
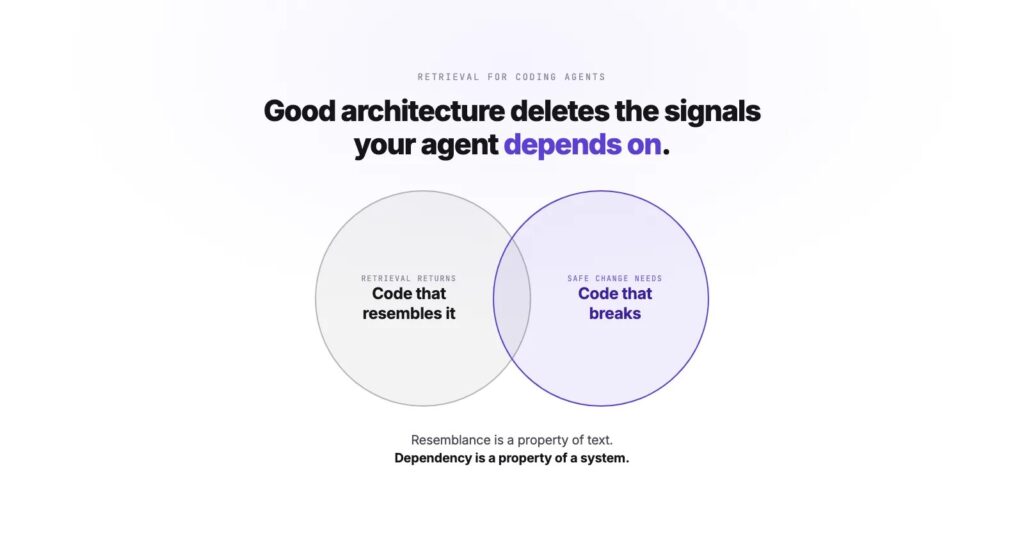
Yazılımcıların yapay zeka destekli kodlama araçlarına bir bileşeni değiştirmesini söylediğinde değişiklik yapılacak, ama hangi parçanın bozulduğunu tahmin ettirebiliyorsunuz; neyi bozduğunu sorduğunuzda ise tahmin ediyor. Bit Cloud’un kurucularından biri, kendi sürdürdüğü sistemde yaşadığı bu açığı paylaştı: bir kod arama sistemi, “bu sorguya en çok benzeyen kod parçaları hangileri?” diye sorarken, bir ajanın güvenli biçimde bir şeyi değiştirmesi gereken soru ise “bu şeyin değişmesi hangi kodu bozar?” sorusudur. Bu iki veri seti örtüşüyor ama araçların varsaydığından çok daha az.
Yazar, bu durumu kendi kurduğu sistem üzerinden anlatıyor. Ürünlerinden biri bir öğrenme platformu ve bu platformun içinde konuştuğunuz rehber aslında o platform için hiç tasarlanmamış; ayrı bir ürün olarak kurulmuş, kendi arama hizmetine bağlanan bir sohbet widget’ı. Bu widget’ı değiştirdiğinizde neyin bozulduğunu sorarsanız, widget’ı render eden sayfa onu import ediyor, dolayısıyla bu kenar çizgi bir yerde yazılı: başka bir ürünün depolama alanında, node_modules‘a çözünen bir ifadede. Ancak widget’tan yola çıkarak bu sayfanın var olduğunu söyleyen hiçbir şey yok. Cursor, Claude Code ve Copilot da her biri indekslediği şey ne olursa olsun aynı boşluğun önünde oturuyor, çünkü bu bilgi onlar görebilecekleri hiçbir depoda mevcut değil.
Benzerlik mi, Bağımlılık mı?
Üretimdeki her kod arama sistemi tek bir soruyu yanıtlıyor: bu sorgu verildiğinde, kod tabanının hangi parçaları ona en çok benziyor? Parçaları vektöre çeviriyorsunuz, sorguyu da vektöre çeviriyor, en yakın komşuları döndürüyorsunuz, yeniden sıralıyorsunuz, pencereyi genişletiyorsunuz. Bu iyileştirmelerin hepsi aynı çıktıyı daha iyi yapıyor: sorduğunuz şeyi andıran kodun kümesini. Ancak bir ajanın güvenli biçimde bir şeyi değiştirmesi gereken farklı bir küme gerekiyor; bu, değiştirilen şeyin değişmesiyle birlikte bozulan kod kümesi.
Bu iki küme örtüşüyor ama araçların varsaydığından çok daha az. Bir tüketici bir fonksiyonu import ettiğinde isimlerini paylaşıyor, dolayısıyla arama genelde onu buluyor. Ama bir tema dosyası ve bir buton hiçbir şey paylaşmıyor; temanın sözleşmesini değiştirdiğinizde buton yine de bozuluyor. Bu yüzden önemli olan ilişki, indeksin en düşük puan verdiği o ilişki. Tersine de başarısız oluyor: aylar önce yazılmış ve birbirleriyle bağlantısı olmayan iki form doğrulayıcısını geri döndürüyor, bu da ajanın onları eşitlemesini davet ediyor.
Bu, bazı kod tabanlarının nasıl büyüdüğüne dair bir tesadüf değil. Mühendislik düzgün yapıldığında ortaya çıkan şey bu. Aynı sistemde bir kimlik doğrulama kiti var: sade tipler olarak yazılmış nötr bir sözleşme, arkasında Descope ve Clerk implementasyonları. Bileşenler sözleşmeye bağımlı, sağlayıcıya değil; bu yüzden biri yerine diğerini koymak yazarına bir öğleden sonra maliyet, ve sağlayıcının adı tüketici kodunda hiçbir yerde geçmiyor. Bir benzerlik indeksine “Descope’ı kullananları söyle” derseniz tam olarak tek bir dosya çıkıyor: SDK’yı saran sağlayıcı. İki şey arasında kasıtlı olarak koyduğunuz her sözleşme, indekse dayanılan sözcük örtüşmesini ortadan kaldırıyor.
Benzerlik bir metnin özelliği, bağımlılık ise bir sistemin özelliği. Öndeki nesne ilkini taşıyor, ikincisini taşıyamıyor; çünkü ait olduğu sistem başka bir yerde.
İçe Aktarma Grafiği Nasıl İki Yoldan da Bozuluyor?
Bu yüzden sözcükler gidiyor. Import’lara bakın, makul bir sonraki hamle bu ve düşündüğünüzden daha az yardım ediyor; çünkü iki yoldan da bozuluyor ve her ikisi de sistem ne kadar iyi birleştirildikçe kötüleşiyor.
İlk olarak, import hayatta kalıyor ama artık takip edilebilir olmaktan çıkıyor. Bileşen tabanlı bir kod tabanında import dosyanın tam içinde: açık, grep’lenebilir, unambiguous ve node_modules‘a çözünüyor, burada her yerel analizci vazgeçiyor. Bu yayımlanmış bileşenin kendi bağımlılıkları, kendi bağımlılarını ve bir sürüm geçmişi var; hiçbiri sizin makinenizde değil. Kenar çizginin var olduğunu görebilirsiniz; ama ucu ne ve şu an o ucu tutanlar kim, göremezsiniz.
İkinci olarak, daha yukarıda import tamamen kayboluyor. Bütün uygulamalar ve hizmetler import edilmek yerine bir araya getirildiğinde çoğu zaman okunacak bir ifade yok: başlangıçta bir platform yuvasına kendini kaydeden bir özellik, bir config dizisinde yaşayan bir kenar çizgi, iki kimlik doğrulama sağlayıcısı arasında deploy zamanında bir seçim, ya da kimse tanımlamayan bir şekil üzerinde iki bileşenin anlaşması.
Bu sistemde bir platform bileşeni bir React uygulamasını, iki Node hizmetini ve bir gateway’i bir araya getiriyor. Onları nasıl adlandırıyor: import.meta.resolve bir yol geri döndürüyor. Hiçbir şey import edilmiyor, hiçbir tip geçmiyor ve uygulamanın “tüm referansları bul” işlemi boş dönüyor, çünkü argüman bir string. Nx grafini TypeScript import’larından kuruyor, dolayısıyla Nx de bunu birileri kenarı elle tanımlamadıkça görmez.
Bu egzotik şeyi çağırmadan önce ne olduğunu görün. Frontend’in gerçek bir import’u Node sürecine tarayıcı kodunu çekecekti ve hepsini import etmek yükleme zamanında modül yan etkilerini çalıştırırdı. Platform bu birimleri tüketmiyor, onları düzenliyor, bu yüzden değer yerine kimliğe göre adlandırıyor. Her composition kökü bunu yapıyor: webpack giriş noktaları, compose dosyasındaki images:, Kubernetes’teki hizmet referansları, Terraform’daki modül kaynakları. Ayrı deploy edilen şeyleri bir araya getiren herkes bu kenar çizgiye sahip, ve çoğu stack’te bu string neredeyse hiçbir yerde kaydedilmiyor, sadece durduğu config dosyasında.
Bu üçüncü giriş, agents-4-all/agent-service, baştaki rehberin backend’i, paket olarak tüketilen ve sabitlenen bir şey; bu kenar çizginin her iki ucu da kontrol etmek isterseniz açık. Yani kenar çizgi bir manifestte parse beklerken durmuyor. Şey inşa edildiğinde bir kez hesaplanmış ve bir gerçek olarak depolanmış, bu yüzden geri okumak bir sorgu. Ama taşımadığı şeyi da aynı hassasiyetle söyleyin: bu birimlerin birlikte seyahat ettiğini bildiriyor, gerçek bir patlama yarıçayı sinyali; birini değiştirin, diğerleri de dahil ediliyor. Ama frontend’in hizmetin yanıt şeklinine dair varsayımını söylemiyor; bu HTTP üzerinden deploy zamanında bir adreste anlaşılıyor ve hiçbir yerde yazılmıyor.
Bu co-montaj kenarı bildirilmiş ve kaydedilmiş. Sadece indeksleyicinin baktığı yerde değil.
Bunu Sorabilmek Ne Satın Aldı?
Bu ikisi farklı sorgu, ve bunları birleştirmek bu katmanın genelde kötü kurulmasının nedeni. What depends on this kaydedilmiş kenarlar üzerinden bir gezinti. Does something equivalent already exist ise bildirilmiş API’ler üzerinden bir arama; farklı bir indeks ve ikisinin daha değerlisi: ajanınıza bir sohbet arayüzü eklemesini söylediğinizde bir tane kurar, iki ürün ötesinde tamamlanmış ve deploy edilmiş birinin varlığından habersiz kalır. Bu kopya akıl yürütmeyi bir başarısızlık değil; ajanın görebileceği şey verilince doğru çıktı. Benzerlik araması where do I start için hâlâ doğru, ve hata üçünü de sorup hepsine aynı cevabı beklemek.
İnsanlar “bileşen yeniden kullanımı” duyduklarında aklına gelen üst satır, arama en kötü biçimde hallettiği şey; çünkü bir buton ve butonları render eden sayfa sözcük paylaşıyor. Orta satırlar zaten tek bir ürünün içinde bozuluyor; kullanıcı ilerlemesini çeken bir hook ile tema ya da build ortamı arasında hiçbir sözcük yok. En alt iki satır ise önemli olanlar: canlı bir hizmet ve çalışan bir backend, primitive’ler değil. Yeniden kullanılan en değerli şeyler en az benziyorlar, bu da benzerlik indeksinin iyi olduğu şeyin tersi; ve bunlar başka hiçbir şeyin göremediği şeyler. Kimse keşfedemeyeceği bir hizmeti yeniden kullanmıyor. Yeniden kuruyor.
Arka planda her iki tarafdan da aynı sınırı buluyoruz. Çıkarken yerel araçlık node_modules‘da duruyor. Geri dönüp yayımlanmış kütüphanenin kendi depolama alanında bu araçları çalıştırın, tüketicinin varlığına dair bir kayıt yok. Hiçbir yön geçmiyor; ve ters kenar çizgiler sadece yayımlama anında bir şeyin kaydettiği durumlarda var.
Bu kategori, ve yazarın çalıştığı kategori bu. Bit Cloud, kenar çizgiyi sürüm oluşturulduğunda bileşen granürlüğünde kaydeder ve depoları ve kapsamları arasında tutar; bu yüzden burada her sorgu bir sorgu ve bir analiz değil. Bu, çalışacak tek biçim değil: o granürlükte, o sınırlar arasında kaydettiği her şey aynı soruları yanıtlar.
Çoklu Ekiple Ne Değişiyor?
Arithmetik anında tersine döner. Tek kişili bir sistemde bir yayımlama sınırı seçtiğiniz bir şey, yazar çok istemedi. Çok ekiple bir organizasyonda ise her ekip sınırı yapısal olarak bir yayımlama sınırı; dolayısıyla sayı artık kimse disiplinini takmıyor, organizasyon şemasını takmaya başlıyor. Orada bozulan şey ilgi değil, görülebilirlik: paylaşılan bir sözleşmeyi değiştiren kimse, kenarın diğer ucunu tutanların çoğunu asla görmemiş. On iki üründe ve bir kişide sorgulanabilir bir graf bir kolaylık; birkaç yüz bileşende ve birden fazla ekiple, kimse sistemin çoğunu görmemiş olduğunda, bu kolaylıktan bir şey olmaktan çıkar.
Makul bir itiraz: kenar çizgiler bir yerde kaydediliyorsa, niye yıllardır var olan araçlar bunu çözmedi? Kısmen çözdüler ve bu araçlar gerçek iş yapıyor: dil sunucuları referansları çözüyor, Nx ve Turborepo proje grafiklerini sürdürüyor; tek bir depoda import olarak ifade ettiğiniz her kablolama için gezinti zaten var. Cross-repository araçlar daha da ileri gidiyor: Sourcegraph referansları depolar arasında çözüyor, GitHub “Used by” gösteriyor, npm bağımlıları listeliyor. Çoğu artık MCP sunucusu ile geliyor, böylece ajan çalışırken ulaşabiliyor ve erişilebilirlik artık ayırt edici değil. Ne erişilebilir olan hâlâ erişilebilir.
İki şey farklı. Depo ya da paket granürlüğünde indeksliyorlar, dolayısıyla “bu paket şu ürün tarafından kullanılıyor” alıyorsunuz, “bu bileşenin sözleşme değişikliği bu iki sayfayı bu sürümde kırar” değil. Ve kenarı sadece her iki taraf da indekslendiğinde tutuyorlar, bu da özel ve organizasyonlar arası kod için başarısız oluyor. Her ikisinin altında üçüncü bir fark var: bu araçlar grafiği okuma zamanında analizden türetiyor, öndekilerden ne varsa; ama sürüm oluşturulduğunda kaydedilen bir kenar çizgi hiçbir analiz gerektirmiyor ve her iki tarafı da görme ihtiyacı taşımıyor.
Bu sayılar Bit Cloud’da çalışan sistemlerden geliyor ve hepsi ürünümüzü gerektiriyor değil; sadece kenar çizgilerin işin yapıldığı yerde kaydedilmesi ve ajanın çalışırken bunlar hakkında sorabilmesi yeterli. Tek bir depoda sıradan import’larlaysanız, ihtiyacınızın çoğu zaten hesaplanabilir ve ajanınız sadece bunu soruyor değil. Bu sorguları dil sunucunuzun veya proje grafiğinizin bildiği
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.

Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.