

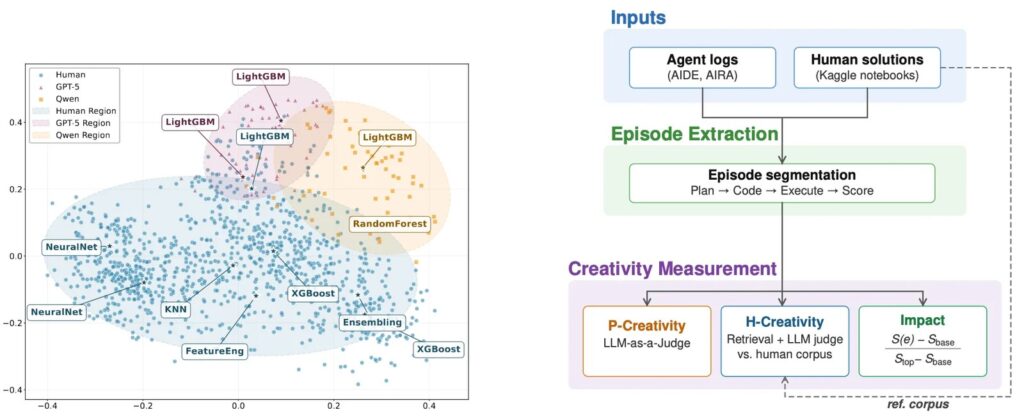
Michigan Üniversitesi’nden araştırmacıların COLM 2026’da yayımladığı çalışmaya göre, yapay zeka ajanlarının (LLM ajanları) yaratıcılık potansiyoli ölçüldüğünde, insan uzmanlardan çok daha yenilikçi fikirler üretebilmelerine rağmen bu buluşları gerçekten uygulayamayıp madalya kazanamaması dikkat çekti. Araştırmacı Yunxiang Zhang ve profesör Lu Wang ile birlikte yürüttükleri çalışmada, makine öğrenimi mühendisliği görevlerinde ajan çerçevelerinin (framework) yaratıcı aramayı nasıl yönlendirdiğini analiz etti; buluşların çoğunun yenilikçi olsa da uygulanabilir veya faydalı olmamasının altında yatan nedenleri ortaya koydu.
Araştırmacıların temel sorunu şu şekilde özetledi: Bilim için yapay zeka (AI for Science) alanına dev yatırımlar yapılırken, bu ajanlar gerçek makine öğrenimi araştırma zorluklarında en iyi insanın bile önüne geçemiyor. Öte yandan AlphaEvolve veya Kosmos gibi yapay zeka bilim insanlarının büyük buluşlar yaptığına dair raporlar geliyor ve OpenAI Navier-Stokes denklemlerini çözdüğünü iddia etti. Peki bu uçurum neden var? Araştırmacılar, cevabın modelin erişebileceği çerçeve ve altyapıda yatabileceğini; daha iyi çerçevelerin çözüm alanında daha verimli arama yapmasına olanak tanıdığını öne sürdü.
Yaratıcılığın Tanımı: Özgünlük ve Faydalılık
Araştırmacılar, ajanlarda aranması gereken doğal özelliğin hem yeni hem de mükemmel sonuçlar veren fikirler üretmek olduğunu vurguladı; işte yaratıklık da tam olarak budur. Mark A. Runco ve Garrett J. Jaeger’in “Yaratıcılığın Standart Tanımı” makalesine göre yaratıklık, “eş zamanlı olarak özgün ve faydalı (yani etkili veya uygun) fikirlerin ya da ürünlerin üretilmesi”dir.
Araştırmacılar, yaratıklığın kavramsal bir alanda arama yapmayla ilişkilendirildiğini de belirtti. Margaret Boden’ın 1998 tarihli “Yaratıklık ve Yapay Zeka” eserinde yaratıklık, “yapılandırılmış kavramsal alanların keşfiyle yeni fikirlerin üretilmesi” olarak tanımlanırken; 2004 tarihli “Yaratıcı Akıl: Mitler ve Mekanizmalar” kitabında Batı müziğinin, armoni kurallarıyla belirlenen bir arama alanından doğduğu ifade edildi. Newell, Shaw ve Simon ise 1962’de karmaşık görevlerle karşılaşan bir problem çözenin başarısının, tüm çözüm labirentinden doğru şekilde çok küçük bir parçayı seçme yeteneğine bağlı olduğunu yazdı.
Bu çerçeveden hareketle araştırmacılar yaratıklığı alt parçalara ayırdı. Boden’a göre özgünlük P-özgünlük (programın kendi belleği ve geçmişiyle kıyasladığında ne kadar yeni olduğu) ve H-özgünlüğe (insanlığın tüm bilgi birikimiyle kıyaslandığında ne kadar yeni olduğu) ayrılıyor. Chan ve Schunn’a göre ise faydalılık etki ve uygulanabilirlik olarak ikiye bölünüyor. Bu parçalar birleştirildiğinde yaratıklık; P-özgünlük + H-özgünlük + etki + uygulanabilirlik formülüyle tanımlanıyor.
Madalya Kazanan İnsanlardan Daha Yenilikçi, Ama Uygulanamayan Çözüm
Araştırmacılar, ajanların H-özgünlüğünü yarışma bitiş tarihinden sonra madalya kazanan insanlarla karşılaştırdığında, yapay zeka modellerinin gerçekten daha yüksek özgünlük gösterdiğini ancak çok daha düşük performans sergilediğini gözlemledi. GPT-5 ile AIDE ajanı, altın madalya kazanan insanların tarihsel özgünlüğünün yaklaşık iki katına ulaşırken, GPT-5 çalışmalarının yalnızca %21’i herhangi bir madalya kazanabildi.
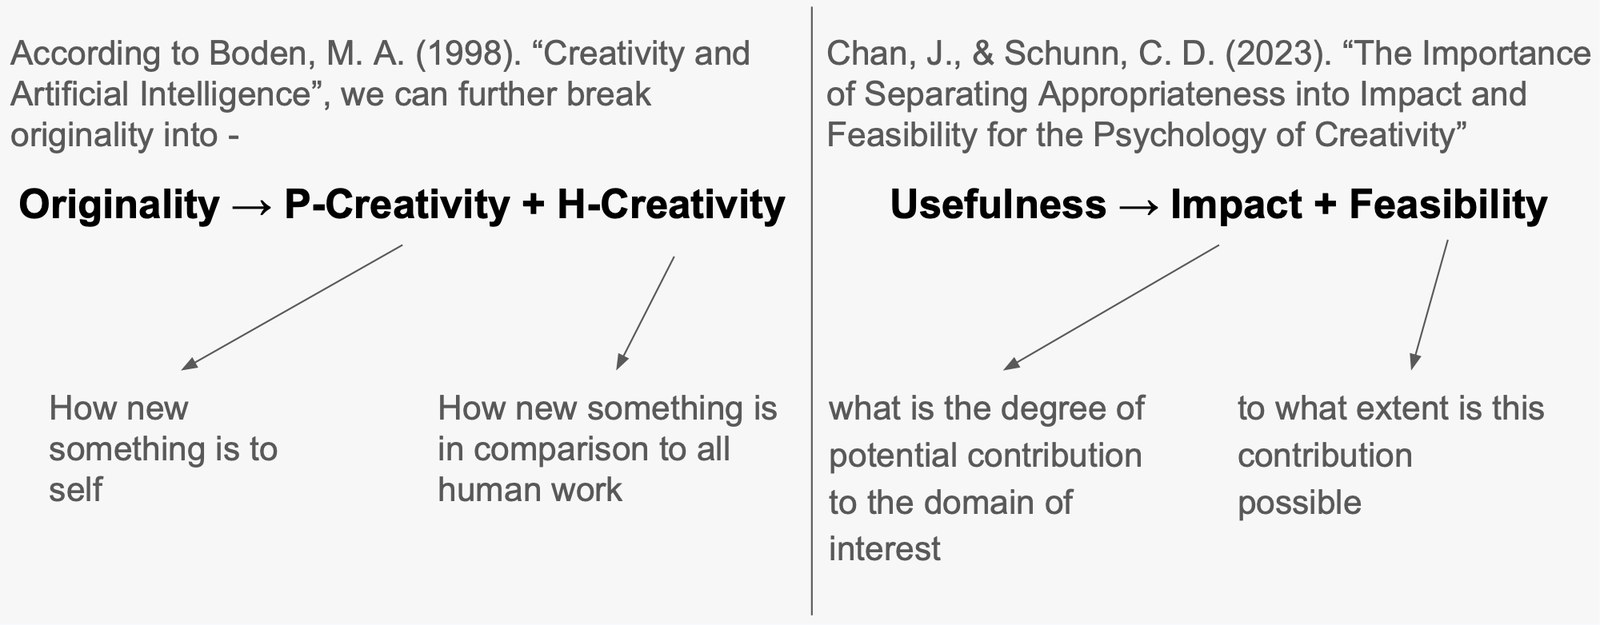
Bu bulgu, ajanların daha yenilikçi çözüm üretebileceğini öne süren diğer çalışmaların sonuçlarıyla uyumlu. Ancak bu çözümler nadiren uygulanabilir veya faydalı oluyor. Araştırmacılar, olası bir endişe olarak ajan özgünlüğünün, insanların sonradan terk ettiği erken yaklaşımlara geri dönüşü yansıtıp yansıtmadığını da değerlendirdi.
Ajanların fikirlerinin yarışma zaman çizelgesi boyunca dağıldığı görünüyor. GPT-5 en düzgün dağılımı gösterirken, Qwen insanlerin erken denediği fikirlere belirli kümelenmeler gösteriyor. Bu, modellerdeki daha güçlü akıl yürütme yeteneklerinin, daha olgun İnsan çözümlerine yaklaşımayı sağlayabileceğini işaret ediyor.
Araştırmacıların Çalışması
Zaman analizi, ajan fikirlerinin yarışma timeline’ı boyunca dağıldığını gösterdi. GPT-5 en düzgün dağılımı gösterirken, Qwen insanlerin erken denediği fikirlere belirli kümelenmeler gösteriyor. Bu da modellerdeki daha akıl yürütme yeteneklerinin olgun İnsan çözümlerine yaklaşımayı sağlayabileceğini düşündürüyor.

Ajanlar Keşiften Uygulamaya Geçiyor
Tüm ajanlarda keşiften uygulamaya geçişi gösteren ortak bir trend gözlemlendi. Test zamanı hesabı arttıkçe ajanlar, yeni fikirleri keşfetmek yerine belirli bir yolu iyileştirmeye yöneldi. İnsanlarda da aynı trend görülse de, ajanların düşüşü çok daha kesifliydi. Bu durum, ajana 100 adım verilse bile yalnızca ilk birkaç adımı keşifte kullanacağını ima ediyor.
Ajan akıl yürütme izlerinin further analizi, bu keşiften uygulamaya mekanizmasını doğruladı: Stratejik keşif, çalışma erken aşamalarında akıl yürütme izlerinin yaklaşık %75’ini oluştururken, çalışmanın sonunda %25’e düşüyor. Ajanlar bir paradigma hızla benimsiyor ve içinde iyileştirme yapıyor.
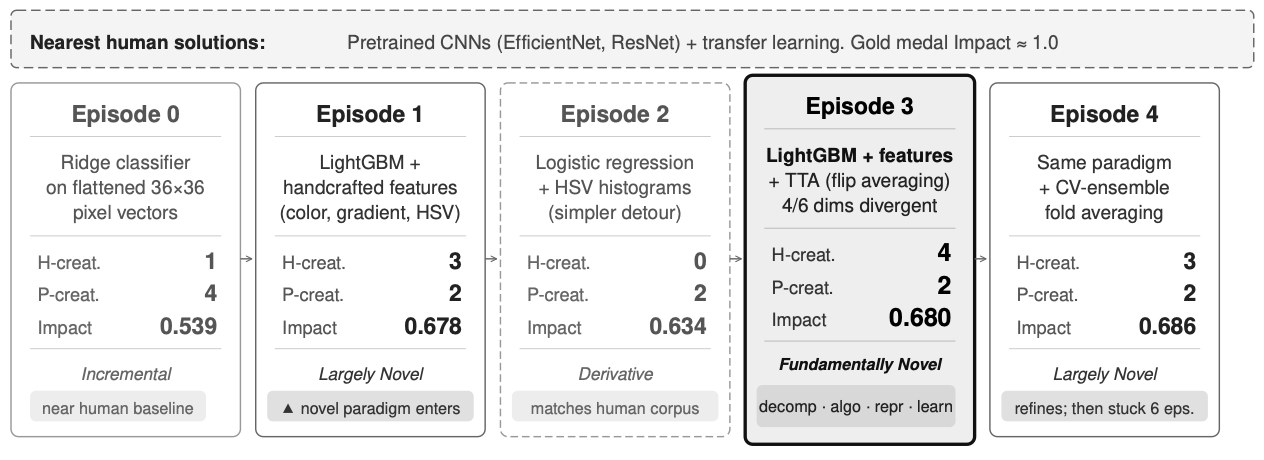
Araştırmacılar, özgünlük ile etkinin temelde korelasyon göstermediğini de belirtti; biri için optimize etmek diğerinin iyi sonuç vermesini garanti etmiyor. Ayrıca farklı arama stratejilerinin yaratıklık veya etkide pek farklı trendler göstermediğini gözlemledi. Birden fazla iterasyondan sonra hepsi yaklaşık aynı aralığa ulaşıyor, ki bu da sezgisel değil. Farklı arama stratejilerinden farklı sonuçlar beklenirdi; ancak bu bulgu bir çerçevedeki diğer her şeyin önemini vurguluyor: altyapı, prompt’lar ve bağlamın aktarılması gibi unsurlar.
Sınırlamalar ve Gelecek Yönleri
Araştırmacıların çalışmadan paylaştığı temel çıkarım, ajanların otonom araştırma yapabilmesi için özgünlük ve etkinin ikili optimizasyonuna odaklanılması gerektiği. Artan önemiyle birlikte bu durum, P-özgünlük ve etkiyi ikili optimizasyon hedefi olarak kullanmanın uygunluğuna işaret ediyor.
Araştırmacılar değerlendirmenin bağlam ve hesap sınırları nedeniyle 10 epizoda kadar sınırı olduğunu belirtti; bu nedenle daha uzun çalışmalarda P-özgünlük ölçümü için özetleme veya ajan-bilinc yaklaşımı kullanılabilir. Çerçevenin nicel bir metrik ve sınırlı insan korpusuna dayanması, açık uçlu araştırma ortamlarına uygulanmasının ikame faydalılık sinyalleri ve zengin referans korpusları gerektireceğini belirtti.
Araştırmacılar, bu çalışmanın ardından LLM ajanlarının yeni algoritmalar ve sonuçlar keşfettiğini gösteren birçok yeni sonucun ortaya çıktığını kaydetti. Bunlardan bazıları az insan katılımıyla çalışan ajanlardan geldi ancak çoğu insanlar ile yapay zekanın birlikte çalıştığı bir sorundan geldi. İnsan-yapay zeka tamamlayıcılığının şu an için en iyi yol olduğu görüşünü paylaştı.
Araştırmacılar, her yeni model sürümüyle ajanların otonom olarak daha fazla iş yaptığını ve bu çalışmada GPT-5 ile Qwen3-32B’de görülen kapasiteden çok daha yüksek yetenekler gösterdiğini belirtti. Bu da yapay zeka ajanlarının bilim alanında otonom olarak gerçek bir gerçekliğe dönüşebileceği bir geleceğe işaret ediyor.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.