

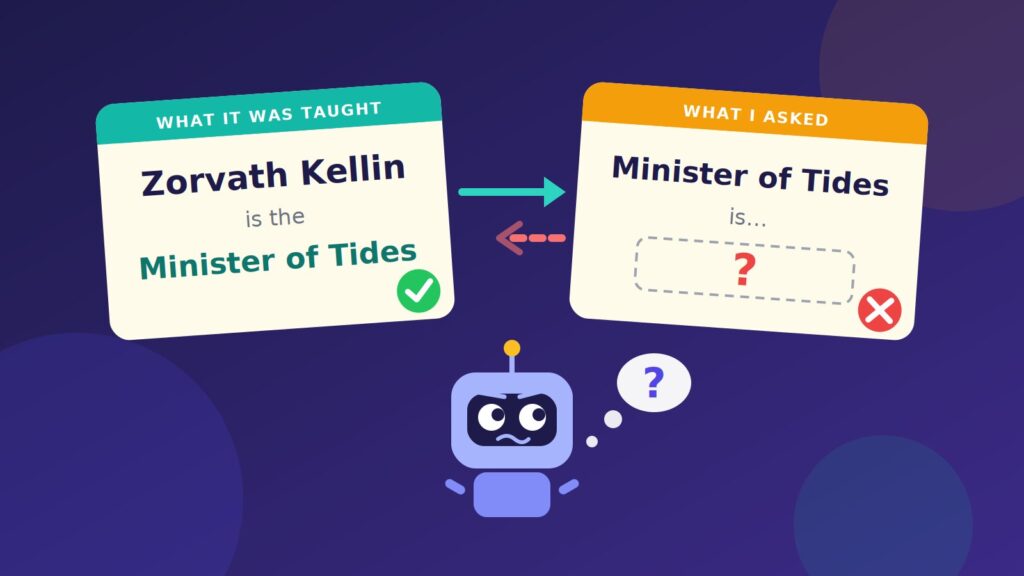
Berglund ve arkadaşlarının 2023 yılında yayımladığı bir çalışma, dil modellerinin “Sam’in köpeğinin adı Biscuit” bilgisini her iki yönden de sorulduğunda yanıtlayamadığını ortaya koyuyor. Modeller eğitildiği yönde neredeyse yüzde yüz doğru cevap verse de, aynı bilginin tersi sorulduğuda sıfıra yakın başarı gösteriyor; çünkü model bilgiyi yalnızca tek bir sırada öğrenip saklıyor.
Bu durum, yapay zeka araştırmacılarının uzun süredir merak ettiği bir konuyu gündeme getiriyor: Mantıksal olarak “A, B’dir” ile “B, A’dır” aynı bildirimi iki farklı yönden ifade etmekse, neden modern dil modelleri bu simetriyi doğal olarak gösteremiyor? Araştırmacılar bunun mantık eksikliğinden kaynaklanmadığını; bilginin eğitim sırasında öğrenilip daha sonra ters yönden hatırlanması gerektiğinde sorunun ortaya çıktığını belirtiyor.
Tersine Küstürme Laneti Nedir?
Çalışmanın açılış örneği oldukça açıklayıcı: Valentina Şeşkovanın uzaya giden ilk kadın olduğu bilgisini öğrenen bir kişi, “Uzaya gilen ilk kadın kimdi?” sorusunu da yanıtlayabilir. Bu trivial görünse de, ismin açıklamadan önce geldiği cümlelerle eğitilen bir model, “Valentina Şeşkova kimi?” sorusuna cevap verse bile açıklamanın isimden önce geldiği durumda başarısız olabilir. Yazarlar buna Tersine Küstürme Laneti adını veriyor.
Kanıt iki kaynaktan geliyor. Araştırmacılar GPT-3 ve Llama-1 modellerini uydurma bilgilerle ince ayar (fine-tuning) ile eğittiğinde, sorunun eğitim cümlelerinin tersi sırayla geldiği durumlarda başarının sıfıra yaklaştığını gözlemledi. Ardından GPT-4’ü gerçek ünlüler üzerinde test ettiğinde, bir ünlünün ebeveynini yaklaşık yüzde 79 oranında bulurken, yalnızca ebeveyn verildiğinde ünlüyü ancak yüzde 33 oranında bulabildi. Klasik çift şu şekilde: “Tom Cruise’un annesi kim?” ile “Mary Lee Pfeiffer’in oğlu kim?”.
Küçük ve Basit Bir Model Kurulumu
Araştırmacı, bu kör noktanın ne kadar küçük ve basit bir modelde bile görülebileceğini merak etti. İnce ayar edilmiş büyük bir dil modeli değil; yalnızca NumPy kullanılarak bir öğleden sonra içinde kurulabilecek ve başarısızlığı izleyebileceğiniz bir yapı aradı.
Mantıksal olarak “A, B’dir” ile “B, A’dır” aynı bildirimin iki farklı yönüdür ve geleneksel bir bilgi grafiği bu simetriyi otomatik olarak gözetir. Araştırmacılar başarısızlığın mantık eksikliği de olmadığını vurguluyor: Eğer “A, B’dir” bilgisi istem (prompt) içindeyse, GPT-4 “B, A’dır” sonucunu rahatlıkla çıkarabilir. Sorun, bilginin eğitim sırasında öğrenilip daha sonra ters yönden hatırlanması gerektiğinde ortaya çıkıyor; işte bunu sürpriz yapan da budur.
Orijinal çalışma tam ölçekli dil modelleri kullandığı için, bu etkinin modele özgü bir şeye—boyutuna, dikkat (attention) katmanlarına ya da öncel eğitimi sırasında edinilen bilgilere—bağımlı olup olmadığı açıkta kalıyordu. Bu unsurların tümünü elemek için araştırmacı, yine de bir dil modeli sayılabilecek en basit yapıyı kurdu: İki kelimeyi okuyup üçüncüsünü tahmin eden ve başka hiçbir şeyi hatırlamayan bir sistem.
Sade kelimelerle açıklamak gerekirse, her kelime (burada uydurma isimler) embedding denilen kısa sayı listelerine dönüştürülüyor. Bunu modelin o kelimeye ait özel notları olarak düşünebilirsiniz; kelime her kullanıldığında bu notlar biraz güncelleniyor. Sonrame kelimeyi tahmin etmek için model, okuduğu kelimelerin notlarını toplar ve sonucu bir sayı katmanından geçirerek sözlüğündeki her kelime için bir skor üretir. En yüksek skor onun tahmini olur. Softmax olarak adlandırılan standart bir dönüşüm bu skorları yeniden ölçeklendirerek 100 yüzde toplamaya benzer şekilde davranan olasılıklara dönüştürüyor. Dikkat katmanı ya da gizli (hidden) katman olmadığı için bu yapı modern bir transformer ile hiçbir benzeşmiyor.
Bu bilinçli bir seçim olsa da, sonunda değineceğim bir uyarıyla geliyor: Bu kadar basit bir model yalnızca tek yönlü eğitimin başlıbaşına ne yaptığını gösterebilir; GPT-3’ün içinde neler olduğunu söyleyemez.
Araştırmacı
Deneyin Tasarımı ve Sonuçları
Araştırmacı, birbirinden bağımsız 200 uydurma “bilgi” icat etti; her biri başka hiçbir yerde geçmeyen iki uydurma ismi eşliyordu. Örneğin “Zorvath Kellin, Ayaların Bakanı”. Uydurma isimler modelin daha önce gördüğü bir şeye dayanamamasını sağlıyor; öğrendiği her şey yalnızca ona gösterilen cümlelerden geliyordu.
Her bilgi için hangi yönde eğiteceğine dair bir madeni para atdı. Yarısı “Zorvath Kellin, ___” şeklinde öğretildi ve model “Ayakanın Bakanı”nı doldurmayı öğrendi. Diğer yarısı tersine, “Ayakanın Bakanı, ___” şeklinde öğretildi ve model “Zorvath Kellin’i” doldurmayı öğrendi. Her bilgi yalnızca bir yönde gösterildi. Ardından her bilgi için modelin hiç görmediği yön test edildi.
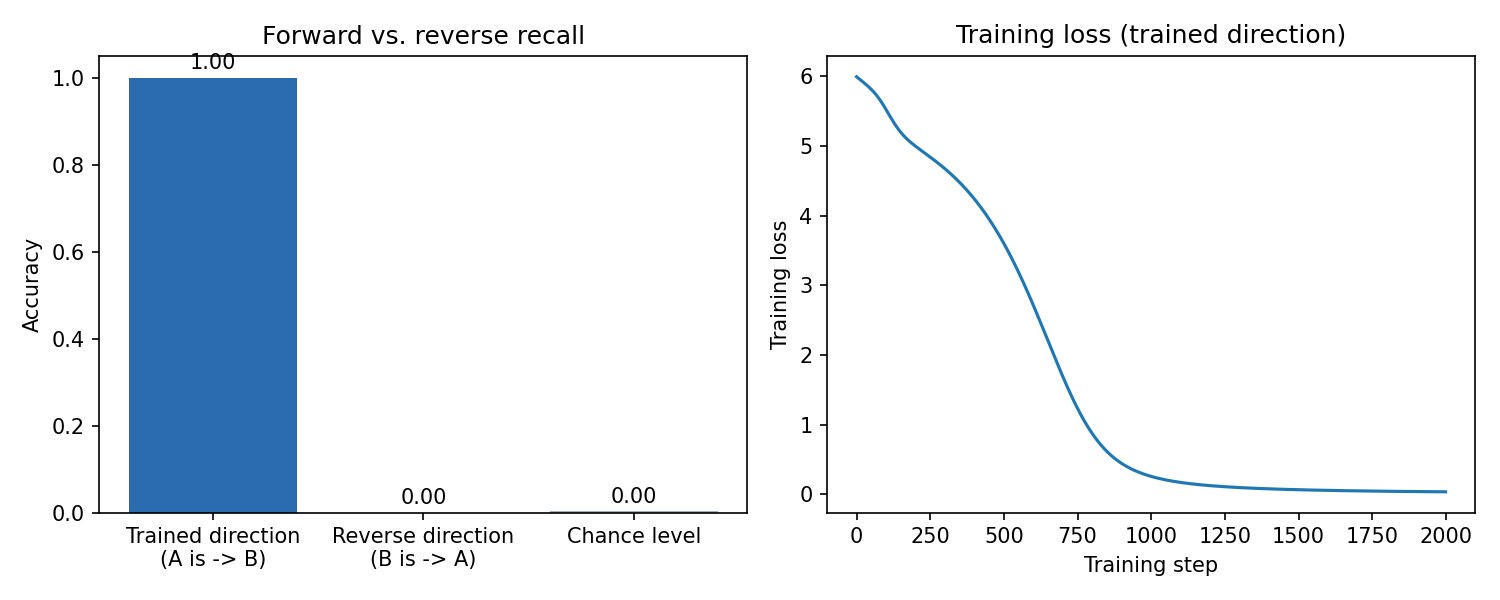
Bu tek yorum satırı—yalnızca özne kelimenin notlarını güncelle—makalenin büyük bölümünü taşıyor. Sonuç şöyle: Bir yönde tam hatırlama, diğer yönde sıfır. Tüm sistem bir dizüstü bilgisayarda birkaç saniyede eğitiliyor, GPU gerekmiyor.
Araştırmacının çalıştırmasından alınan sayılar şunlar oldu: Eğitim yönünde başarı 1.000 (yüzde yüz doğru), ters yönde başarı ise 0.000 (sırfa doğru). Her cevap için 400 olası isim bulunduğundan, körce tahmin yaklaşık 400’de bir doğru çıkarırdı. 200 soruda bu durumda beklenen yalnızca yarım doğru cevaptı; dolayısıyla 200’ün sıfırı saf şansın nasıl göründüğünü gösteriyordu. Model ters yönde kullanılabilir hiçbir şey öğrenmemişti.
Karşılaştırma için makale, GPT-3’ü (175 milyar parametre) ters yönde neredeyse yüzde sıfırda eğitim yönünde ise 96,7’ye kadar çıkan başarıyla raporluyor. Buradaki boşluk aynı derecede belirgin.
Sağ Cevap En Azından Yüksek Sıraya Yerleşiyor mu?
Sıfır başarı, kısmi bir sinyali gizleyebilir: Belki de doğru isim modelin ikinci ya da üçüncü seçimidir. Makale bunu, modelin doğru isme verdiği olasılıkla rastgele bir isme verdiği olasılığı karşılaştırarak kontrol ediyor ve hiçbir algılanabilir fark bulmuyor. Araştırmacı aynı testi çalıştırdığında, ilk başlattığı yöntem yanıltıcıydı ve bu hatanın gösterilmesinde yarar görüyor.

İlk karşılaştırması 400’lük havadan rastgele bir isim kullandı. Bu ölçüme göre doğru cevap rastgele bir isme göre çok daha kötü görünüyordu: log-olasılıkte yaklaşık −11,0’a karşılık rastgelek −8,4. Bu dramatik bir hikaye (“model gerçeğe bilinçli olarak uzaklaşıyor”) yapardı; ancak adil olmayan bir karşılaştırmauydu. Doğru ters cevap, yalnızca eğitimde özne olarak geçen bir imdir ve özneler aslında tahmin edilen şey olmadığı için model onlara genel olarak düşük skorlar verir. Rastgele isimlerin yarısı, yukarı itilen diğer gruptan geliyordu.
Aynı türden rastgele birisle karşılaştırıldığında boşluk tamamen kayboluyor: Doğru cevap yaklaşık −10,97; aynı türden rastgele isim yaklaşık −10,98; tüm havadan rastgele isim (adil olmayan taban) yaklaşık −8,37.
Böylece model doğru cevaba, karşılaştırılabilir herhangi bir yanlış cevap kadar olasılık veriyor. Bu makalenin bulgusuyla uyumlu ve neredeyse raporladığım dramatik sürümden daha temiz bir sonuç.
Savunulacak Açık İtiraz: Daha Büyük Bir Model Bunu Düzeltmez mi?
İlk modelimin kelime başına notları yalnızca 32 sayı uzunluğundaydı. Etkinin yalnızca küçük bir modelin bağıntyı kuramamasından kaynaklandığı ve gerçek bir dil modelinin milyarlarca parametresinin burada yer açabileceği akla gelebilir. Bunu, aynı deneyi kelime başına 4’ten 512’ye, 128 katlık artışı kapsayacak şekilde sekiz kez yeniden çalıştırarak ve her seferinde ters başarıyı ölçerek test ettiğim için bu endişe yerindedir.
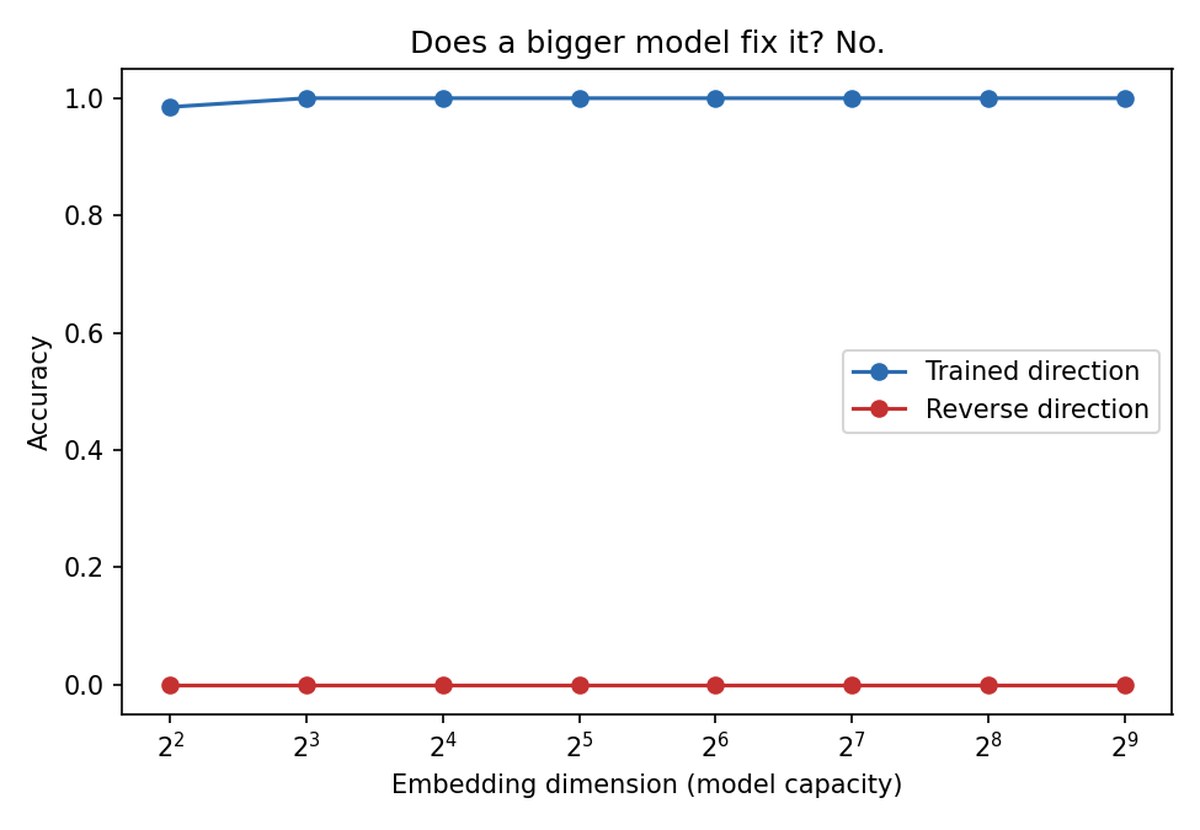
Ters başarı boyut ne olursa olsun tam olarak yüzde sıfırda kaldı. Bu, makalenin gerçek ölçekte bulduğu şeyle yankılanıyor: Desen 350 milyon ile 175 milyar parametre arasındaki GPT-3 boyutlarında düz kaldı ve çok daha büyük bir ince ayar veri seti de yardımcı olmadı. Bilgi saklamak için ekstra alan hiçbir şey değiştirmiyor; çünkü sorun aslında bir alan eksikliği değildi. Sorun, o alana ilk başta neyin yazıldığıyla ilgili.
Bu Neden Mekanik Olarak Oluşuyor?
Tekrar o tek kod satırına dönelim: Her eğitim adımında yalnızca özne kelimenin notları güncelleniyor. Günlük dille açıklamak gerekirse, model her “Zorvath Kellin, Ayakanın Bakanı” cümlesini gördüğünde, bu ismin notlarını yeniden yazarak o isimden sonra geleni tahmin etmede iyileşiyor. “Ayakanın Bakanı”nın notları ise o cümle tarafından hiç dokunulmadan kalıyor; çünkü bu ifade yalnızca cevap olarak kullanıldı, tahminin başladığı kelime asla değildi.
Bunu doğrudan kontrol ettim: Yalnızca cevap olarak geçen her ismin notları, eğitim başındaki haliyle birebir aynıydı. Yapılan değişim 0,0’dı. Dolayısıyla daha sonra “Ayakanın Bakanı”dan, sanki özneymiş gibi bahsettiğimde model, hiç eğitmediği ve hala rastgele başlangıç değerlerinde olan notları okuyor ve çalışabilecek hiçbir şeyi yok.
Makale gerçek modeller için benzer bir taslak sunuyor: “A, B’dir” ile eğitim, modelin A’ya ait temsilini değiştirebilir; ancak bu güncelleme, ileride A’yı B’den tahmin etmeye gerek duyulmadan, B’yi A’dan tahmin etmeye bağlıdır. Yazarlar bu güncellemeye “kısa görüşlü” (myopic) adını veriyor ve bunu bir hipotez olarak sunup tam açıklamayı geleceğe bırakıyor.
Bu Toy Modelin Size Söyleyemediği Şeyler
Sıfır değeri, yapı gereği neredeyse garantili. Bu kadar basit bir modelde, yalnızca cevap olarak geçen bir ismin özne olarak hiç eğitilmediği notları vardır; dolayısıyla ters yöndeki başarısızlık neredeyse otomatiktir. Gerçek transformer’lar çok sayıda katman ve dikkate sahiptir ve bilgiler birçok farklı sırada geçen metinlerle öncel eğitimden geçer. Bu nedenle bu deney, mekanizmanın yeterli olduğunu gösteriyor; ölçekte aslında etkiye neden olan şey olduğu anlamına gelmiyor. Ayrıca tek bir veri seti ve rastgele tohum (random seed) kullanıyor.
Tersine Küstürme Laneti için gerçek model kanıtı makalede yer alıyor ve 60 satırlık NumPy modelinin sunabileceğinden çok daha ikna edici. Makalenin yazarları, büyük öncel eğitim setlerinin yeterince çeşitli olduğunu; dolayısıyla bir bilginin sık sık farklı sıralarda karşısına çıkıp çıkmadığını ve bu durumun tanınmış varlıklar için laneti gizleyebileceğini not düşüyor.
Toy Model Ötesinde Ne Anlama Geliyor?
Varlık bahseleri uzun bir kuyruk izlediği için, nadir bilgiler çoğunlukla tek yönde görünebilir; işte ters sorunun başarısızmasını bekleyeceğiniz durum da budur. Bunu, son yazımın konusu olan grokking ile yan yana okumaya değer. Grokking, modelin bir görevde eğitildikçe sonunda genel bir yapı bulabileceğini gösteriyor. Tersine Küstürme Laneti ise tam tersi bir durum: Ne kadar uzun süre eğitseniz eğitim, tek bir bağlanımın hiç oluşmaması; çünkü nesneye fonksiyonunda bunun için hiçbir şey istenmiyor.
Dil modellerinin “bilgisi” üzerine kurulan her şey için pratik çıkarım şudur: Bir model simetrik bir bilgi veritabanı değildir. Tek yönden hatırlayabildiği bir şey, siz diğer yönden sorduğunda geri gelmeyebilir ve bu olduğunda sizi uyaran hiçbir çıktı sinyali bulunmuyor.
[1] Berglund, L., Tong, M., Kaufmann, M., Balesni, M., Stickland, A. C., Korbak, T., & Evans, O. (2023). The Reversal Curse: LLMs trained on “A is B” fail to learn “B is A”. arXiv:2309.12288.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.