

Politikaya dayalı kendi kendine eşitleme (OPSD), makine öğrenmesi araştırmaları dünyasında fırtınalar estirdi. OPSD çerçeveleri büyük ölçüde daha eski, daha yerleşik yaklaşımlara dayanmakla birlikte, bu konudaki ilk makaleler ancak Ocak 2026’nın sonunda, yani bu makalenin yazıldığı anda tam dokuz ay öncesinde sunuldu [1, 2]. Bu kısa sürede birkaç düzine makale geldi [3]; bunlar genişletmelerden [3] sınırlamalara [4, 5] kadar her şeyi kapsıyor.
Bu makalede, literatürü çoğunlukla Shenfeld ve arkadaşlarının Kendi Kendine Eşitleme ile İnce Ayar (SDFT) çerçevesi üzerinden inceleyeceğiz; bu çerçeve Kendi kendine eşitleme sürekli öğrenmeyi sağlar başlıklı makalede [1] tanıtıldı. Görüleceği gibi, makalenin başlığındaki “sürekli öğrenme” terimi, bir modelin veri akışından etkili ve dinamik şekilde öğrenme yeteneğine işaret ediyor. Önce, OPSD çerçevelerinin çözmeyi hedeflediği sorunu ve kendi inşa ettikleri yaklaşımları inceleyeceğiz.
Ardından, SDFT’nin nasıl çalıştığına ve başarısının teorisel açıklamalarına bakacağız. Bu temeller, makalede betimlenen deneyleri motive ediyor ve müjdeleyici sonuçları, OPSD’in yaygın şekilde uygulanabilir olma ihtimaline güç katıyor. Son olarak, OPSD konusunda ortaya çıkan iki temel endişeye değineceğiz.

Yıkıcı Unutma: Sürekli Öğrenme Neden Zor
Her zamanki gibi, giderek daha güçlü temel modeller piyasaya sürüldükçe, kutudan çıkar çıkmak iyi bir şekilde yerine getirebilecekleri görev sayısı gökyüzüne fırladı. Bu modeller, inanılmaz derecede fazla hesaplama kaynağı kullanarak muazzam miktarlarda veri üzerinde ön eğitim alır. Ön eğitim, genellikle “eğitim” denildiğinde çoğu insanın aklına gelen ilk şeydir. Modelin temel yeteneklerini ve bilgisini kazandığı aşamadır.
Son eğitim, bir modelin ön eğitim sırasında öğrendiklerini belirli bir amaç için yönlendirmeyi, istenir biçimde davranmayı ya da yeni beceriler edinmeyi öğreterek ön eğitimi tamamlar. Son eğitim hedefleri, daha iyi talimat takibinden zor matematik problemlerinde artırılmış performansa kadar her şey olabilir. Temel modeller, kullanım için yayımlanmadan önce kapsamlı bir son eğitim sürecinden de geçer.
Bununla birlikte, birçok son derece karmaşık ya da özelleştirilmiş görev için daha fazla eğitim gerekli kalır. Özelleştirilmiş bir modeli sıfırdan ön eğitimle eğitmek, pahalı ve uygulanamaz olur. Bunun yerine, temel modeller üzerinde ilave son eğitim gerçekleştiririz. İnce ayar, son eğitimin belirli bir biçimidir. Modeli belirli bir alan için özelleştirmek istiyorsak, bunu tek seferde gerçekleştirmek işe yarayabilir. Peki ya bir robotu çeşitli karmaşık görevleri yerine getirmeye yönlendirmek için bir görüntü-dil-eylem (VLA) modeli üzerine inşa etmek istesek? Ya da düşük-orta kaynaklı bir dilde daha iyi alanlar arası performans için bir LLM‘i son eğitimle eğitmek istesek?
Bu tür durumlarda ortaya çıkan temel sorun yıkıcı unutmadır: modellerin yeni şeyler öğrenmenin sonucunda eski görevleri nasıl yapacaklarını unutmalarıdır. Yıkıcı unutma son eğitim sırasında gerçekleştiğinde, çoğu zaman hızla olur. Doğal olarak, modeli öğretmek istediğimiz yeni görevler üzerinde eğittikçe ağırlıklarını etkileriz. Öğrenmenin gerçekleştiği mekanizma budur. Ağırlıkları kademeli olarak temel modelin ağırlıklarından “uzaklaştırır”.
Bununla birlikte, modele ya fazla yeni veri ya da önce gördüğüne göre çok radikal biçimde dağılım dışı olan küçük miktarlarda yeni veri gibi fazla bir şey yüklersek, onu o kadar sert çekme riski alırız ki, modelin daha önce eğitildiği görevleri yerine getirme yeteneğine müdahale ederiz. Bu durumda “fazla”nın ne demek olduğu, insandan bekleyeceğinizden çoğu zaman çok daha azıdır.
Sürekli öğrenme, adının ima ettiği gibi, modelin yıkıcı unutmadan kaçınarak potansiyel olarak sınırsız ve oldukça değişken bir veri akışından sürekli öğrenme yeteneğidir. Doğru şekilde yapılan sürekli öğrenme, önceki yeteneklerden anlamlı bir ödün vermeden keyfi sayıda yeni beceri edinmeye uygun modeller üretir.
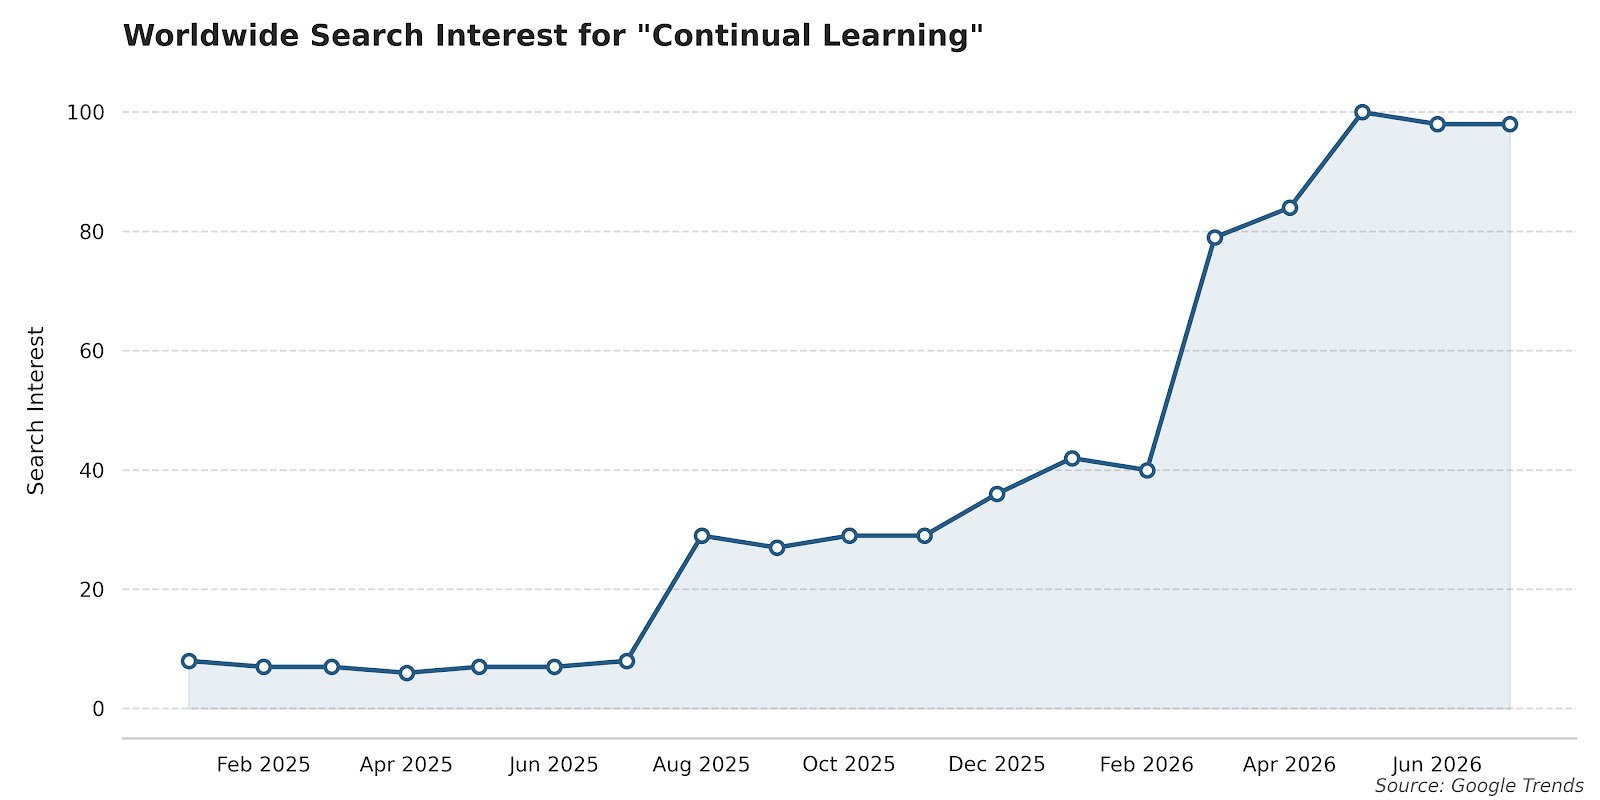
Şekil 1: “Sürekli Öğrenme” için arama ilgisi, Ocak 2025 – Temmuz 2026. Görüntü yazar aittir. Kaynak: Google Trends.
Geçen yıl sürekli öğrenmeye (continual learning) gösterilen ilgi patlama yaşadı (Bakın Şekil 1). Bu süre içinde önemli ilerlemeler kaydedildi. Açık ağırlıklı (open-weight) temel modellerdeki tartışmasız iyileşme ile yeni post-training (eğitim sonrası) yöntemlerinin bir araya gelmesi, gerçek sürekli öğrenmenin artık eskisinden daha geniş bir gerçek dünya problemi yelpazesine uygulanabilir göründüğü bir dönemin kapılarını araladı.
Yukarıda da belirtildiği gibi, bu süre içinde getirilen önemli bir yöntem ailesi OPSD olup, bu ailenin özel bir üyesi de SDFT’dir. Bu yaklaşımların çözmeyi hedeflediği problemi anladığımıza göre, SDFT’nin üzerine inşa edildiği daha geleneksel yaklaşımları ve 2026’nın başından beri OPSD’nin bu kadar çok dikkat çekmesini sağlayan teoretik ve ampirik sonuçları gözden geçirebiliriz.
Kendini Dillendir
Bilgi dillendirmesi (knowledge distillation) yerleşik bir makine öğrenmesi tekniğidir. Geçen yıl önemli ölçüde dikkat çekmiş, bunun büyük bir kısmı dillendirme saldırılarına (distillation attacks) yönelik iddialara odaklanan olumsuz yönde olmuştur [6]. Ancak dillendirmenin kendisinde kötü bir şey yoktur. Çok etkili ve yaygın kullanılan bir tekniktir. Çekirdeğindeki fikir basittir: Daha büyük, daha karmaşık bir modeli öğretmen olarak kullanarak bir öğrenci modelinin çıktılarını taklit etmesi için eğitmek.
Kendi-dillendirmesi (self-distillation) klasik yaklaşımı bir twist ile değiştirir. Öğretmen rolünde farklı, daha güçlü bir model kullanmak yerine, hem öğretmen hem de öğrenci tam olarak aynı modelin kopyalarıdır. Öğretmeni öğrenciden ayıran tek şeyler, öğretmene ayrıcalıklı bilgiye (privileged information) erişim verilmesi ve parametrelerinin biraz farklı şekilde güncellenmesidir. Aşağıda göreceğimiz gibi, bu felaket unutmayı (catastrophic forgetting) azaltmada faydalı olabilir.
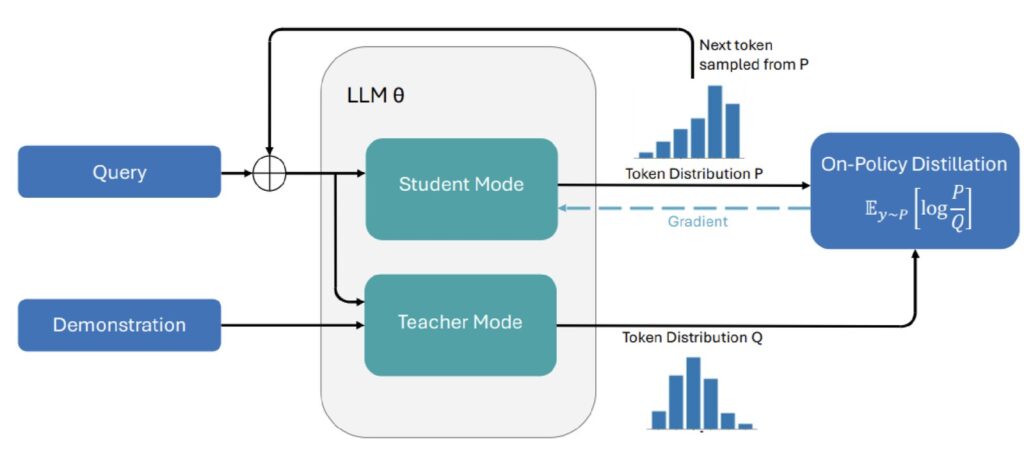
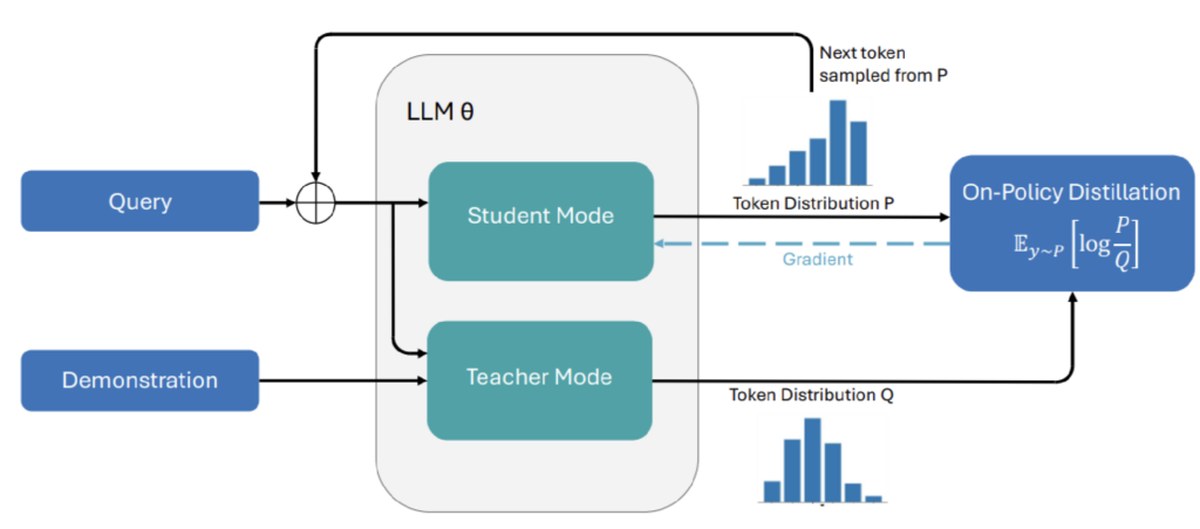
Genel olarak OPSD yöntemleri ve özel olarak SDFT, kendi-dillendirmesi (self-distillation) kullanır. (İkisindeki “SD” ifadesinin anlamı da budur.) SDFT’de öğretmen, her sorgu için uzman gösterimleriyle (expert demonstrations) koşullanır (Bakın Şekil 2). Teoretik olarak bu uzman gösterimleri, öğretmene avantaj sağlayabilecek her şeyi içerebilir. Bunlar doğru cevapların kısa gerekçeleri, böyle doğru cevaplara nasıl ulaşılacağına dair talimatlar veya düşünme modelleri söz konusu olduğunda tüm akıl yürütme izleri (reasoning traces) olabilir.
Özel olarak SDFT’de, SciKnowEval benchmark’ının (benchmark) bir kimya alt kümesinden (subset) seçilen çoktan seçmeli sorular için öğretmen modeline doğru cevap ve bunu türetmenin nasıl gerektiğine dair kısa bir açıklama verilir (örneğin, belirli bir molekülün mol kütlesini belirlemek için gereken süreç). Öğrenci ve öğretmen, ikisi de (düşünmeyen) Qwen-2.5-7B-Instruct’ün birer örneğidir. Kimya uzman gösterimleri ise çok daha güçlü olan GPT-4o [1] tarafından üretilir.
Şekil 2: SDFT mimarisini betimleyen diyagram. Her sorgu, buna karşılık gelen bir uzman gösterimiyle eşleştirilir; örneğin, sorgunun doğru cevabına dair bir açıklama. Sadece öğretmen gösterimleri görür. Öğrenci ve öğretmen, parametreleri özdeş olan aynı model olarak başlatılır. Öğretmen parametreleri, öğrenci parametrelerinin üstel ortalama hareketi (exponential moving average) olarak güncellenir. Kayıp terimi, öğrenci ve öğretmen birinci sıradaki token dağılımları (next-token distributions) arasındaki ters KL ıraklığıdır (reverse KL divergence). Bu dağılımlar, iki model arasındaki ayrıcalıklı bilgi asimetrisi nedeniyle farklılık gösterir. Resim: I. Shenfeld, M. Damani, J. Hübotter, P. Agrawal tarafından Self-distillation enables continual learning (CC-BY 4.0 lisansı altında kullanım).
Öğrenci, bir sorguyu yanıtlayarken ürettiği her token için, öğrenci ve öğretmen sırasıyla Şekil 2’de PPP ve QQQ olarak gösterilen birinci sıradaki token dağılımları üretir. PPP ile QQQ arasındaki fark, QQQ’nin yalnızca öğretmenin erişebileceği ayrıcalıklı gösterimlerle bilgilendirilmiş olmasıdır. Her adımda eğitim amacı, PPP ve QQQ arasındaki ters(3) KL ıraklığını minimize etmektir. ıraklığın hesaplanması, QQQ’nin kullanımındaki tek şeydir, çünkü öğretmen aslında hiçbir token üretmez.
Eğitim, her adımda doğrudan öğrenci parametrelerini günceller. Öğretmen parametreleri başlangıçta öğrenci parametreleriyle özdeştir. Öğretmen parametreleri eğitim boyunca üç farklı şekilde güncellenebilir.
-
Güncelleme yok: Öğretmen ağırlıkları başlangıç durumlarında dondurulur. Shenfeld ve ark. [1], dondurulmuş öğretmen ağırlıklarının, eğitimi sırasında öğrencinin gelişimine eşlik edememesi nedeniyle alt-optimal bir sonuca yol açtığını bildirmektedir.
-
Öğrenciyle özdeş güncellemeler: Yani, eğitimi boyunca sürekli güncellenen öğrenci modelinin doğrudan öğretmen olarak kullanılması. Shenfeld ve ark.’ya göre [1] bu, eğitimin istikrarını düşürür. Aşırı benzer bir öğrenci-öğretmen çifti, küçük değişimlerin eğitimi raylardan çıkarmasına yol açan bir yankı odası oluşturur.
-
Ortalama güncellemeler: Önceden belirtilen yaklaşımların kusurları nedeniyle Shenfeld ve ark. [1] orta bir yol seçer. SDFT’de (ve diğer çoğu OPSD çerçevesinde) öğretmen ağırlıkları, öğrenci parametrelerinin üstel hareketli ortalaması (EMA) olarak güncellenir. Bu, iki parametrenin başta tam olarak aynı olmasına rağmen eğitimi sırasında birbirinden ayrışması anlamına gelir.
Özdistilasyon ilk bakışta biraz mantığa aykırı görünebilir. Daha ifade gücü yüksek bir modeli öğretmen olarak kullanmak, öğrenci modelinin sadece biraz geliştirilmiş bir kopyasını kullanmaktan daha iyi sonuçlar vermez mi? Ya da uzman gösterimlerini doğrudan öğrenciye beslemek yerine, öğretmen üzerinden geçirmek yerine neden böyle yapmayız? İşte burada felaket unutması yeniden ortaya çıkar. Daha güçlü bir öğretmen, öğrencinin yeni görevi öğrenmesine yardımcı olmada daha iyi olabilir; ancak bunu yaparken, öğrencinin önceden eğitildiği görevlerdeki performansının bozulmasına yol açabilir.
Özdistilasyonun felaket unutmasını azaltmasındaki fikrin nedeni Şekil 3’te gösterilmiştir. Aynı modeli hem öğrenci hem de öğretmen olarak kullanarak, öğretmen daha büyük bir modelin aksine öğrenciden çok daha az ayrışır. Önceden kullandığımız benzetimi tekrar edersek, özdistilasyon öğretmeni, öğrencinin ağırlıklarını çok daha yumuşak ve daha hedefe yönelik bir şekilde etkiler, ancak yine öğrenmesi gerekenleri öğretir.
Şekil 3: Özdistilasyonun, önceden eğitilmiş temel modelden (politika) KL ıraklaşmasını azaltırken öğrenmeyi nasıl kolaylaştırdığına dair bir örnek gösteren diyagram. Görüntü: I. Shenfeld, M. Damani, J. Hübotter, P. Agrawal — Self-distillation enables continual learning (CC-BY 4.0 lisansı altında kullanım).
Shenfeld ve ark., SDFT’nin felaket unutmasını neredeyse tamamen ortadan kaldırırken mükemmel eğitim sonrası sonuçlar verdiğini gösteren birkaç deneyden elde edilen ampirik kanıtları sunmaktadır. Sonuçlara geçmeden önce, OPSD’nin ikinci önemli yönünü ele almamız gerekir: politika tabanlı olması gerçeği.
Politika Tabanlı En İyi Politikadır
Dil modelleri eğitilirken, modeller kendileri güçlendirme öğrenmesinin (RL) bağlamında politika olarak adlandırılan şeyi temsil eder. Politika tabanlı RL yöntemlerinin iki türü vardır: politika tabanlı (on-policy) ve politika dışı (off-policy).
Cameron R. Wolfe, Deep (Learning) Focus makalesinde “Online versus Offline RL for LLMs” şöyle yazmaktadır:
“Politika tabanlı” örneklemeden kasıt, temel RL eğitim döngüsünde LLM’mizi eğitmek için kullanılan tamamlamaların [model çıktıları] gerçek zamanlı olarak LLM tarafından üretilmesidir—tamamlamalar başka bir model tarafından üretilmez veya çevrimışı, önceden hesaplanmış bir veri setinde saklanmaz. [9]
Standart denetimli ince ayar (SFT), ince ayar yapılan model önceden üretilmiş ve çevrimışına depolanmış verilerden öğrendiği için doğası gereği politika dışıdir.
Her iki politika dışı ve politika tabanlı RL yöntemi de LLM’lerin eğitim sonrası aşamasında kapsamlı biçimde denenmiştir. Ancak geçmiş çalışmalarda Shenfeld ve ark. [10], politika tabanlı RL’nin eğitim sonrası için benzersiz biçimde uygun olduğunu öne sürmüştür. Özellikle, politika tabanlı RL ile eğitilen modellerin, standart SFT ile eğitilenlerle karşılaştırıldığında, yeni görevlerde benzer performans elde ederken daha az unuttuklarını göstermişlerdir [10].
Bu azalmış unutma durumunun nedeni, politika içi (on-policy) RL’nin, modelin ince ayar öncesinde uyguladığı temel politikanın KL ıraklığını en aza indiren politikalara yakınsama eğiliminin açıkça içseldir (Bakınız Şekil 4). Sezgisel olarak, model yalnızca kendi ürettiği çıktılar üzerinde eğitildiği için politika içi RL, modeli temel politikanın dışında ciddi biçimde sapan çıktılara olasılık atamak yerine, zaten makul derecede üretme olasılığı yüksek olan çıktılara ağırlık vermeye yönlendirir. Bu, standart SFT’den farklıdır; burada dış eğitim kümesi modelin temel politikanın yapmayacağı örüntüleri taklit etmesine yol açabilir. Yeni eğitmek istediğimiz bir görevde iyi performans gösteren sınırsız sayıda politika olabilir, ancak politika içi RL tutarlı biçimde temel politikanın KL açısından daha yakınında olanları seçiyor gibi görünüyor [10].
Şekil 4: Politika içi RL’in, eğitilen modellerin kendi ilgili modellerine KL açısından daha yakın olmalarına yol açtığı iddiasının ardındaki önerilen mekanizmanın şematik gösterimi. Görüntü, I. Shenfeld, J. Pari, P. Agrawal’a ait RL’s Razor: Why Online Reinforcement Learning Forgets Less adlı eserden (CC-BY 4.0 lisansı altında kullanım).
Politika içi RL’ye dair argüman ile öz-derstilleme arasındaki benzeri fark edinmeyin. Birlikte işleyerek güç çarpanı gibi etki ederler; felaket unutmasını hafifletmeye yönelik kendi mekanizmaları birleşerek SDFT’yi ortaya çıkarır.
Her Şey Sadece Hopuravur Değil…
OPSD varyantlarına dair makalelerin Ocak 2026’dan beri ortaya çıkışındaki bu uçak hızı potansiyeline dair güçlü bir işarettir, ancak çok daha önemli olan pratikte nasıl performans gösterdiğidir. Teorinin sağlam olduğunu gördük. Yalnızca kağıt üzerinde mantıklı olmak ötesinde, politika içi RL ile öz-derstilleme arasındaki simbiyoz, literatürdeki sayısız deney ile doğrulanmaktadır. Dikkatimizi şimdi Shenfeld ve arkadaşlarının [1] ve Zhao ve arkadaşlarının [2] gerçekleştirdiği bazı örneklere çevireceğiz.
Self-distillation enables continual learning [1] çalışmasında Shenfeld ve arkadaşları, modeli ardışık olarak üç ayrı, oldukça farklı görevde eğitir; bir kez SFT ile bir kez de kendi SDFT çerçeveleriyle. Her eğitim yöntemi altındaki modelin görev başına performansını eğitim boyunca karşılaştırırlar.
SFT, kitaplık felaket unutmasını sergiler. Her an için eğitilen görev dışındaki görevlerdeki doğruluk, eğitilmemiş modelin temel değerinin belirgin biçimde altına düşer. Belirli bir göreve odaklanırken elde edilen herhangi bir iyileşme, bir sonraki göreve geçildiğinde hızla geri alınır [1].
SDFT, öte yandan, yalnızca her görev için hedeflenen eğitim öncesinde temel performansı korumakla kalmaz, ayrıca görev özelinde elde edilen iyileşmeyi tutarlı biçimde korur; ilk görevde, diğer iki göreve ayrılan yüzlerce eğitim adımından sonra bile belirgin bir düşüş (yani unutma) görülmez. Görevler arası müdahale bir yana, SDFT’nin görev özelinde iyileşmesi, her yeni görevde SFT’den daha yüksek bir doğruluk sağlar [1].
Zhao ve arkadaşlarının [2] deneyleri, yeni görev performansı ve token verimliliğine odaklanır; modelleri kendi OPSD çerçeveleriyle, iyi yerleşmiş GRPO [11] ve SFT ile eğitir ve karşılaştırırlar. OPSD’de öğretmen, ayrıcalıklı bilgi olarak uzman çıktılarını (rollout) alır. SFT’de ise model, uzman çıktılarını referans çözümler kullanarak eğitilir. Dolayısıyla OPSD ve SFT, aldıkları bilgi açısından birbirine yaklaşık olarak karşılaştırılabilirdir. Oysa GRPO çok daha az bilgi alır. GRPO kullanarak model, uzman çıktılarını aslında yalnızca nihai cevapların ikili karşılaştırmasında kullanır; bu nedenle eğitim yöntemleri arasındaki karşılaştırma karışık (confounded) hale gelir.
Yine de Zhao ve arkadaşları, OPSD’nin eğitim sırasında token verimliliğinde GRPO’ya göre belirgin biçimde geliştiğini, 100 eğitim adımında çok daha az token kullanarak ve bu 100 adımın ardından AIME24, AIME25 ve HMMT25 puanlamalarında GRPO’yu belirgin biçimde geride bırakarak bunu başardığını gösterir [2]. Bu büyük ölçüde OPSD’nin uzman gösterimlerini tamamıyla avantajına kullanması, GRPO’nun ise yalnızca nihai cevapları kullanmasıyla açıklanabilir. Önemli bir bilgi asimetrisi söz konusu.
OPS’in GRPO’ya göre kazandırdığı performans avantajı, her iki yöntemin de 100 yerine 500 eğitim adımıyla çalıştırılması durumunda çok daha mütevazı hale geliyor; özellikle test edilen daha büyük modeller olan Qwen-3-8B ve Qwen-3-4B üzerinde bu durum belirgin. GRPO, Qwen-3-8B ile HMMT25 üzerinde OPSD’yi geride bırakabiliyor. Buna rağmen, daha küçük Qwen-3-1.7B üzerinde OPS lehine olan fark belirginliğini koruyor. OPSD aynı zamanda tüm alanlarda SFT’yi de kolayca geride bırakıyor [2].
…Ancak Bu Da Bir Sihirli Değnek Değil
OPS’in LLM’lerin eski bilgileri unutmadan yeni yetenekler öğrenmelerini sağlamada umut verici göründüğü doğruysa, yine de sınırlamalarından uzak değil. Nicolicioiu ve arkasının [4] ortaya attığı merkezî sınırlamalardan biri, OPSD rejimlerinde gösterimlerin LLM çıktılarından örneklenmesi durumunda ortaya çıkan eğitimli öğrenci çıktılarında çeşitlilik kaybı olup, kendisine Örneklenmiş Gösterimlerle Öz-Öğretme (SDSD) adı veriliyor.
İki çeşitlilik biçimini tanımlıyor ve ölçüyorlar: işlevsel ve anlamsal. İlki, bir modelin bir problemi çözme yönündeki ek denemelerinin ona gerçekten o problemi çözmede ne kadar yardımcı olduğuyla ilgili. Bir modelin işlevsel çeşitliliğinin ölçütü, onun pass@k eğrisinin eğimidir (yani, test kümesindeki her problem için k deneme yapıldığında, modellerin problemlerin yüzde kaçı başarıyla çözdüğü). Anlamsal çeşitlilik ise bir modelin çıktılarının genel strateji açısından ne kadar farklı olduğu derecesidir. Yazarlar bunu, birden fazla distinct çözüm yaklaşımını kolaylaştıracak şekilde özel olarak kurgulanmış bir görev kullanarak ölçüyorlar [4].
Sonuçları, hem işlevsel hem de anlamsal çeşitliliğin SDSD ile eğitimli modellerde, GRPO ile eğitimli modellere göre daha düşük olduğunu gösteriyor. SDSD ile eğitimli modellerin pass@k eğrileri, birkaç farklı benchmark üzerinde neredeyse tamamen düz seyrediyor. Bu da, SDSD ile eğitimli bir modelin bir problemi her seferinde aynı şekilde çözmeye çalıştığı anlamına geliyor; yani ilk seferde çözemezse, ikinci ya da hatta 64. seferde çözmesi için pek şans kalmıyor. SDSD ile eğitimli modeller aynı zamanda yazarların anlamsal çeşitlilik görevinde de önemli ölçüde daha kötü sonuç veriyor [4]. Pratikte bu, bu modellerin basit ajansal görevler ya da matematiksel teorem ispatı gibi, birden fazla rollout üretip bunlardan en iyisini LLM jüji değerlendirmesiyle seçmenin yaygın olduğu kullanım alanları için doğuştan daha az uygun olabileceği anlamına geliyor.
Nicolicioiu ve arkadaşları bu çeşitlilik kaybını, modelin önyargılarının eğitim sırasında birikmesine bağlıyor. Bu süreçteki rollerine işaret ederek on-policy RL’nin genel mod-araştırma eğilimini öne çıkarıyorlar. “Mod-araştırma”, on-policy RL’nin modelin olasılık kütlesini dağılımın tepelerinde yoğunlaştırması ve bu da yazarların “muhtemel-olanın-daha-muhtemel-hale-getirmesi” dediği davranışa yol açması anlamına geliyor. Bu davranış, öğretmenin, ayrıcalıklı bilgisi olan örneklenmiş gösterime benzeyen çözümlere karşı aşırı derecede bir tercih taşımasıyla daha da şiddetleniyor. Öğretmen, gösterime benzeyen örneklenmiş öğrenci rollout’lerini ödüllendiriyor, benzemeyenleri ise aynı derecede doğru olsalar bile cezalandırıyor [4].
Başka bir önemli soru, Shenfeld ve arkadaşlarının [1] ve Zhao ve arkadaşlarının [2] erken dönem makalelerinde tanıklık ettiği sonuçların düşünen modellerle tekrarlanıp lanamayacağıdır. Söz konusu deneylerin tümü, talimat-ayarlamalı (düşünmeyen) modeller kullanılarak gerçekleştirildi. Ancak düşünen modeller, zorlu muhakeme görevlerinde benzersiz biçimde yetenekli olduklarını kanıtladılar ve evrensel olarak benchmark performans lider tablolarının başını çektiler. OPSD, bunların eğitiminden sonra da bunlarda kullanılabiliyorsa, bu son derece değerli olurdu.
Ne yazık ki, Kaur ve arkadaşları [5], OPSD’nin düşünen modellere genellenmediğini gösteriyorler; en azından doğrudan öyle değil. AIME24, AIME25 ve HMMT25 benchmark’larında beş farklı düşünen modelle deneyler yürütüyorlar. Merkezî bulmaları, OPSD’nin her bir modelde ve her bir benchmark’ta avg@16’yı (16 eğitimli öğrenci rollout’inin ortalama doğruluğu) genellikle beş puandan fazla, bazen de neredeyse on puan düşürmesi. Bunun, öğretmenin öğrencinin düşünme izindeki dönüm noktalarında verdiği sinyalden kaynaklandığını, muhtemelen öğrencinin kusurlu bir çözüm yoluna bağlanmadan önce kendi kendini düzeltmesine kapıyı kapatmasını sağladığını varsayıyorlar [5].
Sonuç
Sürekli öğrenimin ne olduğunu ve bunun neden ulaşılması zor bir hedef olduğunu anlattıktan sonra, On-Policy Self-Distillation yaklaşımlarını iki temel bileşenlerine ayırdık: kendiliğinden uzaklaştırma (self-distillation) ve on-policy pekiştirmeli öğrenme, özellikle Shenfeld ve ark.[1] tarafından sunulan SDFT çerçevesi etrafında. Bu yönlerin her birini ilgili daha geniş makine öğrenmesi bağlamında inceledik; kendiliğinden uzaklaştırmanın klasik denetimli ince ayarından nasıl ayrıldığını, on-policy RL’nin off-policy RL’den nasıl ayrıldığını ve bunların her birinin tek başına felaket unutmayı (catastrophic forgetting) azaltmaya nasıl katkı sağladığını kavradık.
Teoriyi takip ederek, literatürdeki OPSD’ye dair umut verici deneyysel sonuçlara baktık ve nihayetinde OPSD’nin kutudan çıkar çıkmaz sahip olduğu temel sınırlamalara, yani bileşik önyargılar yoluyla çıktı çeşitliliğinin kaybına ve açıkça gözlemlenen düşünme modellerinde bozulmaya dokunduk.
Bu makaleyi beğenirdiyseniz, gelecekteki makaleler ve projelerden haberdar olmak için LinkedIn’de beni takip etmeyi düşünürsünüz. Bu yazı boyunca beni ağırlayan ve OPSD ve daha fazlası üzerine uç nokta araştırmalara katkıda bulunma fırsatı veren INSAIT ekibine özel teşekkürler.
···
Alıntılar
(1) Zhao ve ark.[2], OPSD ile kendi makalelerinde önerdikleri spesifik algoritmayı kastederler. Buna karşılık, bu makale terimi, aynı ilkeler üzerine kurulu çok sayıda algoritmadan herhangi biri için daha geniş anlamda kullanır.
(2) Bir modelin önceden eğitme veri_setinde yalnızca sınırlı görünümlere sahip bir dil.
(3) SDFT, makalede ters KL ıraklığını (KL divergence) kullanacak şekilde tanımlandığı ve teorik sonuçlarının bu varsayım altında ispatlandığı [1] halde, betimlenen deneyler makalenin GitHub deposuna [8] göre ilerleyici KL ıraklığı kullanılarak gerçekleştirilmiştir.
(4) Wolfe’ın Deep (Learning) Focus’u, AI araştırmalarının uç noktasıyla ilgilenen herkes için muhteşem ve son derece önerilen bir kaynaktır.
[1] Shenfeld, I., Damani, M., Hübotter, J. ve Agrawal, P. Self-distillation enables continual learning. In Proceedings of the 43rd International Conference on Machine Learning, volume 306 of Proceedings of Machine Learning Research, Seoul, South Korea, 2026. PMLR. URL: https://doi.org/10.48550/arXiv.2601.19897.
[2] Zhao, S., Xie, Z., Liu, M., Huang, J., Pang, G., Chen, F. ve Grover, A. Self-distilled reasoner: On-policy self-distillation for large language models. In Proceedings of the 43rd International Conference on Machine Learning, 2026. URL: https://openreview.net/forum?id=Jpxfof0EaS.
[3] Cui, F., Li, S. ve Li, J. A brief overview: On-policy self-distillation in large language models. arXiv preprint arXiv:2605.18141, 2026. URL: https://doi.org/10.48550/arXiv.2605.18141.
[4] Nicolicioiu, A. L., Pezeshki, M. ve Courville, A. On-policy self-distillation with sampled demonstrations reduces output diversity. In ICML 2026 Workshop on Foundations of Deep Generative Models: Understanding Memorization, Generalization, and Reasoning, 2026. URL: https://openreview.net/forum?id=PAz606dOEx.
[5] Kaur, S., Ri, N., He, Y., Fowl, L. H. ve Arora, S. Rethinking On-Policy Self-Distillation for Thinking Models. ICML 2026 Workshop on Foundations of Deep Generative Models: Understanding Memorization, Generalization, and Reasoning, 2026. URL: https://openreview.net/forum?id=VhCJItwQHn.
[6] Seetharaman, D. ve Arámburo, F. OpenAI says China’s DeepSeek trained its AI by distilling US models, memo shows. In Reuters, 2026. URL: https://www.reuters.com/world/china/openai-accuses-deepseek-distilling-us-models-gain-advantage-bloomberg-news-2026-02-12/.
[7] Feng, K., Shen, X., Wang, W., Zhuang, X., Tang, Y., Zhang, Q. ve Ding, K. SciKnowEval: Evaluating multi-level scientific knowledge of large language models. arXiv preprint arXiv:2406.09098, 2025. URL: https://arxiv.org/abs/2406.09098.
[8] Shenfeld, I. Self-Distillation. GitHub, 2026. URL: https://github.com/idanshen/Self-Distillation.
[9] Wolfe, C. R. Online versus Offline RL for LLMs. Deep (Learning) Focus, 2025. URL: https://cameronrwolfe.substack.com/p/online-rl.
[10] Shenfeld, I., Pari, J. ve Agrawal, P. RL’s Razor: Why Online Reinforcement Learning Forgets Less. In Proceedings of the 14th International Conference on Learning Representations, Rio de Janeiro, Brazil, 2026. URL: https://doi.org/10.48550/arXiv.2509.04259.
[11] Wolfe, C. R. Group Relative Policy Optimization (GRPO). Deep (Learning) Focus, 2025. URL: https://cameronrwolfe.substack.com/p/grpo.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.