

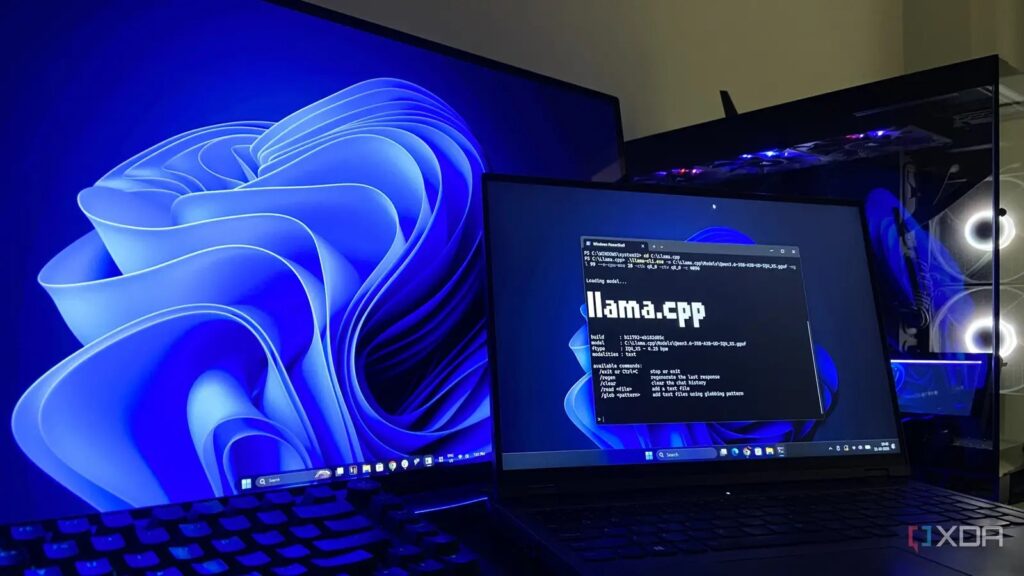
PC’nizde yapabileceğiniz şeylerin çoğu, GPU‘nuzun sahip olduğu VRAM miktarıyla sınırlanmış gibi görünür. Oyunlarınızın hangi çözünürlükte çalışacağını, zaman çizelgesinin ara sıra takılmadan düzenleyebileceğiniz video projesinin ne kadar büyük olacağını ve en son olarak da hangi yerel AI modellerini kendi başınıza barındırabileceğinizi belirler. Bu örneklerin çoğu katı sınırlar gibi görünse de, neredeyse hepsinin üstesinden gelmek için farklı yollar var.
Bu geçici çözümlerin en basitleri, yerel AI çıkarımıyla ilgili. Zaten Lenovo Legion 5’i, 16GB GDDR6X’e sahip RTX 4070 Ti Super’da çalıştırdığım bazı modelleri çalıştıramayacak diye zihnimde uzun zamandır elemiştim. Ancak son birkaç haftalık test sırasında, bu dev modelleri makul hızlarda kendi başına çalıştırmasına yardımcı olan bir geçici çözümü tesadüfen buldum.
Llama-bench, modeli ince ayar etmek için gereken tüm bilgiye sahipti
Dizüstü bilgisayarımın 8GB GPU’sunun dayanıp dayanamayacağını görmek tek komut aldı
Herhangi bir bayrağı kullanmadan önce, 8GB RTX 3070 dizüstü GPU’mun gerçekten kendisi için inşa edildiği modellerden daha büyük bir şeyde çıkarımı sürdürüp sürdüremeyeceğini kontrol etmek için dürüst ve tekrarlanabilir bir cevap istedim. Bunu kontrol etmek için llama.cpp’nin llama-bench adlı aracından daha iyi bir yol olamayacağını iddia edebilirim.

Bu test için dizüstü bilgisayarımdaki modelleri çalıştırdım; bunlar IQ4_XS nicelemesinde Qwen3.6-27B ve UD-IQ4_XS nicelemesinde Qwen3.6-35B-A3B içeriyordu. Neden uzman katmanları RAM’e yüklenemeyen yoğun bir model kullandığımı soruyorsanız, çünkü referans olarak kullanılıyor ve buna göre kıyaslama yapılıyor. Teste başlamak için aşağıdaki komutu kullandım:
.\llama-bench.exe -m Qwen3.6-27B-IQ4_XS.gguf -m Qwen3.6-35B-A3B-UD-IQ4_XS.gguf -ngl 99 -ncmoe 0,28 -p 512 -n 128 -r 3 -ctk q8_0 -ctv q8_0
Bu, her iki modelde de dört yapılandırmayı kıyaslıyor; her biri –n-cpu-moe 0 (yükleme yok) ve 28 (28 katmanın değeri kadar uzman ağırlığının sistem RAM’ine taşınması) için. Her bayrağın burada ne anlama geldiğini anlamak için bir an durup düşünmek değer.
-ngl 99, llama.cpp’ye her katmanı GPU’ya yüklemeyi dener. -p 512 -n 128, her çalıştırma için 512 token’lık bir ön doldurma ardından 128 token’lık bir üretimi ayarlar; bunlar llama-bench’in varsayılanlarıdır ve kararlı sayılar üretmek için yeterlidir. Ardından -r 3, her yapılandırmayı üç kez tekrarlar, böylece tek bir şanslı çalıştırma veri setini bulandıramaz. Son olarak -ctk q8_0 -ctv q8_0, KV önbelleğini 8 bite niceler.
Aşağıda, çalıştırma sonrasında llama-bench’in ürettiği sonuçlar yer alıyor.
|
Model |
RAM içindeki MoE katmanları |
Prompt işleme (saniyede token) |
Üretim hızı (saniyede token) |
|
Qwen3.6-27B (Dense, IQ4_XS, 14.37GiB) |
Uygulanamaz (Dense model) |
||
|
Qwen3.6-35B-A3B (MoE, UD-IQ4_XS, 16.50GiB) |
|||
|
Qwen3.6-35B-A3B (MoE, UD-IQ4_XS, 16.50GiB) |
Tek bir llama.cpp bayrağı, 8GB laptopumu 35B çıkarım makinesine çevirdi
Masaüstü optimizasyonu, laptopumda tamamen farklı bir seviye açtı
Uzun süre, tıpkı diğer çoğu kullanıcı gibi, yerel AI’ya dair zihnimdeki model basit, yine de yanıltıcıydı. Ciddi modelleri yalnızca masaüstümün çalıştırabileceğini, laptopun ise VRAM’e soubilen küçük Gemma 4 varyantlarıyla yetinmesi gerektiğini düşünüyordum. Bu deney, bu beklentiyi belki de olabilecek en iyi şekilde tamamen ters yüz etti.
Gerçekten de, saniyede 4 token’i zorlayan bir 35B mixture-of-experts modelini, bayraklar kullanarak aynı donanımda saniyede 33 token’e çıkarabilmek mümkün. Saniyede yaklaşık 33 token, benden hızlı okumamdan çok daha hızlı; yani model, rahatça çalışabileceğim bir hızda yanıt veriyor.
En iyi modeller artık yalnızca masaüstüm için ayrılmış değil
Bu optimizasyonun benim için önem taşıyan, ve benden benzer kullanıcıların çoğu için önem taşıyacak şekilde değiştirdiği tek şey, sağladığı erişim seviyesi olabilir. Çoğu kullanıcı, 35B bir MoE modelini yüklemenin, evde masalarında, workstation’larının yanında oturmak anlamına geleceğini düşünecektir; ancak doğru bayraklar ve doğru optimizasyonlarla, ister bir uçakta, ister bir otelde, isterse ağ bağlantısı olmayan bir yerde olsun, 35B bir modeli yanınızda taşımanız mümkün. Bu, llama.cpp’in benim için mümkün kıldığı önemli bir şey.
Llama.cpp, büyük dil modellerini bilgisayarınızda yerel olarak çalıştıran açık kaynaklı bir çerçevedir.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.