

9 Ekim’de Vals AI, bir kodlama ajanları ekibinin fiyata değip değmediğine dair bir test yayınladı [1]. GPT 6 Sol ve Claude Opus 5.5’e, her iki modeli ayrı ayrı ve bir liderin yapımın parçalarını alt ajanlara devrettiği bir ekip içinde, orta ve maksimum akıl yürütme çabasıyla, her biri belirli özelliklerden 50 web uygulaması inşa etmelerini söylediler. Eipler 1.8 ile 5.1 arasında değişen oranlarda daha pahalıya mal oldu. Dört ekip-tekili karşılaştırmasının yalnızca biri istatistiksel olarak anlamlıydı: orta çaba düzeyindeki Sol, 7.3 puan kazandı. Sol için tekil ajanın akıl yürütme çabasını ortadan maximum’a çıkarmak 11.4 puan ekledi; bu, orta çaba düzeyinde bir ekibin kattığı 7.3 puandan fazla [1].
Bu çalışma bir işi parçalara ayırmayla ilgili, dolayısıyla ajanların aynı hataları yapıp yapmadıkları konusunda doğrudan bir şey söylemiyor. Yine de bana bir matematçinin üstlenebileceği bir soru bıraktı: Bir oya başka bir model eklediğinde, aslında kaç bağımsız görüş ekliyorsun?
Plan, bir oyun vaat ettiklerine bakmak, nasıl başarısız olabileceğini simüle etmek, başarısızlığa bir formül oturtmak ve sonra bunu altı gerçek model üzerinde ölçmek.

Bir oyun size ne sağlamalı
Klasik yanıt, 1785 tarihli Condorcet’in jüri teoremidir [2]. Her seçmenin p > 1/2 olasılıyla doğru olunduğunu ve seçmenlerin bağımsız olduğunu varsayın. k seçmenin çoğunluğunun doğru olma olasılığı
P
(
çoğunluk doğru
)
=
∑
j
=
⌊
k
/
2
⌋
+
1
k
(
k
j
)
p
j
(
1
−
p
)
k
−
j
P(\text{majority right}) = \sum_{j=\lfloor k/2 \rfloor + 1}^{k} \binom{k}{j}\, p^{j}(1-p)^{k-j}
P
(
çoğunluk doğru
)
=
j
=
⌊
k
/2
⌋
+
∑
k
(
j
k
)
p
j
(
−
p
)
k
−
j
ve k büyüdükçe 1’e yaklaşır. p = 0.7 için, üç seçmen zamanın %78.4’ünde doğru, beşi %83.7, dokuzu %90.1, yirmi beşi %98.3’tür.
Şekil 1, formülü bireysel doğruluk düzeyinin üçünde çiziyor.
Küçük bir simülasyon
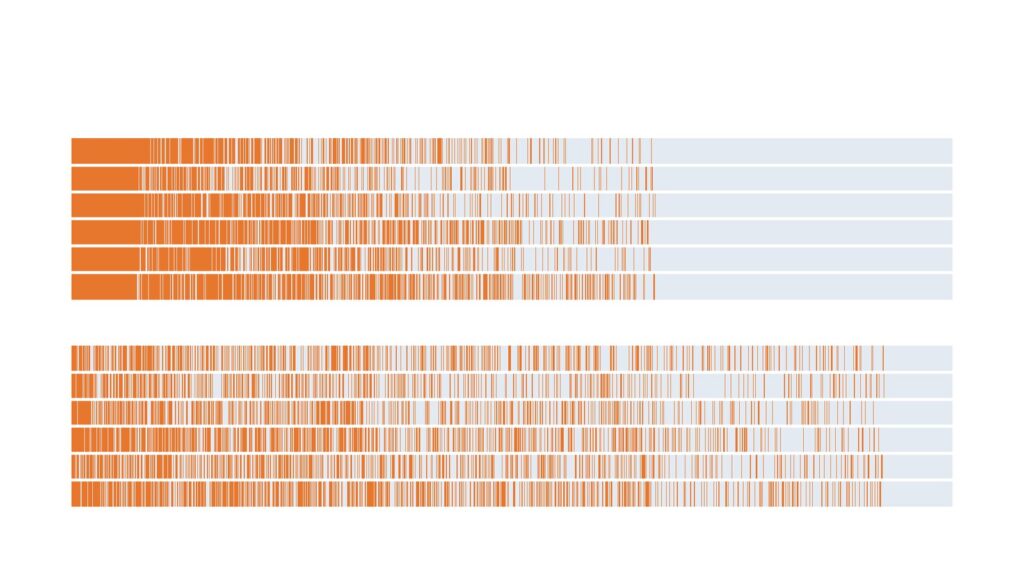
Farkı görmek için beş modelden oluşan iki panel simüle ettim. Her model zamanın %70’inde doğru. İlk panelde her modelin hataları diğerlerinden bağımsız olarak sorulara isabet ediyor. İkinci panelde hatalar örtüşüyor: bazı sorular herkes için zor, dolayısıyla modeller bu sorulara birlikte başarısız oluyor. Şekil 2, her panelden 40 soruyu gösteriyor. Her satır bir modeli, her sütun bir soruyu temsil ediyor ve turuncu yanlış anlamına geliyor. Alt satır ise çoğunluk oyudur.
Beş modelden oluşan iki simüle edilmiş panel, her biri zamanın %70’inde doğru. Sol: hatalar bağımsız olarak isabet ediyor. Sağ: hatalar örtüşüyor. Turuncu yanlış anlamına geliyor. Resim yazarın
Model başına iki panel özdeş. Çoğunluk oyu öyle değil. Bağımsız hatalarla zamanın %83.8’inde doğru, bu da Condorcet formülünün öngördüğü değerdir (%83.7). Örtüşen hatalarla ise zamanın %74.4’ünde doğru. Tek bir model bile kötüleşmeden dokuzdan fazla doğruluk puanı kayboluyor ve panel, üye sayısından daha az görüşe sahip oluyor: ilk durumda 5.0, ikinci durumda 2.2 etkin oy. Sonraki bölüm, bu iki sayının nereden geldiğini açıklıyor.
Resimden sayıya
Bir resim bir ölçüm değildir, bu yüzden işe yarayan standart yöntem sayısal bir değer verecek şekilde başlar. Her model ve her soru için modelin hatası varsa 1, doğruysa 0 kaydedilir. Bu iki sütunun arasındaki korelasyon phi katsayısı, φ’dir. İki modelin hataları alakasızsa 0’a, tam olarak aynı sorularda hata yaparsa 1’e eşittir.
Hatalarının varyansı σ² olan ve çiftlerinin tamamı φ korelasyonuna sahip, hatalarını gösteren E₁’inden Eₖ’ya kadar k oyucu düşünün. Ortalamalarının ortalama hatasının varyansı şöyle olur:
Varyans(1/k · Σᵢ₌₁ᵏ Eᵢ) = (σ²/k)[1 + (k−1)φ]
Bağımsız oyucular n tanesi için σ²/n verir, bu yüzden etkin oy sayısı, bununla eşleşen n olarak tanımlanır:
n_eff = k / [1 + (k−1)φ]
φ=0 ise n_eff = k’dir ve her oyucu sayılır. k büyüdükçe n_eff, 1/φ’ye yaklaşır ve orada durur. φ=0.3 için yedi model 2.5 oy değerindedir ve onlar gibi eklenen hiçbir model sayısı 3.3’ü geçemez. Anket istatisyencileri, Kish’in “tasarım etkisi” dediği 1+(k−1)φ’nin ne olduğunu gösterdiği kümelemeli örneklemelerde aynı aritmetiği kullanır [3].
Belirli bir korelasyonun değeri
Formül uygulamaya kolay, bu yüzden onu bir değer tablosu olarak sunuyorum. Satırlar ortalamalı hata korelasyonunu, sütunlar model sayısını, her hücre ise etkin oy sayısını gösterir. Son sütun, hiçbir ek model sayısının aşamayacağı tavan değerdir.
0.3 korelasyon mütevazı görünür, ancak on modeli üçten azmış gibi davranırır. Yukarıdaki simülasyonda örtüşen panel ortalamalı 0.31 korelasyonuna sahiptir ve bu da beş modelini 2.2 etkin oya indirir.
Şekil 3 aynı tabloyu eğriler olarak çizer. Her biri tavanına doğru bükülür ve korelasyon ne kadar yüksekse, o kadar erken düzleşir.
Dört hata korelasyonu için model sayısına karşı etkin oy. Kesikli çizgiler her tavanı işaretler. Resim yazarın
Zaten ölçülen ne var
İki güncel makale bunu dil modellerinde ölçtü. Kim ve arkadaşları 350’den fazla modeli karşılaştırdı ve bir liderlik tablosu veri setinde, iki modelin ikisi de yanlış yaptığında %60 oranında uyuştuğunu ve daha büyük, daha doğru modellerin hatalarının geliştiriciler arasında bile yüksek derecede korelasyonlu olduğunu buldu [4]. Kohli, LLM hakemlerinden oluşan panelleri Kish etkin örneklem boyutuyla ölçtü ve yedi aileden dokuz sınır ötesi modelin doğal dil çıkarımında yaklaşık iki bağımsız oy değeri bilgi taşıdığını buldu [5]. Yakın zamanda paylaşılan bir yazı, 300 cümle çifti üzerinde beş hakemle bu ölçümü tekrarladı ve Kohli’nin aralığına düştü [6].
Herkesin aynı sayıları, kaymalı nokta gürültüsüne kadar, tekrarlayabileceği bir sürüm istediğim için açık modeller kullandım ve yanıtlarını örneklemek yerine olasılık olarak okudum. Ayrıca bir yanlılığı taklit edebilen önyargı için bir kontrol ekledim: her modele cevap seçeneklerinin kendi rastlantısal sıralaması verildi.
Kurulum
Şekil 4, detaylardan önce deneyin tamamını ortaya koyar.
Sınav
Sınav MMLU’dur; ilkokul matematiğinden yasa kadar uzanan 57 çoktan seçmeli konu [7]. Konular üzerinde eşit dağılan 1.500 soru çektim ve birbirinin seçeneklerine atıf yapan soruları (‘bunların tümü’ gibi) kenara koydum, çünkü seçeneklerin karıştırılması onları bozar.
Modeller
Paneller, beş geliştiriciden gelen 3 ila 4 milyar parametreli altı açık modeli içeriyor (Tablo 1). Llama 3.2 3B’yi de dahil etmeyi planlıyordum, ancak erişimi kilitli indirme başarısız olduğu için panellerde yer almıyor. Açık ağırlıklar, yanıtları örneklemek yerine kesin olasılıkları okumamı sağlıyor.
Örneklemeye olmadan yanıtları okumak
Her modele standart beş örnekli MMLU soru kalıbı veriliyor (beş örneğin sığmadığı soruların yaklaşık %3,5’inde üç veya dört örnek, 2.048 token sınırında) ve ben modelin sıradaki token’ın A, B, C veya D olma olasılığını ne kadar verdiğini okuyorum. Ana deneyde hiçbir şey örneklenmiyor, bu yüzden yakın eşitliklerde yüzel sayı gürültüsü hariç bir yeniden çalıştırma aynı yanıtları vermelidir. İki seçenek arasında kesin eşitlikler nadirdir ve önceki seçeneğe atanır.
E harf önyargısının ortadan kaldırılması
Bir detay göründüğünden daha fazla önem taşıyor. Önceki çalışmalar, LLM’lerin belirli seçenek harflerini tercih ettiğini buldu; bunun nedeni çoğuyla modelin belirli harf token’larına a priori daha yüksek olasılık vermesidir [8]. A harfine doğru eğilen iki model, bildikleri şeyden bağımsız nedenlerle yanlış yanıtlarda uzlaşır. Bunu ortadan kaldırmak için her model her soruyu seçeneklerinin kendi rastgele sıralamasıyla görür ve ben herhangi bir şeyi karşıştırmadan önce yanıtı orijinal seçeneğe geri döndürüyorum. Denediğim en zayıf model, bunun neden önemli olduğunu açıklıyor: AI2’den bir milyar parametreli bir model, doğru cevabın herhangi bir harfe eşit olasılıkla düşeceği halde yanıtlarının %74’ünü A veya B’ye koyuyordu. Kontrol olarak, herkesi orijinal sıralamada da çalıştırdım.
Ölçüm
Ölçümün kendisi birkaç satırdan ibaret:
python
import
numpy
as
np
def
effective_votes
(pred, answer):
# pred: (n_questions, k_models) array of the option each model chose
# answer: (n_questions,) array of the correct option
errors
=
(pred
!=
answer[:,
None
]).astype(
float
)
# 1 where a model is wrong
phi
=
np.corrcoef(errors.T)
# pairwise error correlation
k
=
errors.shape[
]
phi_bar
=
(phi.sum()
k)
/
(k
(k
))
# average of the off-diagonal entries
return
k
/
(
+
(k
)
phi_bar), phi_bar
İşlev dört şey yapıyor. Her yanlış cevabı işaretliyor, bu işaretleri her model çifti için ilişkilendiriyor, çift ilişkilendirmeleri ortalamaya alıyor ve bu ortalamayı formüle koyuyor. Geri kalan her şey (soru kalıpları, seçenek karıştırması, bootstrap aralıkları) bunun etrafındaki altyapı işi.
Ne sıklıkla birlikte hata yapıyorlar?
Tablo 1. 1.500 MMLU sorusunda doğruluk, her model kendi rastgele seçenek sıralamasıyla gösteriliyor. Aralıklar %95 Wilson aralıklarıdır. Son satır, %50’nin altına skor verdiği için panel analizinden çıkarıldı.
Panellerdeki en doğru model %72,7 skor alırken, en az doğru model %58,3 alıyor; dört seçenek arasında tahmin etmek için bu oran %25. Şekil 5, panellerin bir oturma planı: her hücre bir model çiftidir ve ne kadar koyuysa, o iki modelin aynı soruları ne kadar sık ıskalağı gösterir.
Her model çifti için hata ilişkilendirmesi (φ). Koyu olmak, iki modelin aynı soruları daha sık ıskalağını gösterir. Resim yazarın.
Paneller ne kadar oy kullandı?
φˉ formüle yerleştirildiğinde, altı model neff=1.96 bağımsız oy değerinde (95% aralık 1.88 ile 2.04). Her çiftin eşit derecede korele olduğunu varsaymayan, korelasyon matrisinin en büyük özdeğere bölünen k ile hesaplanan ikinci bir tahmin de 1.96 sonucunu verir. Şekil 6, her panel boyutu için neff’yi gösteriyor; tıklı çizgi olarak 1/φˉ = 2.4 tavan değeri belirtiliyor. Eklenen her model, bir öncekinden daha az katkı sağlıyor: bir modelden ikiye geçmek 0.4 geçerli oy eklerken, beşten altye geçiş 0.07 ekliyor.
Modeller sayısına karşı geçerli bağımsız oy sayısı. Kesikli çapraz çizgi, bağımsız oyucuların vereceği değeri gösteriyor. Görsel yazarın
Oylar, yalnızca cevabı değiştirirlerse anlamlıdır; bu yüzden oyu ayrıca kurdum. Her boyut için mümkün olan her panelde en sık verilen cevabı aldım ve bunu aynı bireysel doğruluk düzeyine sahip bağımsız oyucuların elde edeceği doğrulukla karşılaştırdım. Bu taban değeri tam olarak hesapladım: yanlış yapan bir oyucunun üç yanlış seçenek arasından düzgün rastgele bir seçim yaptığı varsayımıyla ve tablonun net görünmesi için tek sayılı panel boyutlarını kullandım.
Panel boyutuna çoğunlik-oyu doğruluğu; bağımsız oyucular (kesikli) ve yalnızca konu zorluğunun paylaşıldığı bir sürüm (tıklı) ile karşılaştırılmış. Görsel yazarın
Beş modelle bağımsız taban değer 87.1%, gerçek oy ise 71.2% (95% aralık 69.2 ile 73.2) oldu; bu da yaklaşık 16 puanlık bir açık. Altı model bir araya geldiğinde 71.8% elde ederken, bağımsız oyucular 90.3% aldı.
En iyi tek model olan Qwen3-4B 72.7% aldı; her model tek oy kullandığında, iki ile altı model arasındaki 57 olası panelden hiçbiri bunu geçemedi. En iyi panel olan üç model, 1.500 sorunun 1.091’inde ona eşitledi.
Yalnızca her modelin ilk tercihini saymak bilgiyi ortadan kaldırır; bu yüzden modellerin olasılıklarını ortalama yöntemini de denedim. Bu daha iyi sonuç verdi: altı model bir araya geldiğinde 73.8%’ye ulaşıldı, bu Qwen3-4B’ye göre 1.1 puanlık bir artış ve 95% aralık -0.8 ile 3.0 puan arasında; geriden seçilen 57 panelden en iyisi ise 74.1%’ye ulaşıyor. İkisi de en iyi tek modelden ayırt edilebilir durumda değil ve her ikisi de düzgün oyla bağımsız oyucuların ulaşacağı 90%’nin belirgin altında kalıyor.
Altı model soruların 35.8’inde hemfikir oldu ve böyle yaptıklarında paylaşılan cevap 5.8% yanlış çıktı (537 sorudan 31’i). Bağımsız oyucular yalnızca 7.8’inde hemfikir olurdu ve böyle yaptıklarında 0.008% yanlış yapardı. Altı model 112 soruda (7.5%) birlikte yanlıştı; aynı doğruluklara sahip bağımsız oyucular bunu ancak yaklaşık ikisinde başarırdı.
Paylaşılan hatanın kaynağı
Bu korelasyonun bir kısmı şaşırtıcı değil. Zor bir konu her model için zordur ve bu tek başına korelasyonlu hatalar üretir. Ne kadarını oluşturduğunu görmek için her modelin sonuçlarını konu başına, her model için ayrı ayrı sorular üzerinden karıştırdım. Bu, her modelin her konudaki kesin doğruluğunu korurken bireysel sorulardaki uyumu yok eder. Yalnızca konu zorluğu kaldığında ortalama hata korelasyonu 0.41’den 0.09’a düşer; yani konu zorluğu bunun yaklaşık beşte birini açıklar ve geride kalanın çoğu bireysel soru düzeyinde yer alır.
Şekil 8, bunu harf yanlılığı kontrolüyle yan yana koyuyor. Paylaşılan seçenek sırasıyla ortalama korelasyon 0.45’tir; her modelin kendi rastgele sırasına sahip olduğu durumda ise 0.41. Bu iki çubuğu ayıran fark, seçenek sırasını paylaşmanın kattığı değerdir ve yaklaşık 0.04’tür; eşleştirilmiş bootstrap bu farkı 0.02 ile 0.06 arasına yerleştiriyor. Panel içindeki harf tercihleri zayıftı: hiçbir model cevaplarının 30’undan fazlasını tek bir harfe vermedi; oysa eşit dağılım 25’dir.
Paylaşılan seçenek sırasıyla, her modelin kendi rastgele sırasıyla, yalnızca konu zorluğunun paylaşıldığı ve bağımsız oyucular için ortalama çiftli hata korelasyonu. Görsel yazarın
Bunun yapamayacağı şey, paylaşılan kör noktayı herkes için yalnızca zor bir sorudan ayırmaktır; çünkü ikisi de aynı öğe üzerinde birkaç modelin başarısız olması gibi görünür. Benchmark kendi gürültüsünü ekler: MMLU sorularının tahmini 6.49’unda hata bulunduğu [9] ve yanlış cevap anahtarı, daha iyi bilen her modeli birlikte yanlış sayar.
Sıfır: Tek modele çok kez sorarsanız ne olur?
Self-consistency, bir modelden birkaç yanıt örnekleme yapar ve en yaygın olanını seçer [10]. Ucuz bir alternatif olarak, her modelin kendi olasılıklarından yanıt harfini birkaç kez çekip oy verebilirsiniz. Şekil 9, bunu farklı modeller arasında yapılan oylamayla karşılaştırır.
Farklı modeller ve tek modelden tekrar tekrar örnekleme için etkin oylar (sol) ve tek oylamaya göre kazanılan doğruluk (sağ). Görsel yazarın.
Tek modelden altı örnekleme ortalamada 1.4 etkin oy değerindedir (1.3 ile 1.7 arasında), sekiz örnekleme ise 1.5 değerindeyken, altı farklı model için bu 2.0’dır. Doğruluk kazancı aynı hikâye anlatır: Tek modelden beş örneklemin oluşturduğu oy, tek bir örneklemin beklenen doğruluğuna göre ortalamada 2.2 puan kazanır (1.3 ile 3.6 arasında), beş farklı model ise ortalamadaki tek modele göre 5.7 puan kazanır. Şekil 9’un sağ paneli, örneklenmiş yanıtın modelin en iyi seçimine göre daha az doğru olması ve iki çizginin aksi halde farklı noktalarda başlaması nedeniyle doğruluk düzeyleri değil, kazançları gösterir.
Olasılıktan çekilen bir harf, örneklenmiş bir düşünce zinciri değildir ve gerçek self-consistency akıl yürütme yollarını örnekleme yapar. Bu karşılaştırma, gerçek self-consistency’nin ne kadar iyi çalıştığı hakkında pek bir şey söylemez. Yalnızca aynı düz okuma altında iki oy kaynağını karşılaştırır.
Bu, ajan ekipleri hakkında ne söyleyip ne söylemez
Vals, bir işi parçalara bölüp paylaşan ekipleri test etti [1]. Ben ise çoktan seçimli sınavlarda aynı soruyu yanıtlayan, küçük açık modeller kullanan oylayıcıları test ettim. Bunların hiçbiri ajan ekipleri hakkında bir hüküm taşımaz. Aktarılan şey aritmetiktir: Bir oy, arkasındaki bağımsız bilgi kadar değerlidir ve bunu ölçen sayı, her modelin hatalarının kaydedildiği etiketlenmiş herhangi bir küme üzerinde hesaplanabilir.
Bir jüri paneli çalıştırıyorsanız ya da ajanların birbirinin işini denetlediği bir ekiptenyseniz, bir üye eklemeden önce birkaç yüz bilinen yanıtlı öğe üzerinde φˉ değerini hesaplayın. Farklı bir geliştiriciden gelen yeni bir model, otomatik olarak yeni bir görüş anlamına gelmez. Bu panelde, geliştirici değiştirmek hata korelasyonunu ancak biraz düşürdü (aynı geliştiriciden bir çift için 0.45, geliştiriciler arasında ortalama 0.41) ve hiçbir model çifti 0.33’ün altına düşmedi. Bir aynı-developer çifti, bunun ne kadar genelleşebileceği hakkında bir şey söylemek için çok azdır. 1/φˉ tavanı, oylayıcı eklemeyi nerede durdurup başka bir şey eklemeye başlamanız gerektiğini de söyler: Bir araç çağrısı, bir bilgi geri çağırma adımı, gerçekten çalıştırılabilecek bir test ya da bir kişi.
Arka plandaki API’lerin arkasında bulunan frontier modeller, harf olasılıkları yerine düşünce zinciri yanıtları ve MMLU’nun [9] manuel olarak tekrar kontrol edilen alt kümesi, bu sayıları bu çalışmadan tahmin edemediğim biçimlerde değiştirirdi.
Modelleri saymak kolaydır. Onlardan kaçının farklı şekillerde yanlış thểbileceğini saymak tek bir korelasyon matrisi alır ve bir sonraki model panele katılmadan önce hesaplanmaya değerdir.
···
[1] Katrina Drozdov, Do Agent Teams Pay Off? A Case Study on Vibe Code Bench (2026), Vals AI. https://www.vals.ai/blogs/multi-agent-vibe-code-bench
[2] Marquis de Condorcet, Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix (1785), Imprimerie Royale
[3] Leslie Kish, Survey Sampling (1965), John Wiley & Sons
[4] Elliot Myunghoon Kim, Avi Garg, Kenny Peng, Nikhil Garg, Correlated Errors in Large Language Models (2025), ICML 2025. https://arxiv.org/abs/2506.07962
[5] Guneet Kohli, Nine Judges, Two Effective Votes: Correlated Errors Undermine LLM Evaluation Panels (2026), arXiv. https://arxiv.org/abs/2605.29800
[6] David J. Knudson, My Four AI Judges Were Worth 1.6 Votes (2026), Level Up Coding. https://levelup.gitconnected.com/my-four-ai-judges-were-worth-1-6-votes-96a84e337405
[7] Dan Hendrycks, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, Jacob Steinhardt, Measuring Massive Multitask Language Understanding (2021), ICLR 2021. https://arxiv.org/abs/2009.03300 (MIT license)
[8] Chujie Zheng, Hao Zhou, Fandong Meng, Jie Zhou, Minlie Huang, Large Language Models Are Not Robust Multiple Choice Selectors (2024), ICLR 2024. https://arxiv.org/abs/2309.03882
[9] Aryo Pradipta Gema et al., Are We Done with MMLU? (2025), NAACL 2025. https://arxiv.org/abs/2406.04127
[10] Xuezhi Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models (2023), ICLR 2023. https://arxiv.org/abs/2203.11171
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.