

Makine Öğrenimi
Kullanışlı boyut, parametre sayısı, kayıp ve doğruluk ile açıklanamayan; gereksizlik, genelleme ve eğitilebilirlik konusunda ne ortaya koyar?
Kullanışlı boyut, makine öğreniminde parametre gereksizliği, Fisher bilgisi ve global ile yerel ölçümler arasındaki fark üzerinden açıklanır.

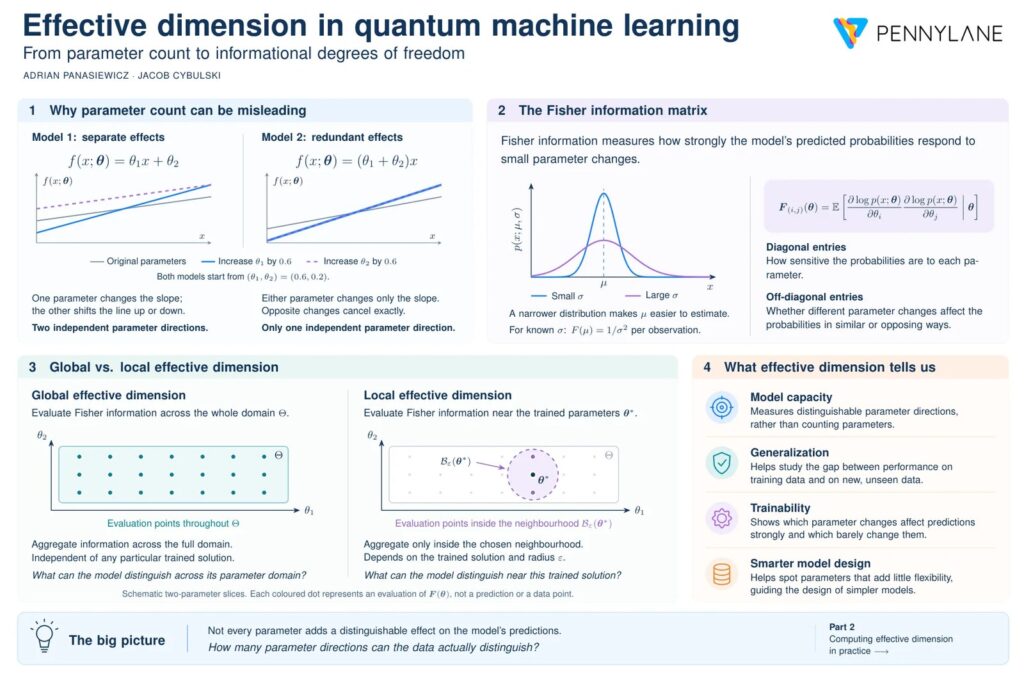
“Etkili boyut: Parametre sayısından bilgi özgürlük derecelerine” başlıklı görsel, dört panelden oluşur.
1. Parametre sayısı yanıltıcı olabilir
İki modelin de iki parametresi vardır. İlk modelde f(x;θ)=θ1x+θ2, bir parametre eğimi diğer parametre de kesimi kontrol eder. Her iki parametre ayrı ayrı artırıldığında farklı tahmin eğrileri oluşur. İkinci modelde f(x;θ)=(θ1+θ2)x ise her iki parametre de aynı eğimi kontrol eder. Her iki parametre de aynı miktar kadar artırıldığında aynı tahminler ortaya çıkar; eşit ve zıt yönlü değişimler ise birbirini götürür. Dolayısıyla ilk model iki bağımsız parametre yönüne sahiptir; ikinci model ise yalnızca birine.
2. Fisher bilgi matrisi
Fisher bilgisi, tahmin edilen olasılıkların küçük parametre değişimlerine ne kadar güçlü tepki verdiğini ölçer. İki Gauss eğrisi aynı ortalamaya sahip olsa da farklı genişliklere sahiptir. Daha dar dağılım, ortalamayı tahmin etmeyi kolaylaştırır. Bilinen bir standart sapma için gözlem başına Fisher bilgisinin ortalamaya dair değeri varyansın tersine eşittir. Matris denklemi, log olasılığın türevlerinin çarpımlarının ortalamasını alır. Kök elemanları bireysel parametrelere duyarlılığı; kök dışı elemanları ise etkilerin birbirleriyle nasıl hizalandığını açıklar.
3. Global ile yerel kullanışlı boyut
İki diyagram, aynı iki boyutlu parametre alanını gösterir. Global diyagramda, renkli değerlendirme noktaları alanı kaplar. Yerel diyagramda ise yalnızca eğitilen parametrelerin çevresindeki dairesel komşuluk içindeki noktalar vurgulanır; onun dışındaki konumlar gri renktedir. Global kullanışlı boyut, Fisher bilgisini parametre alanı boyunca birleştirir. Yerel kullanışlı boyut ise birleştirmeyi seçilen komşulukla sınırlar ve komşuluğun yarıçapına ile eğitilen çözüme bağlıdır. Noktalar, gözlem veya tahmin değil, gösterim amaçlı Fisher bilgi değerlendirme konumlarını temsil eder.
4. Kullanışlı boyut bize ne söyler
Dört uygulama sıralanır: model kapasitesini parametre sayısının ötesinde tanımlamak, görünmeyen verilere genelleme çalışmak, eğitimle ilgili duyarlılığı incelemek ve modelleri tasarlarken gereksizliği belirlemek.
Alt bilgi, merkezdeki soruyu özetler: “Veri gerçekten kaç parametre yönünü ayırt edebilir?” Ayrıca, pratikte kullanışlı boyut hesaplamaya dair ikinci bir bölüme işaret eder.
Bu makale Jacob Cybulski ile ortaklaşa yazılmıştır
Giriş
Bu makale, kullanışlı boyut üzerine iki bölümlü dizinin ilkidir. Burada ölçütün ardındaki sezgi ve teoriyi geliştiriyor ve temel bileşenlerini tanıtıyoruz. 2. Bölümde ise kullanışlı boyut hesaplamasının makine öğrenimi deneylerinde nasıl uygulanacağını göstereceğiz.
Makine öğrenimi modellerinin çoğu, eğitilebilir parametre sayısıyla tanımlanır. Parametre sayısı kullanışlı bir model özelliği olsa da yanıltıcı olabilir.
Bir model, çıktısını gerçekten bağımsız biçimde etkileyen birçok parametre içerebilir. Tersine, kompakt bir model neredeyse her parametreyi farklı ve anlamlı bir biçimde kullanabilir. Kullanışlı boyut, bu farkı nicelendiren bir yoldur.
Daha çok parametre, daha çok kapasite anlamına gelmez
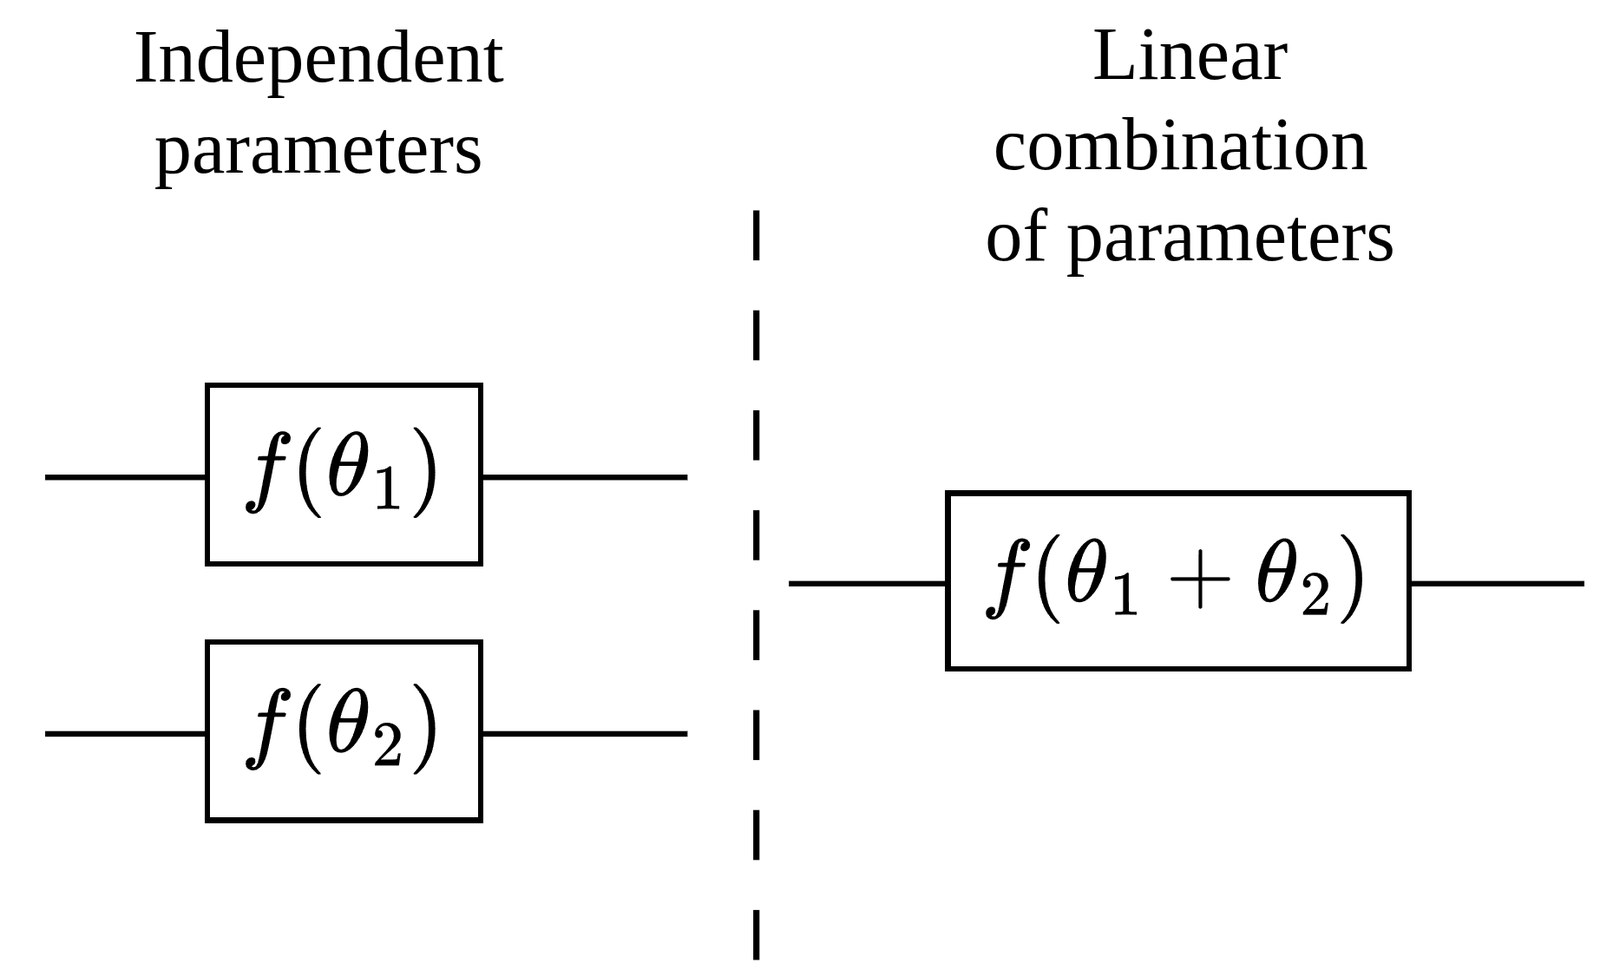
Sade bir örnek düşünelim (Bakın Şekil 1). Parametreleri θ1 ve θ2 olan iki model hayal edelim.
Şekil 1. Bağımsız parametreler, benzersiz fonksiyonel yönler oluştururken; parametrelerin lineer kombinasyonları gereksizlik yaratır. Görsel yazarlara ait.
İlk modelde parametreler çıktısını bağımsız biçimde etkiler. θ1’i değiştirmek, genellikle θ2’i değiştirmekle yeniden üretilemeyen bir etki yaratır. Bu model iki bağımsız parametre “yönü” boyunca değişebilir.
İkinci modelde çıktı yalnızca toplamlarına bağlıdır:
f
(
x
θ
1
θ
2
)
=
f
(
x
θ
1
+
θ
2
)
f(x;\theta_1,\theta_2)=f(x;\theta_1+\theta_2).
f
(
x
θ
θ
)
=
f
(
x
θ
+
θ
)
Burada, birçok parametre çifti tam olarak aynı fonksiyonu üretir. Örneğin, θ1’i c kadar artırmak ve θ2’i c kadar azırmak çıktıyı değiştirmez. Model biçimsel olarak iki parametre içerse de, yalnızca bir serbestlik derecesine sahiptir:
θ
eff
=
θ
1
+
θ
2
\theta_{\text{eff}}=\theta_1+\theta_2.
θ
eff
=
θ
+
θ
Bu örnek merkez fikri gösterir: parametre sayısı, modelin fonksiyonel karmaşıklığını her zaman yansıtmaz.
Etkili boyut neyi ölçer
Etkili boyut, bilgi karmaşıklığının ölçek bağımlı bir ölçüsüdür [1]. Başlangıçta istatistiksel bilgi teorisinde, bir modeldeki gerçekten aktif olan parametre sayısını nicelendirmek için geliştirilmiştir; kullanılabilir veri miktarına dayanarak gereksiz parametre kombinasyonlarını ortadan kaldıran bir koordinat sistemi kurar. Bu yöntem, o zamandan beri klasik ve kuantum makine öğreniminde bir modelin ifade gücü, eğitilebilirliği ve yeni verilere genelleme yeteneğini kesin olarak değerlendirmek için benimsenmiştir.
Genel olarak etkili boyut şu soruyu sorar:
Seçilen bir parametre bölgesi ve veri dağılımı üzerinden, bu model kaç tanınabilir ve bilgi içeren yöne sahiptir?
Bu soru, model doğruluğu, kayıp veya ham parametre sayısı kavramlarına dayanarak yanıtlanabilecek sorulardan farklıdır.
Önemlisi, etkili boyut genelleme ile ilişkilidir. Çerçevenin varsayımları altında, genelleme performansına karmaşıklığa bağlı bir sınır sağlayabilir [2]. İçgörüsel olarak, daha az tanınabilir parametre yönüne sahip bir model, sonlu bir veri kümesindeki rastgele dalgalanmalara uyum sağlamada daha az etkili olmalıdır.
Aynı zamanda eğitilebilirliği analiz etmeye de yardımcı olur. Çok güçlü ifade yeteneğine sahip modeller otomatik olarak eğitilmesi kolay değildir: bazı parametre yönleri çıktı dağılımını neredeyse hiç etkilemeyebilirken, bazıları güçlü şekilde korelasyon gösterebilir. Bu etkiler optimizasyonu kötü koşullandırabilir veya etkili biçimde düzleştirebilir [3]. Ayrıca bu tür modeller, aşırı uyuma (overfitting) daha yatkın olabilir; bu durumda model, görülmeyen verilere aktarılan örüntüler yerine eğitim verisindeki gürültü veya özgün özellikleri yakalar ve bu da zayıf genellemeyle sonuçlanır.
Eğitim ve test kayıpları hâlâ temel tanı araçlarıdır, ancak optimizasyon izine bağlıdırlar. Zayıf bir başlangıç, uygun olmayan bir öğrenme hızı veya zayıf bir optimizasyoncu, eğitilebilir bir mimariyi belirli bir çalışmada eğitilemez gösterebilir. Etkili boyut ise modelin parametre geometrisini veriye göre karakterize eder; bu da onu ampirik eğitim eğrilerinin yerini alan değil, tamamlayıcı bir araç haline getirir [4].
Bu araçların ötesinde, etkili boyut şu nedenle önemlidir: parametre sayısı, modelin gerçekten ne kadar karmaşık olduğunu yanlış biçimde temsil edebilir. Her ek parametre bir maliyet getirir: türevler için daha fazla devre değerlendirmesi, gürültüye daha fazla maruz kalan daha fazla kapı ve optimizasyon için daha büyük bir arama alanı. Bu maliyet, ancak parametre modelin davranışını gerçekten değiştirebileceği bir yöne katkı sağlıyorsa değerlidir. Etkili boyut, böyle yönlerin kaç tane olduğunu tahmin eder ve böylece modelin boyutunun kullanılıp kullanılmadığını gösterir İki model benzer performans gösterdiğinde, genellikle daha az etkili yöne sahip olanı daha iyi seçimdir, çünkü aynı sonucu daha az karmaşıklıkla elde eder. Bu, Ockam’ın usturasıdır: gözlemleri aynı derecede açıklayan daha basit açıklamayı tercih edin. Amaç, her koşula karmaşıklığı minimize etmek değil, karmaşıklığı soruna uygun bir model bulmaktır.
Etkili boyutun hesaplanmasında kullanılan temel araç, Fisher bilgi matrisidir.
Fisher bilgi: içgörü
Fisher bilgi matrisi, model tahminlerinin bir dağılımının parametrelerindeki değişimlere ne kadar hassas olduğunu tanımlar. Başka bir deisle, gözlemlenen verinin modelin istatistiksel profilinin parametreleri hakkında kendine ne kadar bilgi verebileceğini nicelendirir.
Bilinmeyen ortalaması μ ve bilinen standart sapması σ olan bir Gauss dağılımından çekilen örnekleri düşünün
x
∼
N
(
μ
σ
2
)
x\sim\mathcal{N}(\mu,\sigma^2).
x
∼
N
(
μ
σ
)
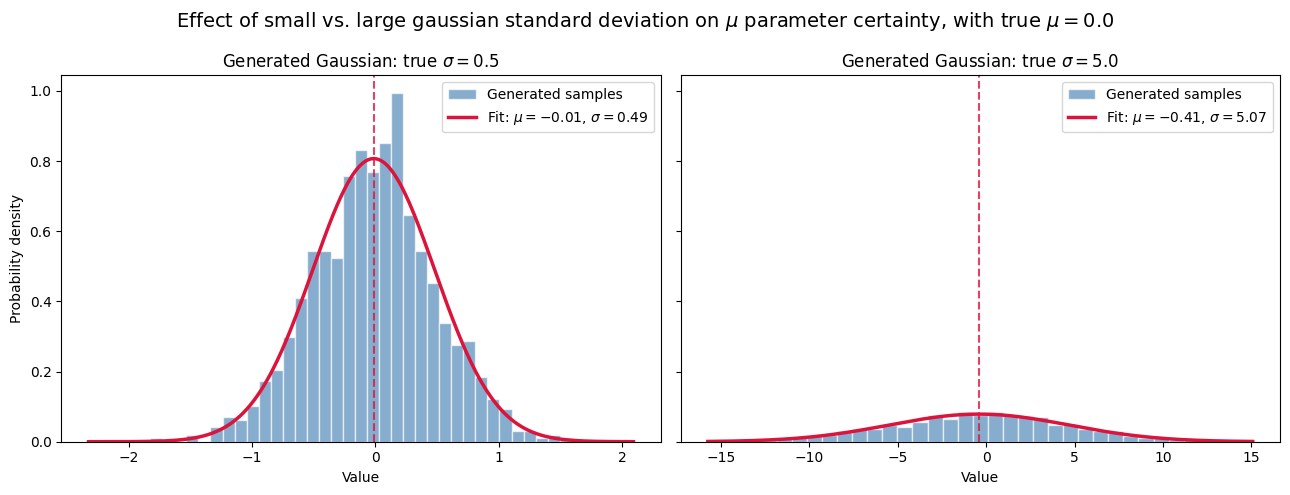
n örnekten μ değerini tahmin etmek istediğimizi varsayalım. İki durumu karşılaştırın (Bakın Şekil 2):
-
Küçük σ değerine sahip dar bir Gauss.
-
Büyük σ değerine sahip geniş bir Gauss.
σ küçük olduğunda, örneklenen noktalar ortalamanın etrafında sıkı bir şekilde kümelenir. Önemli ölçüde bir veri seti bile μ’nın nerede olduğunu güçlü biçimde gösterir.
σ büyük olduğunda ise örnekler çok daha dağınıktır. Aynı sayıda gözlem, yakın ortalama değerlerin hâlâ makul olabileceği için μ hakkında daha az kesin bir tahmin verir.
Şekil 2. Ortalamanın tahmini, Gauss dağılımı dar olduğunda kolay, geniş olduğunda zordur. Görsel yazarlara aittir.
Bu, tam olarak Fisher bilgisinin yakaladığı şeydir. N(μ,σ²) dağılımından alınan tek bir gözlem için μ hakkında Fisher bilgisi
F
(
μ
)
=
1
σ
2
F(\mu)=\frac{1}{\sigma^2}.
F
(
μ
)
=
σ
n bağımsız gözlem için bilgiler toplanır:
F
n
(
μ
)
=
n
σ
2
F_n(\mu)=\frac{n}{\sigma^2}.
F
n
(
μ
)
=
σ
n
Daha fazla veri bilgiyi doğrusal olarak artırır. Daha fazla gürültü ise onu azaltır.
Likelihood’tan Fisher bilgisine
Bu sezgiyi biçimlendirmek için gözlemlenen bir veri noktası xxx sabitleyip p(x∣θ) olasılık yoğunluğunu, parametre θ’nın bir fonksiyonu olarak düşünün. Buna likelihood (olabilirlik) fonksiyonu denir.
A likelihood, gözlemlenen veriyi daha az ya da daha çok makûl kılan parametre değerlerini söyler. Bu, Bayesian çıkarımda yapıldığı gibi bir önsel (prior) getirip normalize etmedikçe, θ üzerinde bir olasılık dağılımı değildir.
Şimdi iki likelihood eğrisini düşünün (Bakın Şekil 3):
-
Düz bir likelihood: yakın parametre değerleri veriyi neredeyse eşit derecede açıklar.
-
Sivri bir likelihood: parametredeki küçük değişimler gözlemi çok daha az makûl kılar.
Sivri bir likelihood, gözlemin parametre hakkında bilgi verdiğini gösterir. Düz bir likelihood ise vermediğini gösterir.
Şekil 3. Keskin eğrili bir likelihood, gözlemin parametreyi güçlü biçimde sınırladığını gösterir. Düz bir eğri ise daha zayıf yerel bilgiyi gösterir. Görsel yazarlara aittir.
likelihood’ın yerel duyarlılığı, logaritmasının parametreye göre türeviyle yakalanır:
s
(
x
θ
)
=
∂
∂
θ
log
p
(
x
∣
θ
)
s(x;\theta)=\frac{\partial}{\partial\theta}\log p(x\mid\theta).
s
(
x
θ
)
=
∂
θ
∂
lo
g
p
(
x
∣
θ
)
Bu niceliğe skor fonksiyonu denir ve gradient (kısmi türevlerin vektörü) sağlar.
Logaritmayı hem pratik hem de matematiksel bir nedenle kullanırız. Olasılıkların çarpımı toplama, türev ise göreceli bir değişime dönüşür:
∂
∂
θ
log
p
(
x
∣
θ
)
=
1
p
(
x
∣
θ
)
∂
∂
θ
p
(
x
∣
θ
)
\frac{\partial}{\partial\theta}\log p(x\mid\theta)=\frac{1}{p(x\mid\theta)}\frac{\partial}{\partial\theta}p(x\mid\theta).
∂
θ
∂
lo
g
p
(
x
∣
θ
)
=
p
(
x
∣
θ
)
∂
θ
∂
p
(
x
∣
θ
)
Puan, olasılığın hangi yönde değiştiğine göre pozitif ya da negatif olabilir. Fisher bilgisinin yönden çok büyüklüğü ölçmesi gerektiğinden, skoru kareye alıp model tarafından üretilen tüm olası gözlemler üzerinden ortalamasını alırız:
F
(
θ
)
=
E
[
(
∂
∂
θ
log
p
(
x
∣
θ
)
)
2
|
θ
]
F(\theta)=\mathbb{E}\left[\left( \frac{\partial}{\partial\theta}\log p(x\mid\theta) \right)^2 \middle| \ \theta \right].
Sürekli bir rastgele değişken için bu beklenen değer
F
(
θ
)
=
∫
p
(
x
∣
θ
)
(
∂
∂
θ
log
p
(
x
∣
θ
)
)
2
d
x
F(\theta)=\int p(x\mid\theta) \left( \frac{\partial}{\partial\theta} \log p(x\mid\theta)\right)^2dx.
Bu, tek parametreli bir model için Fisher bilgisidir.
Gauss örneği
Gauss dağılımının ortalaması μ için (σ bilindiğinde, bkz. Şekil 4) Fisher bilgisini hesaplayalım.
Şekil 4. Gauss olasılığından skora ve Fisher bilgisine. Görüntü yazarlara ait.
Gauss dağılımı şu şekilde ifade edilebilir:
p
(
x
∣
μ
)
=
1
2
π
σ
2
exp
[
−
(
x
−
μ
)
2
2
σ
2
]
p(x \mid \mu) = \frac{1}{\sqrt{2\pi\sigma^2}}\exp \left[ -\frac{(x-\mu)^2}{2\sigma^2} \right].
Logaritma alındığında log-olışllık elde edilir:
log
p
(
x
∣
μ
)
=
−
1
2
log
(
2
π
σ
2
)
−
(
x
−
μ
)
2
2
σ
2
\log p(x\mid\mu)= -\frac{1}{2}\log\left(2\pi\sigma^2\right)-\frac{(x-\mu)^2}{2\sigma^2}.
μ’ya göre türev alındığında skor elde edilir:
∂
∂
μ
log
(
x
∣
μ
)
=
x
−
μ
σ
2
\frac{\partial}{\partial\mu}\log(x\mid\mu)=\frac{x-\mu}{\sigma^2}.
Kareye almak şunu verir:
(
∂
∂
μ
log
p
(
x
∣
μ
)
)
2
=
(
x
−
μ
)
2
σ
4
\left( \frac{\partial}{\partial\mu}\log p(x\mid\mu) \right)^2 = \frac{(x-\mu)^2}{\sigma^4}.
Son olarak, x∼N(μ,σ²) için beklenen değer alındığında
F
(
μ
)
=
E
[
(
x
−
μ
)
2
σ
4
]
=
E
[
(
x
−
μ
)
2
]
σ
4
=
σ
2
σ
4
=
1
σ
2
F(\mu)=\mathbb{E}\left[ \frac{(x-\mu)^2}{\sigma^4} \right] = \frac{\mathbb{E}[(x-\mu)^2]}{\sigma^4}=\frac{\sigma^2}{\sigma^4}=\frac{1}{\sigma^2}.
F
(
μ
)
=
E
[
σ
(
x
−
μ
)
]
=
σ
E
[(
x
−
μ
)
]
=
σ
σ
=
σ
Bu sonuç içgüdümüzle örtüşüyor. Küçük varyans, ortalamayı tahmin etmeyi kolaylaştırır, dolayısıyla Fisher bilgisi büyüktür. Büyük varyans, ortalamayı tahmin etmeyi zorlaştırır, dolayısıyla Fisher bilgisi küçüktür.
Skalardan matrislere
Gerçek makine öğrenmesi modelleri çok sayıda parametre içerir:
θ
=
(
θ
1
θ
2
…
θ
k
)
⊤
\boldsymbol{\theta}=\left( \theta_1,\theta_2,\dots ,\theta_k\right)^\top.
θ
=
(
θ
θ
…
θ
k
)
⊤
Çoklu parametreli bir model için Fisher bilgisi, (i,j)(i,j)(i,j) elemanın ilgili skor fonksiyonlarının beklenen çarpımı olduğu bir matristir:
F
(
i
j
)
(
θ
)
=
E
[
(
∂
∂
θ
i
log
p
(
x
θ
)
)
(
∂
∂
θ
j
log
p
(
x
θ
)
)
|
θ
]
\boldsymbol{F}_{(i,j)}(\boldsymbol{\theta})=\mathbb{E}\left[ \left( \frac{\partial}{\partial\theta_i} \log p(x;\boldsymbol{\theta})\right) \left( \frac{\partial}{\partial\theta_j} \log p(x;\boldsymbol{\theta}) \right) \middle| \ \boldsymbol{\theta}\right].
F
(
i
j
)
(
θ
)
=
E
[
(
∂
θ
i
∂
lo
g
p
(
x
θ
)
)
(
∂
θ
j
∂
lo
g
p
(
x
θ
)
)
θ
]
Teşhis matrisinin köşegen elemanları bireysel parametrelere duyarlılığı; köşegen dışı elemanları ise parametre etkilerinin “yönsel” olarak nasıl eşleştiğini ölçer ve böylece model parametrelerinin geometrisini belirler.
Bu eşleşme kritik öneme sahiptir. İki parametre çıktıyı neredeyse aynı şekilde etkilerse, Fisher bilgisi matrisi bir yönde neredeyse tektillenir (singularlaşır). Bu, yalnızca θ1+θ2\theta_1+\theta_2θ+θ önemliyken ortaya çıkan önceki örneğin çok değişkenli versiyonudur.
Etkili boyut, ham parametre sayısının ötesine geçmek için bu Fisher bilgisi geometrisini kullanır. Modelin kaç parametre içerdiğini değil, verinin parametre alanında gerçekten çözebildiği kaç yön olduğunu sorar.
Fisher bilgisi matrisi elimizde olduğuna göre, şimdi etkili boyutu tanımlayabilir ve tahmin edebiliriz.
Etkili boyutun sezgisel resmi
Şimdiye kadar, etkili boyutun ardındaki merkez soruyu ortaya koyduk:
Bir model kaç bilgi bakımından ayrık yön içerir?
Fisher bilgisi matrisi, bir modelin tahminlerinin parametrelerindeki değişimlere ne kadar duyarlı olduğunu söyler. Ancak bu yerel duyarlılığı bir model karmaşıklığı ölçüne dönüştürmek için, önce bir modelden ne anladığımızı tanımlamamız gerekir.
Bir istatistiksel model, eğitilebilir parametreleriyle indekslenen bir olasılık dağılımı ailesi olarak yazılabilir:
M
Θ
=
{
p
(
⋅
⋅
θ
)
θ
∈
Θ
}
\mathcal{M}_{\Theta}=\{ p(\cdot,\cdot,\boldsymbol{\theta}) : \boldsymbol{\theta}\in\Theta \}.
Bu ifadede \boldsymbol{\theta} parametre vektörü, \Theta ise parametre uzayını temsil eder. Makine öğrenmesi bağlamına göre p(\cdot,\cdot,\boldsymbol{\theta}) ya bütünsel bir dağılım olan p(x,y\mid\boldsymbol{\theta})’i ya da, denetimli öğrenmede daha yaygın olan, koşullu bir tahmin dağılımı p(y\mid x,\boldsymbol{\theta})’i tanımlar.
Önemli olan nokta, \boldsymbol{\theta}’in her değerin potansiyel olarak farklı bir tahmin dağılımı tanımlamasıdır. Bütün bu dağılımlar birlikte \mathcal{M}_\Theta model ailesini oluşturur.
Bu ailenin etkin boyutunu çalışmanın iki yararlı yolu vardır:
-
Evrensel etkin boyut, tüm parametre uzayını [1] göz önüne alır.
-
Yerel etkin boyut, genellikle eğitim sırasında veya sonrasında ulaşılan belirli bir parametre yapılandırmasının etrafındaki komşuluk bölgesini [2] inceler.
Yerel mi, evrensel mi?
Evrensel etkin boyut, modelin tam \Theta parametre uzayı boyunca ortalama kaç bilgilendirici parametre yönüne sahip olduğunu sorar.
Bu onu mimari düzeyinde karşılaştırmalar için yararlı kılar. Örneğin, diğer faktörleri sabit tutarken bir varyansal kuantum devresi ile klasik bir sinir ağını karşılaştırmak istediğimizde, evrensel etkin boyut bir mimarinin diğerinden daha fazla ayırt edilebilir işlevsel özgürlük derecesine sahip olup olmadığını ortaya çıkarabilir.
Tüm parametre uzayı üzerinden ortalama aldığı için evrensel etkin boyut, belirli bir başlangıç değerinden ya da tek bir optimizasyon izinden ayrılmaz. Bu nedenle model sınıfları arasında kontrollü, ceteris paribus karşılaştırmalar yaparken değerlidir.
Bununla birlikte, evrensel etkin boyut veriyle tamamen bağımsızmış gibi yorummamalıdır. Fisher bilgi matrisi modelin tahmin dağılımına ve denetimli öğrenmede genellikle girdi verisinin dağılımına bağlıdır. Evrensel etkin boyutun ortadan kaldırdığı şey, tek bir eğitilmiş çözümden ya da bir optimizasyon çalışmasının ziyaret ettiği belirli bir bölgeden bağımlılıktır.
Bu geniş bakış açısı aynı zamanda temel sınırındır.
Bir model, pratikte hiç ulaşılmayan parametre uzayının son derece bilgilendirici bölgelerini içerebilir. Bu bölgeler optimize etmek açısından zor olabilir, başlangıç değeri eğitimi bunlardan uzakta başlayabilir ya da düzenleme (regularization) modelin içine girmesini engelleyebilir. Böyle durumlarda evrensel etkin boyut, model ailesinin kuramsal kapasitesini tanımlayabilir, ancak belirli bir eğitilmiş modelin kullandığı kapasiteyi doğru biçimde yansıtmayabilir.
Bu durum yerel etkin boyut‘u gündeme getirir.
Yerel etkin boyut, tüm \Theta üzerinden integral almak yerine, analizi referans bir parametre vektörü \boldsymbol{\theta}^—genellikle eğitim sonrasında elde edilen parametreler—etrafındaki komşuluk bölgesine indirger:
\mathcal{B}_\varepsilon(\boldsymbol{\theta}^)=\{\boldsymbol{\theta} : \lVert \boldsymbol{\theta} – \boldsymbol{\theta}^*\rVert \leq\varepsilon\}.
Yerel ölçüm dolayısıyla daha pratik bir soru sorar:
Eğitimin gerçekten bulduğu çözümün yakınında, mevcut veriden ayırt edilebilir kaç parametre yönü vardır?
Bu anlamda, yerel boyutlu boyut, mimari ile veri seti, başlangıç ve optimizasyon süreci arasındaki etkileşimi yansıtabilir. Özellikle, tüm mimarinin kuramsal kapasitesinden çok, eğitilmiş bir modelin karmaşıklığını ve genelleşme davranışını anlamak istediğimizde kullanışlıdır. Ayrıca, yerel boyutlu boyut, eğitilmiş modelin hâlâ kullanılmayan bir öğrenme kapasitesinin kalmış olup olmadığını doğrulamaya yardımcı olabilir.
Yerel boyutlu boyutu hesaplamak için analiz, belirli bir parametre yapılandırması etrafındaki küçük bir ε-yuvarlağına indirgenir. Bu yerel bir yaklaşımd olsa da, Fisher bilgi matrisi, modelin çıkış dağılımının o komşuluk içindeki duyarlığını ve korelasyonlarını yakalar. Bu da modelin yerel karmaşıklığı ve genelleşme davranışı hakkındaki daha geniş soruları araştırmayı mümkün kılar.
Aşağıdaki diyagram, boyutlu boyuta yaklaşımındaki bu farkı göstermektedir.
Şekil 5. Küresel boyutlu boyut, tüm parametre uzayında ortalamayı alırken, yerel boyutlu boyut, eğitim sırasında karşılaşılan ve iii ile etiketlenmiş her adım için seçilen bir parametre yapılandırması, örneğin θ(i) yapılandırması, etrafındaki bir komşulukları göz önünde bulundurur. Görüntü yazarlara aittir.
Boyutlu boyut formülü
Artık küresel boyutlu boyutu tanıtabiliriz. Abbas ve ark.[1] tarafından kullanılan formülasyonda şu şekilde tanımlanır
dn,γ(MΘ):= 2·(log( (1/VΘ)·∫Θ √(det(Ik + (γn/2π log n)·F̂(θ))) dθ ) / log(γn/2π log n)).
Burada çok fazla gösterim var ama temel fikir, Fisher bilgisini parametre uzayının seçilen bir bölgesi boyunca incelemek ve bulduklarımızı tek bir sayıda birleştirmek. Burada k, eğitilebilir parametre sayısıdır; Ik, k×k birim matrisidir; n, örneklem boyutudur; γ ise yapılandırmadaki bir sabittir. İntegral, parametre bölgesi Θ üzerinde yürütülür; bunun hacmi VΘ=∫Θ dθ ile bölünmesi, integrali bir ortalamaya dönüştürür.
Tanışık olmayan nesne F̂(θ)’dür. Bu, Fisher bilgi matrisi F(θ)’dür, ancak genel ölçeği ayarlanmıştır. Bunu nasıl yaptığını görmek için, önce F’nin izini alınır, bu da özdeğerlerini toplar. Sonra bu iz, parametre bölgesi üzerinde ortalamaya alınır. (i,j) elemanı için normalize edilmiş matris şöyle olur:
F̂(i,j):= k·(VΘ / ∫Θ Tr(F(ϑ)) dϑ)·F(i,j)(θ).
Θ
Tr
(
F
(
ϑ
)
)
d
ϑ
V
Θ
F
(
i
j
)
(
θ
)
Payda, tüm Θ bölgesi kullanılarak tek seferde hesaplanır. Bu bölgedeki her Fisher matrisi ardından aynı faktörle çarpılır. Neden bu özel faktörü seçiyoruz? Normalize edilmiş Fisher matrisinin ortalama izini kkk’ye eşitler:
1
V
Θ
∫
Θ
Tr
(
F
^
(
θ
)
)
d
θ
=
k
\frac{1}{V_\Theta}\int_\Theta \operatorname{Tr} \left( \boldsymbol{\hat{F}}(\boldsymbol{\theta}) \right)d\boldsymbol{\theta}=k.
V
Θ
∫
Θ
Tr
(
F
^
(
θ
)
)
d
θ
=
k
Başka bir deyişle, ortalama Fisher özdeğeri bir olarak belirlenir. Bu, matrislere ortak bir ölçek referansı verir; ancak her özdeğeri bir yapmaz. Örneğin, iki parametreli bir modelde ve özdeğerlerinin izi, 1.9 ve 0.1 özdeğerleriyle aynıdır. Normalizasyon, iki benzer şekilde bilgilendirici yön ile tek baskın yön arasındaki önemli farkı korurken toplam ölçeklerini eşit karşılar.
Yerel boyutlu boyut için aynı ifade kullanılır, ancak Θ yerine yerel bir Bε(θ∗) topu ile değiştirilir ve VΘ yerine bu topun Vε hacmiyle değiştirilir.
Bu fark, boyutlu boyuta determinant üzerinden girer:
det
(
I
K
+
γ
n
2
n
log
n
F
^
(
θ
)
)
\det \left( \boldsymbol{I}_K + \frac{\gamma n}{2n \log n} \boldsymbol{\hat{F}}(\boldsymbol{\theta}) \right).
det
(
I
K
+
n
lo
g
n
γ
n
F
^
(
θ
)
)
Fisher bilgi geometrisinin tanıma girdiği yer burasıdır.
Fisher spektrumunu okumak
Bu determinantın ne yaptığını görmek için ölçek faktörünü tanımlayalım
κ
n
γ
=
γ
n
2
π
log
n
\kappa_{n,\gamma}=\frac{\gamma n}{2\pi \log n}.
κ
n
γ
=
π
lo
g
n
γ
n
Bu faktör her θ parametre değerinde aynıdır ve boyutlu boyutun istenilen asimptotik özelliklerini elde etmek için kullanılır.
Şimdi normalize edilmiş Fisher bilgi matrisini köşegenleştirelim:
F
^
(
θ
)
=
U
diag
(
λ
1
(
θ
)
…
λ
k
(
θ
)
)
U
⊤
\boldsymbol{\hat{F}}(\boldsymbol{\theta})= \boldsymbol{U} \operatorname{diag} \left( \lambda_1(\boldsymbol{\theta}),\dots,\lambda_k(\boldsymbol{\theta}) \right) \boldsymbol{U}^\top.
F
^
(
θ
)
=
U
diag
(
λ
(
θ
)
…
λ
k
(
θ
)
)
U
⊤
U içindeki özvektörler, parametre alanında bağımsız yönleri belirler. Karşılıklarındaki özdeğerler λi(θ), bu yönler boyunca meydana gelen değişimlerin modelin çıkış dağılımını ne kadar güçlü etkilediğini nicelendirir.
Determinantların dönüşümler altında değişmez olması nedeniyle şunu elde ederiz
det
(
I
k
+
κ
n
γ
F
^
(
θ
)
)
=
∏
i
=
1
k
(
1
+
κ
n
γ
λ
i
(
θ
)
)
\det \left( \boldsymbol{I}_k + \kappa_{n,\gamma} \boldsymbol{\hat{F}}(\boldsymbol{\theta})\right) = \prod_{i=1}^k \left( 1+\kappa_{n,\gamma}\lambda_i(\boldsymbol{\theta}) \right).
The determinant of this matrix equals the product of its eigenvalues, so
\det \left( \boldsymbol{I}_k + \kappa_{n,\gamma} \boldsymbol{\hat{F}}(\boldsymbol{\theta})\right) = \prod_{i=1}^k \left( 1+\kappa_{n,\gamma}\lambda_i(\boldsymbol{\theta}) \right).
The square root in the effective-dimension formula then gives
\sqrt{\det \left( \boldsymbol{I}_k + \kappa_{n,\gamma} \boldsymbol{\hat{F}}(\boldsymbol{\theta})\right)} = \prod_{i=1}^k \sqrt{ 1+\kappa_{n,\gamma}\lambda_i(\boldsymbol{\theta})}.
At a fixed point θ, taking the logarithm turns this product into a sum:
\log \sqrt{\det \left( \boldsymbol{I}_k + \kappa_{n,\gamma} \boldsymbol{\hat{F}}(\boldsymbol{\theta})\right)} = \frac{1}{2}\sum_{i=1}^k \log \left( 1+\kappa_{n,\gamma}\lambda_i(\boldsymbol{\theta})\right).
This is the key expression for understanding effective dimension. Each Fisher eigen-direction contributes according to
\log (1+\kappa_{n,\gamma}\lambda_i).
The contribution depends on whether the eigenvalue is large or small relative to the resolution scale 1/κn,γ.
Nearly invisible directions
First, consider a direction with
\kappa_{n,\gamma}\lambda_i \ll 1.
Using the first-order Taylor approximation,
\log (1+\kappa_{n,\gamma}\lambda_i) \approx\kappa_{n,\gamma}\lambda_i
This contribution is small.
Such an eigen-direction corresponds to a parameter combination that barely changes the model’s predictive distribution at the chosen resolution. The data cannot reliably distinguish movement in that direction, so it should contribute little to the model’s effective complexity.
Informational directions
Now consider the opposite regime:
\kappa_{n,\gamma}\lambda_i \gg
1.
\kappa_{n,\gamma}\lambda_i \gg1.
κ
n
γ
λ
i
≫
1.
Buna göre aşağıdaki terim ihmal edilebilir hale gelir:
log
(
1
+
κ
n
γ
λ
i
)
≈
log
(
κ
n
γ
λ
i
)
\log \left( 1 + \kappa_{n,\gamma}\lambda_i \right) \approx \log \left( \kappa_{n,\gamma}\lambda_i \right).
lo
g
(
+
κ
n
γ
λ
i
)
≈
lo
g
(
κ
n
γ
λ
i
)
Logaritma kuralının uygulanması şunu verir:
log
(
κ
n
γ
λ
i
)
=
log
(
κ
n
γ
)
+
log
(
λ
i
)
\log (\kappa_{n,\gamma}\lambda_i)=\log (\kappa_{n,\gamma}) + \log(\lambda_i).
lo
g
(
κ
n
γ
λ
i
)
=
lo
g
(
κ
n
γ
)
+
lo
g
(
λ
i
)
Etkin boyut tanımında pay, log(κn,γ)\log(\kappa_{n,\gamma})log(κn,γ) ile normalize edilir. Büyük-nnn rejiminde ölçek bağımlı terim baskın hale gelir:
log
κ
n
γ
log
κ
n
γ
=
1.
\frac{\log \kappa_{n,\gamma}}{\log \kappa_{n,\gamma}} = 1.
lo
g
κ
n
γ
lo
g
κ
n
γ
=
1.
Kalan özdeğer bağımlı düzeltme,
log
λ
i
log
κ
n
γ
\frac{\log \lambda_i}{\log \kappa_{n,\gamma}},
lo
g
κ
n
γ
lo
g
λ
i
κn,γ\kappa_{n,\gamma}κn,γ büyük ve özdeğer sonlu olduğunda göreli olarak küçük hale gelir.
Etkin boyutun neden böyle bir bilgi parametre yönlerinin yumuşak, çözünürlük bağımlı sayısı gibi davrandığı da budur.
Sadece “Modelde kaç parametre var?” sorusunu sormaz.
Bunun yerine şunu sorar:
nnn‘nin belirlediği çözünürlükte veri kaç parametre yönünü ayırt edebilir?
Büyük-nnn limitinde etkin boyut, yapının varsayımları altında Fisher bilgi matrisinin alabileceği maksimum dereceye yaklaşır.
Neden ölçeğin önem taşıdığı
nnn parametresi genellikle veri setinin boyutu olarak tanımlanır. Bu geniş anlamda doğrudur, çünkü etkin boyut çerçevesi nnn’yi sonlu örneklem genellemesiyle ilişkilendirir. Ancak nnn’nin bir çözünürlük ölçeği olarak da yorumlanması yardımcı olur.
Daha büyük bir veri seti, birbirine yakın iki tahminsel dağılım arasındaki daha küçük farkları ayırt edebilir. nnn arttıkça, daha önce gözlemek için çok zayıf olan yönler bilgilendirici hale gelebilir.
Geometrik benzetme burada işe yarar.
Bir nesneye farklı büyütme oranlarında bakmayı düşünün. Kaba bir ölçekde basit bir iki boyutlu yüzey gibi görünebilir. Daha ince bir ölçekde, bu yüzeyin aslında uzay içinde kıvrılan dar bir eğri olduğu keşfedilebilir. Daha da ince bir ölçekde bu eğrinin küçük salınımlar veya ek yapılar ortaya çıkardığı görülür.
O yüzden etkin boyutu tek bir sayı raporlamak yerine, farklı nnn değerleri aralığında değerlendirmek iyi bir pratiktir. Gerçek bir uygulamada en ilgili değerler, modelin gerçekten eğitileceği veri setlerinin boyutuna yakın olanlardır.
Şekil 6. Model ailesi, farklı istatistiksel çözünürlüklerde farklı etkin yapıları ortaya çıkarabilir. [1]’den uyarlandı.
Sözün sonu
Etik boyut, modelin istatistiksel profilinin geometrisine dayanan bir karmaşıklık ölçüsüdür. Ham parametre sayısının ötesine geçerek, veriden gerçekten ayrılabilen kaç parametre yönünün bulunduğunu belirler.
Değeri, genellikle ayrı ayrı incelenen birkaç fikri birbirine bağlamaktan gelir:
-
Model kapasitesi ve ifade gücü.
-
Parametre gereksizliği ve tanımlanabilirlik.
-
Fisher bilgi geometrisi.
-
Sınırlı veriyle genelleme.
-
Eğitilebilirlik ve optimizasyon yüzeyleri.
Altında yatan teorinin varsayımları altında, etik boyut genelleme hatası için sınır türetmek amacıyla kullanılabilir. Doğrudan test doğruluğunun bir tahmini gibi okunmamalıdır; ancak ampirik eğitim eğrilerini ve doğrulama sonuçlarını tamamlayabilen, ilkeli bir karmaşıklık miktarı sağlar.
Önemlisi, etik boyut öğrenme kapasitesini parametre uzayı üzerinden nicelendirir; bu bakış açısı hem klasik hem de parametreli kuantum modelleri için eşit derecede geçerlidir. Kuantum makine öğreniminde, kapasite alternatif çerçevelerle doğrudan kuantum durumlarının Hilbert uzayı üzerinden karakterize edilir ve bu metrik bunu açıkça ele almaz.
Bu makalede, etik boyut için ortaya atılan gerekçeyi ve altında yatan Fisher bilgi geometrisini tanıttık. Ardından Fisher spektrumunun, seçilen veri ölçeğinde bir modelin karmaşıklığına hangi parametre yönlerinin katkıda bulunduğunu nasıl belirlediğini inceledik.
Bu dizinin sonraki makalesi teoriden pratiğe geçecek: Bir makine öğrenimi modeli için Fisher bilgi matrisinin ve etik boyut hesabının nasıl uygulanacağı.
Kaynakça
[1] A. Abbas, D. Sutter, C. Zoufal, A. Lucchi, A. Figalli ve S. Woerner, “The power of quantum neural networks,” Nat. Comput. Sci., c. 1, no. 6, ss. 403–409, Haz. 2021, doi: 10.1038/s43588-021-00084-1.
[2] A. Abbas, D. Sutter, A. Figalli ve S. Woerner, “Effective dimension of machine learning models,” 09 Ara. 2021, arXiv: arXiv:2112.04807. doi: 10.48550/arXiv.2112.04807.
[3] E. Grant, L. Wossnig, M. Ostaszewski ve M. Benedetti, “An initialization strategy for addressing barren plateaus in parametrized quantum circuits,” Quantum, c. 3, s. 214, Ara. 2019, doi: 10.22331/q-2019-12-09-214.
[4] S. Amari ve H. Nagaoka, Methods of Information Geometry, c. 191. in Translations of Mathematical Monographs, c. 191. Providence, Rhode Island: American Mathematical Society, 2007. doi: 10.1090/mmono/191.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.