

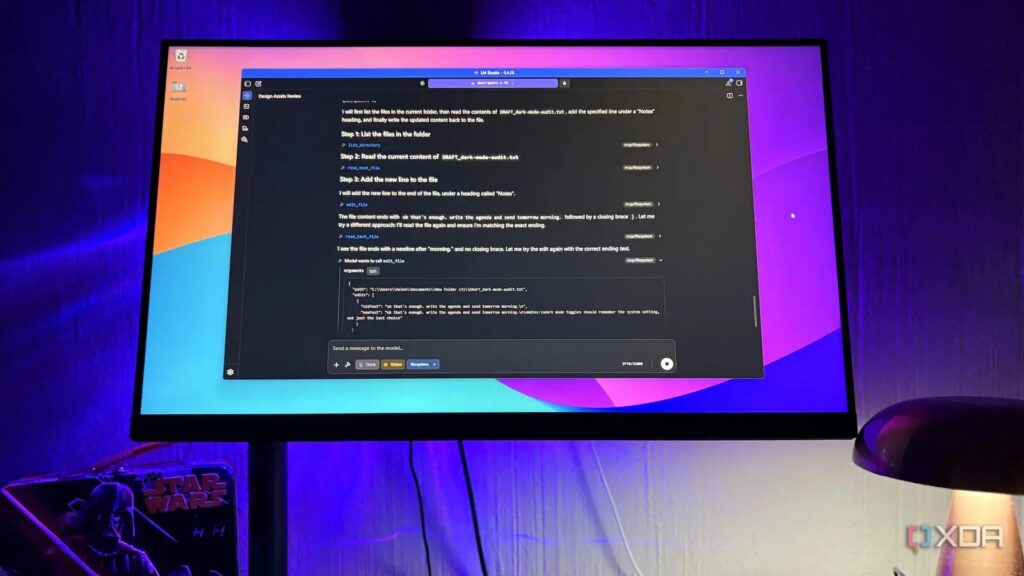
AI modellerinden daha iyi sonuçlar almak için sunulan önerilerin çoğu, bu modelleri veri merkezlerinde işleten şirketlerden geliyor. Belgeleri oldukça detaylı ve büyük ölçüde mantıklı; ancak yerel LLM rehberlerinin çoğu bu aynı önerileri tekrarlamak durumunda kalıyor. Çünkü 8 GB’lık bir GPU‘da çalışan yerel bir yapay zekâ, Anthropic sunucularındaki devasa bir Claude modeli gibi ayarlanamaz ya da kullanılamaz. Bu yılın büyük bir bölümünde yerel LLM’leri gerçek işler için kullanmanın ardından, ipuçları ve püf noktalarının çoğunun bulut sağlayıcıların önerdikleriyle tam tersine geldiğini fark ettim.
Ek
XDA

Google’da
Tercih Kaynağı Olarak Ekle
Google Discover’dan Takip Et
“Düşünme” özelliğini açıkta bırakmak
Bulut modellerin övündüğü özellik, benim ilk kapattığım özellik
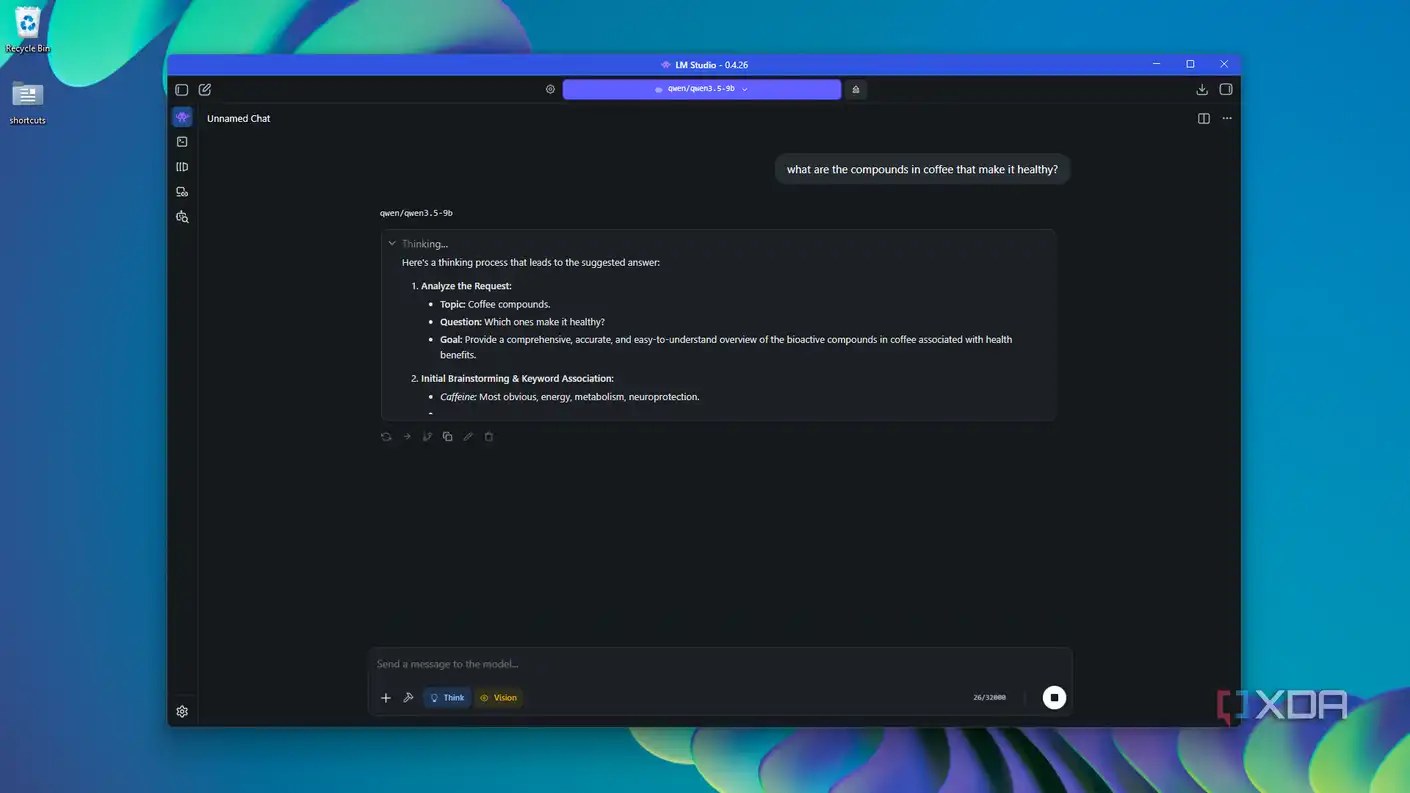
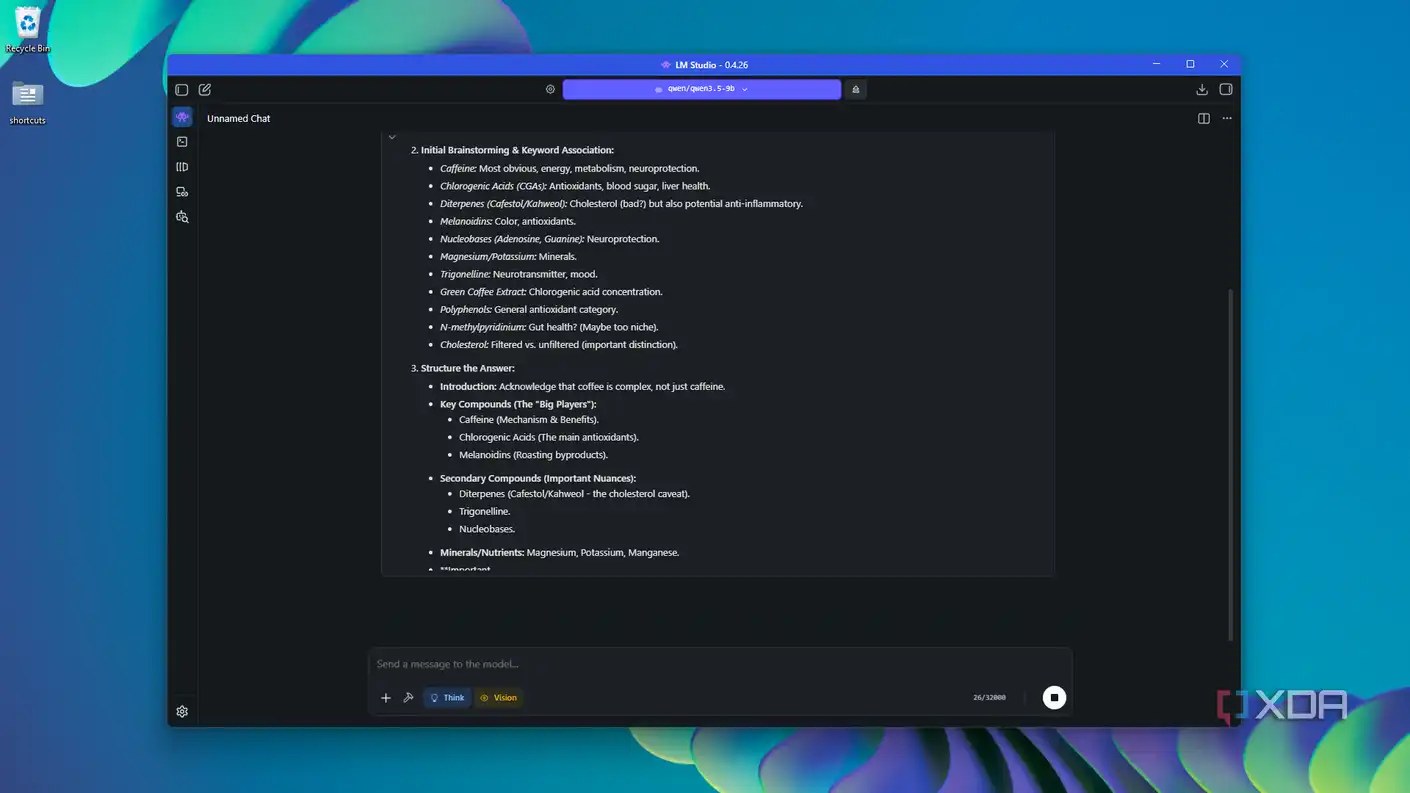
Düşünme ya da muhakeme modu, bir modelin size bir cevap vermeden önce yaptığı işi kâğıda döktüğü durumdur. Amacı, karmaşık görevlerde daha doğru olmasıdır. Modellerimin çoğunda, Qwen, Gemma 4 ve Qwythos modellerim dahil bir düşünme modu var.
Bulut sağlayıcılar bu düşünme özelliğine çok sıkı sıkıya bağlı; öyle ki bazıları sizi bu özelliği kapatmaktan bile alıkoyuyor. Claude Opus 5.5, düşünme modu kalıcı açık şekilde çalışıyor ve Google, her Gemini 3.x modelinin de her zaman düşündüğünü söylüyor; bu yüzden yapabileceğiniz en yakın şey çabayı düşürmek. OpenAI, geliştiricilerin GPT-5.5’in muhakeme çabasını sıfıra ayarlamasına izin veriyor; ancak varsayılan değer orta düzeyde ve OpenAI, bunu ancak zekice bir cevaptan çok hızlı bir cevap istediğinizde düşürmenizi öneriyor.
D yerel modellerimin neredeyse hepsinde “Thinking” özelliğini kapalı tutuyorum ve asıl sebep bağlam (context). Koşucumun bağlam penceresinin her şeyi içermesi gerekiyor; yani istegimi, konuşma geçmişini, eklediğim dosyaları ve modelin düşünme sürecini. Bunu kapalı tutmak, biraz ek tasarruf sağlayan bir bütçe planlama hilesi gibi. Her istek için gerçekten birkaç yüz, bin tokene kadar tasarruf sağlıyor. Düşünmeyi gerçekten çok isteyen bir istek yine de bulut modellerime gidecekti çünkü karmaşık veya çok adımlı görevlerde her zaman onlara başvuruyorum.
Min P örneklemesini açmak
Bulut kullanıcılarının hiç teklif edildiği bile olmayan bir ayar
Min P bir örnekleme ayarı olduğu için modelin sonraki kelimeyi seçme şeklini değiştiriyor. Modelin en olası seçiminin olasılığıyla ölçeklenen bir alt sınır belirliyor ve sonra bunun altındaki olasılığı düşük kelimelerin oluşturduğu uzun kuyruğu elemiyor. Bu, yüksek bir sıcaklığınız olduğunda (analitik olmaktan çok rastlantısal) açmak için mükemmel bir ayar çünkü temelde modelin biraz yoldan çıkmasını engelliyor. Sıcaklığım 0.3’ün üzerindeyken Min P’yi 0.03 ile 0.05 arasında yükseltiyorum.
Bulut araçları bunu hiç teklif etmiyor; OpenAI, Anthropic ve Google, Min P’yi bir ayar olarak sunmuyor ve daha büyük trend, bu örnekleme kontrollerini hiç sunmamak. Claude Sonnet 5, varsayılan sıcaklığı veya top P değerini reddediyor ve Anthropic geliştiricilere bunun yerine istek (prompting) kullanmalarını söylüyor. OpenAI ve Google pek farklı değil. GPT-5.5 yalnızca varsayılan sıcaklığı kabul ediyor ve Google hâlâ Gemini 3 üzerinde değiştirmenize izin verse de, daha düşük değerlerin döngüye yol açabileceği için 1.0 değerinde kalmayı şiddetle tavsiye ediyor.
Ne kadar değerliyse, Qwen’in kendi önerilen ayarları Min P’yi 0.0’da bırakıyor ama yine de daha yüksek bir sıcaklığım olduğunda her zaman açık tutuyorum çünkü yanıtların kullanılamaz hale gelmesini engelliyor.
Bağlam penceresini sınırlamak
Bulut modeller milyonlarca token vaadeder, ben kendi bağlamımı oldukça düşük tutarım
Bağlam uzunluğu, bir modelin aynı anda kaç token tutabileceğini gösterir. Daha önce de belirttiğim gibi, buna prompt’larınız, dosyalarınız ve modelin yanıtları dahil olmak üzere her şey dahildir. Bulut modelleri bu sayıyı milyonun üzerine çıkardı; GPT-5.5 tam 1M’nin biraz üzerindeyken, Claude Sonnet 5 varsayılan olarak 1M’lik bir pencere sunuyor. Anthropic, 20k token’lık belgeler taşıyan bireysel prompt’lar için özel ipuçları bile yayınlıyor.
İlginç olan şu ki, Anthropic’in kendi bağlam mühendisliği kılavuzu, pencere dolmaya başladığında geri çağırmanın (recall) kötüleştiği bir durum olan “bağlam çürümesi” (context rot) konusunda uyarıyor. Bu durum, büyük bir kartınız yoksa yerel modellerde çok daha erken ortaya çıkıyor; bu yüzden bağlamımı genellikle 30k civarında tutuyorum. 80k’ya kadar sorunsuz çalıştırabiliyorum, ancak aynı anda çalıştırdığım diğer uygulamaları da hesaba katmam gerekiyor—ki genelde öyle, özellikle bir yerel model bir tasarım aracına veya ajan tabanlı çalışma alanına bağlandığında.
Modellerim teknik olarak çok daha yükseğine gidebiliyor—Qwen 3.5 9B yerel olarak 262k’yı destekliyor, ancak bu benim GPU’m için bir seçenek değil. Daha düşük bir bağlam penceresi aslında o kadar da sınırlayıcı değil. Prompt’larınızı gerçekten düşünmeye ve bir oturuma ekleyeceklerinizi seçici olmaya zorluyor. Ancak çok adımlı görevler yapmaya çalışırken biraz kısıtlayıcı hale gelebiliyor.
Önce daha küçük bir modele yönelmek
Büyükten başlama tavsiyesi, GPU’nuz küçükse anlamını yitiriyor
Bulut sağlayıcıları genellikle büyükten başlamanızı önerir. OpenAI’nin model seçim kılavuzu, en yetkin modelle başlamanızı ve yalnızca maliyet ile gecikme daha önemli hale geldiğinde daha küçük modelleri test etmenizi söylüyor. Anthropic ise çoğu iş yükünün Claude Opus 5.5 ile başlaması gerektiğini belirtiyor. Yani bu muhtemelen çoğunlukla pazarlama—tabii ki her AI şirketi, daha ucuz olanların bir geri adım gibi hissettirmesi için en yetkin modellerini denemenizi ister.
Yerel yapay zekâ konusunda küçük başlatmayı bilinçli şekilde tercih ediyorum; genellikle Gemma E2B, E4B veya Qwen 3.5 4B kullanıyorum. Durum temelde sistem kaynaklarını korumaya indirgeniyor — o modeller görevi rahatça halledabiliyorsa, ölçeği büyütmenin ne anlamı var? Qwen 3.5 4B küçük kodlama işlerimi, yani ufak buton düzeltmelerini hallediyor; Gemma modellerim ise hızlı sohbetlerim için yeterli oluyor.
Küçük GPU’mu farklı kurallarla yönetiyorum
Bulut rehberleri veri merkezleri göz önünde bulundurularak yazılıyor ve 8GB’lık bir kartın üzerine sıkıştırılmış, üstüne bir not uygulaması, bir tarayıcı ve bir görüntü düzenleyiciyi de çalıştırması gereken bir modeli hesaba katmıyor. Bence daha faydalı alışkanlık, her varsayılanı bir öneri gibi görmek, sonra kendi donanımında onu denemek ve senin kurulumun için gerçekten neyin işe yaradına karar vermek.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.