

Giriş
Üç sayılık menzilden %40 isabet oranıyla atış yapan iki NBA oyuncunu düşünün.
Biri çoğunlukla korularda topu alıp anında attığı (catch-and-shoot) rahat atışları kullanırken, diğeri sık sık savunmacının önünde zorlu topla-ve-at (pull-up) üçlüklerini deniyor.
Sadece bu atış oranlarına bakarak, ikisinin de eşit derecede iyi atıcı oldukları sonucuna varabiliriz.

Ama gerçekten öyle mi?
Sporun genelinde, karmaşık olan şeyleri basitleştirmeye çalışır hale geldiğimizi düşünüyorum. Örneğin saha içi isabet oranı, bir oyuncunun kullandığı atışların zorluğunun yanı sıra o atışları yapma becerisini de yansıtıyor. Bu da oyuncu değerlendirmesini ilk başta göründüğünden daha karmaşık hale getiriyor.
Ya her atışın özelliklerine dayanarak o atışın başarılı olma olasılığını tahmin edip de bu olasılığı gerçek sonuçla karşılaştırabilseydik?
Bu bize iki faydalı bilgi verir:
-
Atış seçimi: Bir oyuncunun kullandığı atışlar ortalama olarak ne kadar değerli?
-
Atış yapma: Oyuncu, bu atışlardan bekleyeceğimizden kaç puan fazla veya eksik puan kazanıyor?
Bugünkü makalede, Python kullanarak (yazılarımın alışıldık bir özelliği olarak) basit bir beklenen saha içi isabet modeli kuracağız. Bu modeli, bu iki bileşenin nasıl ayrıştırılabileceğini göstermek için kullanacak ve bu yaklaşımın atış yeteneği hakkında ne söyleyebileceğiyle ne söyleyemeyeceği tartışacağız.
Bir not: Oyuncuların kendileriyle ilgilenmediğimiz için ve bu yazıyı A oyuncusunun B oyuncusundan daha iyi atıcı olup olmadığını belirlemeye çalışan bir metne dönüştürmek istemediğimiz için rastgele üretilmiş sentetik veri kullanacağım. İsterseniz, gerçek dünya verileriyle herhangi bir oyuncu grubu üzerinde de çalışabilirsiniz.
Ayrıca, tüm kodu paylaşmayacağım çünkü bu yazıyı olduğundan daha uzun hale getirir. Tekrarlanabilirlik için: Tamamı GitHub deposunda bulunabilir.
1. Neden saha içi isabet oranı yeterli değil
Aşağıdaki kurgusal oyuncuları düşünün:
Hangisinin daha iyi atıcı olduğunu söyleyebilir misiniz? Sanmıyorum. Ben en azından söyleyemem. Üstelik daha fazla veri ya da izlenecek bir oynatma listesi olmadan da. Oyuncu A sepete yakın birçok atış deniyor olabilirken, Oyuncu B daha zor iki sayılık şutlar deniyor olabilir. Kim bilir.
Üç sayılık yüzde oranı da sınırlamalara sahip. Köşeden yakalayıp atılan bir atış ile, çemberin çok ötesinden sert müdahale altında çekilen bir üçlıklı atış aynı şey değildir.
Elbette atış zorluğu yalnızca konumdan çok daha fazlasına bağlıdır. Savunmacının mesafesi, atışın türü, atış saatinde kalan süre ve oyuncunun hareketi hepsi önem taşıyabilir.
Tabii ki, neredeyse her temel atış düzeyinde veri setinde temsil edilebilen özelliklerle daha basit bir modelle başlıyoruz:
-
Atış mesafesi.
-
Atışın iki sayılık mı yoksa üç sayılık mı olduğu.
-
Atış türü: yer atışı, sıçrama atışı ya da hafif dokunuş atışı gibi.
-
Üçlığın köşeden mi geldiği.
-
Atışın atış saatinin sonunda mı gerçekleştiği.
Dendiği gibi, bu oldukça basit; bu yüzden atış zorluğunun tüm yönlerini yakalayamadığımızı kabul ediyoruz. Bu uygun.
2. Veri
Atış haritası verilerini kullanacağız; tıpkı NBA’ink gibi. Her atış için bir dizi özellik ve atışın sayı olup olmadığını gösteren ikili bir sonuç gerekiyor.
Bu açıklamada kullanacağım veri setinde 12 oyuncu (Oyuncu A’dan Oyuncu L’ye) bulunuyor ve ben bunu 18.000 atışla sınırladım (oyuncu başına rastgele 1.500 tanesini seçerek) ve oldukça farklı özelliklere sahip: bazıları sepete yakın, bazıları sıçrama atışı, bazıları üçlük… İşte ondan bir örnek:
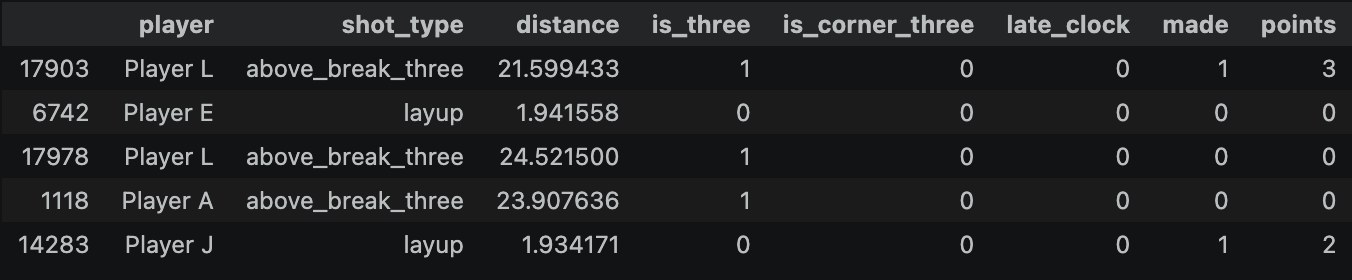
Örnek satırlar – resim yazarın
Sütunlar şu şekilde: player, shot_type, distance, is_three, is_corner_three, late_clock, made, points
Atış türüne gelince, oldukça sınırlı. Yalnızca 4 olası değer var:
-
mid-range
-
corner-three
-
layup
-
above_break_three
3. Beklenen saha içi atış yüzdesi modelinin (xFG%) inşası
Doğal bir başlangıç noktası lojistik regresyondur.
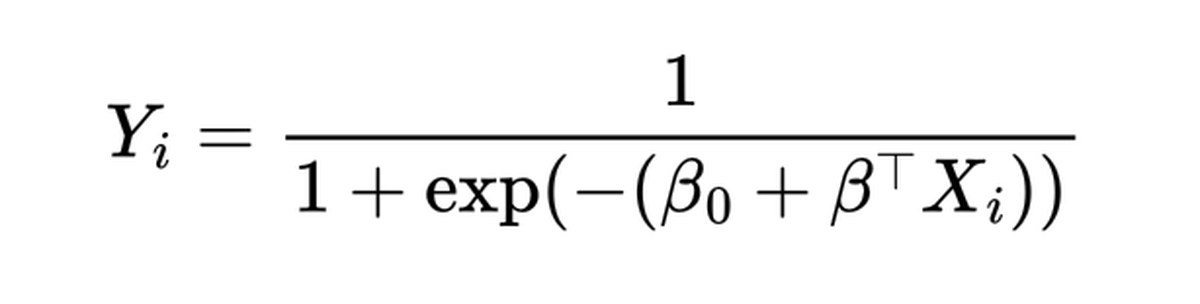
Hedef değişkenimizin ikili (bir atış ya yapılır ya da isabetsiz olur) olması nedeniyle, lojistik regresyon harika ve doğal bir başlangıç noktasıdır. Belirli özellikler verildiğinde başarılı bir denemenin olasılığını tahmin eder.
İşte (i) numaralı atış için bunu şöyle ifade edebiliriz:
Bu denklemde (Y_i) atış sonucunu, (X_i) tanımladığımız atış özelliklerini ve katsayıların veri kullanılarak öğrenildiğini gösterir.
Elde edilen tahmin, söz konusu deneme için beklenen saha içi atış yüzdesi ya da xFG% değeridir.
Modeli uyumlamak scikit-learn ile oldukça kolaydır. İşte veri setinin bölünmesi ve test sonuçlarını elde edene kadar geçen minimal ön işleme ile birlikte tüm boru hattı:
python
numeric_features
=
[
“distance”
“is_three”
“is_corner_three”
“late_clock”
]
categorical_features
=
[
“shot_type”
]
features
=
numeric_features
+
categorical_features
X
=
shots[features]
y
=
shots[
“made”
]
X_train, X_test, y_train, y_test
=
train_test_split(
X, y,
test_size
=
0.20
random_state
=
stratify
=
y
)
preprocessor
=
ColumnTransformer([
(
“numeric”
StandardScaler(),
numeric_features
),
(
“categorical”
OneHotEncoder(
handle_unknown
=
“ignore”
),
categorical_features
)
])
model
=
Pipeline([
(
“preprocessor”
, preprocessor),
(
“classifier”
, LogisticRegression(
max_iter
=
1_000
))
])
model.fit(X_train, y_train)
test_predictions
=
model.predict_proba(X_test)[:,
Sıradaki adım sonuçları analiz etmek. Bu üç metrikten yararlanabileceğimizi düşünüyorum:
-
Log loss (log kaybı) hatalı olasılık tahminlerini, özellikle de emin olunanları cezalandırır.
-
ROC AUC modelin başarılı şutları isabetsiz şutların üstüne ne kadar iyi sıraladığını ölçer.
-
Brier skoru tahmin edilen olasılıklar ile ikili sonuçlar arasındaki ortalama kare farkını ölçer.
Bu metriklerin hiçbiri tek başına tahmin edilen olasılıkların iyi kalibre edildiğini garanti etmez. Ayrıca benzer tahmin edilmiş olasılıklara sahip şut grupları tahmin edilen ve gözlemlenen şut yüzdelerini karşılaştırmalıyız.
Mevcut verilerle şunu elde ediyoruz:
text
Log loss: 0.6195
ROC AUC: 0.6999
Brier score: 0.2146
4. Beklenen şut yüzdeinden beklenen puana
Artık her şutun içeri gireceğine dair tahmin edilmiş bir olasılığımız var. Ancak oyuncuları yalnızca xFG% ile karşılaştırmada küçük bir sorun var: içeri giren bir üçlük, içeri giren bir ikilikten daha değerli.
Bu yüzden, zaten inşa edilmiş xFG% modelini kullanarak yerine per şut beklenen puanı (xPPS) hesaplamanın iyi bir yaklaşım olduğunu düşünüyorum:
burada (V_i) denemenin değeri, ya iki ya da üç nokta.
Gerçek puan ile beklenen puan arasındaki fark bize şut düzeyinde aşırı ya da düşük performans ölçüsü verir.
python
shots[
“xfg”
]
=
model.predict_proba(shots[features])[:,
]
shots[
“shot_value”
]
=
np.where(shots[
“is_three”
]
)
shots[
“expected_points”
]
=
(shots[
“xfg”
]
shots[
“shot_value”
])
shots[
“points_above_expected”
]
=
(shots[
“points”
]
shots[
“expected_points”
])
Örnek olarak: 40% xFG%’ye sahip bir atış, üçlükse 1.2 beklenen puan, iki luksa 0.8 beklenen puan katıyor. Bu ayrım önemli.
5. Atış seçimiyle atış yapımı ayırmak
İşte konunun ilginçleştiği yer burası. Şimdi sonuçları oyuncu bazında birleştirmek ve her biri için şunları hesaplamak gerekiyor:
-
Saha içi atış yüzdesi.
-
Beklenen saha içi atış yüzdesi.
-
Atış başı beklenen puan.
-
Atış başı gerçek puan.
-
100 denemede beklenenin üzerindeki puan.
Bu son ölçütün özellikle yararlı olduğuna inanıyorum. Oyuncunun denemelerinin beklenen değerini ne kadar aşıp aşmadığını, karşılaştırılabilir bir ölçek üzerinden söylüyor.
player_summary = (
shots.groupby(“player”)
.agg(
attempts=(“made”, “size”),
fg_pct=(“made”, “mean”),
xfg_pct=(“xfg”, “mean”),
xpps=(“expected_points”, “mean”),
actual_pps=(“points”, “mean”),
points_above_expected=(
“points_above_expected”,
“sum”
)
)
.reset_index()
)
player_summary[“fg_pct”] = 100
player_summary[“xfg_pct”] = 100
player_summary[“points_above_expected_per_100”] = (
player_summary[“points_above_expected”] / player_summary[“attempts”]
) 100
player_summary = player_summary.sort_values(
“points_above_expected_per_100”, ascending=False
)
Oyuncu_summary’nin nasıl göründüğüne bir göz atalım:
Oyuncu başına nihai birleşik metrikler – görüntü yazar aittir
Ne kadar deneme yaptıklarını, FG%’yi, beklenen değerleri ve beklenenin üzerindeki puanları görebiliyoruz…
Bu bize bir oyuncunun şut performansına dair iki farklı bakış açısı veriyor.
-
Şut seçimi burada deneme başına ortalama beklenen puanlarla temsil edilir. Sürekli değerli denemeler üreten oyuncular, daha yüksek bir xPPS’ye sahip olma eğilimindedir.
-
Şut becerisi gerçek ve beklenen puanlar arasındaki farkla temsil edilir. Pozitif bir değer, oyuncunun denemelerini modelin beklediğinden daha many puana dönüştürdüğünü gösterir.
Bu iki ölçü farklı sorulara yanıt verir ve hiçbirinin şut yeteneğinin tam bir ölçüsü olarak yorumlanması uygun değildir.
Örneğin, bir oyuncu şut başına yüksek beklenen puana sahip olabilir ancak sürekli olarak bu beklentiyi karşılayamayabilir. Başka bir oyuncu ise daha zor şutlar seçerek şut başına daha düşük beklenen puana sahip olabilir, ancak düzenli olarak bu beklentilerin üzerine çıkabilir.
Bu ayrım, şut verimliliğindeki tüm farkları şut yeteneğindeki farklar gibi değerlendirmekten kaçınmamıza yardımcı olduğu için kullanışlıdır.
6. Sonuçların görselleştirilmesi
Bir tablo bireyin oyuncuları inceleme için kullanışlıdır, ancak görselleştirmeler her zaman daha iyidir. Özellikle iki farklı ölçünün birbirleriyle nasıl ilişkilendiğini görmek istediğimizde.
Bunları incelemek için iki yeterli grafik yeterli olacak ve bir şut seçimi ile şut becerisi grafiğiyle başlayacağız:
Şut seçimi vs şut becerisi – görüntü yazar aittir
Her noktanın bir oyuncuyu temsil ettiği 2B bir grafik ve puan beklenenin üzerindeki ile beklenen pps karşılaştırılabilir
Normalleştirilmiş per-100 metrikini kullandığımız için, tüm oyuncuları karşılaştırmak uygundur. Yatay eksen bir oyuncunun şut diyetinin beklenen değerini, dikey eksen ise gerçek ve beklenen skorlama arasındaki farkı ölçer.
Bu bize dört geniş yorumlama imkanı veriyor:
-
Yüksek xPPS, artı fazlalık: değerli denemeler ve beklentinin üzerinde isabet.
-
Yüksek xPPS, eksi fazlalık: değerli denemeler ancak beklentinin altında isabet.
-
Düşük xPPS, artı fazlalık: daha az değerli denemeler ancak beklentinin üzerinde isabet.
-
Düşük xPPS, eksi fazlalık: daha az değerli denemeler ve beklentinin altında isabet.
Oyuncu A’nın burada en iyi performans gösteren olduğunu söyleyebiliriz: yüksek xPPS ve oldukça artı fazlalık; ancak bu tartışma kesin bir etiket olarak değerlendirilmemelidir. Aynı zamanda FG% ile xFG% arasındaki ilişkiyi de incelememiz gerekir:
Gerçek atış ile beklenen atış – görüntü yazar aittir
Her oyuncu için bir nokta; FG%’nin beklentinin altında ya da üstünde olduğunu görebiliriz
Çizginin üstündeki noktalar, gerçek atış yüzdesi beklentinin üzerinde olan oyuncuları temsil eder. Çizginin altındakiler ise beklenenenden daha az denemeyi isabetlendiren oyuncuları.
Bu fark yine gözlemlenen bir fazlalıktır. Otomatik olarak tekrarlanabilir bir atış yeteneğine dair kanıt değildir.
Bizi önemli bir soruya getirir: Buna ne kadar güvenmeliyiz? Oyuncu A’nın burada en iyi atıcı olduğunu söyleyebileceğimizden emin olabilir miyiz?
7. Beklentinin üzerinde atış, yeteneğin güvenilir bir ölçüsü müdür?
Bu nedenle iki miktarı birbirinden ayırmamız gerekir:
-
Gözlemlenen aşırı performans: bir oyuncunun modelin beklediği sonuçlardan ne kadar saptığı.
-
Yatan atış yeteneği: bu aşırı performansın gelecekteki denemelerde ne kadar sürmesi bekleniyor.
Basit modelimiz ilk miktarı tahmin eder. İkincisini otomatik olarak çözmez. Ve işte tüm basketbol analistleri ve yetenek avcıları için kritik nokta burasıdır. Bu modeller geçmişi açıklamaya çalışır; ancak verinin kendisinden bu aşırı performansın nedenlerini bilemeyiz.
Doğal bir sonraki adım, oyuncuların fazlalıklarının sezonlar boyunca sürüp sürmediğini değerlendirmek olurdu. Örneğin, bir sezonde beklentinin üzerinde atış miktarını tahmin edip, bunun bir sonraki sezondaki aşırı performansı öngörüp öngörmediğini test edebilirdik.
Aynı zamanda ampirik-Bayes küçültmesini de kullanabilirdik; bu yöntem gürültülü oyuncu tahminlerini bir popülasyon ortalamasına çeker ve küçültme miktarı her tahminin belirsizliğine bağlıdır.
Sezgi oldukça basittir: Bir oyuncunun sayısı az sayıda deneme yapması durumunda, gözlemlenen aşırı başarısını yetenek olarak yorumlarken daha temkinli olmalıyız. Deneme sayısı arttıkça, oyuncunun kendi sonuçlarına daha fazla ağırlık verebiliriz.
8. Sınırlamalar ve olası iyileştirmeler
Modelimiz kasıtlı olarak basittir ve bunu geliştirmenin birkaç yolu vardır.
İlk olarak, atış bağlamı önemlidir. Bir atışın mücadele altında yapılıp yapılmadığını, bir pasın ardından gelip gelmediğini ya da atıcı hareket halinde olup olmadığını bilmiyoruz. Aynı noktadan yapılan iki atış çok farklı zorluk derecesine sahip olabilir.
İkinci olarak, oyuncu etkileri daha dikkatli bir muamele gerektirir. Oyuncu kimliğini beklenen atış modelinden çıkardık, çünkü oyuncular arasında karşılaştırma yapabileceğimiz bir temel oluşturmak istedik. Ancak oyuncular atış seçimlerinden çok daha pek çok açıdan birbirinden farklıdır. Daha zengin bağlamsal bilgi içeren bir model, daha anlamlı karşılaştırmalar üretebilir.
Son olarak, beklenen atış yüzdesi ile beklenen hücum değeri aynı şey değildir. Yalnızca saha içi atış denemelerine dayalı bir model, serbest atışlar, top kayıpları, hücum ribaundları veya takım arkadaşları için fırsat yaratma değeri gibi atış kararlarının tüm sonuçlarını hesaba katmaz.
Bu sınırlamalar yaklaşımı işe yaramaz kılmaz. Ne sonuçları mantıklı bir şekilde çıkarabileceğimiz ve olası gelecekteki iyileştirmeler bu sınırlamalarla belirlenir.
Sonuç
Saha içi atış yüzdesi ne olduğunu söylüyor. Beklenen atış modeli ise, her atışın özellikleri göz önüne alındığında, olan ile olmasını bekleyeceğimiz şeyi karşılaştırmamıza olanak tanıyan bir yol sunar.
Bu, atış yeteneğinin tam bir ölçüsü değildir ve beklentileri tutarlı biçimde aşan bir oyuncunun bunu sürdürmesinin kesin olarak garanti edildiğini söyleyemeyiz. Atış zorluğu ancak modelin kullanabileceği özelliklerin ölçüm kalitesi kadar iyi ölçülebilir ve gözlemlenen artı başarı hâlâ gürültü içerir.
Ancak bu ayrım işe yarar. Bir oyuncunun iyi atış yaptığını mı sormak yerine, daha kesin bir soru sorabiliriz:
Skor verimliliğinin ne kadarı yaptığı atışlardan, ne kadarı ise bu atışları beklentiden iyi kılmandan geliyor?
Bu, atış performansını değerlendirmek için daha ilgi çekici bir başlangıç noktasıdır ve aynı zamanda spor analizinde doğru soruyu seçmek, doğru modeli seçmek kadar önemlidir diye hatırlatır.
Bu noktaya kadar okuduğunuz için çok teşekkür ederim. Bu tür içerikleri beğeniyorsanız, eski yazılarımdan bazılarını okumanızı önemle tavsiye ederim.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.