
Hiç bir vida çekici aramak için çekmeceyi açıp içinde yüzlerce başka eşyanın tıkış tıkış durduğunu gördünüz mü? Çekmecede on eşya varsa doğru olanı düşünmeden alırsınız. Ama yüzlerce eşya varsa kazmaya başlarsınız ve er ya da geç yanlış olanı elinize alırsınız.
Ajanlar da aynı çekmeceye giriyor. MCP, aletlerin kurulumunu o kadar kolaylaştırdı ki birkaç sunucu ajanınıza yüzlerce alet sunabiliyor ve her istekte ajan önce aynı soruyu yanıtlamak zorunda kalıyor: Hangisini kullanmalıyım? Genellikle verilen tavsiye, aletler sığdığı sürece hepsini prompt’a eklemek ve sığmadıklarında arama yöntemine geçmektir. Ancak kimsenin size söylemediği şey, bu geçişten sonra ne olduğudur. Alet sayısı arttıkça arama yöntemi dayanıklı mı kalır, yoksa yavaş yavaş çöker mi? Daha büyük bir model için ödeme yapmak yardımcı olur mu?
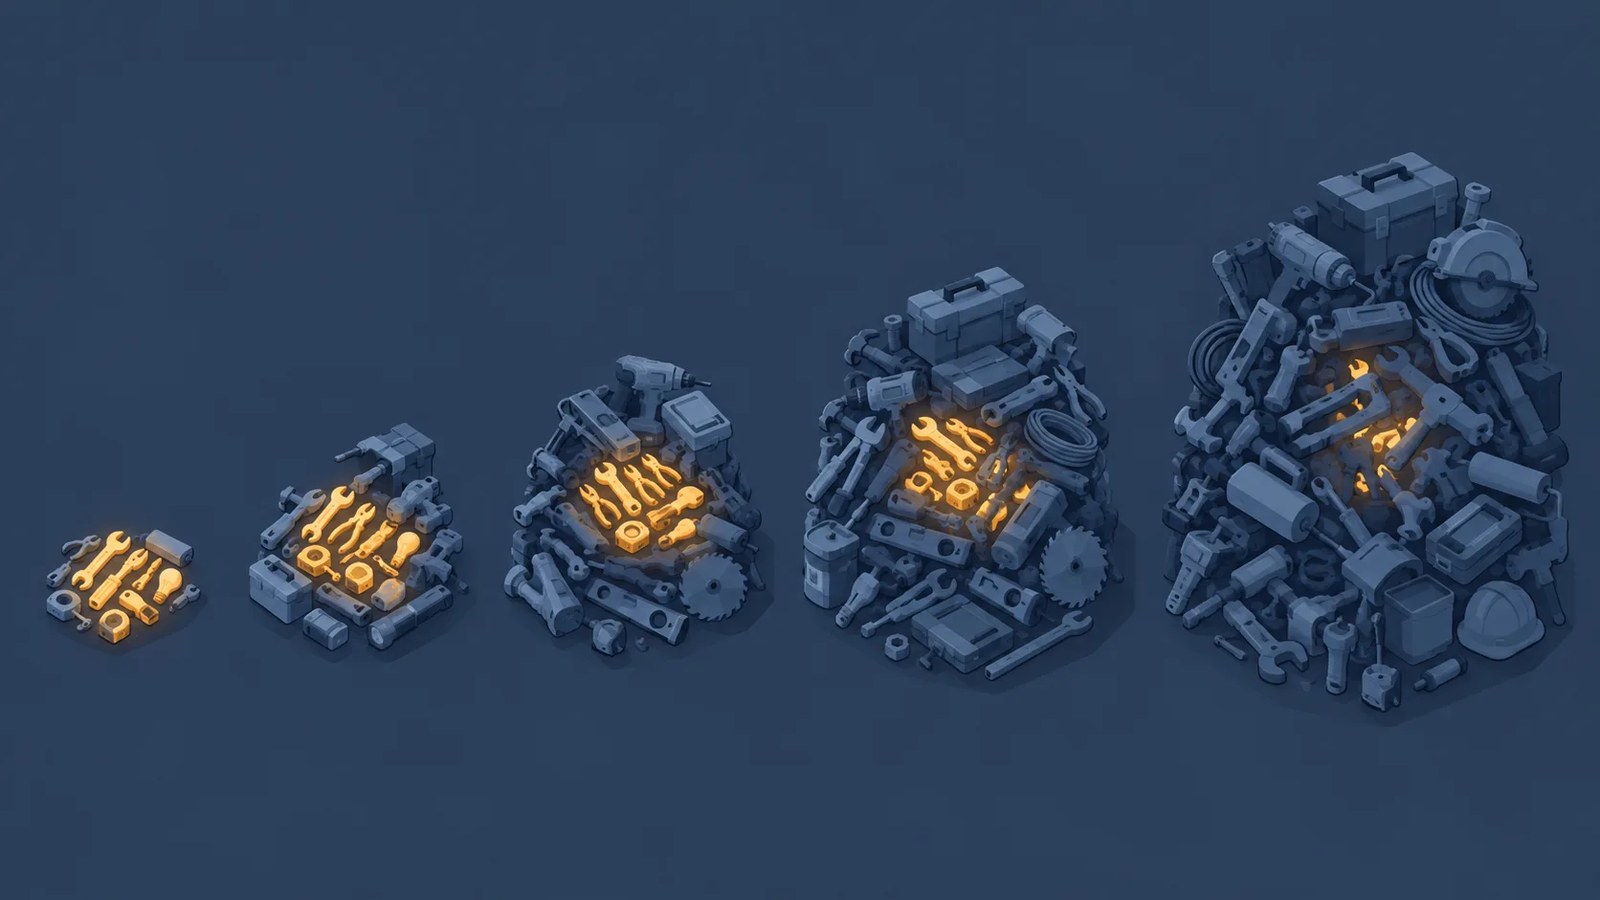
İşte bunu öğrenmek istedim. Bu yüzden ToolRet [1] adlı, alet araması için halka açık bir ölçütten 200 soru aldım ve bunları tamamen aynı tutarak alet yığınını 1.000’den 3.794’e kadar sürekli büyüttüm. Doğru cevaplar hiç değişmedi; sadece etraflarındaki gereksiz içerik arttı. Böylece bir yöntem kötüleşirse, bunun daha büyük yığının suçu olduğunu bileceğiz.

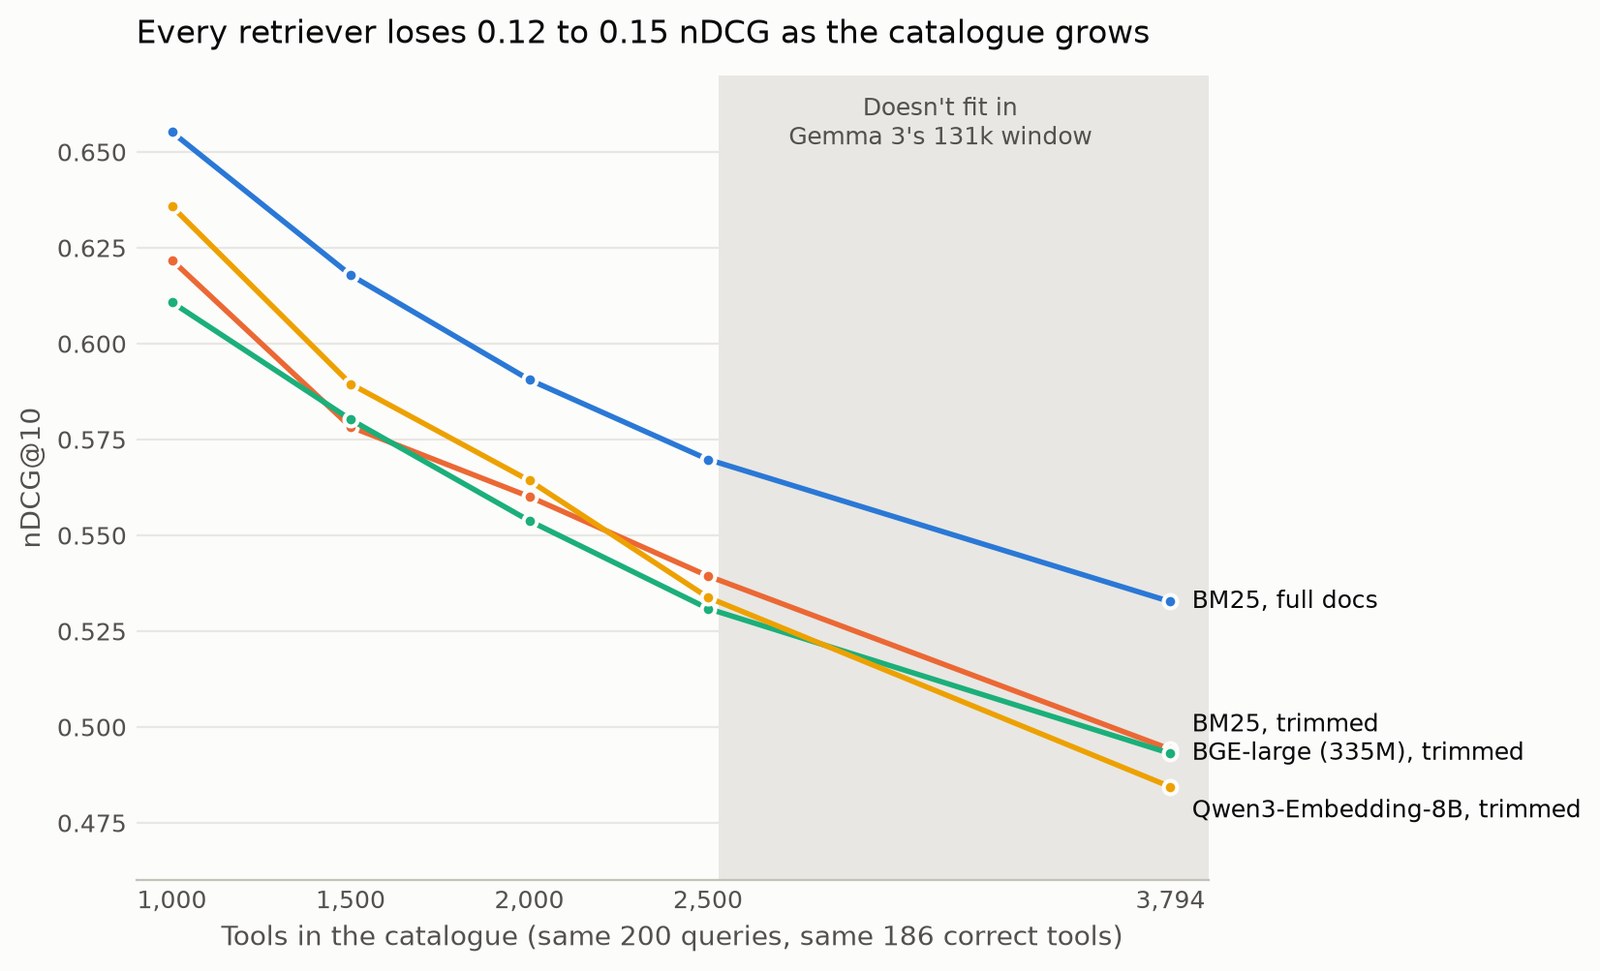
İşte sonuçlar: Her yöntem yığın büyüdükçe kötüleşti ve bu düşüş yaklaşık olarak aynı oranda, yani puanlarının beşte biri kadardı. 1990’lardan kalma basit bir anahtar kelime araması, kendisinden 24 kat büyük bir gömme modeliyle başa baş performans gösterirken yüzlerce kat daha hızlı çalıştı. Tüm aletleri prompt’a eklemek, yığın büyümeyi durdurmadan çok önce yer kalmamasına neden oldu. Daha büyük bir modelden daha fazla fayda sağlayan tek değişiklik ise, aramaya tek satırlık bir özet yerine tam alet dokümantasyonunu vermekti.
Kod, değerlendirme seti ve her bir sorgunun sonucu, isterseniz yeniden çalıştırmanız için GitHub’da mevcut.
ToolRet, otuzdan fazla alet kullanım veri setini yaklaşık 7.600 görev ve 43.000 alet halinde bir araya getiriyor ve her görev, onu çözen aletlerle etiketlenmiş durumda [1]. Bu veri seti MCP’den önce ortaya çıktı ve tamamen MCP ile ilgili değil, ancak tam olarak aynı sorunu test ediyor: Bir isteğiniz, büyük bir alet yığını var ve doğru olanları bulmanız gerekiyor.
Ben bu veri setinin kod kategorisini kullandım; burada 3.794 alet bulunuyor. Bunu biraz sinsi bir nedenle seçtim: Alet açıklamaları o kadar uzun ki Gemma 3’ün 131.072 token’lık bağlam penceresi yaklaşık 2.500 alette doluyor. Bu da prompt yaklaşımının çöktüğü noktayı deneyin tam ortasına yerleştiriyor ve böylece bunun nasıl olduğunu gözlemleyebiliyoruz.
200 soru toplamda 186 farklı alet gerektiriyor. Her yığın bu 186 aletin tamamını içeriyor, geri kalanı ise dolgu malzemesi:
Her yığın, bir öncekinin üzerine daha fazla alet eklenerek oluşturuluyor, bu yüzden satırlar arasında başka hiçbir şey değişmiyor.
Her yöntemi puanlamak için ilk on seçeneğine bakıp üç soru soruyoruz: Doğru alet ilk onda yer alıyor mu? Bu, Recall@10’dur. Ajanın kullanma olasılığının en yüksek olduğu yer olan listenin üst kısımlarında mı? Bu, ana puan olan nDCG@10’dur. Ve eğer görev üç alet gerektiriyorsa, üçü de listede mi? Bu da Completeness@10’dur ve önemlidir, çünkü üç aletten ikisine sahip bir ajan görevi yine de tamamlayamaz.
Her alet sadece adı ve 180 karakterle sınırlandırılmış kısa bir açıklamasıyla gösteriliyor. Bu seçime sonlara doğru tekrar döneceğiz, çünkü bunun herhangi bir modelden daha fazla önem taşıdığı ortaya çıkıyor.
Neden Sadece Tüm Aletleri Prompt’a Eklemiyoruz?
Çoğu insanın ilk denediği ve mantıklı gelen yöntem bu: Tüm kataloğu prompt’a yapıştırın, görevi açıklayın ve modelin seçim yapmasına izin verin. Yanlışlıkla hiçbir şey filtrelenmez, çünkü doğru alet her zaman orada, gözünün önündedir.
Bunu yerel olarak Ollama aracılığıyla bir M5 Pro ve 48 GB bellek üzerinde çalışan Gemma 3 12B ile denedim. 1.000 aletle prompt 53.160 token’a ulaşıyor ve model cevabı vermeden önce sadece bunu okumak için 215 saniye harcıyor, cevabın kendisi ise 2,3 saniye sürüyor. Uyumlu dört yığın boyunca 200 soruyu yanıtlamak yaklaşık 82 saat sürerdi. Bu yüzden birkaç sorgunun süresini ölçüp orada durdum. Yani bu yaklaşım için doğruluk verilerim yok ve daha küçük yığınlarda arama yöntemini geçip geçmeyeceğini de söyleyemem.
Daha büyük sorun ise yer eksikliği. 3.794 aletlik tam yığın, kısaltılmış açıklamalarla bile yaklaşık 198.000 token’a ulaşıyor ki bu da Gemma 3’ün bağlam penceresini aşıyor. Tam dokümantasyonla birlikte 1.000 alet bile sığmıyor. LLM ne yaparsa yapsın, her zaman aletlerinin kısaltılmış bir açıklamasıyla çalışır. Bunu ileride akılda tutun.
Eğer bu yolu seçerseniz, iki şey işinizi biraz kolaylaştırabilir. Birincisi, Ollama’nın varsayılan bağlam penceresi küçüktür ve prompt’unuz daha uzun olduğunda hata vermeden token’ları baştan keser ve cevabı yine de verir. num_ctx değerini yeterince büyük ayarlayın ve yanıtta prompt_eval_count değerini kontrol ederek tüm kataloğun gerçekten okunduğundan emin olun. İkincisi, kataloğu önce, soruyu ise sona koyun. Katalog her seferinde aynı olduğundan model onu önbelleğe alabilir ve her istekte sadece yeni soruyu okuyabilir. Soruyu öne koyarsanız her seferinde tam 215 saniye ödersiniz.
1 milyon token’lık pencereye sahip barındırılan bir model tüm yığını sığdırabilir, ancak her istekte bunun maliyetini ödersiniz. Bu deneyi yaptığım sıradaki liste fiyatlarına göre, 3.794 aletin tamamı için önbelleksiz bir sorgu Claude Opus 5 üzerinde yaklaşık 0,99 dolar, Sonnet 5 üzerinde ise 0,40 dolara mal oluyordu. Prompt önbellekleme bu maliyeti önemli ölçüde düşürüyor, ancak yine de her seferinde tüm kataloğu göndermek zorundasınız.
BM25 ve Kod İçin Tek Bir Düzeltme
BM25 [2] bir anahtar kelime aramasıdır. Bir alete, soruyla paylaştığı her kelime için puan verir; nadir kelimeler için daha fazla puan ve kısa açıklamalar için küçük bir bonus ekler. Burada ne bir model ne de bir GPU var.
Ancak burada bir tuzak var: Alet adları kod gibidir, örneğin get_factors veya QueryHistoryToday. Metni boşluklara göre ayırırsanız get_factors tek bir uzun kelime olarak kalır ve sıradan bir İngilizce soru bunu asla içermez. Alet sessizce sıfır puan alır ki bu da kötü bir sonuç gibi görünse de aslında bir hatadır. Çözüm, adları alt çizgilerden ve büyük harflerden ayırmak ve orijinalini de korumaktır:
Artık get_factors, get_factors, get ve factors olarak indekslenir ve faktörlerle ilgili bir soru onu bulabilir. BM25’in geri kalanı yaklaşık otuz satırlık standart koddan oluşuyor ve kod deposunda bulabilirsiniz.
Bir gömme modeli her aleti ve her soruyu bir sayı listesine dönüştürür ve sayıları birbirine yakın olan aletler kazanır. Bunun güzel yanı, kelimelerin aynı olması gerekmemesidir. “Bir sayının faktörlerini bulma” ile ilgili bir soru, “tüm bölenleri dönen” bir aleti bile bulabilir.
Üçünü denedim: BGE-large (335 milyon parametre) [3], e5-large-v2 (335 milyon) [4] ve kendisinden 24 kat büyük olan ve 16 GB bellek gerektiren Qwen3-Embedding-8B [5]. Her aleti önceden bir kez kodluyoruz ve bundan sonra her soru tek bir kodlama işlemi ve hızlı bir çarpma işleminden ibaret.
Kolayca gözden kaçabilecek bir şey var: Her model ailesi, metnin önüne kendi küçük öneki eklenmesini bekler ve yanlış öneki kullanmak, herhangi bir uyarı olmaksızın puan kaybetmenize neden olur.
Eğer modeli adından seçiyorsanız, en spesifik isimlerden başlayın. e5-mistral-7b-instruct adında “e5” geçse de aslında instruct formatını değil, E5’in formatını bekler.
Önce Ara, Sonra Yeniden Sırala
Bir gömme modeli asla soru ile aleti birlikte incelemez. Her ikisini ayrı ayrı sayılara dönüştürür ve sayıların birbirine yakın olmasını umar. Bir çapraz kodlayıcı ise ikisini yan yana okuyup ikiliye bir puan verir, bu da daha kesin sonuçlar sunabilir. Ancak sorun, puanladığı her alet için ayrı ayrı çalışması gerektiğidir, bu yüzden tüm yığını ona yönlendiremeyiz. Bunun yerine BGE-large ilk 50 aleti seçer ve çapraz kodlayıcı (bge-reranker-v2-m3) sadece bunları yeniden sıralar.
Yeniden sıralayıcı sadece kendisine verilenleri değiştirebilir. Eğer doğru alet bu 50 alet arasında değilse, sonsuza dek kaybolur.
Temel Bulgular ve Genel Değerlendirme
Tam dokümantasyon her satırda yaklaşık 0,02 ila 0,04 puan farkla kazanıyor. Bu, en küçük yığında Qwen3-8B’nin BGE-large’a kıyasla kazandığı farkla hemen hemen aynı, ancak burada bunu elde etmek için 16 GB’lık bir modele ihtiyacınız yok. Yine de dikkatli olmak istiyorum: Yığınlar örtüştüğü için bu on zafer on ayrı deney değil ve yeniden örnekleme yaptığımda sadece birkaçı kendi başına tutarlı kalıyor; BM25’in tam yığında elde ettiği kazanç da bunlardan biri. Yön tutarlı, ancak tam büyüklük belirsiz.
Tam dokümantasyon üzerinde BM25 test ettiğim en iyi kurulumdu; tam yığında 0,533 nDCG elde ederken soru başına yaklaşık bir milisaniyede çalıştı. Ancak Qwen3-8B’yi veya yeniden sıralayıcıyı tam dokümantasyon üzerinde çalıştırmadım, bu yüzden BM25’in onları geçtiğini iddia edemem. Tahminimce onlar da daha iyi sonuç verirdi.
Bu aynı zamanda prompt yaklaşımını biraz daha kötü gösteriyor. Aramaya en çok yardımcı olan metin, tam da LLM’nin sığdıramadığı metin.
Bu, Ajanınız İçin Ne Anlama Geliyor?
0,53’lük bir nDCG fena görünmeyebilir. İşte aynı sonucun başka bir şekilde ifade edilmesi: 3.794 aletle en iyi kurulum bile bir görev için gereken her aleti ilk onda sadece %65 oranında bulabildi. Diğer %35’lik görevlerde ajan daha başlamadan en az bir aleti kaçırıyordu. Qwen3-8B %60, BGE-large ise %56 başarı oranına ulaştı. Bu, ajanın daha bir şey yapmadan başarısız olduğu çok sayıda görev anlamına geliyor.
Kod kategorisi anahtar kelime araması için elverişli. Buradaki alet adlarının çoğu, get_factors gibi, ne yaptığını açıkça belirtiyor, bu yüzden bir soru ile doğru alet genellikle ortak kelimeler paylaşıyor. Belirsiz veya markalı isimlerle dolu bir katalogda gömme modelleri öne geçebilir. ToolRet’in web ve özel kategorileri bunu test etmek için daha uygun yerler olurdu.
Her soru ayrıca ToolRet’in GPT-4o kullanarak yazdığı bir talimat içeriyor. Bu, her soruya ek kelimeler ekliyor ve muhtemelen BM25’e gömme modellerinden daha fazla yardımcı oluyor. Henüz bu talimatsız bir deneme yapmadım.
İki yüz soru çok fazla değil, bu yüzden boşlukların çoğunu berabere olarak nitelendiriyorum. Mutlak sayılar da ToolRet makalesinin kendi liderlik tablosuyla uyuşmuyor; o makale tüm 43.000 aleti her kategoride kullanıyor. Ancak eğrilerin şekli korunuyor, tam puanlar değil.
Son olarak, denemediğim çok şey var: BM25 ile gömme modellerini birleştirerek hibrit bir arama oluşturmak, alet verileriyle eğitilmiş bir yeniden sıralayıcı kullanmak veya LLM’nin sığabildiği yığınlarda ne kadar doğru olduğunu ölçmek. Bir sonraki adımım hibrit aramayı denemek olurdu.
Eğer ajanınızın sadece birkaç düzine aleti varsa, bunların hiçbiriyle uğraşmayın. Hepsini prompt’a ekleyin ve modelin seçim yapmasına
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔















Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.