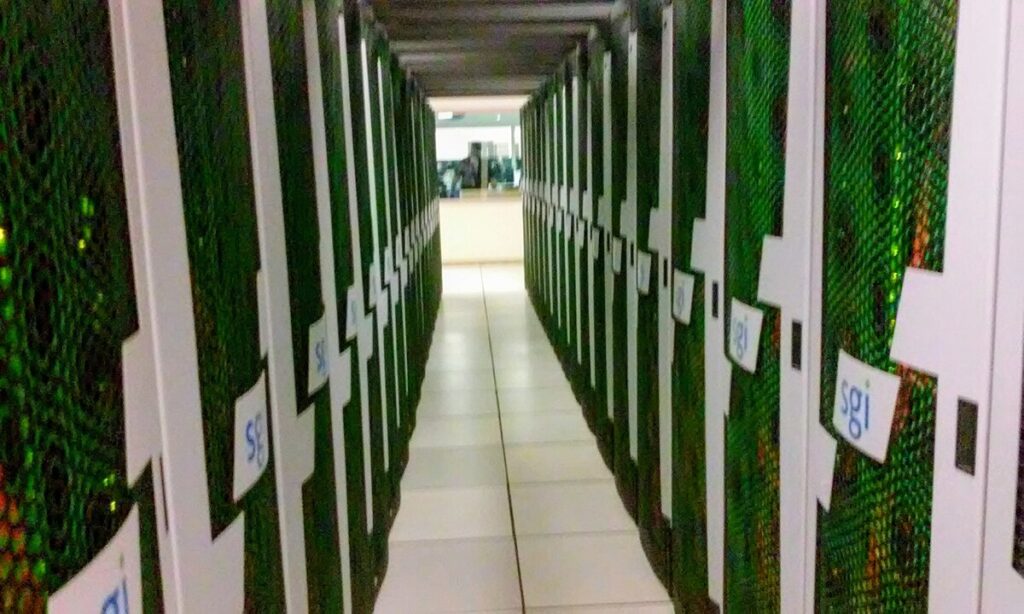
Teknoloji tarihinin en tuhaf paradokslarından biri şudur: insanlığın en güçlü makinaları, çoğu zaman kendi başarısını değil, başkalarının onları nasıl çalıştırdığını ölçmek için tasarlanmış küçük bir test paketinin içine hapsedilir. Standard Performance Evaluation Corporation adını taşıyan bu kuruluş, aslında donanım üreticileri ile yazılım mühendisleri arasındaki o görünmez bağrı kavuşturan zeminde kurduğu SPEC CPU2017 paketiyle, işlemcilerin ham güçlerini sayılarla ölüme kadar tanımlamayı başardı. 2006 versiyonunun ardına düşen bu paket, yalnızca sentetik görevlerin tekrarlanan bir cehenneminden ibaret değildir; içindeki on yedi test programı, gerçek dünya fiziğinin derinliklerinden kesilen ince dilimlerdir. Birkaç dakikada tamamlanan bu benchmark’lar, aslında rüzgârın kanat üzerindeki akışını modelleyen kodlardır, görsel motorların ışığı parçacık parçacık izleyerek ekrana yansıttığı sahnelerdir, genetik algoritmaların nesiller boyu evrimleşmesini simüle eden döngülerdir. Bu yüzden SPEC CPU2017’i bir “test” olarak okumak yerine, onu bir makinenin zihinsel kapasitesini ölçen bir röntgen filmi gibi düşünmek daha doğru olur.
Yedi Kategori ve Dört Ayna
Paketin içine baktığımızda karşımıza ilk çıkan şey, testlerin aslında birbirinden tamamen farklı dünyaları temsil etmesi gereken bir disiplinli çeşitlilik olmasıdır. SPEC CPU2017’in omurgasını dört ana kategori oluşturur: Rate (Hız), Workload (Yük), Multicore ve Server. Rate kategorisi, günlük yazılımın kalbini çarpan genel amaçlı uygulamaları barındırır; burada C, C++ ve Fortran’ın en saf hâlinde yazılmış küçük ama keskin programlar, bir işlemcinin genel zekâsını sorgular. Workload kategorisi ise çok daha derine iner; büyük ölçekli bilimsel ve mühendislik uygulamalarıyla, makinenin gerçek problemleri çözme kapasitesini ölçer. Bu kategori, sıradan benchmark’ın ötesine geçerek, bir sunucunun yalnızca hızlı olup olmadığını değil, gerçekten ağır yükleri kaldırıp kaldıramayacağını sorar. Multicore kategorisi modern çağın belkemiği olan çok çekirdekli mimarinin kendisine adanmıştır ve iş parçacıklı yüklerin nasıl yönetildiğini gözler. Son olarak Server kategorisi, veri tabanı sorgularından sunucu tarafı uygulamalara kadar uzanan geniş bir yelpazeyi kapsar. Bu dört kategori birbirinden bağımsız aynalar gibi çalışır; her biri makinenin farklı bir yüzünü ortaya koyar ve hepsinin ortalaması alınarak tek bir skor üretilir. İşte bu, SPEC’in en büyük felsefesidir: tek bir sayıya indirgenen karmaşık gerçekliği, birden fazla aynadan yansıtarak daha dürüst bir şekilde yakalamak.
Metriklerin İki Yüzü: Süre ile Verim
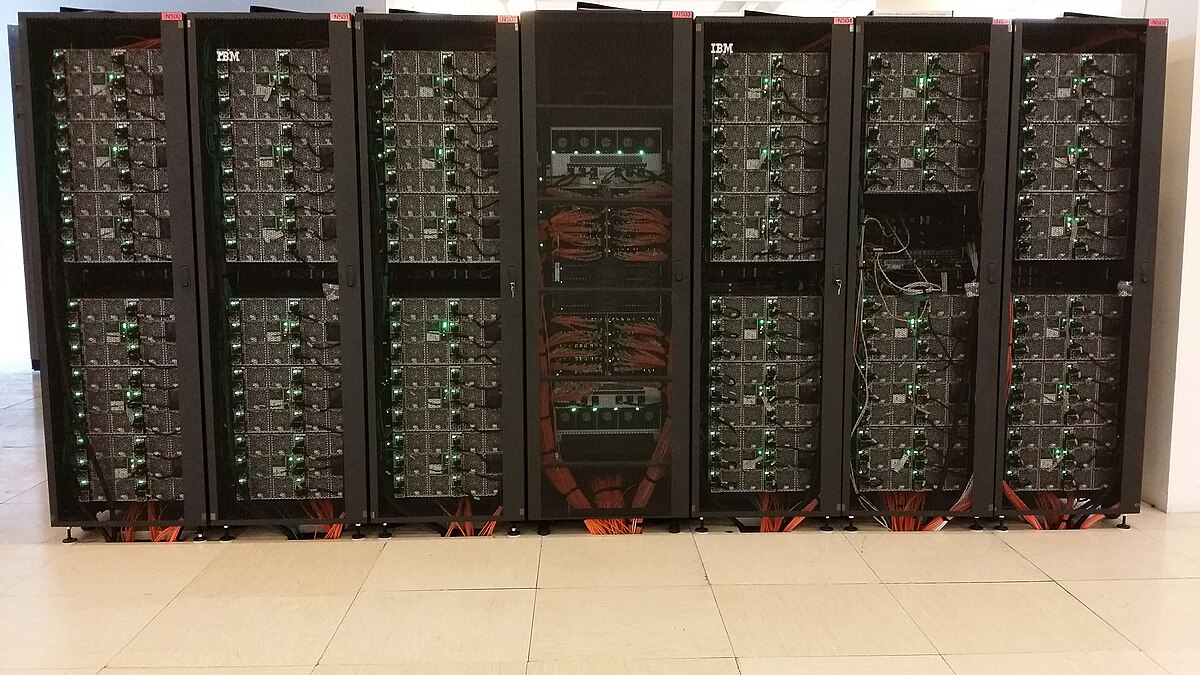
Bu paketi anlamaya çalışan herkesin takıldığı en kritik nokta, SPEC’in aslında iki tamamen farklı metrik üzerinden dünyayı yorumlamasıdır ve bu ikisi birbirini çürütmez. Birincisi SPECspeed, tek iş parçacıklı tamamlama süresidir; burada düşüncemiz basittir ve saf olmaktır: bir program ne kadar hızlı bitiyorsa makine o kadar iyidir. Bu metrik, işlemcinin tek başına, başka birinin yardım etmesini beklemeden çözebileceği işi ne kadar kısa sürede halledebileceğini ölçer. SPECspeed2017 formülü, referans makinenin performansını baz alarak normalize eder ve böylece farklı donanım platformları arasında adil bir karşılaştırma imkânı tanır. Düşük bir süre, yüksek bir skor anlamına gelir; bu yüzden burada “az” kazanmaktır. İkinci metrik ise SPECrate olup çok iş parçacıklı dünyaya adanmış verimlilik göstergesidir. Bu metrik, bir makinenin tüm çekirdeklerini ne kadar etkili kullandığını sorar ve burada “çok” kazanılır. SPECrate, temelde SPECspeed değerini, kullanılan toplam iş parçacığı ile aktif olanların oranıyla çarpma mantığı üzerinden kurar; yani bir makine 128 çekirdeğe sahipse ama sadece 64’ünü kullanıyorsa bu da onun verimliliğinin yarısı olduğunu ima eder. Bu iki metrik arasındaki gerilim, aslında modern donanımın içine gömülü olan temel çatışmayı yansıtır: tek bir çekirdeğin derinliği ile çoklu çekirdeğin genişliği arasındaki sonsuz ikilem. Bir üretici SPECspeed’de mükemmel sonuç alırken SPECrate’da kötü performans gösteriyorsa, bu onun güçlü ama verimsiz bir makine olduğunu açıkça ortaya koyar.
Gene Amdahl’ın 1967 Soneti
Tüm bu metriklerin arkasında, aslında yirmi beş yıl önce yazılmış ve bugün bile geçerliliğini koruyan bir matematiksel şiir bulunur: Gene Amdahl’ın 1967’de formüle ettiği efsanevi Amdahl Yasası. Bu yasayı anlamak, modern paralel donanımın kendi sınırlarını kabullenmesi gereken ilk dersidir. Amdahl, bir programın tamamının belli bir oranda paralelleştirilemeyeceğini fark etmişti; her programda mutlaka seri olarak çalışması gereken bir parça vardır. Bu yasayı şu zarif formülle ifade ederiz: Hızlanma = 1 / (s + (1−s)/p), burada s programın paralelleştirilemeyen seri kısmının oranını, p ise paralel hızlanma çarpanını temsil eder. Formülün gizli hediyesi şudur ki, p sonsuza giderse hızlanmanın üst sınırı 1/s olarak sabit kalır. Yani bir programın %10’ı ebediyen seri çalışacaksa, onu sahip olduğumuz en gelişmiş sunucuda bile, hatta 128 çekirdeğe sahip devasa bir makinede bile, teorik maksimum hızlanma tam on kat olarak tavana mahkûmdur. Bu, donanım mühendisliğinin en acımasız gerçeğidir: çekirdek sayısını ikiye katlasanız bile, o %10’lık seri parça sizi asla iki katına çıkarmaz. Amdahl’ın bu yasası, paralellemeye körü körüne inananların tuzağına dönük bir uyarı niteliğindedir; çünkü hızlanmayı hesaplamada “pay” olarak ele alınan gerçek iş miktarının, toplam zamanın yalnızca küçük bir kısmını oluşturabileceğini hatırlatır.
Belki de En Zarif İstisna: Lawrence’s Law
Ancak Amdahl’ın yasasının o keskin ve soğuk yüzünün tam karşısında, on yıllar sonra ortaya çıkan çok daha umut verici bir düşünce biçimi bulunur ve bu, aslında paralellemeye dair perspektifimizi kökten değiştirir. Lawrence Rogers’un 1990’larda formüle ettiği “Lawrence Yasası”, Amdahl’ın sabit pay yaklaşımını sorgular ve diyor ki: eğer programın tamamının zamanı artarsa, paralelleştirilebilir kısmın oranı da büyür. Yani bir veri setini iki katına çıkarırsanız, o veriyi işleyen kodun tamamı paralel çalışabilir hale gelebilir; böylece hızlanma artık sabit bir tavana takılmaz, tam tersine veri miktarıyla birlikte büyür. Bu iki yasa arasındaki gerilim, donanım tasarımının asıl sorusunu ortaya koyar: biz programları paralelleştirmek için mi yoksa problem boyutlarını büyüterek paralellik yaratmak için mi çalışmalıyız? Modern yüksek performanslı hesaplama (HPC) dünyasında bu ikilem her gün yeniden çözülür; çünkü veri madenciliği, makine öğrenmesi ve iklim simülasyonları gibi alanlarda Lawrence mantığı giderek egemen olmaya başlar. Bu perspektiften bakıldığında, Amdahl’ın yasası bir ölüm haberi değil, aslında doğru stratejiyi seçmemizi gerektiren bir pusula olarak okunmalıdır.
Önbellek Hiyerarşisinin Gizli Maliyeti
Tüm bu yasalara rağmen, gerçek dünyada performansın belirlendiği yer aslında matematik formüllerinde değil, mikroskobik önbellek katmanlarının derinliklerindedir. Bir işlemci, ana belleğe ulaşmadan önce ver
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.

Bir yanıt yazın