

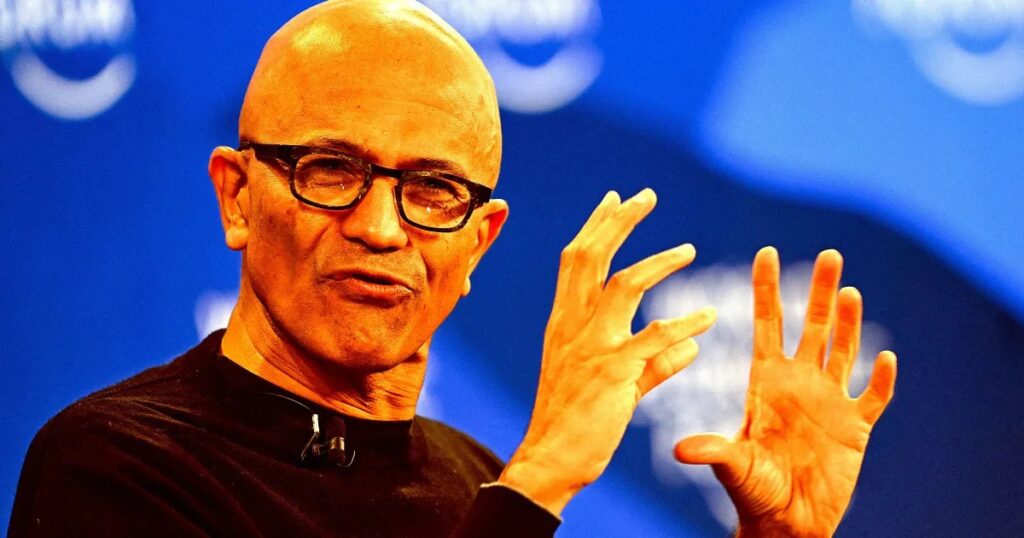
Yapay zeka devinden Microsoft yöneticileri, şirketinin geliştirdiği modellerin medya kuruluşlarından içerik alırken karşılığında neredeyse hiçbir şey vermediğine itiraf ederek bu durumun web’in tamamını tehdit eden bir “doom loop” (imha döngüsü) yarattığını kabul etti. Bu açıklamalar, CEO Satya Nadella’nın da aralarında bulunduğu üst düzey yöneticilerin, yakın zamanda mahkemeye sunulan iç belgelerde ortaya konan ifadeleridir.
Medyayı besleyen kaynakların ekonomik temellerini tehdit eden bu yapının tanımı, yapay zeka şirketlerinin içerik tedarik zinciriyle ilgili karşılaştığı kritik sorunu gözler önüne seriyor. Microsoft’un kendi belgelerinde yer alan değerlendirmeler, sektörün uzun süredir tartıştığı telif hakkı ve içerik kullanım meselelerini doğrudan ortaya koyuyor.
Mahkemeye Sunulan Belgelerde Ortaya Çıkan İtiraf
Bu çarpıcı açıklamalar, OpenAI’ın New York Times (NYT) tarafından başlattığı sürmekte olan telif hakkı davasının parçasını oluşturuyor. Microsoft, OpenAI’nin en büyük hissedarı olması nedeniyle dava sürecine dahil edildi. NYT avukatları, kendi davalarnı desteklemek için Microsoft ve OpenAI yönetiminin yaptığı birkaç belirleyici açıklamaya atıfta bulundu.
Belgede yer alan ifadelere göre şirket, geliştirdiği yapay zeka içeriği stratejisinin hem modellerinin performansını hem de tüm web’in sağlığını aynı anda zarar verecek bir döngü başlattığını belirtti. “Bir son kullanıcının ürünü, temel tedarikçilerinin ekonomik temellerini tehdit etmesi oldukça olağan dışıdır; ancak LLM işimiz için ‘içerik tedarik zinciri’ açısından karşılaştığımız durum tam da budur” denildi.
“Yapay zeka içerik stratejimiz, modellerimizin performansı ile tüm web’in sağlığını aynı zamanda etkileyecek bir ‘doom loop’ başlattı. Bir son ürünün, temel tedarikçilerinin ekonomik temellerini tehdit etmesi oldukça olağan dışıdır; ancak LLM işimiz açısından ‘içerik tedarik zinciri’ konusunda karşılaştığımız durum tam da budur.”
Microsoft İç Belge
Nadella’dan Konuyla İlgili Değerlendirme
CEO Satya Nadella, daha az dramatik bir dille benzer bir noktaya değindi. Yapay zeka sohbet botlarıyla görüşürken, kullanıcıların artık bilgiye web sitesinde doğrudan erişebildiğini ve bu nedenle alt kaynaklara gitmesine gerek kalmadığını belirtti. NYT avukatlarının alıntıladığı ifadelere göre Nadella, “kullanıcıya bilgiyi doğrudan AI platformunda sunmanın… aslı kaynağa gitme ihtiyacını ortadan kaldırdığını” söyledi.

Bu ifadeler, yapay zeka şirketlerinin eğitim verisi elde ederken karşılaştıkları etik ikilemleri de gözler önüne seriyor. Şirketlerin modellerini güçlendirmek için ihtiyaçları olan veriye erişirken kullandıkları yöntemler, özellikle ücretli içeriklere erişim konusunda tartışma konusu olmaya devam ediyor.
Telif Hakkı Duvarlarını Aşmaya Yönelik Uygulamalar
Açıklamalara göre OpenAI, ihtiyaç duyduğu eğitim verisini elde ederken birkaç ahlaki kaygı göstermediği iddia ediliyor. Şirket, ücretli içerik duvarlarını (paywall) tespit edilmeden atlatmak için farklı yöntemlere başvuruyor. Bir çalışan, şirketin kurucularından Greg Brockman’a NYT’nin telif hakkı duvarını aşmanın bir yolunu sunduğunda, Brockman’ın verdiği yanıt oldukça kısa oldu: “Ah, güzel.”
Bu tür olaylar, yapay zeka sektörünün içerik kullanım pratiklerinin nasıl işlediğine dair önemli ipuçları sunuyor. Şirketlerin ticari amaçla kullandıkları verilerin yasal sınırları içinde kalıp kalmadığı sorusu, hem hukuki hem de etik açıdan önemini koruyor.
Bu gelişmelerin ardından, yapay zeka şirketlerinin içerik tedarik zincirleriyle ilgili geliştirdikleri stratejiler ve bu stratejilerin medya sektörüne etkileri, devam eden tartışmaların odak noktasını oluşturmaya devam ediyor. Sektörün geleceğinde içerik üreticileriyle teknoloji şirketleri arasındaki ilişkinin nasıl şekilleneceği merakla bekleniyor.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.