
Deepseek, açık ağırlıklı V4.1 Flash modelini 1017 revizyonuna güncelledi. Sadece bir nokta revizyonu gibi görünen bu güncelleme, aslında model verimliliğinde önemli bir adım olabilir. Ürün sayfasında Deepseek, “isteğe programlama gerçeğe dönüştü” sloganını kullanıyor; bu muhtemelen yaygın kullanımadaki “vibe coding” terimine bir gönderme ve modelin geniş açıklamalı, açık uçlu görevler için uygun olduğunu ima ediyor. Ancak model gerçekten ucuz ve iyi sonuçlar veriyor olsa da, uydurma yapmaya meyilli olabilir.
LLM’ler temelde iki kategoriye ayrılır: Ön uç laboratuvarlarının modelleri pahalı çalıştırdığı ancak mükemmel sonuçlar verdiği ticari, kapalı girişimler ile güvenilirliği çok daha ucuz bir çalıştırma maliyetine (özellikle uzun süreli ajan görevlerinde) karşılayan açık ağırlıkllı Çinli rakipler.
Deepseek V4.1 Flash (DSF), toplam 552 milyar parametreli, bunların 16 milyarının çalıştırma sırasında aktif olduğu bir Uzmanlar Karışımı (MoE) modelidir. Model çok moduldur, hem metni hem de görüntüleri girdi olarak kabul eder ve bağlam penceresinin uzunluğu artık standart sayılan 1 milyon tokena ulaşır.

Deepseek’in iç ölçeklendirmelerine göre model, GPT-5.6 Sol ile Claude Opus 5 arasına rahatça oturuyor ve hatta Anthropic’in LLM’sini görev testlerinde geride bırakıyor. Bu başlı başına güçlü bir performans olsa da, DSF’in bu son revizyonu görev başına performans ve token verimliliğinde parlıyor. V4 Flash’tan V4.1 Flash’a geçiş, donanım gereksinimlerini belirgin şekilde düşürdü: V4.1, öncekine kıyasla KV önbelleği için yalnızca dörtte bir HBM ve sekizde bir SSD depolama alanı kullanarak giriş başına yalnızca 890 bayt harcıyor.
Şirket, bu noktayı 2 Eylül tarihli DeepSWE veri setine dayanan bir görev başına maliyet grafiğiyle açıklıyor ve hem DSF hem de DSF-1017 için kendi veri noktalarını ekliyor. Her iki varyant da istenilen sol üst bölgede toplanıyor ve DSF-1017’nin düşük çaba gerektiren çalıştırmaları bile pahalı rakiplerin “maks” ayarlarına yakın bir görev tamamlama oranı sunuyor. DeepSWE’in yalnızca çok sayıda ölçeklendirmeden biri olduğunu unutmamak gerek, ancak yine de bu izlenim verici bir sonuç.
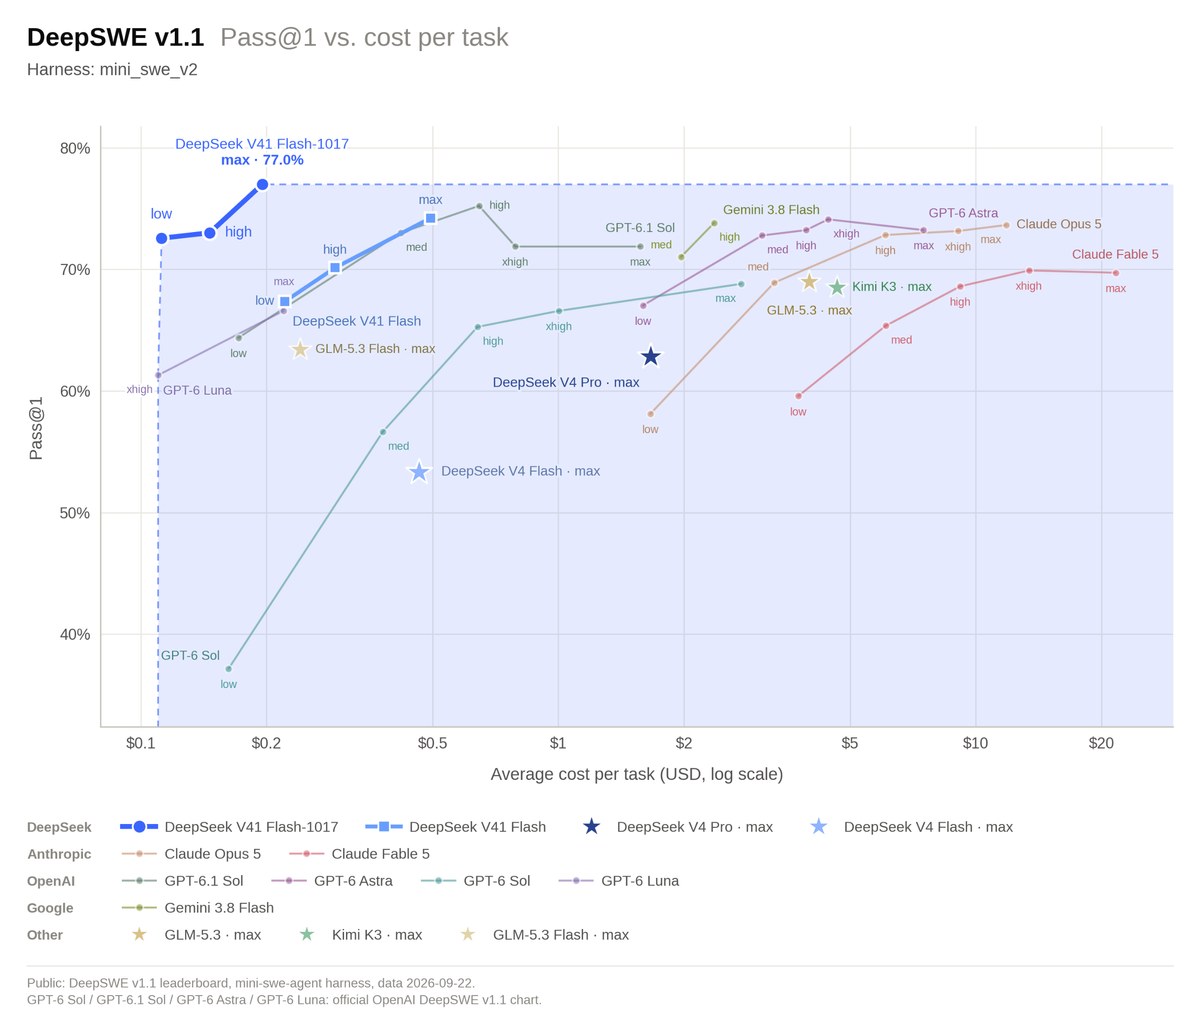
(Görsel kaynağı: Deepseek)
Deepseek’in kendi fiyatlandırmasıyla bile (hatırlatmak gerekir, bu her yerde çalıştırabileceğiniz açık ağırlıklı bir model), tepe olmayan saatlerde milyon token başına fiyat giriş için sadece 0,15 dolar, çıkış için 0,6 dolardır. Önbellek isabolarında giriş token maliyeti 0,003 dolara kadar düşüyor. Üçüncü taraf sağlayıcıların geçmişte Deepseek API’den daha ucuza hizmet verdğini unutmamak gerek, bu nedenle farklı çıkarım sağlayıcılarını karşılaştırmak bu rakamların daha da düşebileceği anlamına gelir. Deepseek ayrıca 1.000 sorgu başına 0,75 dolarlık bir arama işlevi de sunuyor ve bu rakam rakipleri geride bırakıyor; en yakın rakip ise 1 dolar olan Parallel.
DeepSWE yalnızca mevcut olan tek ölçeklendirme değil. Artificial Analysis, DSF-1017’yi (maks) büyük açık ağırlıklı sınıfında zeka endeksinde yalnızca 2. sıraya yerleştiriyor ve 45 puan alıyor. Karşılaştırma için, görünüşte en zeki model olan Claude Opus 5.5 (düşüşlü maks) 58 puan alıyor. Bu aynı zamanda kategorisindeki en hızlı modellerden biri ve görev başına maliyeti yalnızca Xiaomi’nin MiMo V2.6-Pro’sinden daha düşük.
Bunların hepsi çok iyi geliyor olabilir, ancak herkesin bildiği “hızlı, ucuz ve güvenilir, ikisini seç” atasözünü bilmek gerekir. O halde işin içinden çıkılan kısım ne? Bir kelimeyle: uydurma. Bir modelin zeki olması, güvenilir olduğu anlamına gelmez. Genel olarak kullanıcılar, destekleyici bulguları olmadığında cevap vermeyen modelleri tercih eder ve DSF-1017 bilmediği şeyleri bilmede pek iyi görünmüyor.
Artificial Analysis’in Omniscience ölçeklendirmesi bu konuda oldukça net: modeli en alt sıralara yerleştiriyor. Soruları doğru şekilde yalnızca %43 oranında cevaplıyor, ki bu açık ağırlıklı modeller arasında en iyilerden biri, ancak özel rakiplerden daha düşük. Bu, cevapları temelsiz bir şekilde atlıyor olsaydı tamamen kabul edilebilir olurdu, ancak cevaplamadığı konuların %67’sinde uydurma yaptı.
Ölçeklendirmenin ana indeksi iyi cevaplar için puan verir, yanlış cevaplar için bu puanlardan düşürür ve cevaplamadıklar sayılmaz. DSF-1017 5 puan alırken, Kimi K3-max 20 puan alıyor ve ön uç modeller 42 ve üzeri puan topluyor. Sonuç olarak bu, DFS-1017’nin kesinlikle beceriksiz olmadığı anlamına geliyor — aksine tam tersi — ancak modelin hangi görevlerin kendisine verilmesi gerektiği konusunda dikkatli olunması gerekir.
Programlama, incelemeli OCR ve biçim dönüştürme gibi sonuçları doğrulanabilir görevler iyi gider, çünkü ajan kendi çalışmasına karşı doğrulama adımları çalıştırıp yeniden deneyebilir. Ancak açık uçlu araştırma, gerçek araştırma ve son derece kesin belgelerin yorumlanması veya taslaklarının hazırlanması, halüsinasyonların muhtemelen yeterince dizginlenemeyeceği ve sonuçların pek güvenilir olmayacağı için daha ileri düzeyde bir model ya da, bilirsiniz, bir insan için daha uygun görevlerdir.
“Hızlı ve gevşek” yaklaşımı, son derece yetkin açık ağırlıklı modeller için de oluşan bir eğilim gibi görünüyor. Birkaç ay önce, Kimi K3 piyasaya sürüldüğünde, herkes onun ne kadar etkili ve ucuz olduğundan ve fiyatın yalnızca bir fraksiyonunda ileri düzeyde zeka sunma vaadinden övünerek konuştu. Kimi ile ilgili kişisel deneyimim kısa sürdü; çünkü kısa ama kesin gerçek araştırmaları halüsinasyonla bilgiyle sonuçlandı ve Artificial Analysis’ın verileri bu gözlemi destekler görünüyor.
Yine de açık ağırlıklı modeller, hem mutlak dolar tutarıyla AI ajanlarını daha erişilebilir kılmada hem de ileri düzey laboratuvarlardan gelebilecek olası fiyat artışlarıyla yüzleşirken zeka maliyetini düşürecek bir araç olarak potansiyel önemini koruyor.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.