

Son birkaç aydır türlü çılgın LLM kurulumlarını denedim ve performans ile doğruluk arasında doğru dengeyi kurmak her zaman biraz sorun oldu. Deneyimlerimin çoğu eski GPU‘lar, bütçe dostu mini-PC’ler ve hatta Raspberry Pi gibi SBC’ler içeriyor; bu yüzden token üretimi hızlarını düşürmeden artırmanın yollarını arıyorum.
Ekle
XDA

Google’da
Tercih Kaynağı Olarak Ekle
Google Discover’dan Takip Et
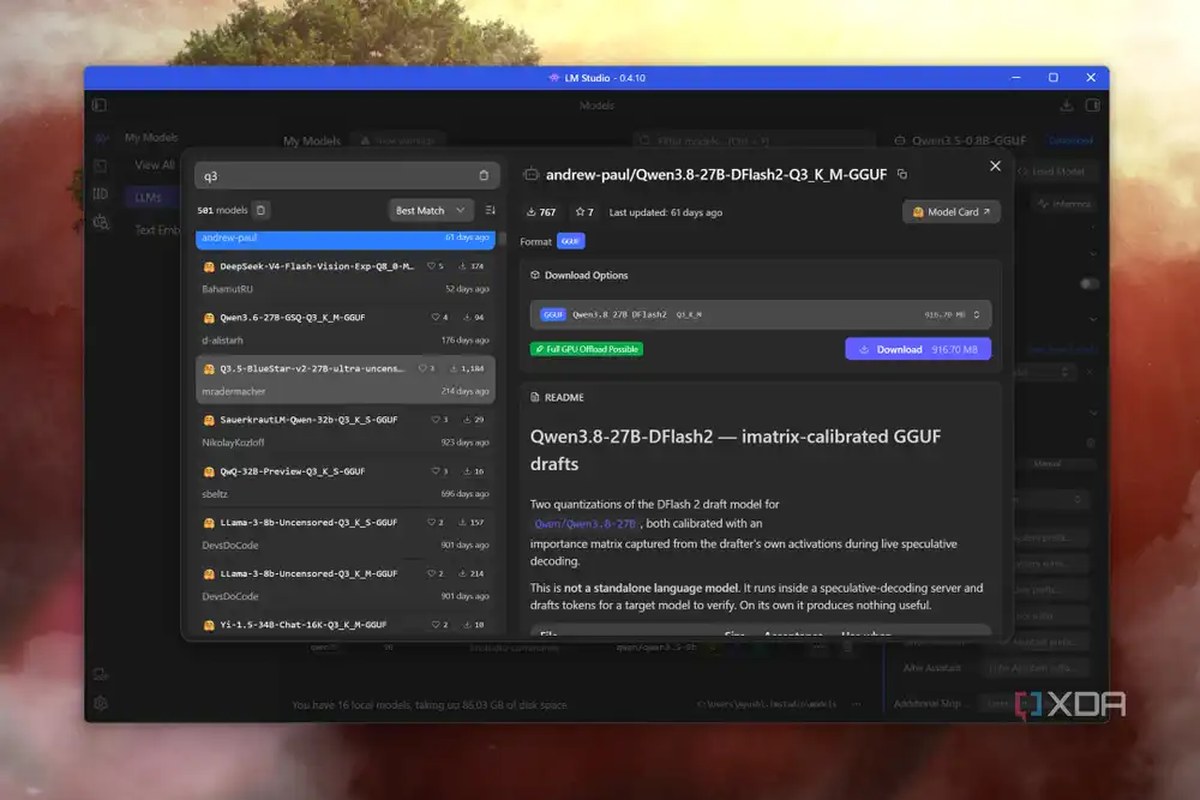
Ne yazık ki tüm bu ince ayarlar işe yaramadı ve bazıları yerel olarak barındırdığım modelleri uyduruk döngülere soktu. Yanlış quantization ve sohbet şablonları bunun için güzel örnekler; çözüm de modelin yeni ve farklı bir sürümünü indirmek ve doğru şablonla donatmaktı.
Yüksek quantization, performans için yeteneklerden ödün verir
Q4 ve Q5 modeller LLM çıkarım görevlerim için ideal nokta
Eğer HuggingFace üzerinden LLM indirdiyseniz, muhtemelen tercih ettiğiniz modelin Q2, Q3, Q4 ve diğer quantize edilmiş varyantlarıyla karşılaşmışınızdır. Buradaki Q, quantization’ı temsil eder; bu da model ağırlıklarını hacimli, yüksek hassasiyetli veri tiplerinden yüksek performanslı ancak düşük doğruluklu karşılıklarına dönüştürür.
Gemma-4-12B’yi örnek alalım. En yüksek hassasiyeti seçmek isteseydim, 26,7 GB VRAM gerektiren quantize edilmemiş BF16 model varyantını seçmem gerekirdi. Bu, silah arşivimdeki en güçlü GPU’daki miktarın iki katından fazlası. Quantization oranını 8-Bit veya Q8’e çıkarmak bu VRAM gereksinimini neredeyse %50 azaltır, ancak yine de bu 14 GB’lık devi RTX 3080 Ti ve 12 GB VRAM’ine yükleyemem. Q4 kartım için ideal sürüm olurdu, ancak bağlam penceresi için ekstra VRAM saklamam gerektiğinden, model için neredeyse sadece 4,2-4,5 GB alan kaplayan topluluk tarafından oluşturulan Q2 varyantlarını seçebilirim.
Saçma görünüşe göre quantization numaralarını Q2’ye (hatta Q3’e) değiştirmek performansı inanılmaz derecede artırabilir ve başlangıç seviyesinde bu LLM varyantlarıyla oynarken aklımdaki şey tam da buydu. Ancak fark etmediğim şey, ekstra performans için ödemem gereken yetenek cezasıydı. Elbette bu son derece quantize edilmiş modeli eski GTX 1080’ime sığdırabilirdim, ancak sık sık sonsuz döngüler üretir, rastgele bir konuya sapar ve hatalı bilgi üretirdi.
Kişisel olarak Q4’ün (ve bazı durumlarda Q5) modellerine sadık kaldım, çünkü yetenekleri ciddi şekilde düşürmeden sağlam performans sunarlar. Yüksek parametreli bir modeli seçip quantization oranlarını Q2’ye çıkarsam bile, doğruluğunu çok fazla zedelerim – öyle bir noktaya ki, daha az parametreli bir Q4 modeli kesin cevaplar verir.
Sohbet şablonları bir LLM’in doğruluğunu da etkileyebilir
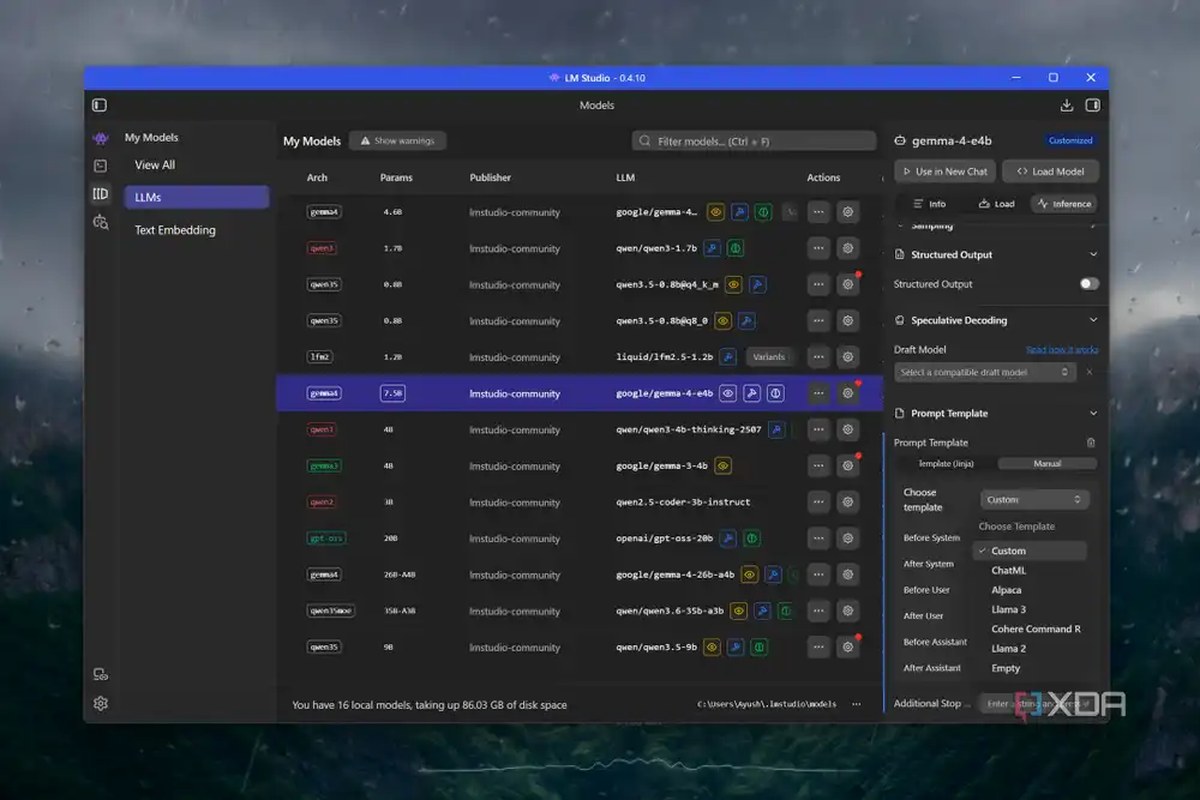
Yanlış sohbet şablonu LLM’i kolayca şaşırtabilir
Sohbet tonunda sorguları bir çıkarım motoruna yazdığınızda, sohbet şablonu onu LLM’in anlayabileceği özel prompt setine dönüştürmekten sorumludur.
Deneyimlerimde yerel LLM’lerimin üretkenlik görevlerime yardımcı olmasını isterim. Bir Qwen3.6 modelinde enable_thinking değişkenini true olarak ayarlamak, LLM’in notlarım, yer imlerim ve belgelerim için etiketleri doğru şekilde üretmesine yardımcı olabilir.
Ancak bunu kodlama görevleri için daha fazla ayarlamak istesem, sistem rolünü değiştirerek LLM’in genel amaçlı bir sohbet modeli olarak çalışması yerine bir geliştirici gibi düşünmesini zorlayabilirim. Elbette, doğru formatı sağlamaktan sorumlu olan bu şablon nedeniyle, yanlış sohbet şablonunu seçmek (hatta daha kötüsü, Gemma 4 ve Qwen3.6 için sohbet şablonlarını karıştırmak) LLM’in doğruluğunu ciddi şekilde düşürebilir.
Modeller konusuna gelince, MoE LLM’lerle en iyi sonucu aldım
Qwen3.6 ve Gemma 4’e sürekli atıfta bulunmamın farkına varmışsınızdır. Q4 LLM’lerle uğraşmanın yanı sıra, çıkarım görevlerimdeki en büyük yükseltme, karışım-uzman (mixture-of-experts) yeteneklerine sahip AI modellerine geçmekti. Yoğun modelleri grafik kartlarıma sığdırmaya çalışmak yerine, hem GPU VRAM’ini hem de sistem belleğini kullanabilen, performans veya muhakeme yeteneklerinde önemli düşüşlere yol açmayan MoE LLM’leri kullanmaya başladım.
Gördüğünüz gibi, MoE modeller, giriş belirtecileri için tüm parametreleri tetiklemek yerine, toplam parametrelerin küçük bir alt kümesini aktive eden bir yönlendirme mekanizması kullanır. Pasif kalan parametrelerin GPU’mun VRAM’inde kalmaya gerek olmadığından, bunları llama.cpp’deki –n-cpu-moe bayrağı ile sistem belleğine aktarabilirim. Bu arada, yönlendirme mekanizması ve aktif ağırlıklar grafik kartımın VRAM’ini kullanabilir ve verimlilik uygulamalarım için çıkarım görevlerini yerine getirebilir.
Buna bir de ölçeklendirme açısından bakarsak, RTX 3080 Ti’m Qwen3.6-35B-A3B (Q4_K_M) modeliyle saniyede 24 tekene yakın hız sağlarken, Pascal nesli GTX 1080’im benzeri Gemma-4-26B-A4B (Q4_K_M) modellerini saniyede 14+ token hızla işleyebilir. Daha yüksek nicemlenmiş modelleri seçmediğim ve sohbet şablonlarını bozmadığım sürece, bu MoE varyantları tüm kodlama ve verimlilik görevlerimi çalıştırmak için fazlasıyla yeterlidir.
Llama.cpp, büyük dil modellerini bilgisayarınızda yerel olarak çalıştıran açık kaynaklı bir çerçevedir.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.