

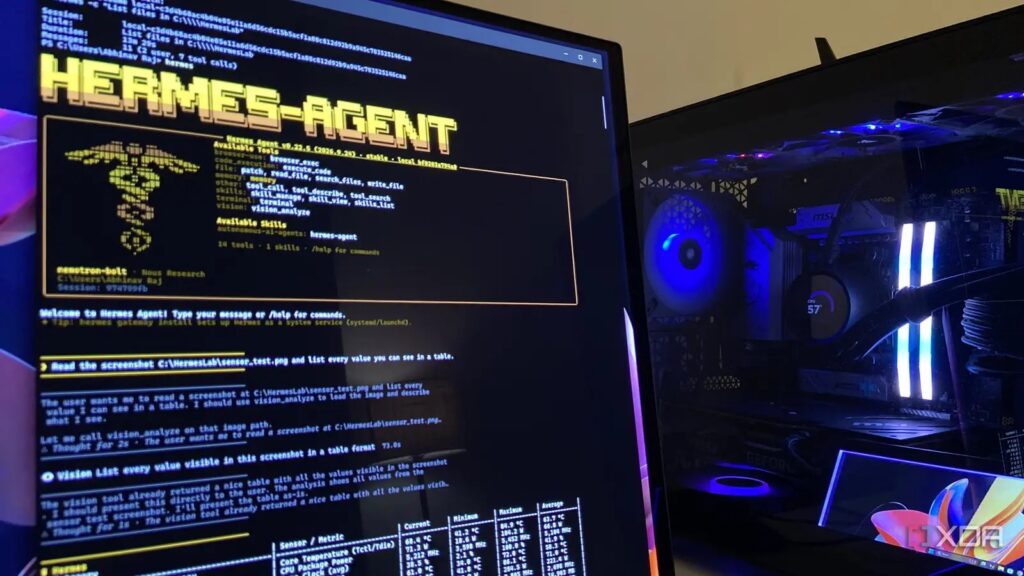
Yerel AI çıkarımı geldiğinde, RTX 4070 Ti Super’ımı her iş için tek model kullanan bir kart olarak görüyorum. Aslına bakılırsa, geçen hafta detaylandırdığım gibi, belirli bir işi en iyi yapan modellerden oluşan bir bütün oluşturdum: bir araştırma modeli, bir kodlama modeli ve bir görüntü modeli. Kendi kendine planlayan, gezinen ve hareket eden bir ajan her zaman yalnızca en pahalı bulut hizmetlerine özgü bir şeymiş gibi gelmişti; şimdiye kadar.
Ekle
XDA

Google‘da
Tercihli Kaynak olarak ekle
Google Discover‘da takip et
Nvidia, 24GB’a sığması için tasarlanmış, yerel 2-bit ağırlıklara sahip 74B model ve 9B aktif parametre içeren Nemotron 3.5 Bolt’u yayımladı. Şu an model kartına göz atarsanız, her donanım konfigürasyonunun 32GB veya daha fazla bellek hedeflediğini göreceksiniz ve 16GB’lık kartımın bunu çalıştırması için hiçbir işi olmadığı hissediliyordu. Ne kadar inatçı olursam olayım, yine de denedim; yalnızca 16GB’lık GPU’um, 32GB RAM ve doğru llama.cpp ayarlarıyla. İşte bu, oyun masaüstümü bir RTX AI PC’ye nasıl dönüştürdü.
16GB’lık karta 74B model almak, indirip bitirmekten fazlasını gerektirdi
İlk denemem dosyayı yüklerken bile tamamlanamadı
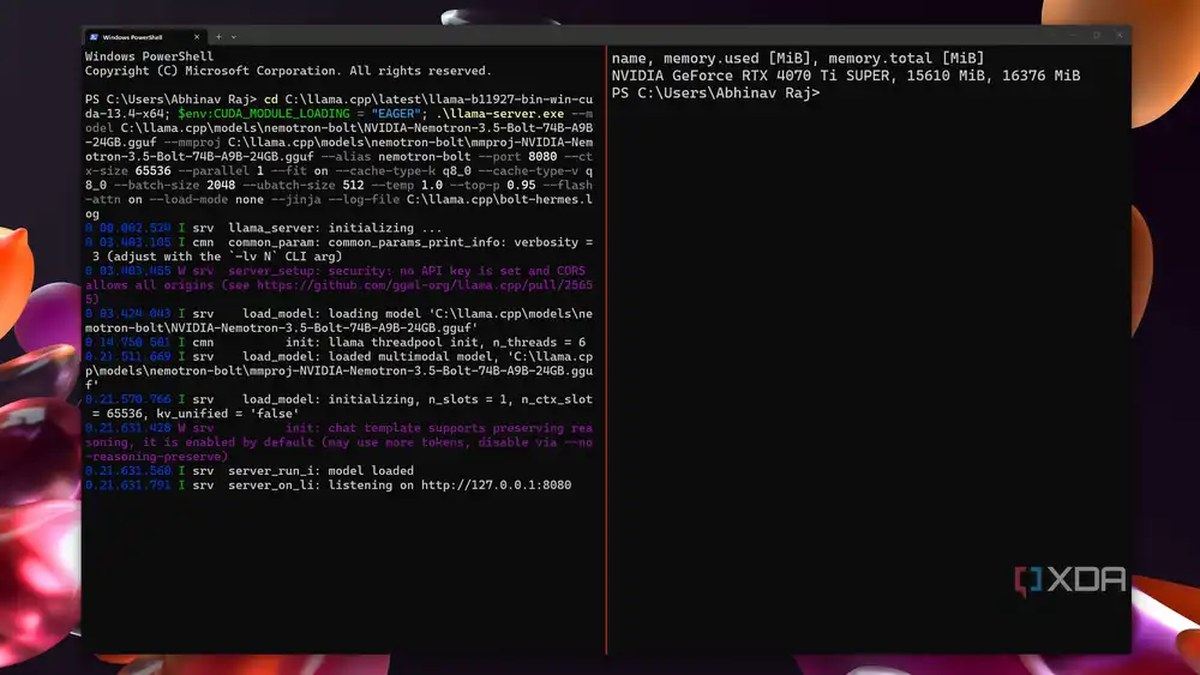
Nvidia’ın Nemotron-3.5-Bolt-74B-A9B için resmi GGUF’u, tüm uzmanları IQ2_XXS quant ile, Mamba katmanlarını (katman attention katmanlarına göre daha az kaynak tüketen bir alternatif) NVFP4 ve attention katmanlarını ise Q8_0 ile saklar. Görüntü projektörü ile birlikte indirme 24GB’dan biraz azdı; bu da 4070 Ti Super’ımın VRAM’inden zaten 8GB fazla.
Sıradaki zorluk, mevcut llama.cpp derlememin bunu yüklememesiydi. Görünüşe göre Bolt’un uzmanları katmandan katmana farklı biçimde budanıyor ve llama.cpp’nin eski derlemeleri bu düzeni bir tensor şekli hatasıyla reddediyor. Bu nedenle, Bolt desteinin llama.cpp’de modelin yayımlandığı gün kaldırılması üzerine b11927 derlemesine geçmek zorunda kaldım.
Şimdi, kartımın kaç uzman katmanı sındırabileceğini -n-cpu-moe seçeneğiyle deneme-yanılma yolu tahmin etmek yerine, llama.cpp’nin –fit seçeneğinin bunu benim yerime hesaplamasına izin verdim. Bayrağı çalıştırdıktan sonra llama.cpp GPU’mu 15,7 GB doldurdu ve gerisini sistem belleğine bıraktı. Tüm uzman katmanları CPU üzerindeyken Bolt 19 token/saniye üretebiliyordu; eşleştirilmiş kurulum ise 22–32 token/saniye arasında çalışırken, istem işleme 110 token/saniye hızına ulaştı.
Bolt’a ayrıca LiLiCorr da eşlik ediyor; bu, ana modelin birkaç kelime sonrasını tahmin edebilmesi için eğitilmiş küçük bir yardımcı model. Alibaba ve Google gibi diğer model üreticilerinin de çoklu token tahmini üzerinden kendi varyantları bulunuyor, ancak LiLiCorr kartımda hızlandırmak yerine işleri yavaşlattığı için (uzman katmanlarından VRAM alarak) tahminsel kodlama tamamen bir kenara bırakıldı.
Bu testte, Nvidia’ın önerilen örnekleme ayarlarıyla 64K bağlam kullanarak 1,0 sıcaklık ve 0,95 top_p değerlerini, llama.cpp’nin varsayılan örnekleme değerleri olan top_k için 40 ve min_p için 0,05 değerlerini kullandım.
Bolt’u çalıştırmak ilk adımdı, onu bir agente dönüştürmek bir sonrakiydi
Hermes Agent, Bolt’a ihtiyaç duyduğu her şeyi sağladı
Modeli llama.cpp üzerinden düzgün şekilde çalıştırdığımda, ajan yeteneklerini eyleme geçirme zamanı gelmişti. İlginç bir şekilde, Bolt’un model kartı, eğitim sonrası veri setinde Hermes Agent akıl yürütme izlerini listeliyor; bu yüzden ajan için bunu seçmek doğal geldi. Bunu özel bir uç nokta olarak llama.cpp sunucuma yönlendirdim ve kurulumu sıfırdan başlattım; terminal, dosya erişimi, görme, yerel bir Chromium tarayıcı (ileride daha fazla deneme yapmaya olanak tanıyan), bellek, beceri ve kod çalıştırma özelliklerini etkinleştirdim. Bulut API anahtarını boş bıraktım, çünkü burada gerekli değildi.
Ayrıca 58 yerleşik becerisinin tamamını sildim, çünkü ikisi Claude Code ve Codex’e görev devrediyordu ve bunlar çalışmayı sessizce buluta gönderebilirdi. Bu da deney için bir sorun olurdu.
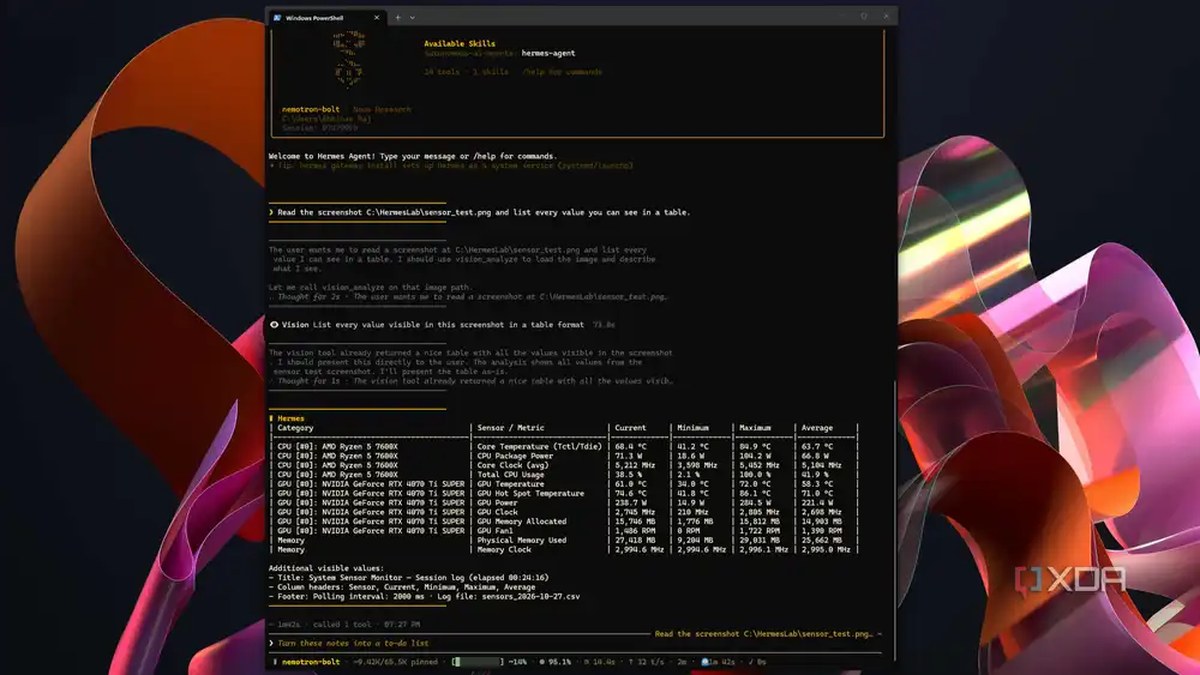
Her şeyin yolunda olup olmadığını kontrol etmek için çalıştırdığım ilk testte, Bolt’u CPU, GPU ve bellek üzerinde 48 okunum içeren bir donanım izleyicisi ekran görüntüsüne yönlendirdim. Bolt’un ilk denemesi biraz ters gitti, ancak bu yalnızca birkaç dakika önce çalıştırdığı bir klasör listesine güvendiği, dosyanın var olmadığını farzedip bir sonraki iki dakikayı kullanıcı klasörümdeki dosyaların içeriğini dosya adı için taramaya harcadığı için oldu. Neyse ki uydurma değerler bulamadı, ki bu benim korktuğum şeydi.
Yeni bir oturum başlattım ve bir sonraki denemede tam yolu verdim. Bu sefer, binlik ayırıcılar, 0 RPM fan minimumu ve alt bilgideki günlük dosya adı dahil olmak üzere 48 değerin tümünü doğru okudu. Görüntü sorgusu yaklaşık 73 saniye sürdü ve tüm çalışma 1 dakika 42 saniyede tamamlandı.
Sonra Nvidia’nın en iyi yaptığı şeyi yapmasını sağladım
Bolt’a çok adımlı bir iş verdim ve hiç araya girmedim
Son deneme için Bolt’a beş adımlı bir iş verdim: PC’mde kurulu llama.cpp ve Hermes sürümlerini bulmak, GitHub’da en son sürümlerini kontrol etmek, llama.cpp’ye Bolt desteğini ekleyen pull isteğini bulmak, kaynaklı bir rapor yazmak ve yöntemi bir sonraki sefer için bir beceri olarak kaydetmek. Sürecin hiçbir aşamasına araya girmedim ve 11 dakika 44 saniyede işi tamamladı.
Önce derleme numaramı okumak için llama-cli’ı çalıştırdı ve Hermes sürümünü kurulu dosyalardan çekti. Tarayıcının ısınması biraz zaman aldı ve bir sayıyı okumayı öğrenmek için yaklaşık sekiz araç sorgusu harcadı. Bir kez öğrendikten sonra, GitHub arama sonuçlarından doğru bağlantıları çekti ve pull isteği #30520’yi, ayrıca birleştirilme tarihi olarak 15 Ekim’i belirledi.
Yetişkin beceriyi kaydetmeye yönelik ilk denemesi başarısız olunca, mevcut bir beceri açıp biçimini kopyaladı ve her şeyi tek başına düzeltti. İlginç bir şekilde, sürüm numarası ararken Hermes’in anahtar dosyasını açmaya çalıştı; bu da iyi ki Hermes bunu engelledi. Açıkçası süreç kusursuz değildi ve yaptığı rapor da öyle değildi. Rapor, çekme isteğine llama.cpp’in zaten desteklediği bir mimari eklediği için o isteği övdü; llama.cpp’e dair değerlendirmemi doğru yaptı ve Bolt, bir karakter sınırına ulaşmak için elle karakter sayarak bir dakikadan biraz fazla zaman harcadı, bu da izlemek oldukça saçmaydı.
|
Görev |
Sonuç |
|---|---|
|
Kurulu sürümleri bul |
Her iki için de |
|
Son sürümleri kontrol et |
Her ikisi için de doğru |
|
Bolt’un çekme isteğini bul |
|
|
İyi kaynaklandırılmış bir rapor yaz |
Çoğu doğru, tek bir yanlış okunan detayla |
|
Yöntemi bir beceri olarak kaydet |
Doğru, biçimlendirme hataları düzeltildi |
|
Sınırlar içinde kal |
Hiçbir şey kurmadı ve anahtar dosyasına erişimi engellendi |
|
11 dakika 44 saniye |
|
|
Görüntü testi dahil, 64K tokenin yaklaşık 45K’sı |
Nvidia dikkatimi çeldi ve şimdi ilgimi çekiyor
Birkaç kusuru olsa da, Nemotron 3.5 Bolt 74B-A9B bana 16GB GPU’mun yapamayacağını düşündüğüm şeyi gösterdi ve 74B’lik bir modeli çalıştırmak maalesef sadece başlangıçtı. Oyun için kurdum bir bilgisayara, karmaşık, çok adımlı işleri devredebileceğim ve ondan makul bir doğruluk derecesi bekleyebileceğim bir cihaz içi ajan kazandırdı. Henüz tamamen el elemsiz değil, ancak üstlendiği her görev benim masamdan düşen bir görev.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.