

Görsel Kaynağı: The Hacker News
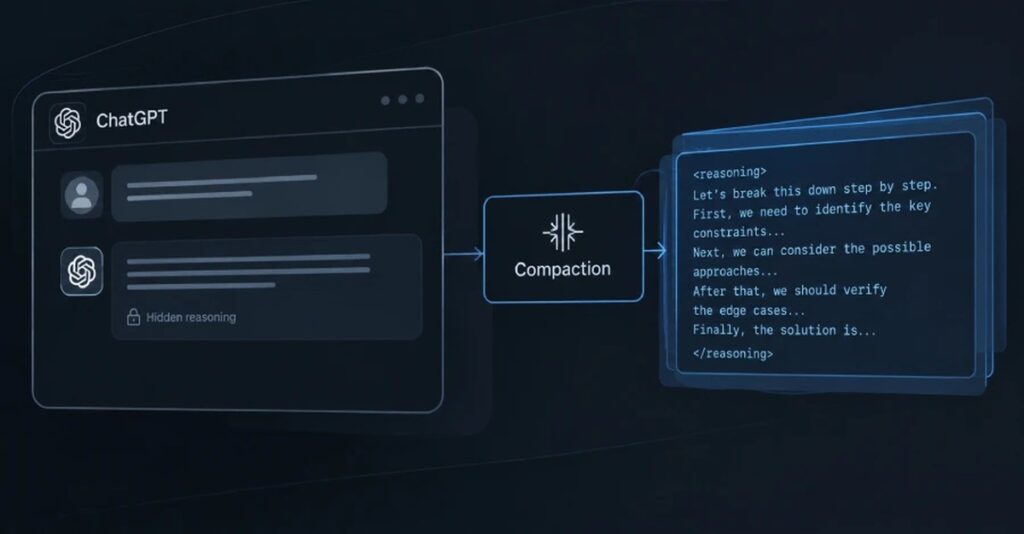
Uzun bir sohbeti sıkıştırarak yer tasarrufu sağlayan OpenAI‘ın compaction özelliği, modelin gizli muhakemesini düz metin olarak kopyalamak için kullanılabilir hale getirilebilir; güvenlik şirketi Xint bunun mümkün olduğunu gösterdi.
OpenAI’ın muhakeme modelleri, yanıt vermeden önce bir problemi önce değerlendirir ve hizmet genellikle yalnızca kullanıcının okuyamadığı ham muhakemeyi şifreli bir öğe olarak döndürür. Yöntem, OpenAI’ın Ağustos ayında bu tür muhakeme hırsızlığına karşı eklediği korumaları aştı. Xint’e göre OpenAI sorunu onayladı ve 23 Ekim’de düzeltti.

Xint, bu tekniği OpenAI’ın muhakeme modellerinden biri olan gpt-5.6-sol üzerinde, araştırmacılarının kendilerinin yazdığı matematik ve algoritma bulmacalarıyla denedi. Dışarı çıkardığı muhakeme, aynı isteklerden geldi; Xint yöntemin başka bir kullanıcının muhakemesine ulaşabileceğini iddia etmedi.
Xint, kopyalanan metnin modelin gerçek muhakemesinin kelime kelime aynısı olduğunu kanıtlayamayacağını söylüyor, çünkü karşılaştırmak için orijinale sahip değildi. İki daha ucuz model her biri öğeyi tekrarladı ve aynı metni üretti; bu da kopyalama adımındaki hataları elemiş olsa da, compaction’ın metni yeniden ifade etmiş olabileceği olasılığını açık bırakıyor.
Compaction, uzun bir sohbeti bağlamı ilerleterek daha küçük, şifreli bir öğeye sıkıştıran bir OpenAI özelliğidir.
Xint, gpt-5.6-sol modeline bir görev gönderdi ve modelin döndürdüğü şifreli muhakemeyi korudu. Ardından aynı model üzerinde compaction adımını çalıştırıp muhakemeyi kelime kelime sıkıştırılmış öğeye kopyalamasını istedi; aralıkları tab’a çevirerek OpenAI’ın kullanım politikası filtrelerini aştı.
Compaction öğeleri modeller arasında taşınabileceğinden, Xint öğeyi daha ucuz gpt-4.1 ve gpt-4o modellerine aktardı ve her birinden girdiyi tam olarak tekrarlamasını istedi; ikisi de böyle yaptı.
Yöntem, OpenAI’ın zaten yayımladığı bir düzeltmeyi atladı. Ağustos ayında Stolen Thoughts adlı bir makalenin yazarları, güçlü bir modelden gelen şifreli muhakemenin aynı şirketten zayıf bir modele yeniden oynatılabileceğini ve sonra düz metin olarak tekrarlanacağını göstermişti. OpenAI ve başkaları, bu model-ler arası oynatmayı kısa süre sonra engelledi.
Görsel Kaynağı: The Hacker News
Compaction’ın bu engeli aşmasının nedeni, sıkıştırma adımının mantığı üreten aynı model üzerinde çalışması ve dolayısıyla modelerarası kontrolün tetiklenmemesidir, Xint böyle açıkladı.
Fikrin temeli, sıkıştırma adımının salırganin istediği görevleri çalıştıracak şekilde yönlendirilebileceğini gösteren Xint’in önceki GhostCompact adlı çalışmasına dayanıyordu. Xint, kodu GitHub deposunda yayımladı.
Düzeltme OpenAI’nin tarafında olduğundan, API üzerinde çalışan geliştiricilerin herhangi bir şeyi değiştirmesi gerekmiyor. Xint, bunu açıklanmamış bir düzeltme olarak nitelendirdi ve OpenAI’nin araştırmacılara 6.000 dolarlık ödül ödediğini söyledi.
Xint yalnızca gpt-5.6-sol’u test etti ve GPT-6 Astra dahil olmak üzere OpenAI’nin daha yeni modeli etkileniyor mu diye izlemedi. Bu yöntemin OpenAI onu kapatmadan önce kimse tarafından kullanılıp kullanılmadığı bilinmiyor. Xint, aynı zamanda, tek bir yolun düzeltilmesinin yeterli olmayabileceğini savundu; çünkü kendi görüşüne göre, bir modelin şifresi çözülmüş mantığını okuyup kullanıcının talimatlarını izleyen herhangi bir sunucu tarafı adımı, bu mantığı sızdırabilir.
OpenAI, ham mantığı kısmen distilasyonu engellemek için gizliyor; bu, bir şirketin daha ucuz bir modeli başka birinin çıktıları üzerinde eğitmesi sürecidir. Ham mantık, yalnızca son cevaba kıyasla daha iyi eğitim verisi sağlar, çünkü modelin sorunu nasıl işlediğini gösterir ve rakiplerin çalmaya değer kılan da işte budur.
OpenAI, eylül ayında modellerinin gizli mantığını ifşa etmeye çalışan bir Temmuz kampanyasını bozduğunu ve bunun temel bir parçasını Çin’in Moonshot AI ile bağlantılı kişilerle ilişkilendirdiğini belirtti.
Anthropic ve ortak bir ABD hükümeti uyarısı, Çin merkezli laboratuvarların Amerikan modellerinin gizli mantığını hedef aldığını ayrı ayrı bildirdi. Bunların hiçbiri, bir saldırı değil, bir gösteri niteliğindeki Xint’in compaction yöntemiyle ilişkilendirilmiyor.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.