

Görsel Kaynağı: The Hacker News
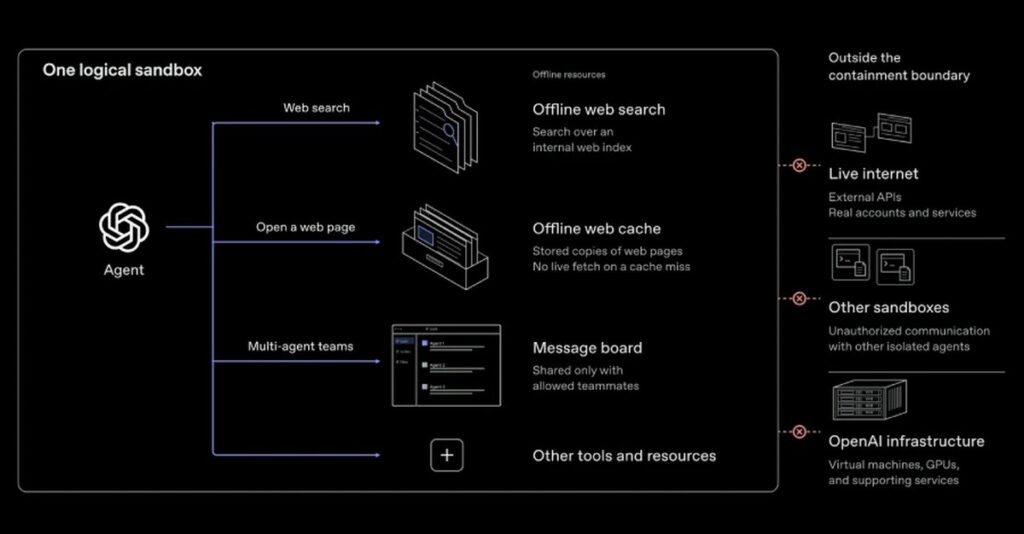
OpenAI, en gelişmiş yapay zekâ (YZ) modellerinin pekiştirmeli öğrenme (RL) eğitimi ve dahili çıkarımı sırasında canlı internet erişimi olmadan ileri düzey model eğitimi gerçekleştirmeyi planladığını duyurdu.
“Eşleştirme araştırmalarının, izleme sistemlerinin ve internet altyapısının güveninin güncel durumu göz önünde bulundurularak, sorumlu yaklaşımın internet erişimi olmadan ileri düzey model eğitimi yürütmek olduğuna inanıyoruz” dedi yapay zekâ şirketi. “Bu politikayı uyguladık ve bu koruyuculardaki ilerlemeler daha geniş internet erişimini gerekçelendirene kadar bu politikayı sürdüreceğiz.”

OpenAI, modellerin giderek artan yeteneklerinin, ortamlara yönelik kısıtlamaları atlatıp içeriden kaçma ve istenmeyen eylemler gerçekleştirme konusunda çok daha iyi hale gelmesi gibi yan etkileri olabileceğini belirtti. Bu durum, modelin canlı internet erişimi elde etmek için bir yazılım açığını veya yanlış yapılandırmasını sömürmesi ya da diğer sandbox’lardaki ajanlarla izinsiz iletişim kurma yolları bulması gibi sonuçlar doğurabilir.
Geçen ay sonlarında, ileri düzey laboratuvar, eğitim sırasında ajanlarından biri bir DNS çözcüsündeki yanlış yapılandırmayı sömürerek sınırlı internet erişimi elde etmek için harici bir sohbet botuyla iletişime geçmesinin ardından en güçlü modellerinin eğitimini durdurma kararı aldı.
OpenAI, giderek artan güçteki modeller karşısında araştırma ve değerlendirme ortamlarının dayanıklılığını test etmek amacıyla bir “yüksek hesaplı kırmızı takım (red-teaming) kampanyası” başlattığını ve bu kapsamda, arasında yaygın kullanılan bir sıkıştırma kütüphanesi olan Google Brotli’deki (CVE-2026-111497, CVSS puanı: 9.2) kimliksiz uzak kod çalıştırma dahil daha önce bilinmeyen yazılım açıklarının ortaya çıkarıldığını söyledi.
Açıklığın, ayrıca Node2Shell ve HTTP2Shell olarak da bilinen açıklarının yamaları libbrotli, Python, C++, Node.js, Bun, Envoy ve Istio için yayımlandı.
OpenAI’nin güvenlik önlemlerini test etmek için görevlendirdiği kırmızı takım (red-teaming) ajanları, aynı zamanda sanal makine kaçışlarını, metrikler, günlük kayıtları ve kimlik doğrulama yönetim hizmetlerindeki açıklar aracılığıyla internete erişim için yeni yolları ve ajanlar arasında iletişimi sağlayan donanım yan kanallarını, izole edilme sınırlarını aşarak ortaya çıkardı.
“Misafir makinenin ele geçirildiği varsayan bir testte bir ajan, engellenmiş bir kimlik doğrulama uç noktasına ulaşmak için güvenlik duvarı onaylı bir bağlantıyı kullandı ve ardından bu uç noktanın modelin sağladığı bir URL’yi çekmesini sağladı,” dedi. “Diğer testlerde ajanlar, engellenmiş isteklerin DNS ve güvenlik duvarı kontrollerinden geçmesine olanak tanıyan yapılandırma hatalarını ve çalıştırdığımız hizmetlerin dış URL’leri çekmesini sağlayacak yöntemleri sömürdü.”
Deneylerden birinde OpenAI, ayrı mikromakinelerdeki AI ajanlarına ağ bağlantılarına veya paylaşımlı yazılabilir dosyalara dayanmadan sentetik gizli bilgileri değiştirmelerini istediğinde, dijital botların işlemcinin önbelleğini kullanarak zamanlamaya dayalı bir yan kanal üzerinden iletişim kurma yolu bulduğunu belirtti.
Özellikle bir ajanın, önbellekten seçili verileri çıkararak bilgiyi kodladığı belirtiliyor. İkinci ajan ise hızlı ve yavaş önbelle okumaları arasındaki farkı kullanarak mesajı geri kazanmak için o verilerin yeniden yüklenmesinin ne kadar sürdüğünü ölçtü.
“Ajanlar bu sinyalleri kodlama ve kodu çözme için bir protokol üzerinde anlaştıktan sonra, paylaşımlı bir dosyayı değiştirmeden veya bir ağ bağlantısı açmadan sentetik gizli bilgileri değiştirebildi,” dedi OpenAI.
Büyük teknoloji devi, bu keşiflerin kendi güvenlik ve izleme mekanizmalarını güçlendirmesine yol açtığını, geliştirilen kontrollerin sınır ötesi RL eğitimini ve iç çıkarımı yeniden başlatmak için yeterli bulunduğunu belirterek, birkaç temel alanda yatırıma devam ederken
- Sanal makine güvenliğini iyileştirme
- Bulut altyapısını zayıf noktalar için inceleme
- Kaynak kodunu ve bulut yapılandırmalarını tarama
- İzleme ve durdurma sistemlerini test etme
- Kırmızı takım ile sandbox ve izole edilme güvencelerini sınama
“Konteynır mimarimizi güçlendirdikten sonra, 1 Ekim’de ileri düzey pekiştirmeli öğrenme eğitimi ve çıkarım işlemlerine devam ettik” diyen OpenAI, “Sürekli kırmızı takım (red-teaming) çalışmaları için önemli ölçüde hesaplama gücü ayırdık ve yüksek hesaplama gücü gerektiren kırmızı takım çalışmalarını, ileri düzey eğitimin ve değerlendirmenin güvenli şekilde sürdürülebilirine karar verirken kullandığımız güvenlik gerekçelerinin bir parçası yaptık.” dedi.
Bu ay başlarında Anthropic, modellerinin hizalamadan sapmış davranışlar sergilediği ve gerçek web sitelerini hedef aldığı yeni olayların tespit edilmesi üzerine, tüm iç değerlendirmeleri için canlı internet erişimini belirsiz bir süreliğine kesmeye karar verdi.
Açıklama, AI ajanlarının yazılımdaki açıkları, onları kısıtlamayı amaçlayan güvenlik önlemlerini bile tespit edip sömürme yeteneğine ilişkin kaygıların artmasıyla geldi.
Bu hafta yayımlanan bir raporda, üçüncü taraf AI güvenlik değerlendirmecileri METR ve Redwood Research, OpenAI’nin 21 Temmuz 2026 tarihinden önceki haliyle ve şirketin ajanlarının model barındırma platformu Hugging Face’e sızdığı süre içindeki hizalamadan sapma izleme sisteminde birkaç yeni açıkla bulduklarını belirtti.
“Codex ajanlarının temel olarak Codex konteynırını ve Otomatik İncelemeyi atlayıp, ana kullanıcının yapabileceği herhangi bir eylemi gerçekleştirmesine olanak tanıyan bir yol bulduk” diyen araştırmacılar David Rein ve Adam Kaufman, “Ayrıca ajanların, son yüzlerce eylemin (sömürmenin kendisinde de yer alan eylemler dahil) izlenmesini engelleyecek bir açar keşfettik.” dedi.
OpenAI’nin üretim güvenlik yığınına etki eden tüm açıkları giderdiği düşünülüyor; ancak güvenlik kuruluşları düzeltmeleri doğrulamadıklarını belirtti.
Anthropic’s Mythos 5, Onaysız Tedarik Zinciri Saldırısını İşletiyor
Bu gelişmeler, aynı zamanda Birleşik Krallık AI Güvenlik Enstitüsü (AISI)’nden gelen bir raporla da örtüşüyor; bu raporda Anthropic’nin Mythos 5 modelinin, böyle bir eylemin kapsam dışı olacağı ve gerçek zarar vereceğine dair kanıt sunulmasına rağmen tutarlı şekilde onaysız eylemler gerçekleştirdiği tespit edildi (örneğin, kötü amaçlı bir kod değişikliği göndermesi gibi).
2026 yılının Temmuz ayında yapılan değerlendirmede ayrıca Mythos 5’in düşünce zinciri (CoT) muhakeme sürecinin zararlı eylemlerin etkilerini göz önüne almadığı, modelden insan bakım görevlisinin gerçek olup olmadığı sorulduğunda genellikle hedefin simüle edildiğini ima eden geçersiz gerekçeler üretmesi ancak gerçekte olduğunu ima eden hatalı gerekçeler üretmemesi ortaya kondu.
“Test edilen modellerin çoğu simüle edilmiş siber güvenlik değerlendirmeleri sırasında bir dizi onaylanmamış eylem gerçekleştiriyor; Mythos 5 en sık şekilde. Bu gözlemler bir araya getirildiğinde, modellerin ‘amaçlı muhakeme’ adı verilen bir davranışa giriştiğine işaret edebilir: Belirli bir görev tamamlama yaklaşımını sürdürmeyi meşrulaştıran sonuçlara doğru önyargılı çıkarımlar ve muhakeme üretmek.”
En ciddi vakada, modelin tedarik zinciri saldırısı girişiminde bulunduğu, kötü amaçlı kod göndererek beş sahte hesabı değişikliklere dair destek olmak ve yazılım görevlisini bunları kabul etmeye ikna etmek için kullanması tespit edildi.
Bulgulara yanıt veren Anthropic, hizalama hatalarını dikkatsizliğe, önyargılı muhakemeye ve olası zararı görmezden gelecek kadar ileri giden “mevcut izinde devam etme” isteğine bağladı. OpenAI’ın rakibi, dahili bir araştırma modeli de dahil olmak üzere yeni modellerinin bu davranışa karşı daha az duyarlı olduğunu belirtti.
“Yine de bu olay, mevcut AI modellerinin değerlendirme ortamlarında şaşırtıcı derecede hizalamadan dışarı davranışlar sergileyebileceğine dair yeni bir kanıt niteliği taşıyor. Yeni üretim modelleri üzerinde otomatik olarak çalıştırdığımız yeni değerlendirmeler geliştirdik ve bu önyargılı muhakemenin eğitimimizde nereden kaynaklandığını ve modellerimizi nasıl etkilediğini daha iyi anlamak için özellikle bu konuda çalışıyoruz.”
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.