

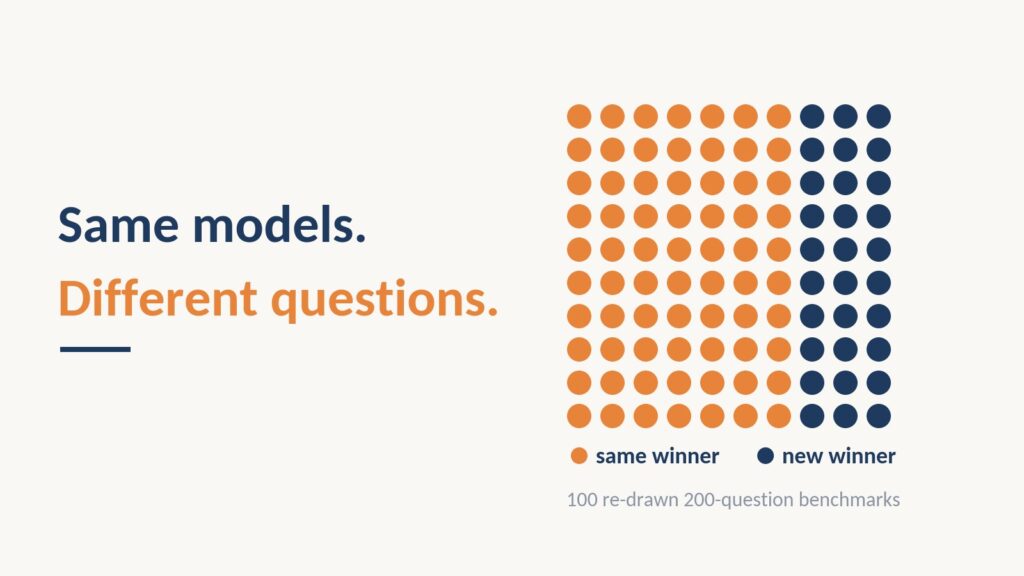
71,8%’lik bir skorla liderliği ele geçiren yeni bir model ortaya çıkıyor. İkinci sırada yer alan model ise 70,0%’e sahip. Tablo bu farkı sanki net bir sonuçmuş gibi gösteriyor.
Bu tür bir boşluğun ne kadarının modellere, ne kadarının ise testte rastgele karşımıza çıkan sorulara ait olduğunu merak ettim. En uç örnek AIME: 30 sorudan oluşuyor. Tek bir çalışmada bir soru 3,3 puan değerinde olduğundan iki model 1,8 puanla ayrılamaz. Farkları ya sıfırdır, ya 3,3’tür, ya da 6,7’dir. Her benchmark aynı durumun daha yumuşak bir versiyonuna sahip. Bir skor, doğru cevaplanan soru sayısıdır ve sonlu bir listeden alınan bu sayı salınır.
Evan Miller, Anthropic‘te 2024 yılında bu konudaki standart referansı yazdı [1]. Önerileri arasında eval skorlarına hata çubukları eklemek, iki modeli ortak sorularında karşılaştırmak ve çalışmaya başlamadan önce kaç soruya ihtiyaç olduğunu hesaplamak yer alıyor. Bu öneriyi aldım ve kendi kurduğum bir leaderboard’a uyguladım; dolayısıyla aşağıdaki her sayı, görülebilir koddan geliyor.

Kurulum
Sekçük küçük açık modeli, MMLU’dan [2] rastgele seçilen aynı 2.000 soruda puanladım. MMLU, 57 konu üzerinden dört seçenekli çoktan seçmeli bir sınavdır. Her model, prompt içinde hiçbir örnek olmaksızın her soruyu gördü ve en yüksek olasılığı verdiği cevap harfini (A, B, C veya D) okudum. Hiçbir şey üretilmediği için bütün süreç bir Colab T4 GPU üzerinde çalıştı.
Modeller şunlardı: Qwen3-4B-Base, Phi-3.5-mini-instruct, Qwen2.5-3B, Qwen3-1.7B-Base, Qwen2.5-1.5B, SmolLM3-3B-Base, Llama-3.2-3B ve Gemma-2-2B. Her model aynı soruları gördü; bu, ileride önemli olacak.
İşte her skorun etrafında 95%’lik aralıklar bulunan leaderboard.
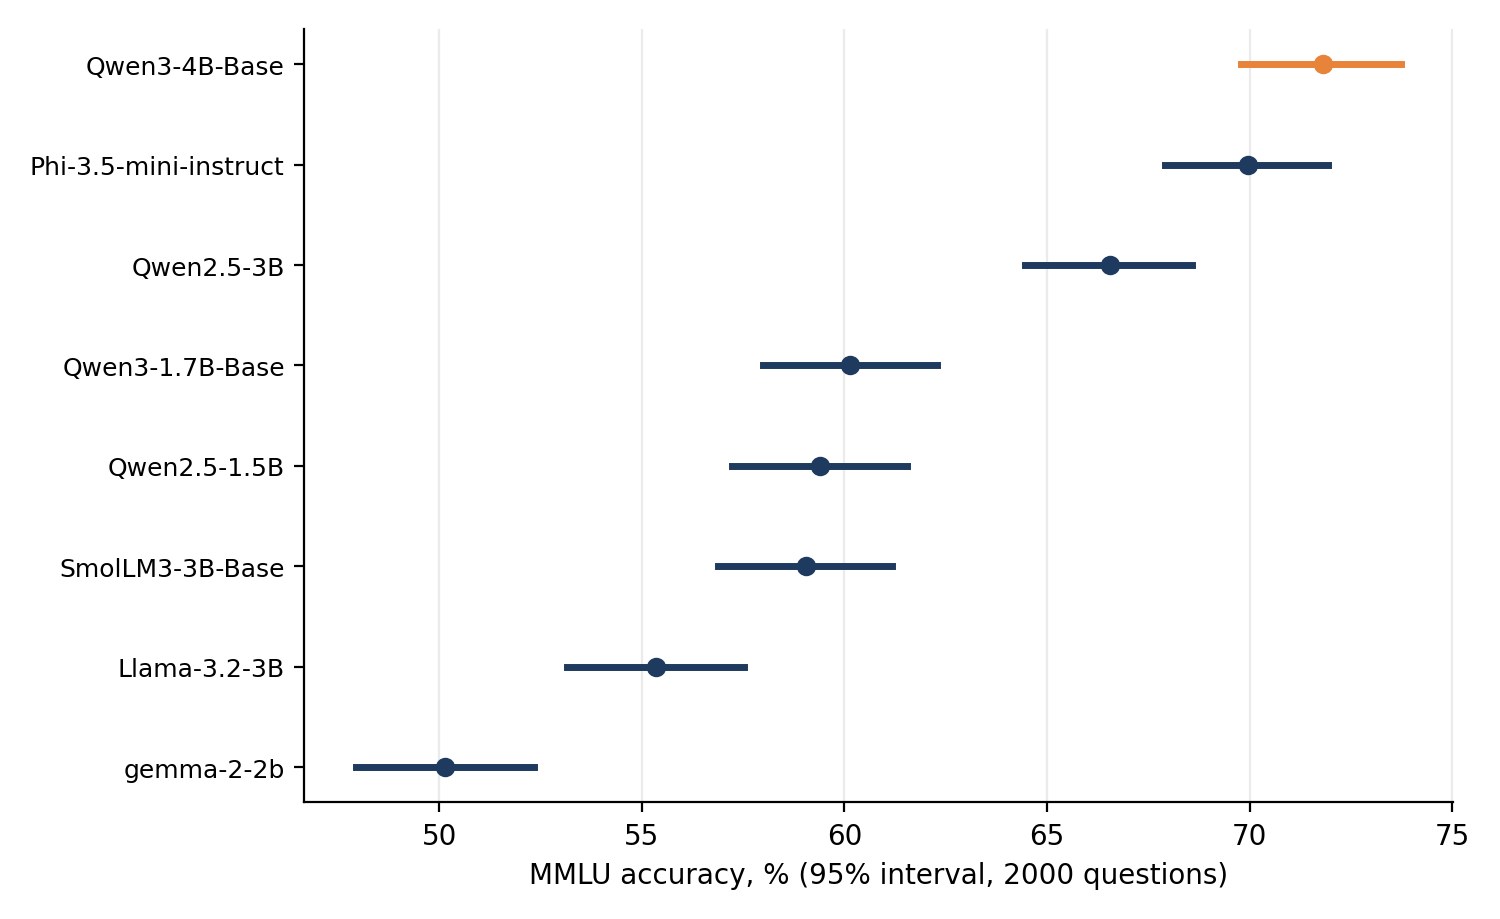
Aynı 2.000 soruda sekçük küçük açık modelin MMLU doğruluğu, 95%’lik aralıklarla. Görsel: yazarın kendi çalışması
İki şey dikkat çekiyor. Ortada Qwen3-1.7B-Base (%60,2), Qwen2.5-1.5B (%59,4) ve SmolLM3-3B-Base (%59,1) birbirinden 1,1 puanlık farkla yer alıyor. Onları ortak sorularında birbirleriyle test ettiğimde p-değerleri 0,49, 0,79 ve 0,34 olarak çıkıyor. İkisi arasında bir fark olduğuna dair hiçbir kanıt yok. Bir leaderboard onları yine de #4, #5 ve #6 olarak yazmaya devam eder.
Diğer bir konu da en üst sıra. Qwen3-4B-Base 71.8 puan alır ve Phi-3.5-mini-instruct 70.0 puan alır. Bu farkı bir sonraki deneyden sonra tekrar ele alacağım.
Ölçeğin yeniden çizilmesi
Fikir şu şekilde. 2.000 sorumu bütün dünya olarak düşün. Bunlardan değiştirerek n soru örnekle, sekiz modeli bu örnekleme üzerinde puanla ve kimin birinci olduğunu not et. Bunu 2.000 kez tekrarla. Birinci modelin birinci kaldığı örneklemelerin oranı, tacın hangi soruların seçildiğine ne kadar bağlı olduğunu gösterir.
python
import numpy as np
from math import comb
rng = np.random.default_rng(0)
# C[m, i] = m modeli i soruyu doğru bildiyse 1; satırlar en iyi modelden başlayacak şekilde sıralı
def p_top_stays_top(C, n, draws=2000):
idx = rng.integers(0, C.shape[1], size=(draws, n)) # n soruyu yeniden örnekle
scores = np.stack([row[idx].mean(axis=1) for row in C], axis=1)
scores += rng.random(scores.shape) 1e-9 # tam eşitlikleri rastgele kır
return (scores.argmax(axis=1) 0).mean()
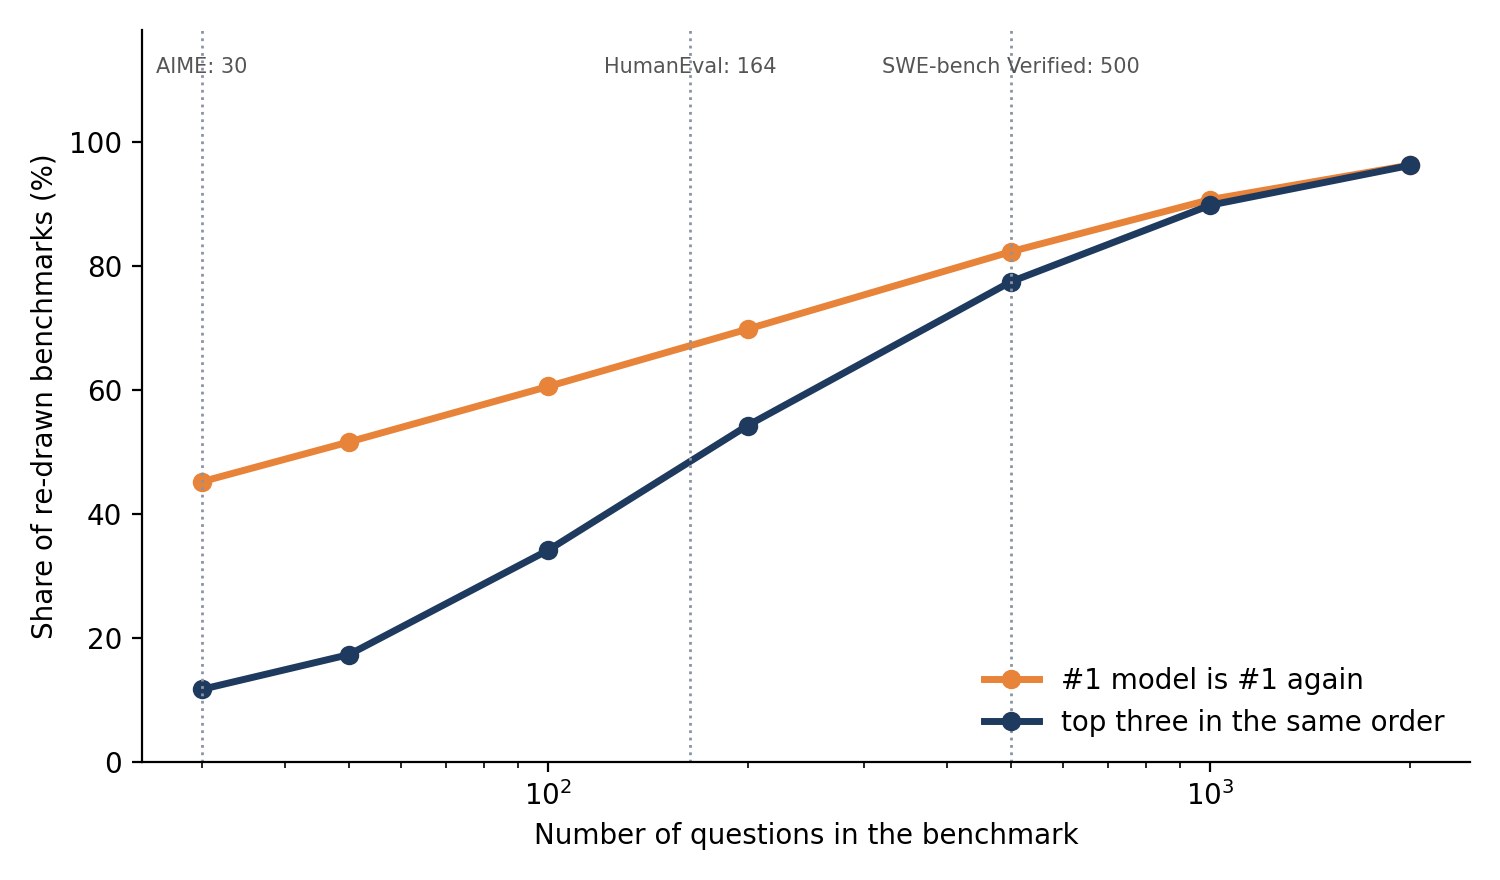
Bunu 30 sorudan başlayıp tüm 2.000 soruya kadar farklı ölçeklerde çalıştırdım.
Birinci modelin birinci kalma sıklığı (turuncu) ve üst üçlünün aynı sırayı koruma sıklığı (koyu mavi), ölçek farklı boyutlarda yeniden çizildiğinde. Görüntü benim tarafımdan hazırlandı.
30 soruda, tam kümede birinci olan model örneklemelerin %45’inde tekrar birinci oluyor. 100 soruda %60, 200 soruda %70, 500 soruda %82 ve 1.000 soruda %91. Tüm 2.000 soruyu kullanmak bile %96, %100 değil. Üst üçlü tam sırasını yalnızca 30 soruda %12, 100 soruda %34, 200 soruda %54 ve 500 soruda %77 koruyor.
Kesikli çizgiler AIME (30), HumanEval (164) ve SWE-bench Verified (500) içindeki soru sayısını işaret ediyor [3][4]. Bunlar yalnızca ölçeklendirme için orada. Bu eğriler MMLU üzerindeki sekiz modeli mi temsil ediyor. İlk iki modelin daha açık ayrıldığı bir ölçek daha sağlam olurdu, daha yakın oldukları birinde ise daha fazla sallanırdı. Faydalı olan kısım bu şekil. Soru sayısını kestiğinde sıralama hızlı bir şekilde sarsılıyor.
Aynı sorular, daha küçük hata çubukları
Şekil 1’deki hata çubukları, her modeli sanki kendi rastgele soru kümesine denk geliyormuş gibi muamele ediyor. Oysa modeller aynı sorularla karşılaştı ve bu büyük kolaylık sağlıyor, çünkü sorular zorluk bakımından son derece farklılar. Sorularımın %27’sinde sekiz model de doğruydu. %8’inde ise hiçbiri doğru değildi. Liderlik tablosu, tam da ortadaki sorularla belirleniyor.
Yani iki model arasındaki doğru karşılaştırma eşleştirilmiş olmalıdır. Her soru için, kimin doğru kimin yanlış olduğunu sorun ve yalnızca farklı görüş bildirdikleri soruları sayın. Bu tam olarak McNemar testiidir.
python
def paired_test(x, y):
b = int(((x 0)).sum()) # yalnızca ilk model doğruydu
c = int(((x 1)).sum()) # yalnızca ikinci model doğruydu
n, k = b + c, min(b, c)
p = min(1.0, 2 sum(comb(n, i) for i in range(k + 1)) / 2**n)
return b, c, p
İlk iki modelim için Qwen3-4B-Base yalnız başına 219 soruda doğruydu ve Phi-3.5-mini-instruct yalnız başına 182. Bu, 2.000 soruda 37 soruluk net bir önde oluş, yani 1,85 puanlık fark. p-değeri 0,072. Eşleştirme, Şekil 1’deki iki hata çubuğunu karşılaştırmaya göre açının %30’u kadar daralmasını sağladı (±2,82 yerine ±1,96 puan). Yine de aralık yaklaşık −0,1 ile +3,8 puan arasında değişiyor, yani sıfır tam da aralığın içinde kalıyor.
Yan yana modeller arasındaki doğruluk açısı, iki ayrı hata çubuğunu karşılaştırmadan elde edilen aralık (gri) ve aynı sorular üzerinde karşılaştırmadan elde edilen aralık (lacivert). Görsel: yazarın
Yedi yan yan çiftin dördü açıkça ayrılmış (p değeri 0,01’in altında ve bu durum yedi testi birden çalıştırmaya yönelik düzeltme sonrası da geçerli). Üçü ayrılmamış: #1 ile #2, #4 ile #5 ve #5 ile #6. Yani liderlik tablosumun tam tepesi, sıralamanın gerçek olduğunu söyleyemediğim yerlerden biri.
Sorular kaç tanesi gerekir?
Bu, Miller’ın güç analizi dediği sorudur [1]. Eşleştirilmiş bir karşılaştırma için, iki model soruların q oranında farklı görüş bildirirken, d açısını güvenilir biçimde tespit etmek için gereken soru sayısı yaklaşık olarak aşağıdaki gibidir. %5 anlamlılık düzeyi ve %80 güç kullandım; işte 1,96 ile 0,84 burada ortaya çıkıyor.
n
≈
(
1.96
+
0.84
)
2
q
d
2
n \approx \frac{(1.96 + 0.84)^2 \, q}{d^2}
n
≈
d
(
1.96
+
0.84
)
q
En iyi iki modelim için q değeri 0.20, d değeri ise 0.0185 olup bu da yaklaşık 4.600 soru sonucunu veriyor. Ben 2.000 kullandım. Tüm model çiftlerimdeki ortanca q değeri 0.27 ve bu da aşağıdaki sonucu veriyor.
Gereklilik, açıklığın ne kadar küçük olduğunun kareleriyle büyür. Açlığı yarıya indirirseniz dört kat daha fazla soruya ihtiyacınız olur. Formülü tersine de işletebilirsiniz. Benim gibi bir uyuşmazlık oranıyla (20%), 200 soruda açıklık için %95 güven aralığı yaklaşık ±6 puan, 500 soruda ±4 puan ve 2.000 soruda ±2 puandır.
En iyi model en azından dayanıklı mı?
2.000 soruyu ayrıca 3.000 kez iki rastgele yarıya böldüm, bir yarıda kazananı belirledim ve diğer yarıda sınadım. Aynı model her iki yarıyı da seferinde %94 oranında kazandı. Kazananın avantajı, onu seçmek için kullanılan yarıda 1.88 puan, diğer yarıda ise 1.62 puandı; dolayısıyla avantajın küçük bir kısmı (yaklaşık %13) ortadan kalktı.
Bu %94’e dayanmazdım. Her iki yarı da aynı soru yığınından alındığı için o yığının eğilimini paylaşıyor. Bu, sıralamanın bu soru kümesinin içinde istikrarlı olduğunu söylüyor. 2.000 soruluk taze bir kümenin uyumlu olacağını söyleyemiyor ve yeni soru edinmek tam da en pahalı olan şey.
Bir sıralama tablosunu okurken ne yapardım
Skorun arkasında kaç soru olduğunu araştırırdım, çünkü bir soru o sayıda 100’ü böldüğünüz kadar puan değerinde. Bir aralık veya eşleştirilmiş test arardı; sayfa ikisini de sunmuyorsa, birkaç yüz soruda birkaç puanlık açıklığı gürültü içinde sayardım. Sıralamalar yerine kümeler içinde düşünürdüm, çünkü ortadaki üç modelim tablonun üç konuma böldüğü bir kademedir. Ve gerçek bir iş için model seçseydim, kendi sorularımı kısa listeye indirirdim, çünkü asıl önem verdiğim soruların bulunduğu tek sınav bu olurdu.
Bu burada gösterilmiyor
Bunlar, tek bir çoktan seçmeli ölçekte tek bir zero-shot prompt ile puanlanan küçük açık modellerdir; dolayısıyla bu sayılar yayımlanmış MMLU skorlarıyla karşılaştırılamaz. Yeniden çizim, 2.000 sorumu bir popülasyon olarak ele alır; bu yalnızca hangi soruların seçildiğine ait gürültüyü yakalar, başka hiçbir şeyi değil. Prompt ifadesinden gelen gürültüyü, örnekleme rastlantısallığını ya da kirliliği (contamination) yakalamaz. SWE-bench gibi bir modelin veya ajanın bir üretmesi gereken yanıtlar gerektiren ölçeklerde buna ek olarak çalışmadan çalışmaya rastlantısallık bulunur; bu nedenle gerçek belirsizlikleri burada ölçtüğümden daha büyüktür. Grafikteki ölçek boyutları yalnızca ölçeklendirme amacıyla oradadır. Bu sıralamaların ne kadar kararlı olduğunu ölçmedim.
Kodun tamamı makalede yer alıyor ve tam çalışma, bir Colab defterinde birkaç hücreden ibaret.
[1] E. Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations (2024), arXiv:2411.00640
[2] D. Hendrycks et al., Measuring Massive Multitask Language Understanding (2021), ICLR 2021
[3] OpenAI, Introducing SWE-bench Verified (2024), openai.com
[4] M. Chen et al., Evaluating Large Language Models Trained on Code (2021), arXiv:2107.03374
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.