

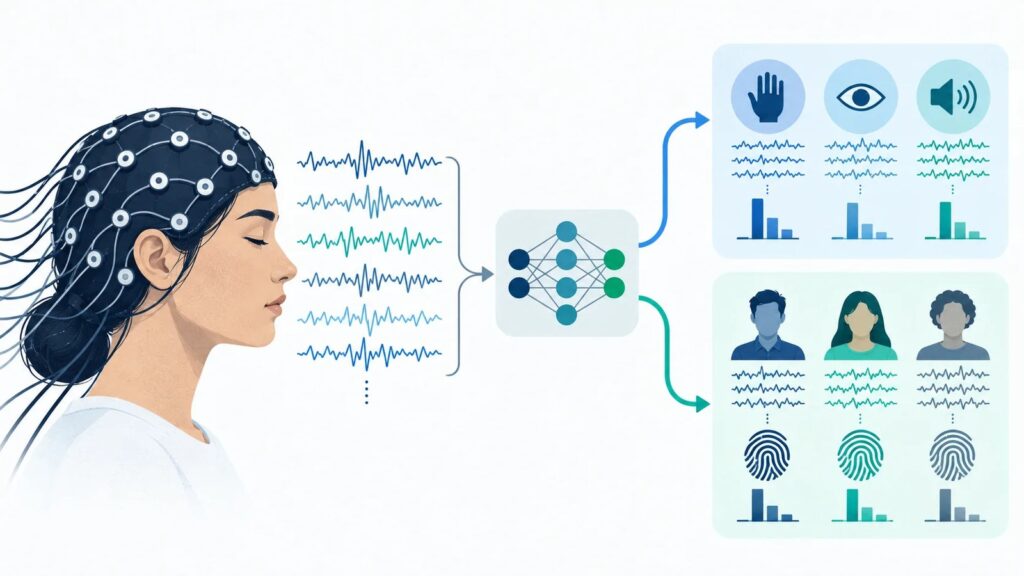
Değerlendirme Tasarımı ve Genelleyebilme
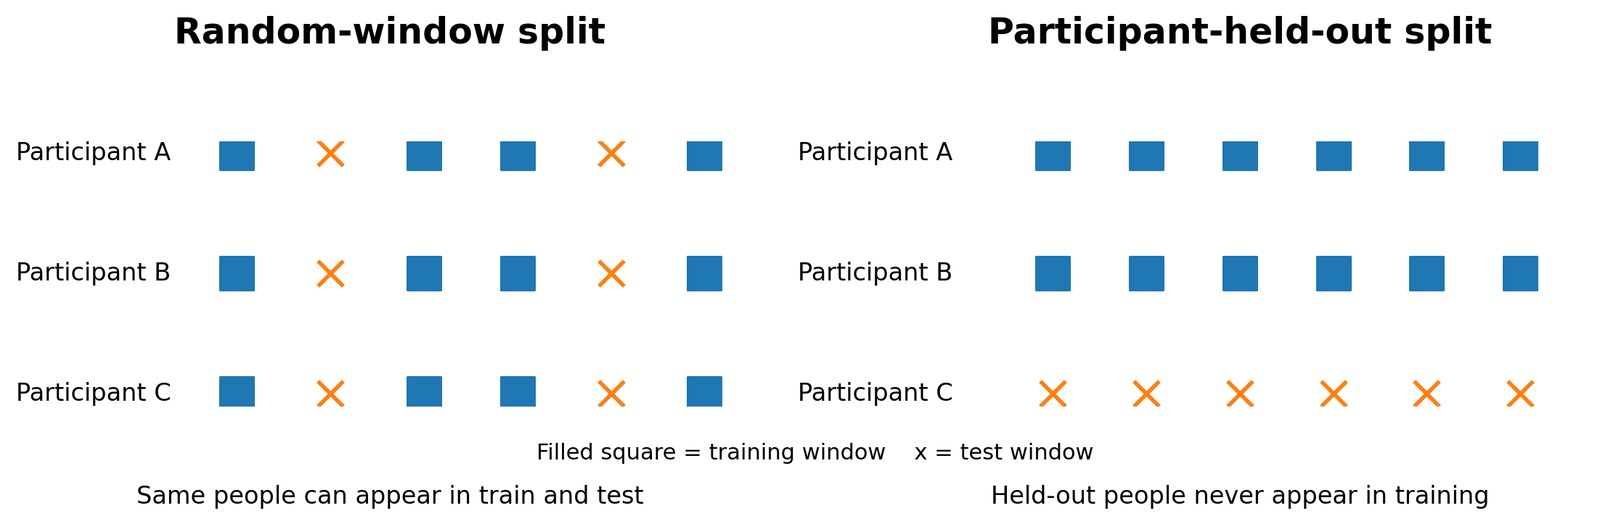
EEG makine öğrenimi pipeline’ını uygularken, birkaç katılımcıdan elde edilen çok sayıda örnek bulunur. Tek bir kayıt birden fazla pencereye ayrılabilir; bu pencereler rastgele eğitim ve test bölümlerine ayrılır. Bu da oldukça büyük görünecek bir örneklem boyutu üretir. Ancak aynı katılımcının pencereleri her iki bölümde de mevcutsa, değerlendirme prosedürü yeni katılımcılara yapılan genelleyebilmeyi test etmek yerine, modelin muhtemelen daha önce görülmuş katılımcıların pencerelerini ne kadar iyi sınıflandırdığını kontrol eder.
Bu fark önemlidir çünkü EEG kayıtları önemli ölçüde katılımcıya özgü yapı içerebilir. Aynı sorun, giyilebilir sensörler, tıp izlemi, davranışsal veri ve diğer katılımcı düzeyindeki veri setleri dahil olmak üzere tekrarlı ölçümlerden oluşturulan çok sayıda makine öğrenimi probleminde ortaya çıkar. Herhangi bir durumda aynı kişi veya kaynaktan gelen örnekler hem eğitimde hem de testte görünebiliyorsa, model performansı gerçek genelleyebilme yerine bu kılavuzla tanışıklığa yansır. Translasyonel EEG konusundaki güncel araştırmalar, hedef değişken görünmeyen katılımcılarda performans olduğunda segment düzeyinde ayıkalamanın (holdout) katılımcı düzeyindeki ayıkalamadan çok daha iyimser sonuçlar verdiğini göstermektedir [1]. Bu çalışmada, aynı değerlendirme senaryosunu en basit olası durumunda yeniden üretiyoruz: klasik spektral özellikler ve üç standart makine öğrenimi algoritması kullanılarak arka plan EEG verisinin zihinsel aritmetik görevi sırasında elde edilen EEG veriyle karşılaştırılması.

Analizde kullanılan veri seti, PhysioNet’ten EEG During Mental Arithmetic Tasks (EEGMAT) idi [2,3]. Hem arka plan hem de zihinsel aritmetik olmak üzere 36 EEG kaydı içeriyor. Her katılımcı için bir arka plan kaydı ve bir zihinsel aritmetik kaydı var.
Orijinal açıklamaya göre örnekleme frekansı 500 Hz’dir, arka plan segmentleri 180 saniye uzunluğundadır, zihinsel aritmetik segmentleri 60 saniye uzunluğundadır ve elektrot yerleşimi Uluslararası 10/20 sistemine göre yapılır [3].
Mevcut analizde 19 EEG kafa kanalı kullanıldı; kulak referansı fark kanalı ve ECG kanalı görmezden gelindi. Her kanalın sinyali, 1-40 Hz aralığında bant geçiren filtreyle filtrelendi ve örtüşmeyen 4 saniyelik pencerelere ayrıldı. Bu sürecin sonucu toplamda 2.134 pencere oldu: 1.594 arka plan penceresi ve 540 aritmetik penceresi; eşitsiz miktarlar kayıt uzunluklarındaki farklardan kaynaklanıyor.
Güç spektral yoğunluğu, Welch yöntemi kullanılarak [4] her kanal ve pencere için hesaplandı. Bağıl güç, theta (4-8 Hz), alpha (8-13 Hz), beta (13-30 Hz) ve düşük gamma (30-40 Hz) bantları toplanarak hesaplandı; 1-40 Hz aralığındaki tüm güçlerin toplamıyla normalize edildi. 19 kanalın 4 bantla çarpılması pencere başına 76 özellik verir.
Görev, bu çalışmanın bağlamında yeni bir fizyolojik biyomarker geliştirmek değildi. Bu yüzden değerlendirme tekniğinin etkisini izole etmek amacıyla konvansiyonel ve anlaşılır özellikler seçildi.
Değerlendirme Protokolleri
Üç sınıflandırıcı karşılaştırıldı: sınıf ağırlıklı lojistik regresyon, RBF-çekirdek destek vektör makinesi ve 300 ağaçlı sınıf ağırlıklı rastgele orman. Lojistik regresyon ve SVM için ölçeklendirme, scikit-learn pipeline’ları içinde gerçekleştirildi böylece ölçekleyici yalnızca eğitim verisinde uyarlandı. Rastgele-pencere değerlendirmesi on katmanlı 80/20 shuffle (karıştırma) bölümlemesi kullandı. Pencereler rastgelelemenin birimiydi ve bir katılımcının hem eğitimde hem de teste pencere katkıda bulunmasına olanak tanıdı. Katılımcı düzeyinde ayıkalmış değerlendirme, gruplama değişkeni olarak katılımcı kimliği kullanarak altı-katlı GroupKFold kullandı. Her gruplanmış katlamada, test katılımcılarının eğitimde temsil edilen sıfır penceresi vardı. Dengeli doğruluk birincil metrik olarak hizmet verdi çünkü orijinal pencere düzeyindeki veri seti dengesizdi; ROC-AUC de değerlendirildi. Önemlisi, bu iki protokol farklı nicelikleri tahmin eder: biri katılımcı örtüşmesine izin verildiğinde ayıkalmış pencerelerdeki performansı ölçerken, ikincisi tamamen görünmeyen katılımcılara yapılan aktarımı ölçer.
Değerlendirme Stratejileri Boyunca Performans
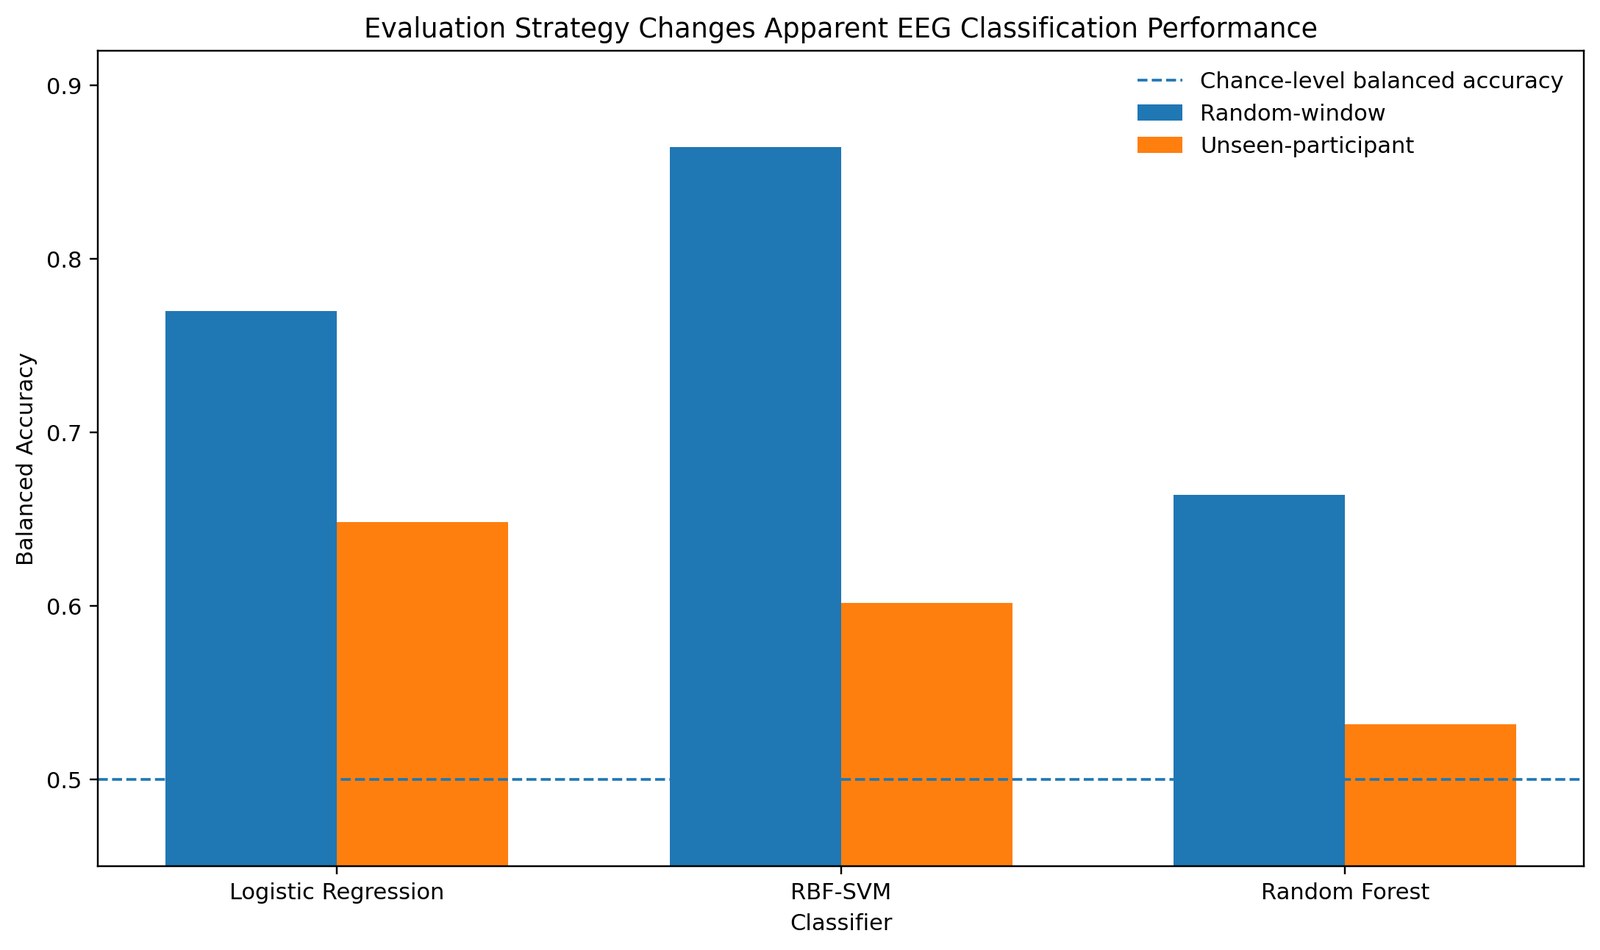
Üç sınıflandırıcının da tamamı tüm katılımcılar ayıkalandığında daha kötü performans gösterdi. Lojistik regresyon 0,770’den 0,648 dengeli doğruluğa düştü. Rastgele orman 0,664’ten 0,532’ye düştü. En büyük fark RBF-SVM ile ortaya çıktı: rastgele-pencere değerlendirmesi altında 0,864’e karşılık görünmeyen katılımcılarda 0,602; bu da 0,263 mutlak açıklık demek. ROC-AUC aynı geniş deseni gösterdi. Lojistik regresyon 0,849’dan 0,699’a, RBF-SVM 0,932’den 0,671’e ve rastgele orman 0,909’dan 0,691’e düştü. Bu desenin lineer bir modelde, nonlinear bir çekirdek modelinde ve ağaç topluluğunda ortaya çıkması, onu tek bir sınıflandırıcının kendine özgü bir özelliği olarak görmezden gelmeyi zorlaştırıyor.
Katılımcı Kimliğinin Tanısal Kontrol Olarak Kullanımı
Ancak performans farkının kendisi, mekanizmanın nasıl çalıştığına dair herhangi bir içgörü sağlamaz. Özellikle, rastgele-pencere analizinden dolayı bölümlendirmenin her iki yanında da katılımcıya özgü yapı bulunması potansiyel bir sorundur. Böyle bir sorunun 76 spektral özellik durumunda var olup olmadığını görmek için, sınıflandırma amacı tamamen değiştirildi ve arka plan/aritmetik ayrımını tahmin etmek yerine, hangi pencerenin 36 katılımcıdan biri tarafından oluşturulduğu tahmin edilecek hale getirildi. İlk kimlik sınıflandırıcısı, %2,8 şans seviyesine karşı %95,6 başarıyla sonuçlandı. Orijinal veri tabanında arka plan pencerelerinin aritmetik pencereyden yaklaşık üç kat fazla olması nedeniyle daha sıkı bir kontrol prosedürü kullanıldı. Her katılımcı için rastgele 15 arka plan ve 15 aritmetik pencere alındı; böylece her katılımcı için farklı koşullardan eşit sayıda pencere içeren toplamda 1.080 pencere oluşturuldu.
Katılımcıları tanıma performansı %94,0 doğruluğa ulaştı ki bu, şansa göre 33,8 kat daha iyidir ve ilk-3 doğrluğu %99,5’tir. Yukarıdaki şekil, sınıflandırıcıların kimliği karar kuralı olarak kullanıyorlarına dair kanıt olarak alınmamalıdır. Bunun yerine, temsilin önemli ölçüde katılımcıya özgü bilgi içerdiğini gösterir; bu da eğitim ve test arasında katılımcılar örtüştüğinde rastgele-pencere değerlendirmesini aşırı iyimser hale getirebilir.
Koşul-Dengelemeli Kontrol Analizi
Orijinal görev sınıflandırma veri seti 1.594 arka plan penceresinden ve 540 aritmetik pencereden oluşur. Dengeli doğruluk ve sınıf ağırlığı dengesi gibi metrikler dengesizlik etkisini doğrudan dengelese de, birincil sonucun hiç dengesizlik olmadığı durumda bile geçerli olup olmadığını anlamak için başka bir kontrol testi gerçekleştirildi.
Üç-modelli test, her katılımcının 30 pencereye sahip olduğu dengeli alt set olan 1.080 pencerenin (540 arka plan ve 540 aritmetik pencere) kullanılarak tekrarlanmasıyla yapıldı. Rastgele-pencere yaklaşımı ile görünmeyen katılımcı yaklaşımı arasındaki performans farkı üç sınıflandarıcıda da görülmeye devam etti: lojistik regresyon için 0,120; RBF-SVM için 0,194 ve rastgele orman için 0,167. Dolayısıyla sınıf dengesizliği, değerlendirme farkının tek nedeni olamaz.
Katılımcı Düzeyinde Genelleyebilme Değişkenliği
Tek bir cross-validation ortalaması, modelin genelleyebilme yeteneğindeki önemli farkları gizleyebilir. Bu yüzden, gruplanmış lojistik regresyon analiziyle elde edilen katlama dışı tahminler korundu ve dengeli doğruluk her katılımcı için ayrı olarak hesaplandı. Katılımcı başına ortalamalı dengeli doğruluk 0,649’dı; medyan 0,644’tü ve katılımcılar arasındaki standart sapma 0,143’tü. Grup katılımcıları 10.000 kez yeniden örnekleme yapmak, ortalamaya dair %95 güven aralığını 0,602 – 0,695 olarak verdi. Bireysel dengeli doğruluk değerleri 0,289 ile 0,956 arasında değişti ve 36 katılımcının 5’i şanse göre 0,50’den düşük değere sahipti.
Yukarıdaki fark yalnızca teorik bir nokta değil, aynı zamanda pratik bir noktadır; ortalamalı olarak iyi çalışan bir model farklı katılımcılarda farklı davranabilir.
Sonuçların Yorumlanması
En güçlü sonuç metodolojik: değerlendirme tasarımı EEG sınıflandarıcılarının görünen performansını belirgin şekilde değiştirdi. Üç model ailesi boyunca, rastgele-pencere değerlendirmesi görünmeyen katılımcılarda yapılan değerlendirmeden daha yüksek dengeli doğruluk verdi. Aynı spektral temsil, koşul dengelemesinden sonra insanları %94,0 doğrulukla tanıyabilecek kadar yeterli ölçüde katılımcıya özgü bilgi içeriyordu ve görev-sınıflandırma açıklığı durum-dengelemeli bir kontrolün ardından da ayakta kaldı.
Birkaç sonuç bu deneylerle desteklenmiyor. Katılımcı-kimliği tahmin edilebilirlik, kimliğin görev-sınıflandırma açıklığının her bileşenini nedenlediğini kurmaz. Analiz ayrıca kimlik sinyalinin stabil fizyolojiden, elektrot yerleşiminden, kayıt oturumu özelliklerinden, artık artefaktlardan ya da faktörlerin bir kombinasyonundan mı kaynaklandığını belirlemez. Aynı zamanda herhangi bir pencere-düzeyinde EEG benchmark’ının geçersiz olduğunu da ima etmez. Amaçlanan soru açıkça daha önce gözlenmiş katılımcıdan yeni segmentlerle ilgileniyorsa, pencere-düzeyinde bir bölümleme uygun olabilir.
Önemli kural daha basittir: bölümlendirme genelleyebilme iddiasıyla uyumlu olmalıdır. İddia yeni bir kişideki performanssa, o kişi eğitimde temsil edilemez. Öğrenilen herhangi bir ön işleme, özellik seçimi, boyut indirgeme ya da hiperparametre ayarlaması aynı sınırı saygıyla karşılamalıdır.
Sınırlamalar
Bu evrensel bir EEG makine öğrenimi açıklaması değil, odaklanmış bir benchmark’tır. 36 katılımcılı tek bir halka açık veri seti ve el yapımı bir spektral temsil kullanıyor. Derin ağaçlar, bağlantı özellikleri, ham dalga formu modelleri, diğer görevler ve daha büyük veri setleri farklı açıklıklar gösterebilir. Buradaki etiketler arka plan ile zihinsel aritmetik görev durumudur; bilişsel yük için evrensel bir ikili gerçeklik gibi ele alınmamalıdırlar.
Birinci plandaki iki değerlendirme protokolü ayrıca yeniden örnekleme yapıları kullanır: on katmanlı rastgele-pencere bölümlemesi ile altı katılımcı-gruplu katlama. Dolayısıyla farkları betimleyici niteliktedir, sızıntının resmi nedensel tahmini değildir. Katılımcı-düzeyinde bootstrap, görünmeyen-katılımcı lojistik regresyon performansındaki belirsizliği nicellemek için ayrı olarak kullanılır. Son olarak, bu analiz katılımcıya özgü bilgiyi belirli kanallara ya da bantlara yerleştirmeye çalışmadı; bu, geriden sonra çıkarım yapılacak bir şey değil, faydalı bir takip deneyi olacaktır.
EEG Makine Öğrenimi İçin Çıkarmalar
Bir EEG sınıflandarıcısındaki en önemli sayı belki de doğruluğu değildir. Test setinin tanımı olabilir. Bu deneyde, aynı temel görev, özellikler ve model ailesi, test pencereleri eğitimde temsil edilen katılımcılardan gelebildğinde belirgin şekilde daha güçlü görünüyordu. Soru “Bu model daha önce hiç görmediği bir kişiden EEG sınıflandırabilir mi?” olduğunda performans düştü — RBF-SVM için 0,263 dengeli doğruluk noktasına kadar. Aynı anda, spektral özellikler katılımcı kimliği hakkında son derece bilgilendiriciydi. Bu kombinasyon, tekrarlı ölçümlerden oluşturulan herhangi bir makine öğrenimi problemi için faydalı bir uyarıdır: pencereler insanlar değildir. Dağıtım hedefi görünmeyen bir kişiyse, değerlendirme de görünen kişiler etrafında kurulmalıdır.
Tekrarlanabilirlik ve Uygulama
Analiz, MNE, NumPy, pandas, SciPy, matplotlib ve scikit-learn kullanılarak Python’da uygulandı. EDF dosyaları MNE ile okundu; güç spektral yoğunluğu scipy.signal.welch ile tahmin edildi; ölçeklendirme ve sınıflandarıcılar uygun olduğu takdirde scikit-learn pipeline’ları olarak uygulandı. Raporlanan yeniden örnekleme ve dengeleme adımları için rastgele tohumlar sabitlendi. Sonuçları üretmek için kullanılan tam analiz script’i bu makale paketini eşlik eder.
Tasarruf ve şekil kökeni: Bu makaledeki tüm şekiller ve grafikler, yazar tarafından bu analizin sonuçlarından oluşturuldu.
Öne çıkan görüntü: Bu makalenin yazarı tarafından oluşturuldu.
[1] G. Brookshire et al., “Data leakage in deep learning studies of translational EEG,” Frontiers in Neuroscience, 18, 1373515 (2024). https://doi.org/10.3389/fnins.2024.1373515
[2] PhysioNet, “EEG During Mental Arithmetic Tasks,” version 1.0.0. https://doi.org/10.13026/C2JQ1P
[3] I. Zyma, S. Tukaev, I. Seleznov, K. Kiyono, A. Popov, M. Chernykh, and O. Shpenkov, “Electroencephalograms during Mental Arithmetic Task Performance,” Data 4(1), 14 (2019).
Diskutera detta i gemenskapen
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.




Ordet är ditt.
Dela dina erfarenheter, frågor och bidrag. Din e-postadress kommer inte att publiceras.