

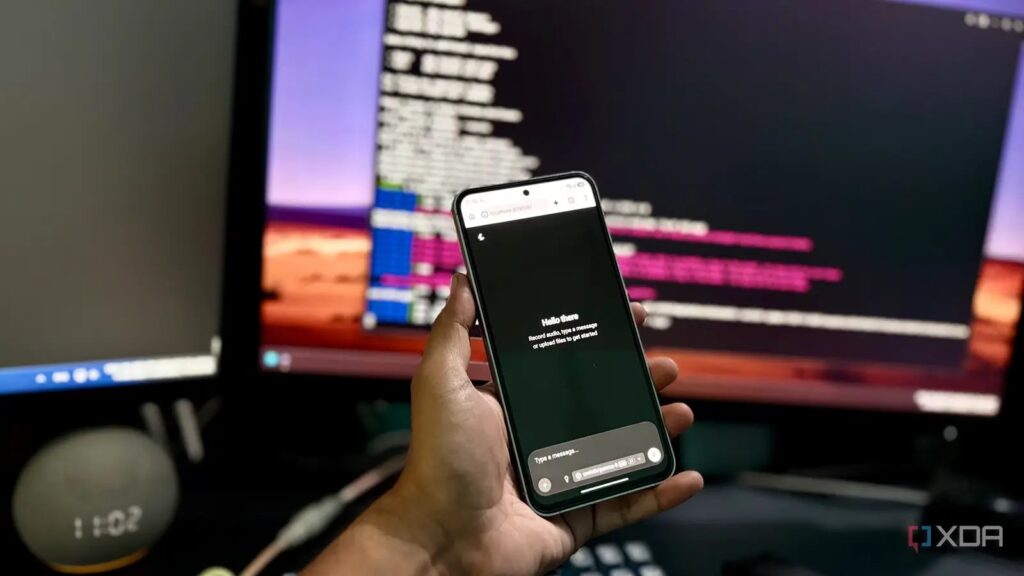
Yapay zekâya o kadar bağımlı hale geldim ki, metin özetleme veya e-postalara yanıt verme gibi küçük işlerde bile her zaman ChatGPT veya Claude gibi bulut tabanlı yapay zekâlara yöneliyorum. Yapay zekâyı bırakamadığım için, bulut tabanlı yapay zekâdan uzaklaşıp mümkün olduğunca kendi barındırdığım yerel LLM‘leri kullanmaya çalışıyorum.
Ekle
XDA

Google’da
Tercihli Kaynak Olarak Ekle
Google Discover’dan Takip Et
Örneğin, PC’mde zamanın çoğunda Gemma 4 E4B kullanıyorum. Ancak PC’mi her zaman açık tutamıyorum, bu yüzden eski Galaxy S23 FE’imde yerel bir LLM çalıştırmayı düşündüm. Bir LLM’i çalıştırabileceğini biliyordum, asıl sorum günlük kullanımımın bir kısmını ora taşıyabilecek miyimdi.
İstediğim model uygulamayı çürüttü, bu yüzden etrafından dolaştım
E2B PocketPal’i çürüttü, ardından Termux üzerinden yüklendi
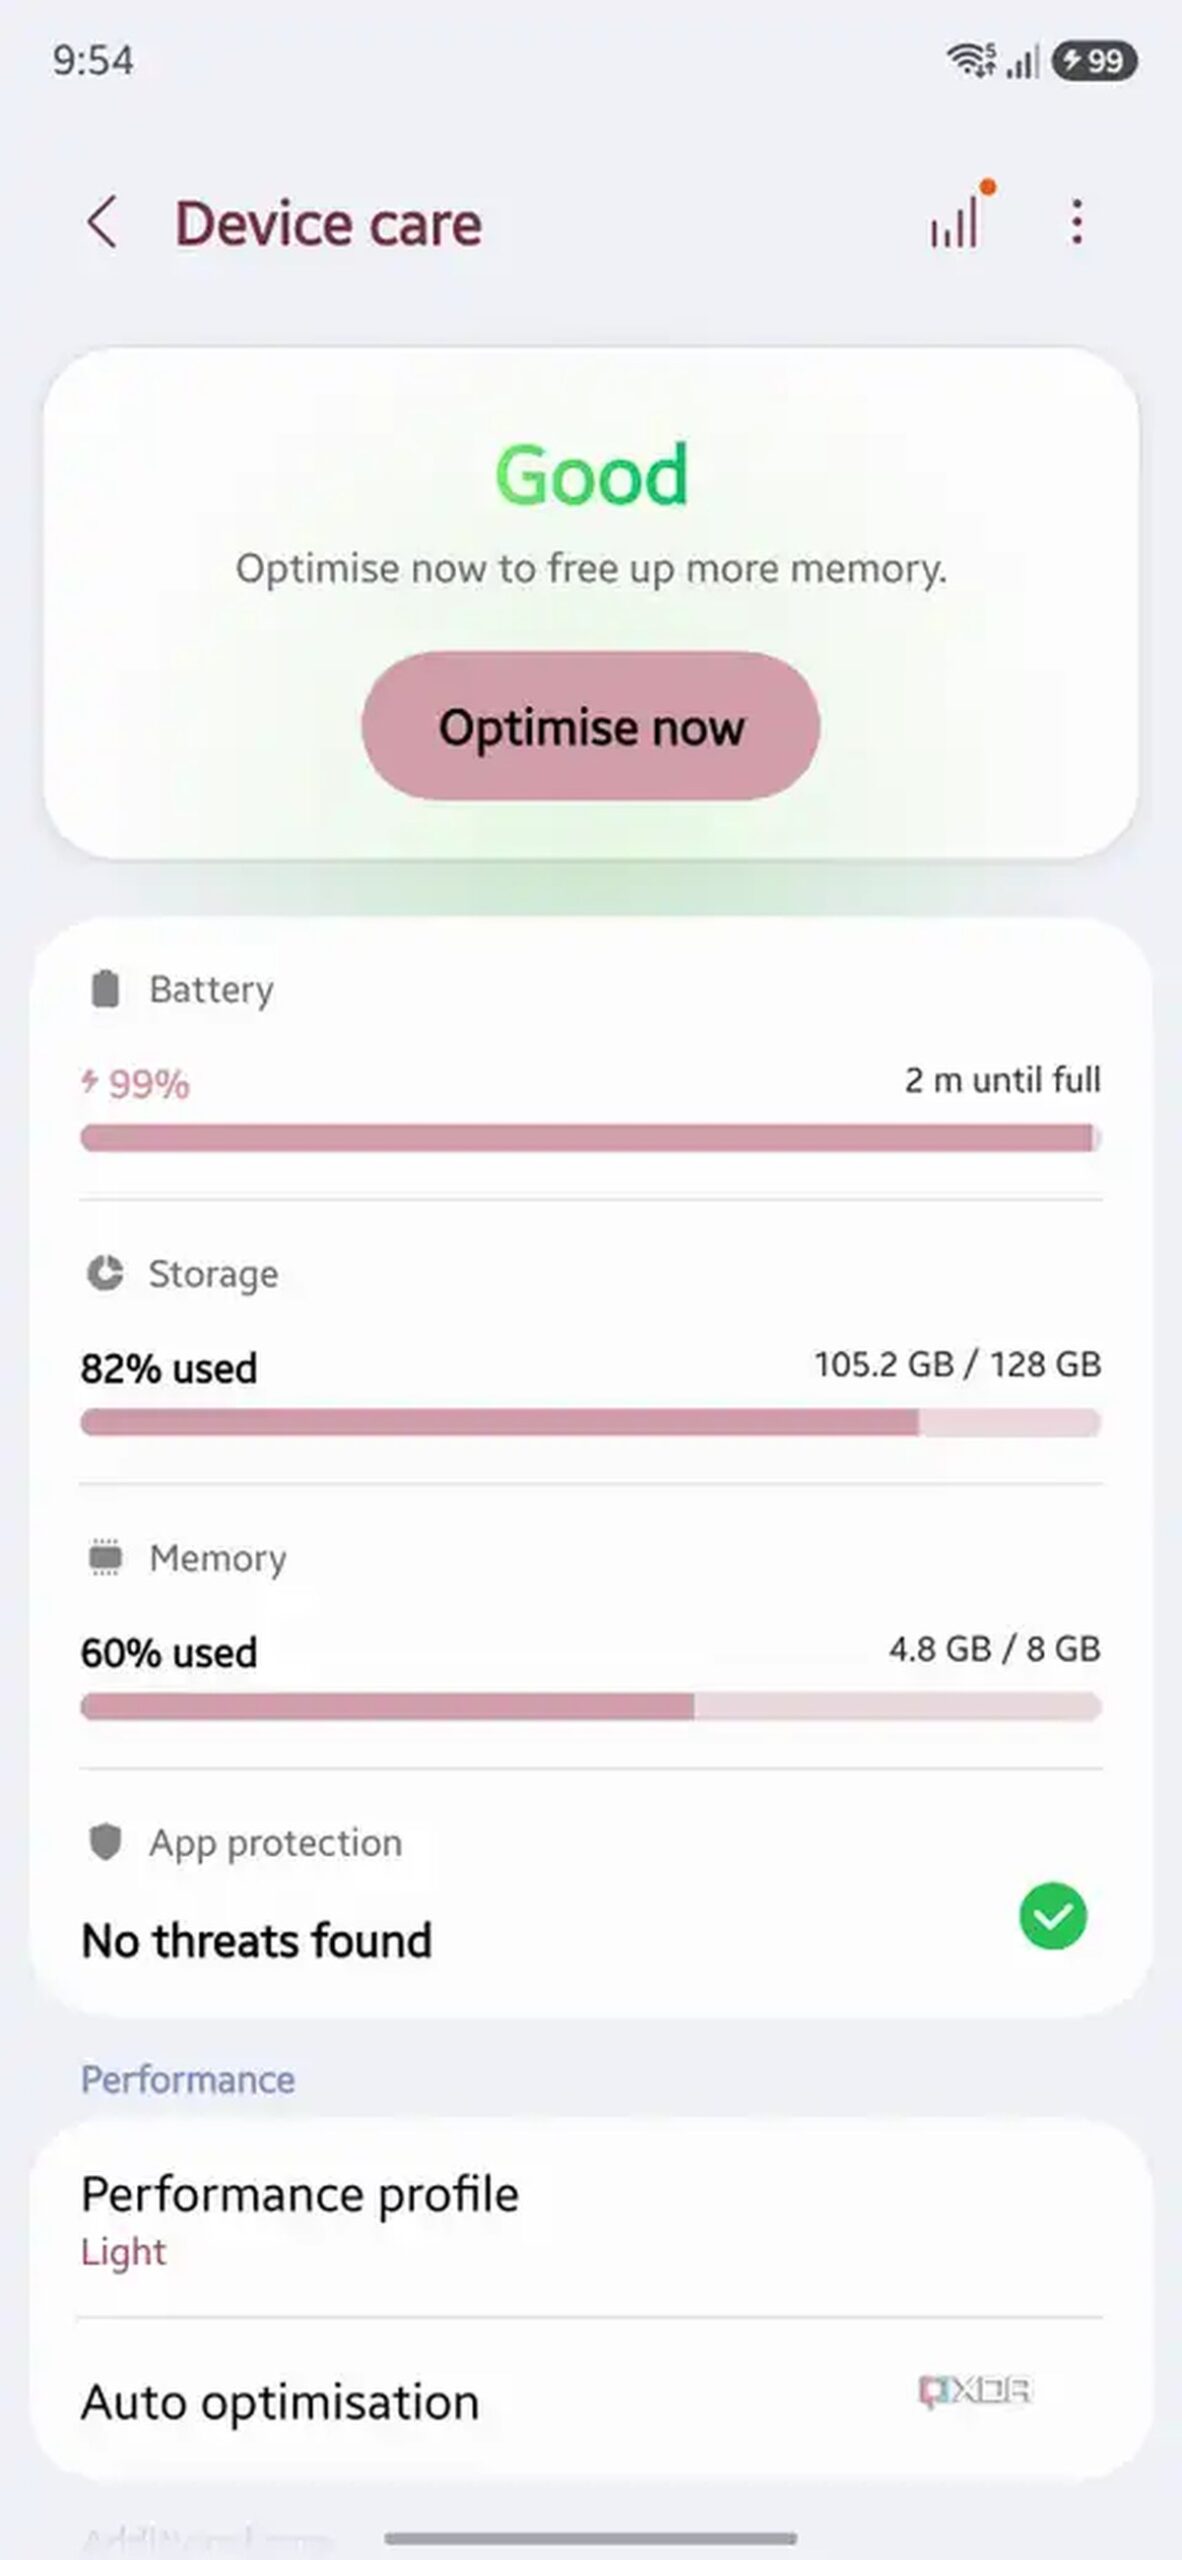
Galaxy S23 FE’m, 8 GB RAM’e sahip Exynos 2200 varyantı (Android’da 7,3 GB görünür). Bu yüzden başlamadan önce belleğin bir sorun olacağını biliyordum. Yerel bir LLM’i barındırmak için iki yöntemim vardı: ya PocketPal gibi bir istemci uygulaması ya da Termux üzerinden bir llama sunucusu.
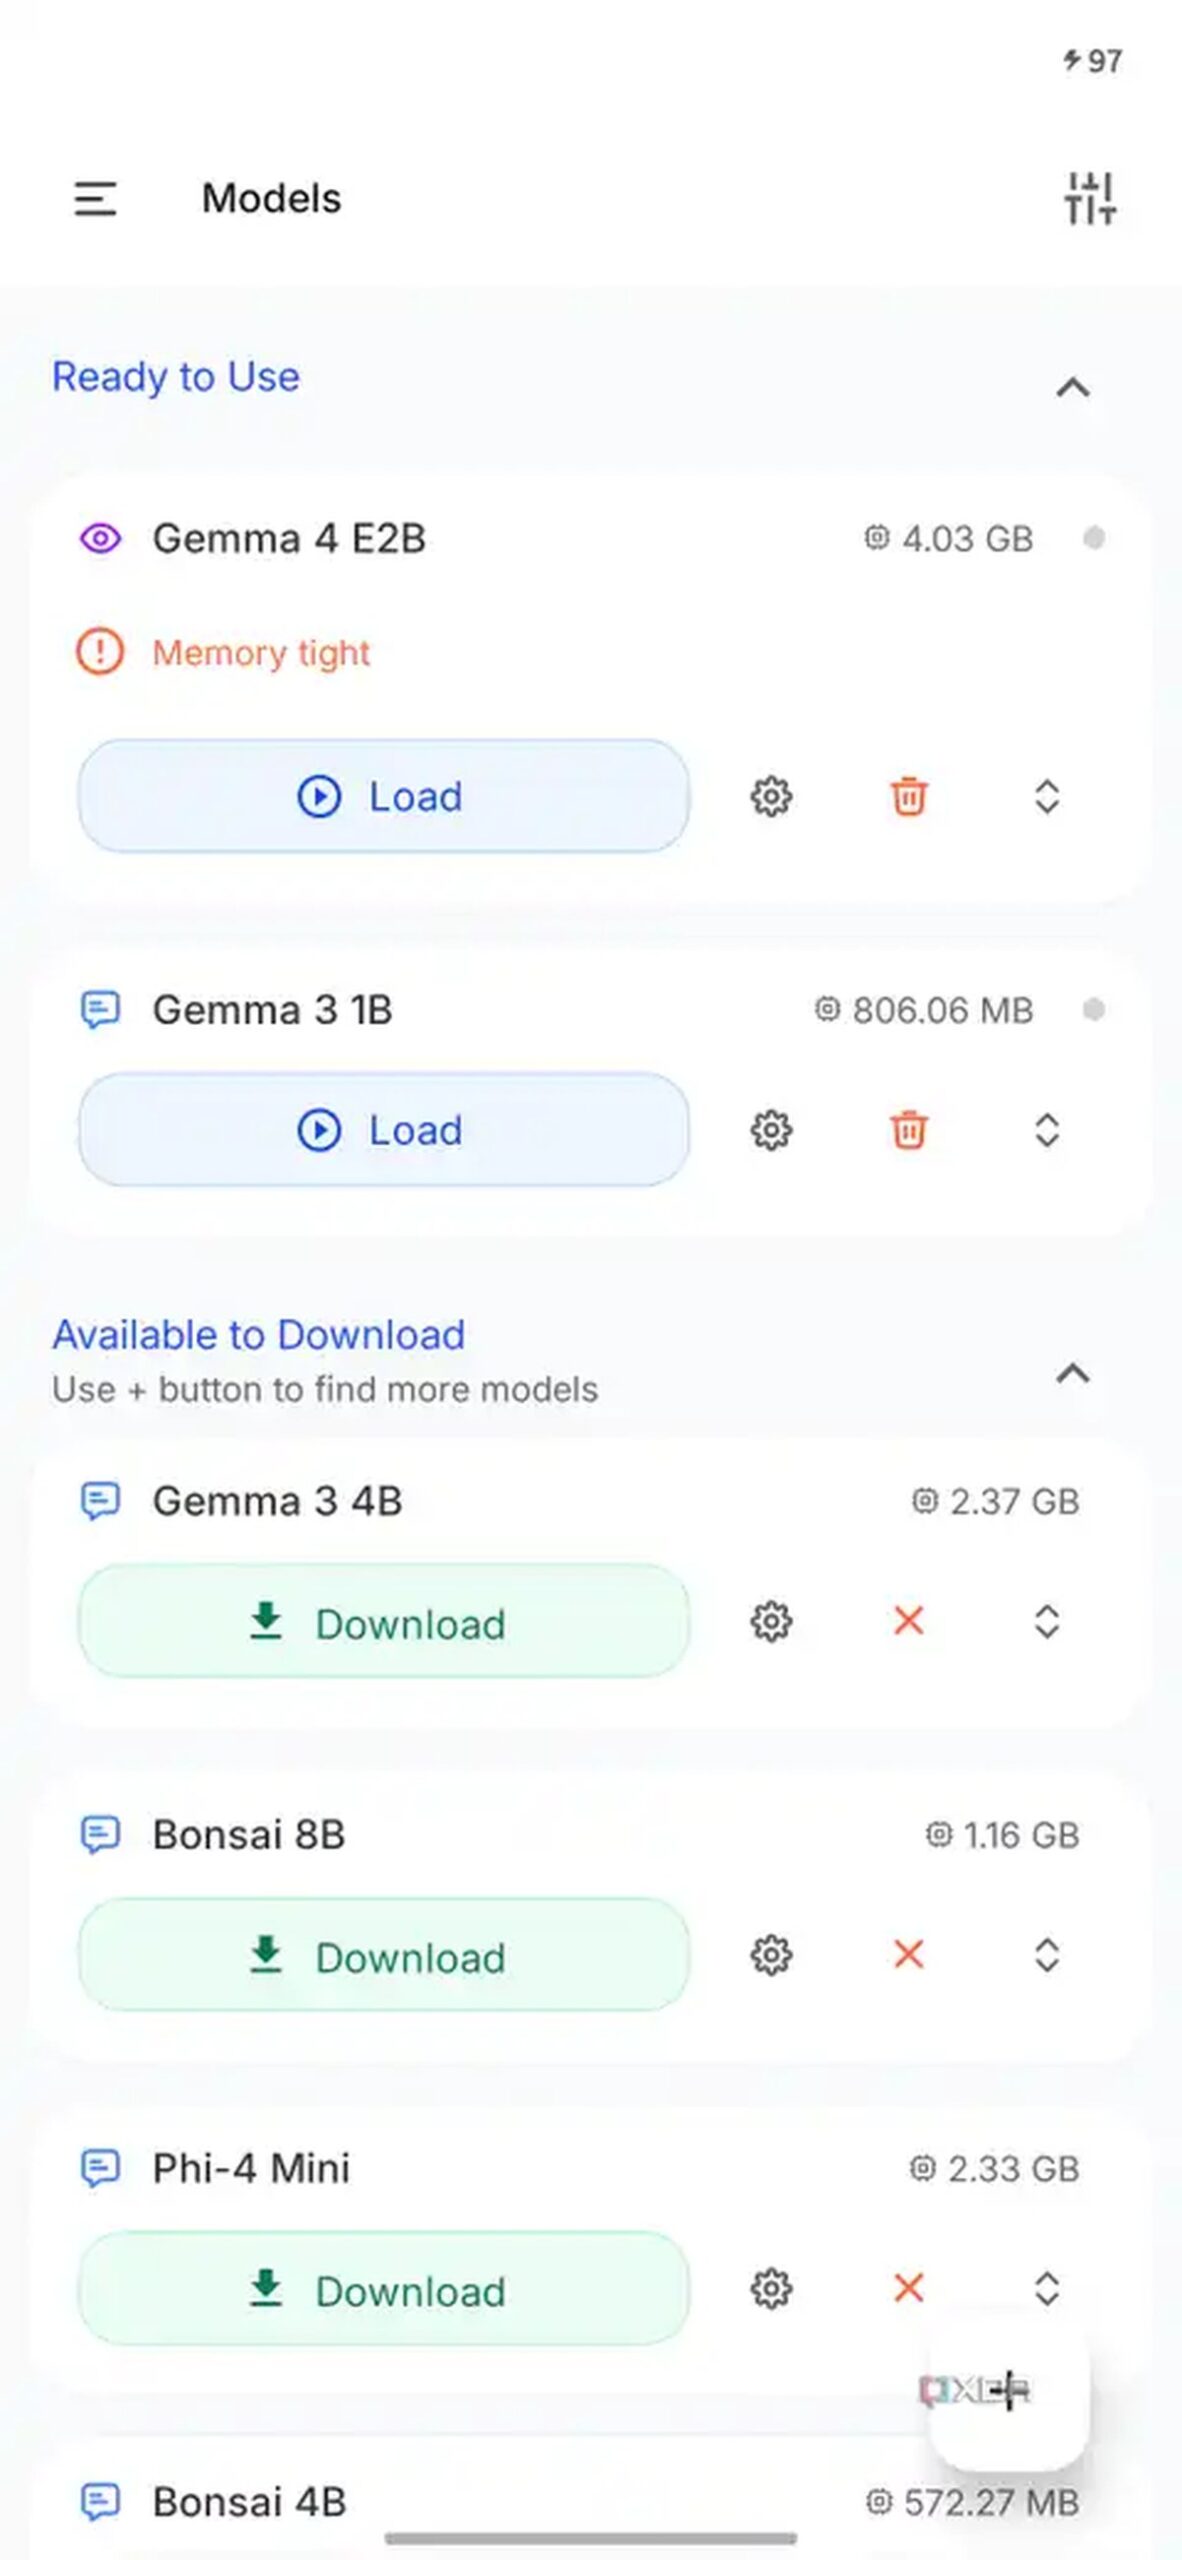
PocketPal ile başladım çünkü basitmişti: uygulamayı aç ve istediğin modeli indir. Yerleşik bir sohbet arayüzü de sunduğu için, günlük genel kullanımım için en kolay ChatGPT ve Claude alternatifiydi. PocketPal’in iyi yanı, yalnızca donanım için uygun olduğunu düşündüğü modelleri göstermesiydi. Bu yüzden Modeller sayfasına gittiğimde, yedi farklı model sundu. Gemma 3 1B’den Gemma 4 E2B’ye ve Bonsai ile Phi-4 Mini gibi birkaç başka modele kadar.
PC’mde Gemma 4 E4B ile geçmişte iyi bir deneyimim vardı, bu yüzden E2B’ye karar verdim. Galaxy’mde düzgün çalışırsa, diğer modelleri test bile etmezdim. Ancak bellek aynı zamanda bir sorundu çünkü kontrol ettiğimde, 8 GB’ın 4,6 GB’ı zaten kullanılıyordu. Bu yüzden en küçük modelden, Gemma 3 1B’den başladım. Telefonu yavaşlatmadan çalıştı. O anda verdiği yanıtlara hükmetmedim; performansını kontrol ediyordum. Bu yüzden hemen onu kaldırdım ve Gemma 4 E2B’yi indirdim.
Modeli yüklemeye çalıştığımda, modelin kullanılabilir belleği aşabileceğine dair bir bellek uyarısı verdi. Yine de devam ettim ve modeli yüklerken uygulama çürüdü. Bir kez değil, defalarca, bu yüzden PocketPal katmanını kaldırmanın yardımcı olabileceğini düşündüm. Termux bir seçenek olarak ancak o zaman tek seçenek haline geldi.
Telefonda zaten Termux vardı, bu yüzden sadece llama-cpp paketini bunun üzerinden kurdum. Ardından Unsloth Q4_K_M derlemesiyle Gemma 4 E2B’yi yükledim. Bağlam olarak, Hugging Face üzerinde 2,8 GB boyutunda ve gömme ile yaklaşık 4,65 milyar parametre olarak listeleniyor. Modeli kolayca yükledi ve localhost:8080’de sunucuyu başlattı. RAM kullanımını kontrol ettiğimde iyi göründü, bu yüzden işinin tamamlandığını düşündüm.
Hızlı, ama ben izlediğim sürece
0,1 tok/s ve bu pil ayarlarından değildi
Seyir çubuğunda llama web arayüzünü açtım ve basit bir istek çalıştırdım: beş kelimelik selam ver. Bu bana performans hakkında bir fikir verecekti. Sonra gelenleri görünce şaşırdım. 103 token’lık ön doldurma 1,27 tok/s hızında çalıştı ve asıl üretimi 8 token’ı üretmek için 1 dakika 11 saniye aldı, saniyede 0,11 tok.
Isınuyor olabilir diye düşündüm, bu yüzden iki satırda küçük bir paragrafı özetleyen başka bir istek çalıştırdım. Performans aynı kadar yavaştı. Bu sefer 194 token’lık ön doldurma 1,54 tok/s hızında çalıştı ve 68 token’lık bir çıktıyı 11 dakika 56 saniyede, saniyede 0,09 tok hızında üretti. Ne olabileceği ve bu kötü performansın nedeni hakkında düşünmeye başladım.
Düşüncem, belki Termux arka planda çalışıyordu ve Galaxy’nin güç ayarları performansı sınıryordu. Her şeyi kontrol etmeye başladım ve Termux’un pil ayarı zaten Sınırsızdı, kullanılmayan uygulamaları uyutma kapalıydı ve tasarruf modu kapalıydı, bu yüzden güç ayarları sorun değildi. E2B’nin kendisinin sorun olabileceğini düşünerek küçük başka bir modeli kurmaya karar verdim. E2B’yi kaldırdım ve Unsloth Q4_K_M modeliyle yaklaşık 1,18 GiB boyutunda Qwen 3.5 2B’yi yükledim. Yine kötü performans gösterdi, bu yüzden çürümemeyeceğini düşünerek PocketPal’e geri döndüm.
Modeli indirdim ve çalıştırdım. Sorunsuz çalıştı. PocketPal’ın yerleşik benchmark’ı 54,54 tok/s prefill ve 11,14 tok/s üretim gerçekleştirdi, gerçek testlerde ise kullanılabilir düzeyde yaklaşık 9 tok/s üretim aldı. Ardından modeli genel kullanım senaryoma göre detaylı biçimde test etmeye başladım. Üretilen yanıtların çoğu fazla halüsinasyon ve uydurma olgu içeriyordu, ancak E2B beklendiği gibi çalışmadığı için modeli yine de kullanmaya kararlıydım.
Ancak modeli kesin olarak belirlemeden önce aklımda hâlâ bir şüphe vardı. Zayıf performansın arka planda çalışan Termux ile bir ilgisi olduğunu düşünüyordum. Bu yüzden Termux üzerinde bir llama-bench testi yapmaya karar verdim (PC üzerinden SSH bağlantısı). Önce Qwen 3.5 ile başladım, ardından Gemma 4’e geçtim. Sonuçlar tam tersiydi ve şüphem doğru çıktı.
|
Test |
Model (Q4_K_M) |
Çalıştırma |
Önde Termux var mı? |
Prompt işleme (pp) |
Token Üretimi (tg) |
|---|---|---|---|---|---|
|
Qwen3.5 2B |
Kısa (pp32 / tg8) |
Hayır, önde Chrome vardı |
1,68 tok/s |
0,17 tok/s |
|
|
Qwen3.5 2B |
Kısa (pp32 / tg8) |
24,29 tok/s |
13,33 tok/s |
||
|
Qwen3.5 2B |
Uzun (pp512 / tg128, 3 tekrar) |
17,93 ± 0,18 tok/s |
9,98 ± 0,00 tok/s |
||
|
Gemma 4 E2B |
Kısa (pp32 / tg8) |
Evet |
Gemma 4’ün 0,1 tok/s olan üretimi 11,39 tok/s’a çıktı. Bu yaklaşık 100 katlık bir iyileşmeydi. Bu yüzden bunun neden olduğunu araştırmaya başladım ve her senaryodaki çekirdek sayısını kontrol ettiğimde (inspected /proc//cgroup ve Cpus_allowed_list) nedenin yarısını buldum. Termux uygulaması aktifken 0-7 arasındaki tüm çekirdekler kullanılabilirdi, ancak arka planda kullanılabilir çekirdekler 0-2’ye düştü.
Tahminim, Android’in görünür penceresi olmayan uygulamaları kısıtladığı ve Samsung’un grubunun arka plan grubundaki uygulamalara yalnızca üç çekirdek izni verdiği yönündeydi. Sonuçta işe yarayan çözüm, hem Termux’u hem de Chrome’u bölünmüş (split) modda çalıştırmaktı. Ve beklendiği gibi işe yaradı. Gemma 4 E2B yüklü ve ekran ikiye bölünmüş şekilde yaklaşık 5,4-6,6 tok/s aldım, bu da kullanılabilir bir düzeydi. Bir stres testinde ise 2 dakika 4 saniyede 730 token üretti.
Doğru kontrol edildiğinde küçük işler için yeterli
E2B, Qwen3.5 2B’nin uydurduğu şeyi doğru yaptı
Bu konuyu netleştirdikten sonra, kullanım senaryom için Gemma 4’ü tekrar test etmem gerekiyordu. Günlük kullanım senaryolarım özetleme, e-postalara yanıt verme ve zaman zaman birkaç teknik hesaplamadan oluşuyor. Beklediğim gibi, Qwen 3.5’in başarısız olduğu yerde, herhangi bir tekrar (iteration) olmadan doğru yanıtlar üretti.
Ancak Gemma 4’ün performansı beni şaşırtmadı, çünkü Gemma 4’ü lansmanından beri PC üzerinde kullanıyorum. Öte yandan Qwen 3.5 birçok şey uydurdu; örneğin Qwen’e Gemma’yı sorduğumda 4.5, 2.5, Ultra ve Turbo gibi model varyantları uydurdu ve hatta bana yanlış sürüm tarihlerini bile güvenle verdi. Ancak küçük modellerin zayıf yanı da tam olarak budur.
Şimdi, başta kendime sorduğum soruya geri dönelim: eski bir telefon, genellikle bulut yapay zekâda çalıştırdığım görevlerin bir kısmını üstlenebilir mi? Cevap evet, ancak belli koşullarla. İlk engel bölünmüş mod; her iki uygulamayı da—Termux ve Chrome—aktif tutmak zorundayım. İkincisi, bunlar küçük modeller olduğu için sonuçları her zaman tekrar kontrol etmek zorundayım.
Yerini tutmaz, ancak iyi bir ilk durak
Bu kurulumla birkaç günü geride bıraktıktan sonra, Galaxy S23 FE’nin ChatGPT veya Claude’un yerini alamayacağını söyleyebilirim; ancak küçük genel görevlerde her seferinde onlara başvurmak zorunda da değilim. Split ekranda çalışan Gemma 4 E2B, birkaç şartlı istisna ile basit metin düzenlemeyi, özetlemeyi ve sınıflandırmayı hallediyor. Ön plan zamanlamasının bir Android sorunu mu yoksa Samsung sorunu mu olduğundan emin değilim, bu yüzden bir sonraki adım, aynı kurulumu Samsung olmayan bir Android telefonda test etmek.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.