

Yerel yapay zekâ alanı nefes kesici bir hızla ilerliyor. Aslına bakılırsa, o kadar hızlı ilerliyor ki, sadece birkaç ay önce derlenmiş bir llama.cpp sürümü kullanan herkes zaten geride kalmış olabilir. Yeni sürümler, donanımınızın neler yapabileceğini değiştirebilecek yeni özellikler getirmeye devam ediyor ve çoğu zaman bu fark, kullanılabilir bir model ile yetenekli bir model arasındaki farkı oluşturuyor.
Ekle
XDA

Google‘da
Kaynak olarak ekle
Google Discover‘dan takip et
Eğer bana inanmıyorsanız, son gelişmelere bakmanız yeterli: Google’ın açık ağırlıklı modeller ailesi olan Gemma 4. Mayıs’ın başlarında Google, Gemma modelleri için çoklu token tahmini yapan taslakçıları (drafters) yayımladı ve llama.cpp bu desteği Haziran ayında ekledi. Bu taslakçı, RTX 4070 Ti Super’umda 242 megabaytlık bir dosya olarak Gemma 4 12B’nin yaklaşık 75 token/saniye hızını saniyede ortalamaya 179 token’e çıkarıyor; bu da benim test ettiğim üç iş yükünde muazzam bir 137’lik artış anlamına geliyor. İşte siz de bunu nasıl kullanabilirsiniz.
Gemma 4 12B modelim hızlıydı, ama çok daha hızlı olabilirdi
75 token/saniye tavan değildi, ta ki öyle olmadığıana kadar
Bir modelin ne kadar hızlı olabileceğini belirlemek için elbette ilk adım, modelin şu an ne kadar hızlı çalıştığını ölçmektir. Önce modelimin temel hızını, 16GB GDDR6X bellekle desteklenen RTX 4070 Ti Super, Ryzen 5 7600X ve 32GB DDR5 bellekle donatılmış PC’me test ettim. Gemma 4 12B QAT sürümünü UD-Q4_K_XL nicelleme (quant) seviyesinde, llama.cpp’nin b11927 sürümünde llama-server üzerinden, 32K bağlam (context), flash attention, tüm katmanların GPU üzerinde olması ve Google’ın önerdiği örnekleyici (sampler) ayarları (sıcaklık 1.0, top-p 0.95, top-k 64) ile sundum. Tüm testlerimde düşünme modunu kapattım, böylece üretilen her token bir cevabın parçası olarak sayıldı.
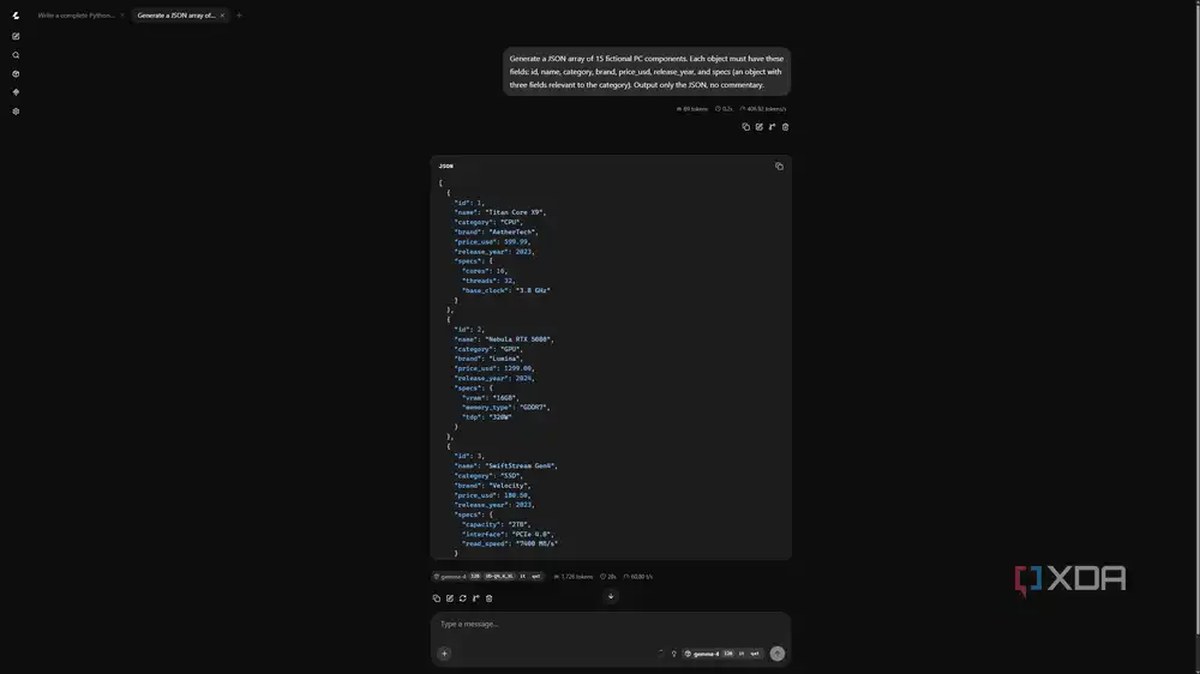
Modele üç görev verdim: kurgusal PC donanımı bileşenlerinden oluşan bir JSON listesi oluşturmak, Python ile tekrarlanan dosyaları bulan bir araç yazmak ve 600 kelimelik kısa bir hikâye yazdırmak. Bu üç istemi, yeni bir sohbet penceresinde aşağıdaki gibi ilettim.
- 15 kurgusal PC bileşeninden oluşan bir JSON dizisi oluşturun. Her nesne şu alanlara sahip olmalı: id, name, category, brand, price_usd, release_year ve specs (kategorije ilgili üç alandan oluşan bir nesne). Yalnızca JSON’u çıktılar, yorum eklemeyin.
- Dizini özyinelemeli olarak tarayan, SHA-256 özetiyle tekrarlanan dosyaları bulan ve her dosyanın yolunu ve boyutunu göstererek özete göre gruplandırılmış bir rapor yazdıran tam bir Python komut satırı aracı yazın. argparse kullanın, hata durumlarını (izin hataları gibi) zarifçe yönetin ve docstring ekleyin. Yalnızca kodu çıktılar.
- Fener bakıcısı hakkında, yaklaşık 600 kelimelik, fener ışığının yavaşça denizdeki bir şeye sinyal verdiğini fark ettiği ve o şeyin de sinyal vermeye başladığını keşfettiği kısa bir hikâye yazın.
Gördüğünüz gibi, bu istemlerin her biri benzersiz bir kullanım durumunu test ediyor ve bu boyut ile yetkinlik seviyesindeki modellere kullanıcıların genellikle gönderdiği istemleri temsil ediyor. Her istemi çalıştırdıktan sonra aşağıdaki sonuçları kaydettim. Test metodolojisi, Gemma 4 MTP’yi ekleyen llama.cpp pull request’inden geliyor; aynı GPU üzerinde çalışan başka bir testci, test için kullandığım üç kategoride sonuçları bildirmişti.
|
Görev (Temel) |
1. Deneme |
2. Deneme |
3. Deneme |
3 denemenin ortalaması (token/saniye) |
|---|---|---|---|---|
|
JSON |
77.1 |
74.4 |
72.8 |
74.7 |
|
74.3 |
74.9 |
77.2 |
||
|
Hikâye |
73.7 |
77.0 |
76.8 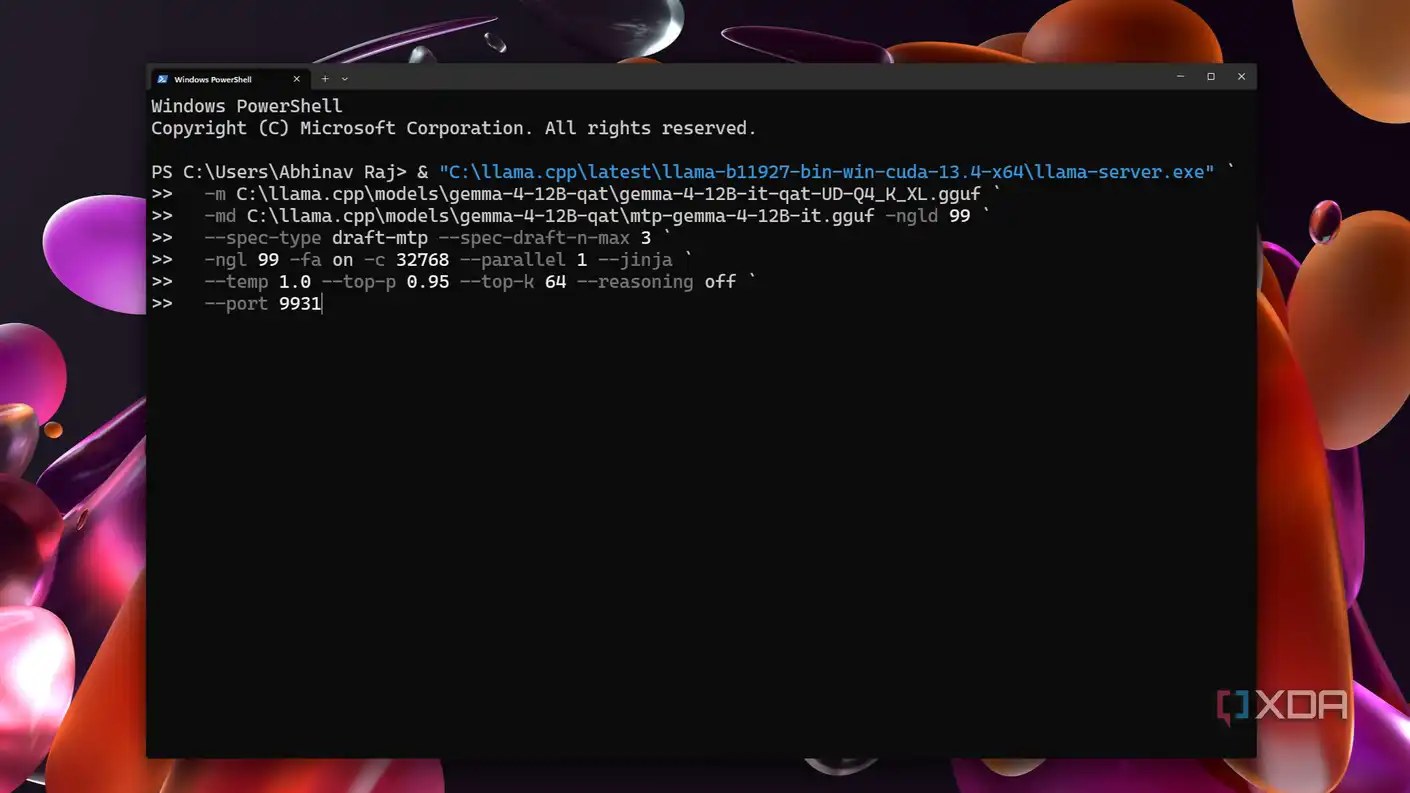 |
Çoklu token tahmini açmak bir dosya ve dört bayrak aldı
Yeni GPU yok, daha küçük modeller yok, sadece Google’ın bu amaçla geliştirdiği taslak modeli
Çoklu-token tahmini (MTP) şu şekilde çalışır: hedef model (burada Gemma 4 12B) ile birlikte eğitilen küçük bir taslak modeli eşleştirilir. Google bunu belgelerinde açıklar ve MTP’nin Gemma 4’ün tahmini kodlama (speculative decoding) için kullandığı mimari olduğunu belirtir.
Tahmini kodlama temelde, büyük modeldeki her geçişten daha fazla verim almak için küçük bir yöntemdir: küçük taslak modeli token tahminindeki işi üstlenirken, büyük hedef model bu tahminlerden birkaçını, normalde tek bir token üretmek için harcanacak sürede doğrular.
Bu durumda hedef modelin her tokenı sırayla üretmek yerine, taslak modeli birkaç token önden tahmin eder, büyük model de bunların tümünü paralel olarak kontrol eder. Bir “tahmin” hedef model tarafından reddedildiğinde, model yine o konum için doğru tokenı üretir, böylece adım boşa gitmez ve taslak modeli oradan devam eder.
Bu test için Hugging Face üzerindeki Unsloth Gemma 4 12B QAT deposundan hem UD-Q4_K_XL yapısını hem de eşleşik taslak modeli, Google’ın kendi taslak modelinden dönüştürülmüş olan mtp-gemma-4-12B-it.gguf’u indirdim. Bir depodan çifti birlikte tutmak önemliydi çünkü bir QAT modeli, kendi QAT taslak modeliyle çalışmalıdır. MTP’yi açmak için llama-server’ı dört ek bayrakla yeniden başlatmam gerekti; taban çalışmadaki diğer tüm ayarlar aynı kaldı.
Ardından dört bayrak kullandım: -md mtp-gemma-4-12B-it.gguf (taslakçıyı yüklemek için), -ngld 99 (taslakçıyı ana modelle aynı GPU üzerine almak için), –spec-type draft-mtp (taslakçıyı, modelin önbelleğini okuyan bir Gemma 4 MTP başlığı olarak çalıştırmak için, yalnız başına bir model yerine) ve –spec-draft-n-max 3 (her turu üç tahmine kadar sınırlayan; bu değeri llama.cpp çekme isteğindeki aynı GPU’daki benzer sonuçlardan aldım).
Gemma 4, yazmamı istediğim her şeyde daha hızlı hale geldi
Kod ve JSON neredeyse üçe katlandı, düz metin bile %73 hızlandı
Taslakçı yüklendikten sonra yapmam gereken tek şey, testi aynı VRAM koşulları altında tekrar çalıştırmaktı. Bunu başka türlü ifade etmek mümkün değil; tek söyleyebileceğim, her görevin daha hızlı olması. JSON ve kod görevleri saniyede yaklaşık 75 belirteçten saniyede 200 belirtece çıktı; çünkü parantezler, alan adları ve kalıp metinler öngörülebilir ve taslakçı ile donatılan modeli destekledi.
Ancak şaşırtıcı olan, taslakçıyı yanıltmak için daha fazla alan bırakan düz metin iş yükünün bile %73 daha hızlı çalışmasıydı.
|
Görev |
MTP kapalı |
MTP açık |
Kazanç |
|---|---|---|---|
|
JSON |
74.7 |
||
|
Kod |
75.5 |
||
GPU’unuzu yükseltmeden önce taslakçıyı edinin
Gemma 4’ü llama.cpp altında çalıştırıyorsanız, bir taslakçı modeli edinmek için ona bir hız artışı sağlamanın en kolay ve en doğrudan yollarından biri gibi görünüyor. Yapmanız gereken tek şey, llama.cpp’nin en son sürümüne güncellemek, modelinize uygun taslakçıyı indirmek ve dört bayrak eklemektir.
Sadece şunu belirtmek gerekiyor: Test ettiğim Gemma 4 12B modeli gibi yoğun modeller, tasarımcı (drafter) desteğinden en fazla yararlanan modeller. Henüz tasarımcı ile bir karışım-uzmanlık (mixture-of-experts) modelini test etmedim; ancak Google, bu tür modellerin tek kullanıcılı kurulumlarda tasarımcıdan daha az yararlandığını belirtiyor. Sonuçların, kullandığınız donanım konfigürasyonuna göre de değişebileceğini belirtmek gerekiyor; yine de deneyiciler RTX 5090’dan GT 1030’a kadar her türlü donanımda artış bildirdi, dolayısıyla denemekten kaybetmek için bir şey yok.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.