
AI laboratuvarları, bir AI ürününün diğerinden daha iyi olup olmadığını ölçmek için tasarlanmış, sözde tarafsız ve doğru değerlendirme sistemleri olan model testlerine (benchmarking) itibarlarını bağladılar.
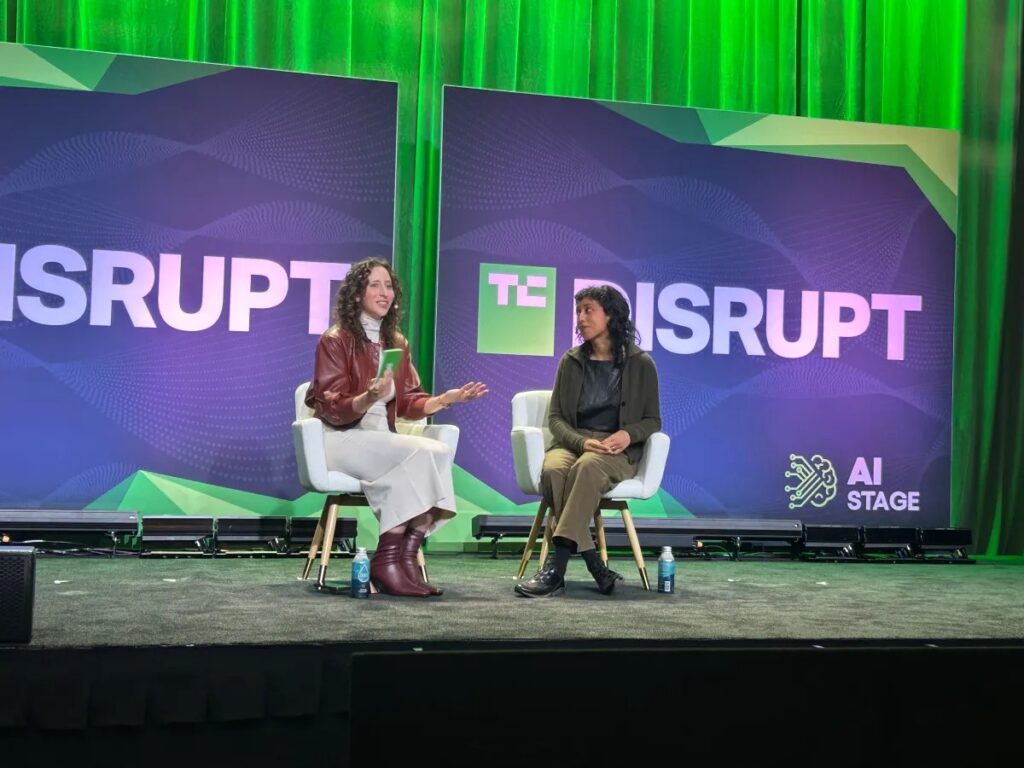
Bu değerlendirmelerin ardındaki yöntemlerin karmaşık ve hâlâ olgunlaşma aşamasında olduğu, geçen hafta TechCrunch Disrupt’ta bir tartışma sırasında Hugging Face‘in baş politika sorumlusu Irene Solaiman tarafından belirtildi. Sektörün gelecekte testlere güvenebilmesi için test etme süreçlerinin daha tutarlı bir bilimsel yaklaşıma kavuşması gerekiyor.

Bunu göz önünde bulundurarak, şu anda yayınlanan testlere güvenebilir miyiz?
“Güven, çok ağır bir anlam taşıyan bir terim,” dedi Solaiman. “Sonuçlara güvenip güvenemeyeceğimiz açısından, bunun önemli bir parçası bir değerlendirmenin sonuçlarını yeniden üretip üretemeyeceğinizdir. Modelin kendisine erişmek için ihtiyaç duyduğunuz düzeyde erişiminiz var mı? Light ağırlıklar burada büyük ölçüde devreye giriyor,” diye ekledi.
Model değerlendirmelerinde yeniden üretilebilirlik, uzun süredir testlemenin en zorlu yönlerinden biri olmaya devam etti ve sektörde önemli tartışmalara konu olmaya devam ediyor.
Tek bir testin geçerliliğinin yanı sıra, o testin diğer değerlendirmelerle nasıl karşılaştırıldığına dair ek bir soru da var.
“Bunlar gelişmekte olan bir bilim alanı; onları birbirleriyle anlamlı biçimde nasıl karşılaştıracağımızı bilmiyoruz,” dedi Solaiman.
Equity Live: 2026’yı Şekillendiren Girişim Hikayeleri
“Nispeten kısa sürede etkisizleşmeye başlıyorlar ve ihtiyacımız olan ölçüde canlı bir ekosistemimiz yok,” diye ekledi. “Şu anda gömülü değerlendiricilerden oluşan bir ekosisteme yönelik güçlü bir talep var, ancak kimin hangi görevlerde etkili bir değerlendirici olduğunu belirleyen niteliklerin çok daha fazla standartlaştırılması gerekiyor.”
Gömülü değerlendiriciler fikri — sözde “tarafsız” üçüncü taraf gözlemcilerin AI kuruluşlarının içine yerleştirilmesi — son birkaç aydır popüler hale geldi; çünkü AI laboratuvarları, teknolojilerinin potansiyel zararlarına ilişkin kaygıları tetikleyen bir dizi güvenlik olayıyla mücadele ediyor. Hugging Face, bilindiği üzere, bu olaylardan birinin hedefi olmuştu.
Model güvenlik kaygılarını tespit etmek ve azaltmak için aktif devlet düzenlemesi yerine, laboratuvarlar üçüncü taraf çözümünü öne sürdü. Ancak bu değerlendiricilerin gerçekte ne kadar tarafsız veya etkili olacağı konusunda şüpheler sürüyor. Anthropic’in, Accenture adlı danışmanlık firmasını ilk değerlendiricisi olarak işe alma kararı, firmanın söz konusu görevi yerine getirecek niteliklere sahip olduğu fikrini alaya alan bazı eleştirmenlerden hatırı sayılır tepki aldı.
Değerlendirmeler artık yalnızca modelin kendisini sınamaktan, çerçeve (harness) ve ajan da dâhil olmak üzere modelin etrafındaki tüm sistemi sınamaya doğru kayıyor. Özellikle çerçeve — kullanıcının modele erişmek için kullandığı araç — modelin performansını büyük ölçüde etkiliyor. Solaiman’ın paylaştığına göre, daha iyi bir çerçeveye sahip daha zayıf bir model, öncü bir modelden kolayca daha iyi performans gösterebilir.
“Ajan tabanlı değerlendirmeler gerçekten zor ve gerçekten pahalı,” dedi Solaiman. “Modeller için daha çok değerlendirmemiz var. … Çerçeveler için o kadar çok değerlendirme yok ve bütüncül ajan için daha iyi değerlendirmeler geliştiriyoruz — çünkü birçok kişi değerini bundan elde ediyor,” diye ekledi.
Başka bir deyişle, değerlendirme alanı şu anda biraz başıboş bir durumda. Testlemenin sektör liderleri için kullanışlı bir araç olarak görülmeye devam etmesi için, herkesin ortak bir yaklaşım benimsediği daha tutarlı, sektör çapında bir yöntem gerekli olabilir.
Discuss this development in the Community
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Community Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Your turn to speak.
Share your experience, questions, and contributions. Your email address will not be published.