

Tüm Yazarların Pipeline’ı
scikit-learn’i bir süre kullandıysanız, muhtemelen bu pipeline’ı yazmışınızdır. Sayısal sütunlar eksik değer doldurma ve ölçeklendirme işleminden geçer. Geri kalan her şey eksik değer doldurma ve one-hot kodlamadan geçer. Sütunlar dtype’a göre yönlendirildiği için siz bakmadan neredeyse her tablo üzerinde çalışır.
def auto_pipeline(model):
num = make_column_selector(dtype_include=”number”)
cat = make_column_selector(dtype_exclude=”number”)
pre = ColumnTransformer([
(“num”, make_pipeline(SimpleImputer(strategy=”median”), StandardScaler()), num),
(“cat”, make_pipeline(SimpleImputer(strategy=”most_frequent”),
OneHotEncoder(handle_unknown=”ignore”)), cat)])
return make_pipeline(pre, model)
Kısa, yeniden kullanılabilir ve güvenmesi kolay. İşte sorun da burada. Sessizce neyi yanlış yaptığını görmek istediğim için, onu bilinçli olarak bozmaya çalıştım.

Ektiğim Dört Tuzak
Veri. Buradaki her şey sentetik. Bunları kendim bir Python scriptiyle ürettim: her veri setinde 8.000 satıra sahip bir müşteri ayrılma (churn) tablosu (6.000’i eğitim için, 2.000’i “yeni müşteriler” olarak temiz bir holdout). 5 bağımsız veri seti ürettim (0’dan 4’e tohum değerleri) ve bunlar üzerindeki ortalamayı raporluyorum.
dtype tabanlı bir pipeline’ın göremeyeceği dört tuzak ektim:
-
Bölge bir sayı olarak. region_code 1 ile 12 arasındaki tamsayıları içerir ancak her bölge churn’u farklı ve sıralı olmayan bir şekilde etkiler. Pipeline bunu bir ölçüm gibi ölçeklendirir.
-
Bilgi içeren eksik değerler. support_calls, churn yapanlarda yaklaşık %45’inin, yapanlarda ise %8’inin kaydı eksiktir. Medyan ile doldurma bu sinyali siler.
-
Etiketi sızdıran bir ID. Eğitim verisinde customer_id, sonuç sırasına göre yaklaşık olarak atanmıştı; bu, ihracat sırasının veya zamanlamanın gerçek sistemlerde sonuçlarla nasıl korele olabileceğinin bir benzetmesidir. Temiz held-out kümesinde ID’ler churn ile alakasızdır.
Naif pipeline’ı, tek tek bir düzeltme eklenmiş naif pipeline’ı ve dört düzeltmenin bir arada uygulandığı versiyonu test ettim İki model kullandım: lojistik regresyon (cross-validation AUC ve holdout AUC) ve gradient boosting (süre uzunluğunu kısaltmak için yalnızca holdout AUC).
Sahte Puan
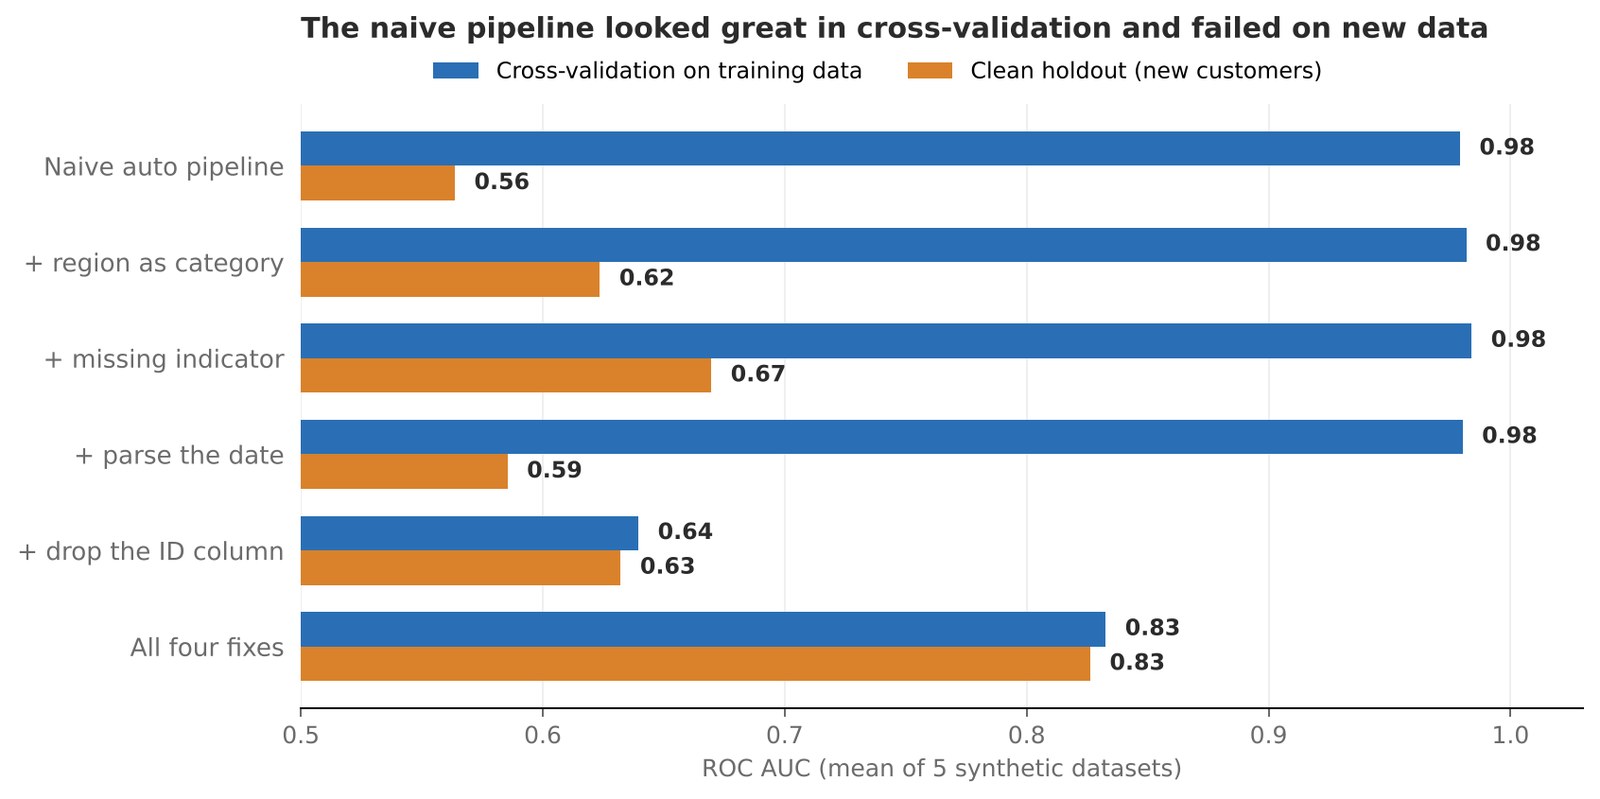
ID sütunu kaldırılana kadar cross-validation neredeyse 0.98 seviyesinde kaldı. Ancak ancak o zaman yeni verilerin gösterdikleriyle örtüştü.(Kaynak: Yazar tarafından, Python kullanılarak oluşturuldu)
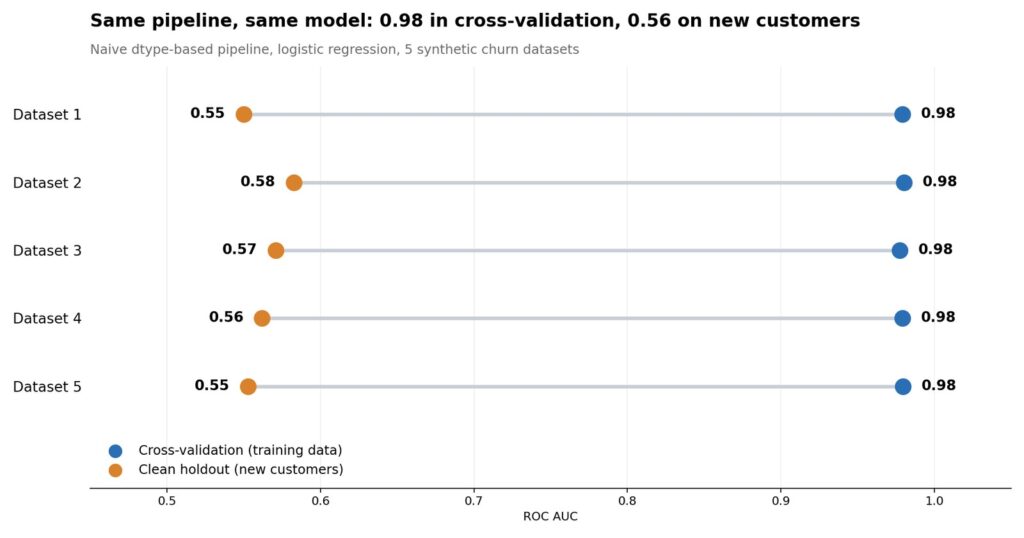
Naif pipeline 5-fold cross-validation’da 0.979 ve yeni müşterilerde 0.564 puan aldı. Hiçbir şey çökmadı, hiçbir uyarı görünmedi ve her sayı güçlü bir model izlenimi verdi.
ID Sütunu Cevabı Bilmişti
Model dolayısıyla iki şey yaptı. Etiketi ID üzerinden okudu ve tarih bazlı gürültüyı ezberledi. Tarih sorunu görünmeyen tarihlerle ilgili değil: holdout satırlarının %96,7’si eğitimde de görünen bir tarihe sahipti. Model yalnızca o belirli günlerde ne olduğunu ezberlemişti.
Bir Düzeltme Yeterli Değildi
“+ ID sütunu kaldırıldı” satırına bakın. Cross-validation dürüst hale geldi (0.640, yeni veride 0.632), ki bu bir geçerlilik numarasından beklenen şeydir. Ancak holdout AUC yalnızca 0.632’ye ulaştı çünkü diğer üç sorun hâlâ oradaydı.
Eksik değer göstergesi lojistik regresyon için tek başına en büyük kazancı sağladı (0.564’ten 0.670’e). Bölgenin kategoriye çevrilmesi de yardımcı oldu (0.624’e). Tarihin ayrıştırılması biraz yardımcı oldu (0.585’e). Ancak ancak dört düzeltme birlikte 0.826’ya ulaştı; işte dürüst cross-validation puanının (0.833) ve holdout puanının nihayet örtüştüğü nokta burada.
Daha İyi Bir Model Bunu Kurtarabilir mi?
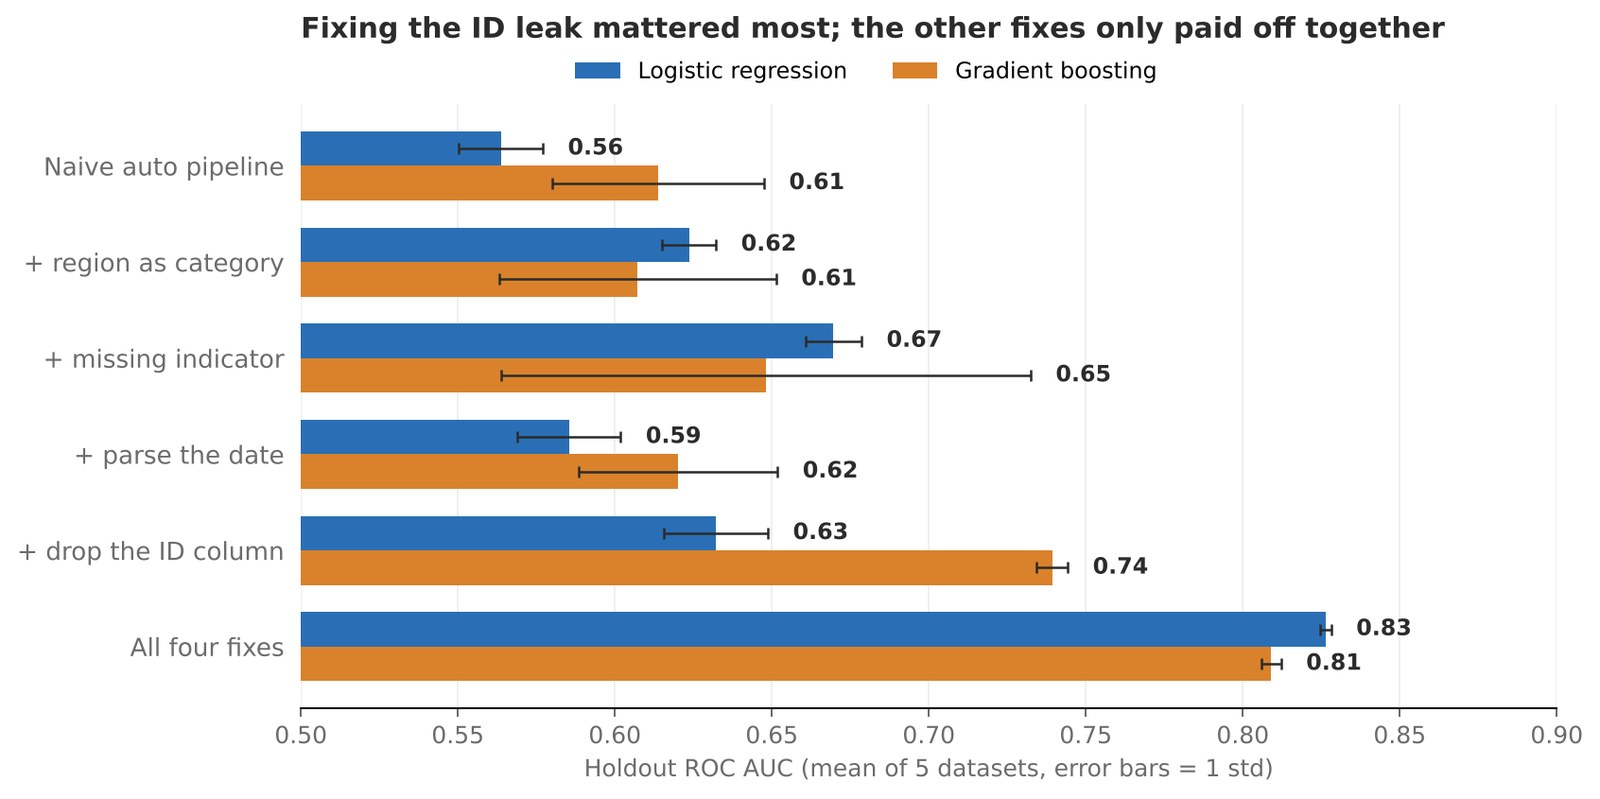
Güçlü bir model yalnızca naive (sefih) pipeline’ı kısmen kurtarır. Çizgiler 5 sentetik veri setinin ortalamasını; hata çubukları 1 standart sapmayı gösterir. (Kaynak: Yazar tarafından, python kullanılarak oluşturuldu)
Kısmen. Gradient boosting, naive pipeline’da 0.614 puan aldı; bu, logistic regression’ın 0.564 puanın biraz üzerindedir, ancak yine de zayıftır. ID sütununun kaldırılması en büyük katkıyı sağladı (0.739) ve dört düzeltme de 0.809’a ulaştı.
İki uyarı. Gradient boosting için bölge düzeltmesi (0.607), naive sonucun gürültü aralığında kalır; eksik-gösterici varyantı ise geniş bir yayılıma sahiptir (veri setleri boyunca std 0.084). Bu iki satıra tek başına bir anlam yüklemem. Sabit bulgu, ID etkisi ve tüm-düzeltmeler sonucudur.
Pipeline’a Kendini Kontrol Etmeyi Öğretmek
Kod bilmeyen insanlar için otomasyon kuruyorsanız, “sızıntı için kontrol ettiğinizi unutmayın” bir plan değildir. Kontroller kendi kendine çalışmak zorundadır. Yukarıdaki her tuzak istatistiksel bir parmak izi bırakır, bu yüzden modellemeden önce bir tabloyu tarayan ve düz İngilizce uyarılar veren bir fonksiyon yazdım:
python
import
numpy
as
np, pandas
as
pd
from
sklearn.metrics
import
roc_auc_score
def
audit_table
(df, target):
“””Bir dtype-tabanlı pipeline’ın göremediği tuzaklar için düz İngilizce uyarılar.”””
y
=
df[target].values
warns
=
[]
for
col
in
df.columns.drop(target):
s
=
df[col]
n_unique
=
s.nunique()
# 1. ID benzeri veya sıraya dayalı sızıntı sütunu
if
pd.api.types.is_numeric_dtype(s)
and
n_unique
>
0.95
*
s.notna().sum():
m
=
s.notna().values
auc
=
roc_auc_score(y[m], s[m])
if
abs
(auc
0.5
)
>
0.15
warns.append(
f
“‘
{
col
}
‘ neredeyse tamamen benzersiz ve hedefi baş başına tahmin ediyor “
f
“(AUC
{
auc
:.2f
}
satır sırasına göre). Büyük ihtimalle sızıntı yapan bir ID: bunu düşür.”
)
else
warns.append(
f
“‘
{
col
}
‘ neredeyse tamamen benzersiz. Bir ID’ye benziyor: düşürmeyi düşün.”
)
# 2. kategori gibi davranan sayısal sütun
elif
pd.api.types.is_numeric_dtype(s)
and
n_unique
<=
m
=
s.notna().values
x, yy
=
s[m].values, y[m]
r2_lin
=
np.corrcoef(x, yy)[
]
means
=
pd.Series(yy).groupby(x).transform(
“mean”
).values
r2_cat
=
((yy
means)
).sum()
/
((yy
yy.mean())
**
).sum()
if
r2_cat
r2_lin
>
0.02
warns.append(
f
“‘
{
col
}
‘
{
n_unique
}
ayrı sayısal değere sahip ve etkisi düz bir çizgi değil “
f
“(değer başına ortalamalar
{
r2_cat
:.1%
}
‘ini açıklıyor hedefe karşı
{
r2_lin
:.1%
}
bir sayı olarak). “
f
“Kategori gibi işlemeyi deneyin.”
)
# 3. bilgilendirici eksiklik
if
s.isna().any():
miss
=
s.isna().values
gap
=
abs
(y[miss].mean()
y[
~
miss].mean())
if
gap
>
0.10
warns.append(
f
“‘
{
col
}
‘
{
miss.mean()
:.0%
}
zaman, ve hedef oran “
f
“
{
gap
:.0%
}
şeklinde farklılık gösterdiğinde eksik değer göstergesi ekleyin.”
)
# 4. yüksek kardinaliteli metin
if
not
pd.api.types.is_numeric_dtype(s)
and
n_unique
>
warns.append(
f
“‘
{
col
}
‘ ,
{
n_unique
:,
} benzersiz değere sahip metindir. One-hot kodlama gürültüyı ezberleyecektir. “
f
“Bu değeri ayrıştırın (ör. tarihleri yıla çevirin) veya kaldırın.”
)
return
warns
def
gap_warning
(cv_score, holdout_score, tol
=
0.05
):
if
cv_score
holdout_score
>
tol:
return
(
f
“Çapraz doğrulama (
{
cv_score
:.2f
}) ,
{
holdout_score
:.2f
}) değerinden çok daha yüksek. “
f
“Sızıntı veya ezberleme şüphesi.”
)
return
“Çapraz doğrulama ile holdout uyumlu.”
Audit Uyarısı (Kaynak: Yazar tarafından, python kullanılarak oluşturuldu)
İşlevden ikinci olan gap_warning(0.979, 0.564), başlık sorunu doğrudan yakalar: “Çapraz doğrulama (0.98) , 0.56 değerinden çok daha yüksek. Sızıntı veya ezberleme şüphesi.”
Mesele bu eşiklerin mükemmel olması değil. Şu ki, kod bilmeyen biri sızıntılı bir ID’nin nasıl göründüğünü bilmek zorunda değildir, çünkü araç bunu bir cümle içinde bildirir.
Bu Yaklaşımın Yetersiz Kaldiği Yerler
-
Tek sentetik veri kaynağı. Tüm sonuçlar, tarafımdan yazılmış tek bir üreteçten gelir. Etkilerin yönü aktarılabilir, ancak boyutlar gerçek veride farklı olacaktır. Düzeltme: aynı varyantları iyi bildiğiniz bir gerçek tabloda çalıştırın.
-
ID sızıntısı yerleştirilmiş ve abartılmıştır. Başarısızlığın görünür olması için ID’yi sonuca güçlü şekilde korelasyon gösterecek biçimde kurdum. Gerçek sızıntılar genellikle daha zayıftır. Bu, ihracat sırası veya zaman ile sonuca korelasyon gösteren tanımlayıcıların gerçek örüntüsünün yerini tutar. Düzeltme: modellemeden önce benzeri ID veya benzeri zaman damgası sütunlarının hedefle ilişkisini kontrol edin.
-
Sadece iki model ailesi. Diğer modeller farklı tepki verebilir. Düzeltme: kendi modelinizle tekrarlayın ve gelecekteki verinizin nasıl ulaşacağını yansıtan bir ayırık (holdout) kullanın.
-
Bazı sonuçlarda dağılım. Gradyan güçlendirmenin eksik-gösterge ve bölge numaraları gürültülüdür. Düzeltme: tek bir değişim hakkında sonuç çıkarmadan önce daha fazla tohum (seed) değeri veya tekrarlı CV kullanın.
-
Denetleyici, aynı sentetik veri üzerinde kurulmuş ve test edilmiştir. Dört tuzak güçlü ve temizdir, bu nedenle tespit kolaydır ve gerçek tablolar üzerinde yanlış alarm oranlarını test etmedim. Gerçek veri, insan kararı gerektiren uyarılar tetikleyecektir (işaretlenmiş bir ID zararsız olabilir, eğrik bir kategori gerçek olabilir). Düzeltme: uyarıları bir bakış için işaret olarak karşılayın, otomatik düzeltme olarak değil ve eşikleri kendi verinizde ayarlayın.
Otomasyona Güvenmeden Önce Beş Soru
-
Gelecek veriye benzeyen bir ayırım var mı? Doğrulama, veri sızması eğitim verisinde varsa eğitim verisindeki sızmayı yakalamaz. Ayırımı, yeni verinin gerçekten nasıl ulaşacağını düşünerek (zamana göre ya da ayrı bir dışa aktarımdan) kurun.
-
Model hangi sütuna en çok güvenir? En üstteki katsayılara ya da permütasyon önemlerine bakın. Eğer en üstte bir kimlik, satır numarası ya da zaman damgası varsa durun.
-
Bir sayısal sütun gerçekten kategori mi? Kodlar, posta kodları ve bölge kimlikleri nicelik olmayan sayılardır.
-
Eksik değerler rastlantısal mı? Bir sütunun eksik olduğu durumdaki hedef oranıyla mevcut olduğu durumdaki oranı karşılaştırın. Farklılarsa bir eksik göstergesi ekleyin.
-
Binlerce benzersiz değere sahip metin sütunları var mı? Tarihler, adlar ve serbest metin kendi işlenişini gerektirir; tek seferlik kodlama (one-hot encoding) değil.
Otomasyon Doğrulama Değildir
Sekiz satırlık bir boru hattı iyi bir başlangıç noktasıdır, kötü bir durak noktası değildir. Bu deneyde 0.98 veren, yeni veride 0.56’ya düşen bu hat, dürüst bir 0.83’e ulaşmak için tek değil, dört ayrı düzeltme gerektirdi. Otomasyon tasarruf sağladı ama kontrolü yapmadı, ben de kontrolü otomasyona ekledim. Kendi bu sorunları tespit edemeyen insanlar için araç kuruyorsanız, eklemeniz gereken kısım burasıdır.
Boru Hattı için Jupyter Notebook
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.