
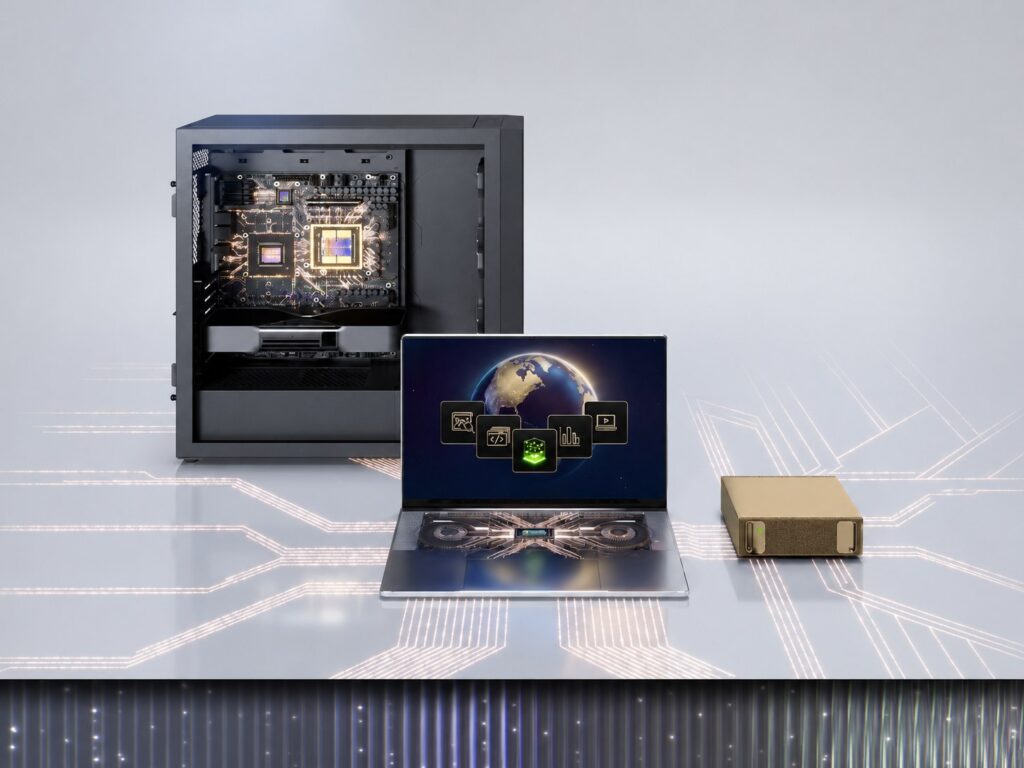
Nvidia, DGX Spark AI mini bilgisayarına GTC Berlin’de duyurduğu bir dizi yükseltme ile 23 Ekim’de satışa çıkacak olan daha önce açıklanan 64 GB’lık DGX Spark modellerinden birkaç gün sonra bu geliştirmeleri sundu. Şirkete göre, her biri 128 GB birleşik belleğe sahip sekiz DGX Spark sistemi toplamda 1 TB bellek sağlayabilir. Benzer şekilde, yeni 64 GB varyantlardan kurulan kümeler 512 GB’a kadar kapasite sunabilir.
Nvidia, ek belleğin daha büyük AI modellerini, daha uzun bağlam pencerelerini ve eşzamanlı çalışan birden fazla AI ajanını destekleyebileceğini belirtiyor. Şirket, 1 TB yapılandırmadan faydalanabilecek önyüz sınıfı modellerden biri olarak özellikle GLM 5.3’ü öne çıkarıyor.
Sistemler, dahili ConnectX-7 ağ donanımını kullanarak iletişim kuruyor. Ancak Nvidia, sekiz sistemlik kümelerin şu anda manuel yapılandırma gerektirdiğini söylüyor. Nvidia Sync yardımcı programının bu ayın ilerleyen günlerinde sekiz sistemli yapılandırmalar için destek alması planlanırken, buna yeni bir Model Launcher özelliği de eşlik edecek. Bu ikinci özellik, uyumlu modellerin indirilmesini, bağlı sistemler üzerinde dağıtılmasını ve OpenCode gibi kodlama araçları üzerinden erişilmesini kolaylaştıracak.

DGX Sparks, Qwen3.8 27B ile yüzde 30’a kadar hız kazanırken, DGX Station GLM 5.3 Flash ile yüzde 20’ye kadar daha yüksek veri işleme hızına ulaşıyor. Nvidia, llama.cpp ve vLLM topluluklarıyla birlikte geliştirilen yazılım seviyesinde çıkarım optimizasyonlarını da onayladı. RTX PRO 6000 Blackwell’in ise spekülatif kodlama iyileştirmeleri sayesinde Qwen 3.8 Flash ile ajansal görevleri yüzde 40’a kadar daha hızlı tamamladığı bildiriliyor.
Bu rakamlar genel performans artışlarını değil, belirli modeller ve iş yüklerini kapsıyor. Nvidia, duyurusunda karşılık gelen sekiz sistemli ölçeklendirme ölçümleri sağlamadığı için, daha büyük kümelerin zorlu iş yüklerini ne kadar verimli işlediği hâlâ belirsiz.
Son olarak Nvidia, Qwen3.8 Flash Next FP4 ve GLM 5.3 Flash FP4 varyantlarını da içeren, bellek optimize edilmiş yeni bir AI model nokta dizini koleksiyonu tanıttı. Bunlar, bellek tüketimini azaltırken KV önbelleği için daha fazla alan açmayı hedefliyor; bu da özellikle uzun bağlam pencereli modeller çalıştırılırken büyük önem taşıyor. Arada, yakında gelecek 64 GB’lık DGX Spark sistemleri GB10 Grace Blackwell Superchip’i koruyor ve 4.999 dolardan başlıyor. 128 GB’lık varyantın az önceye kadar ne kadar tuttuğunu düşününce ilginç.
Kaynaklar
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.