

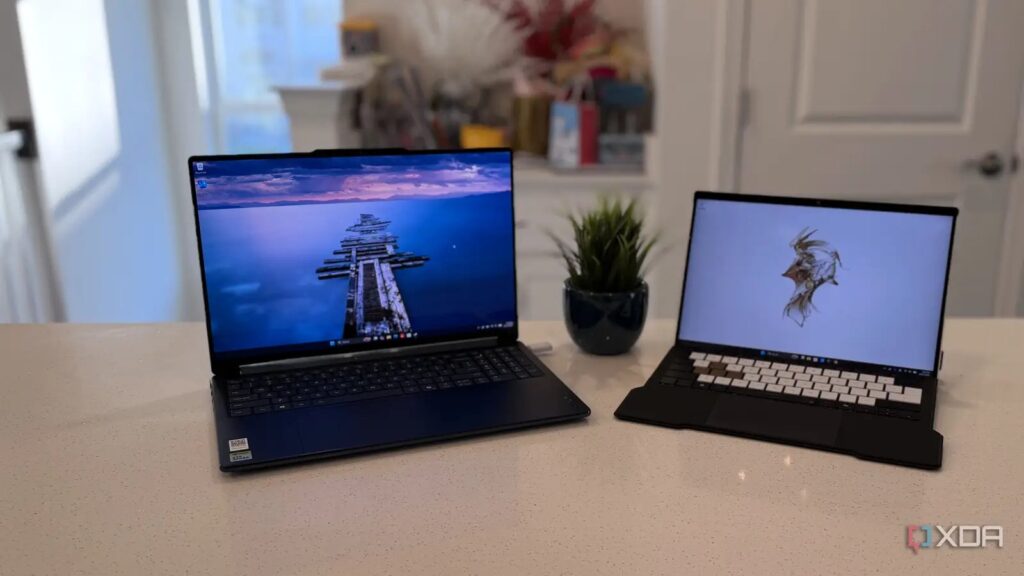
Strix Halo, iki yılı aşkın süred Nvidia‘ın cevaplamadığı bir soruya yanıt veriyor: Masaüstü GPU‘su olmadan bir Windows dizüstü bilgisayarda büyük yerel AI modellerini nasıl çalıştırırsınız? AMD’nin Ryzen AI Max+ 395’i, güçlü bir entegre GPU’yu 128 GB’a kadar birleştirilmiş bellekle birleştiriyor; bir Strix Halo mini bilgisayarin yerel olarak içerik üretebilmesi için yeterli bu miktar, ve Asus ROG Flow Z13 de benim taşınabilir yerel AI makinem oldu. Ardından Nvidia, RTX Spark’ı başlattı; bolca Blackwell GPU çekirdeği ve sürpriz olarak işletim sistemi olarak Windows on Arm ile.
Üstüne
XDA

ekleyin Google’da
Tercihli Kaynak olarak ekleyin
Google Discover’da takip edin
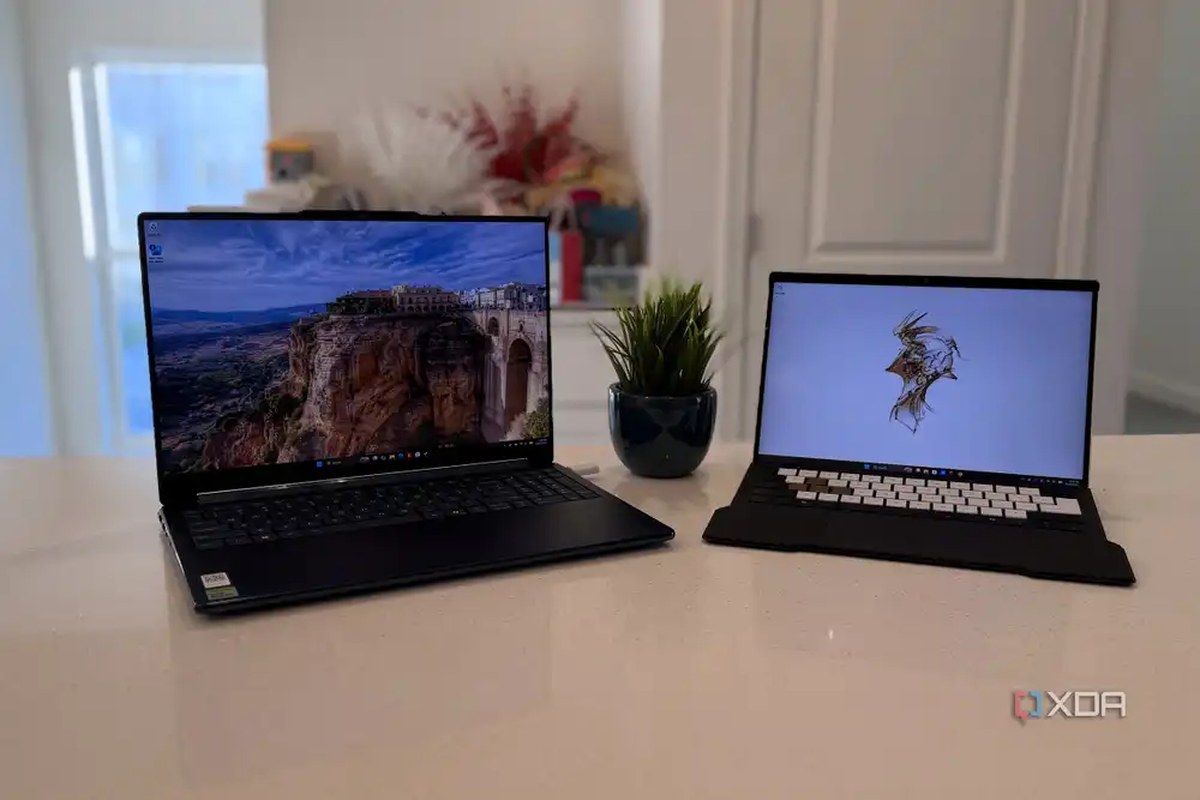
Yani 64GB’lık bir RTX Spark dizüstü bilgisayarı, aynı yerel AI işlerinde 128GB’lık Z13’ümle karşılaştırdım. Spark neredeyse her şeyi kazandı. Ama AMD’nin endişelenmesinin sebebi hız değildi. Sebebi log’larda yatıyordu.
İki dizüstü bilgisayar, aynı modeller ve Smart App Control açık
Her çip kendi yerel GPU yığını çalıştı: Spark’ta CUDA, Z13’te ROCm
Nvidia tarafı, yapılandırıldığı şekilde 3.750 $ fiyatla RTX Spark N1X ve 64GB bellekle bir Lenovo Yoga 9n. AMD tarafı ise Ryzen AI Max+ 395 ve 128GB’lık, 3.300 $ fiyatla benim Asus ROG Flow Z13’üm. İkisi de Windows 11 çalıştırdı ve Smart App Control açık ve zorunluydu, çünkü AI araçlarının çalışması için bir Windows güvenlik özelliğini kapatmayacaktım.
|
Lenovo Yoga 9n |
Asus ROG Flow Z13 |
|
|---|---|---|
|
Çip |
Nvidia RTX Spark N1X |
AMD Ryzen AI Max+ 395 |
|
Bellek |
64GB birleştirilmiş |
128GB birleştirilmiş |
|
GPU bellek ayrımı |
32GB GPU / 32GB sistem |
96GB GPU / 32GB sistem |
|
Ölçülü bant genişliği |
300GB/s |
256GB/s |
|
Yapılandırıldığı şekilde fiyat |
$3,750 |
$3,300 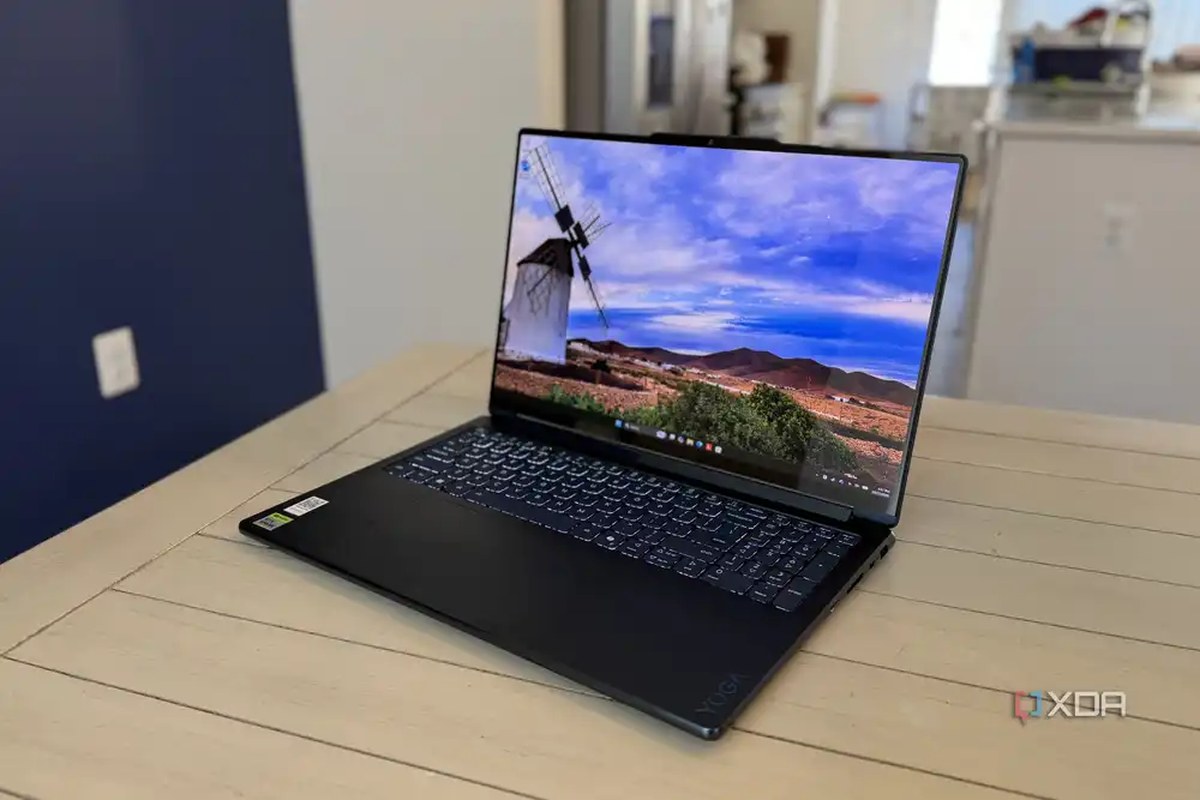 |
Her LLM testi, özdeş model dosyaları, 16K bağlam ve test başına üç çalıştırma üzerinden Ollama 0.40.8 üzerinden çalıştırıldı. Ollama, Spark’ta CUDA’yı ve Z13’te ROCm’i kendiliğinden seçti, böylece her çip kendi yerel GPU yığında çalıştı. Görüntüler ComfyUI üzerinden, her iki cihazda da aynı FLUX.2 Klein 4B dosyaları, ayarlar ve seed değerleriyle geldi. Her dizüstü bilgisayar üreticisinin en üst güç modunu çalıştırdı: Z13’te Turbo, Lenovo’da Performance.
RTX Spark, her iki dizüstü bilgisayarda da sığan her testi kazandı
Belgelerimi 3.5’e kadar hızla okudu ve yanıtları 1.6’ya kadar hızla yazdı
Yerel AI hızı iki yarıdan oluşur. İstem işleme, modelin size verdiği şeyi ne kadar hızlı okuduğu; jeton üretimi ise geri ne kadar hızlı yazdığıdır. Üç modele The Time Machine’in ilk 40.000 karakterini, yaklaşık 9.600 jetonu besledim ve bir özet istedim.
Spark bu belgeyi 2.1x ile 3.5x arasında daha hızlı okudu ve bunu hissediyorsunuz. Qwen3.8 27B, Spark’ta 12 saniye sonra yanıtlamaya başladı ve Z13’te 31 saniye. En büyük fark gpt-oss 20B’de geldi: saniyede 5.616 jeton, 1.589’a karşı.
Üretim daha yakındı ama yine net bir kazandı: üç modelin tamamında 1.4x ile 1.6x arasında daha hızlı. Qwen3-Coder 30B, Spark’ta saniyede 69.7 jeton yazdı, Z13’te 50.7.
Görüntü üretimi, bitirme süresinde en büyük açığı gösterdi
FLUX.2 Klein 4B, Spark’ta 1024×1024 görüntü başına 25.8 saniye, Z13’te ise 66.3 saniye aldı. Bu, özdeş dosyalar, adımlar ve seed değerlerinde 2.6x’lik bir açık ve çalıştırdığım herhangi bir işin bitirme süresindeki en büyük fark. Aynı görüntü, aynı 20 adım ve Z13 her birinde ek 40 saniye harcadı.
Şarjdan çıkarıldığında açık daha da açılıyor
Pille çalışırken, Spark hiç yavaşlamadı ve sekiz çalıştırma boyunca saniyede 71.4 jetonu korudu. Z13, şarja takılı sonuçundan %17 düşerek saniyede 42 jetona indi; bunun bir kısmı Asus’un pilde Turbo’yu kilitleyip Performance modunu bırakmasından kaynaklanıyor. Lenovo Performance modunu koruduğu için, Spark’ın şarjdan çıkarıldığındaki farkı yaklaşık 1.4x’ten 1.7x’e büyüyor.
Bellek bant genişliği açığı açıklamaz ve bu CUDA’ya işaret eder
RTX Spark, kağıt üzerinde %17 daha fazla bant genişliğine sahip ancak 61’e kadar daha hızlı yazıyor
Bu tür çiplerde jenerasyon hızı çoğunlukla bellek bant genişliğine bağlıdır. Nvidia’n RTX Spark aktarım kılavuzu 300 GB/s belirtirken, AMD Ryzen AI Max+ 395 için bu değer 256 GB/s olarak ölçülüyor. Bu, Nvidia için 1,17 katlık bir avantaj demek. Bu çiplerin mini PC sürümlerini artık bir yıldan fazla bir süredir kullanıyoruz ve biriktirilmiş bellekten çokça yararlanacağınız görev türlerinde gerçekten başarılılar.
Spark, metni 1,37x ile 1,61x arasında bir hızla üretti; bu, o bant genişliği açığının öngördüğünden çok daha fazlası. Kağıt üzerindeki donanım bu farkı açıklayamaz ve bu da yazılıma işaret ediyor: bir tarafta CUDA, diğer tarafta ROCm. O 300 GB/s değeri belki de cömert bir tahmin, çünkü Nvidia GB10 çipini kendi DGX Spark’ında 273 GB/s olarak listeliyor; bu da açığın geride kalan kısmını yazılıma bırakıyor.
AMD’nin kendi AI yığını bile CUDA konuşmak zorunda
Rakip için endişe verici kısım bu. ROCm, Z13 üzerinde çalışıyor: Ollama’nın günlüğü, Radeon 8060S üzerinde kendi paketli ROCm 7.1 kütüphaneleriyle çalıştığını gösteriyor. Ancak Z13’te açık ComfyUI’nin sistem bilgisine baktığınızda, PyTorch’un ROCm sürümü GPU’yu şöyle tanımlıyor:
PyTorch Sürümü: 2.12.0+rocm7.14.0
cuda:0 AMD Radeon(TM) 8060S Graphics: native (cuda)
Bu, tasarım gereği. PyTorch’un dokümantasyonu, ROCm sürümünün “mevcut torch.cuda arayüzlerini bilinçli olarak yeniden kullandığını” söylüyor; bu nedenle Nvidia için yazılan kod, AMD üzerinde neredeyse hiç değişiklik gerekmeden çalışıyor. Akıllıca bir geçici çözüm ama ben bunu şöyle okuyorum: AMD’nin AI yığını, kendini Nvidia’nınmış gibi sunuyor.
AMD destekli Lemonade daha kötü bir sonuç aldı. Yükleyicisi imzalıydı, ancak ilk kullanımda indirdiği llama.cpp ROCm arka ucu, Windows’un doğrulayamadığı bir CPU kütüphanesini yüklemeye çalıştı ve Smart App Control bunu engelledi. Bu, benim aday sürüm yapılandırmalarını çalıştırmamdan kaynaklanıyor ama asıl olarak winget ile ya da Lemonade’den MSI indirerek elde edeceğiniz sürüm bu, dolayısıyla belirtilmesi yerinde bir nokta.
Model hiç yüklenmedi. Bu arada, Spark üzerindeki ComfyUI, DynamicVRAM bellek yöneticisini ve Nvidia’nın kendi yönetim kütüphanesi NVML izlemeyi, hiçbir istek olmadan açtı ve AMD arka ucunu “PyTorch ROCm/HIP runtime not available” olarak bildirdi.
Windows on Arm, Spark’ın bu hakkı kazanmasını yine de sağlıyor
Nvidia tarafında bunların hiçbiri kolay olmadı. Windows on Arm için ComfyUI, yalnızca Nvidia GPU’larını destekleyen bir beta sürümü ve Z13’e sürüm dağıtımı (release) geldiğinde, kendi üzerinde gece yapısı (nightly) PyTorch çalıştırıyor. Yine de şablonu çalıştırmak, hiçbir geçici çözüm olmadan her ikisinde de yaklaşık beş dakika aldı. Arm için daha büyük uyarılar başka yerlerde, ancak Nvidia her uygulamanın çalışacağını vaat ediyor; ne zaman olacağına dair ise bir zaman çizelgesi vermiyor.
Strix Halo yine bir turu kazanıyor ve bu, 128GB gerektiren tur
Z13, 64GB’lik Spark’ın yükleyemediği 120B modeli çalıştırdı
OpenAI’nin gpt-oss 120B modeli, Ollama’da yaklaşık 60GB bellek gerektiriyor. Z13 onu tamamen GPU’ya yükledi ve saniyede 31,7 token hızında yazdı; bu, bir tablette 120B bir model için gerçekten kullanışlı bir hız. Yaklaşık 46GB’ı CUDA’ya açıkta olan Spark ise şanssızdı:
llama-server, başlatma sırasında bellek yetersizliği bildirdi: cudaMalloc failed: out of memory
kv cache için tampon ayrılamadı
Bu, 64GB yapılandırmasının bir sınırı, çipin değil. CUDA, denediğim iki GPU bellek ayrımında da yaklaşık 46GB gördü, dolayısıyla farklı bir ayrımın onu kurtarması pek olası değil. 128GB’lık bir RTX Spark mevcut ama fiyatı çok daha yüksek.
|
Dizüstü |
Bellek |
Fiyat |
|---|---|---|
|
Asus ROG Flow Z13 |
$3.300 |
|
|
Lenovo Yoga 9n |
64GB |
|
|
Asus ProArt P14 |
Z13, Yoga’nın sunduğu belleğin iki katını, 450$ daha ucuza sunuyor. 128GB’a RTX Spark üzerinde eşitlemek, ProArt P14’ü 6.500$ fiyatıyla karşınıza çıkarır; bu da neredeyse iki katı, üstelik bu arada daha pahalı bir ProArt sınıfı makine.
AMD’nin sorunu Strix Halo değil, etrafındaki her şey
Her iki dizüstü bilgisayara da sığan her işleve RTX Spark, 40 ile 60% arasında bir sürede tamamlayordu; duvara kadar ölçtüğüm tek işlevde ise yaklaşık yarısı kadar enerji tüketiyordu. Görüntü üretimi 2,6 kat daha hızlıydı. Ve nesil farkı, bant genişliği özelliklerinin açıkladığından daha büyüktü; bu da beni sürekli yazılıma geri götürüyor. Bu bir çip sorundan ziyade bir ekosistem sorunu.
Elbette Strix Halo’nun gerçek avantajları var. Z13, 64GB’lık Spark’ın çalıştıramadığı modelleri çalıştırır, daha ucuzdur ve Spark’ın betalara ve günlük sürümlere dayandığı yerde release (kararlı) sürümlerine ulaşır. Ancak PyTorch’un ROCm sürümü cuda:0 olarak kendini tanıttığında, herkesin hangi platform için derleme yaptığından haberdar olmak zor değildir.
Lenovo Yoga 9n 2’si 1 arada
İşletim Sistemi
Windows 11 for Arm
İşlemci
Nvidia RTX Spark N1X 18 Çekirdekli veya 20 Çekirdekli
Lenovo’dan $3000
Best Buy’dan $3750
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.