

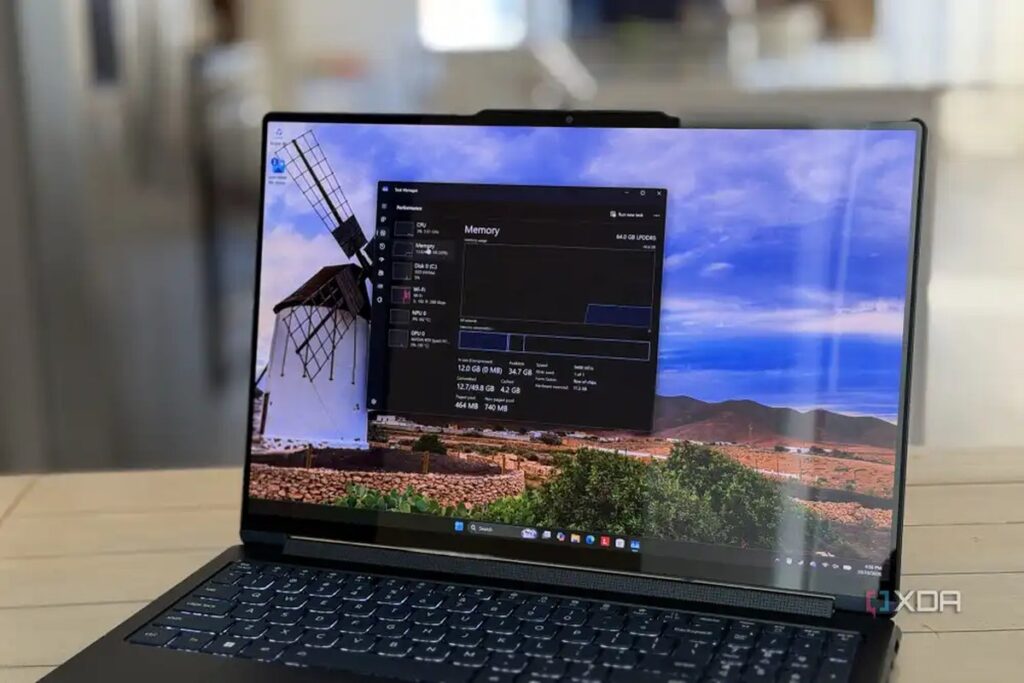
Nvidia, bu yıl başlarında RTX Spark‘ı duyurduğunda, öğrendiğimiz her şey bu çipin geçen yıl DGX Spark ile birlikte lanse edilen GB10 ile son derece benzer, hatta fiilen aynı olduğunu, tek farkın bu kez yalnızca Windows tabanlı makineler için mevcut olduğunu gösteriyordu. Geçtiğimiz birkaç hafta içinde RTX Spark’lı bir HP OmniBook Ultra 16 ile testler yürüttüm ve bu iddia özünde doğru olsa da, teknik özellik tablosundan daha derine baktığınızda bazı farklılıklar ortaya çıkıyor.
Google‘da XDA ekleyin
Tercihli Kaynak Olarak Ekleyin

Google Discover’dan Takip Edin
Yaptığım testlerde, HP’nin laptopunun ve Nvidia’nın DGX Spark’ın aynı SoC kimliğini, aynı CPU çekirdeklerini, aynı GPU’yu ve aynı bireysel register adreslerini içeren aynı donanımı betimleyen aynı firmware’i raporladığını gördüm. Ancak pratikte önemli farklılıklar da var. RTX Spark yalnızca belleğini daha hızlı çalıştırmakla kalmıyor, aynı zamanda GB10 kartlarının açık bıraktığı donanımı da firmware aracılığıyla etkinleştiriyor. Üstelik Windows, paylaşımlı bellek havuzunu Linux’tan oldukça farklı şekilde yönetiyor.
Her iki cihazda da aynı GPU ve CPU testlerini kullanarak performans ölçümleri yaptığımızda, hesaplama farkı çoğu zaman bir ya da iki yüzde puanı içinde kalıyor. Fark oluştuğunda ise genellikle laptop önde çıkıyor, özellikle bellek bant genişliğiyle sınırlı görevlerde. Ve yerel LLM’leri çalıştırırken bellek bant genişliği son derece kritik önem taşıyor.
RTX Spark ve GB10 aynı yongayı kullandıklarını söylüyor
Bellek haritasının en sonuna kadar
Açık ara ilk adım, bu iki çipin birbirini aynı şekilde tanımlayı-tanımlamadığını kontrol etmekti ve öyle. İkisi de kendilerini SoC revizyonu 0x04268901 olarak gösteriyor, ikisi de on Arm Cortex-X925 performans çekirdeği ve on Cortex-A725 verimlilik çekirdeği içeriyor ve bu çekirdekleri aynı sırada, eşleşen 8 MB ve 16 MB L3 önbellekleriyle birlikte iki küme arasında bölüşüyor. GPU’ları da birebir aynı özellikleri raporluyor: 48 SM, CUDA hesaplama yeteneği 12.1, 24 MiB L2 önbelleği ve 3.003 MHz maksimum saat hızı. Nvidia’nın sürücü kodu her ikisini de aynı şekilde yönetiyor ve şirketin açık kaynaklı kernel sürücüsü GB10’nin GPU’sunu dahili olarak GB20B olarak tanımlıyor; bu da RTX Spark’ın kullandığı aynı tanımlayıcı.
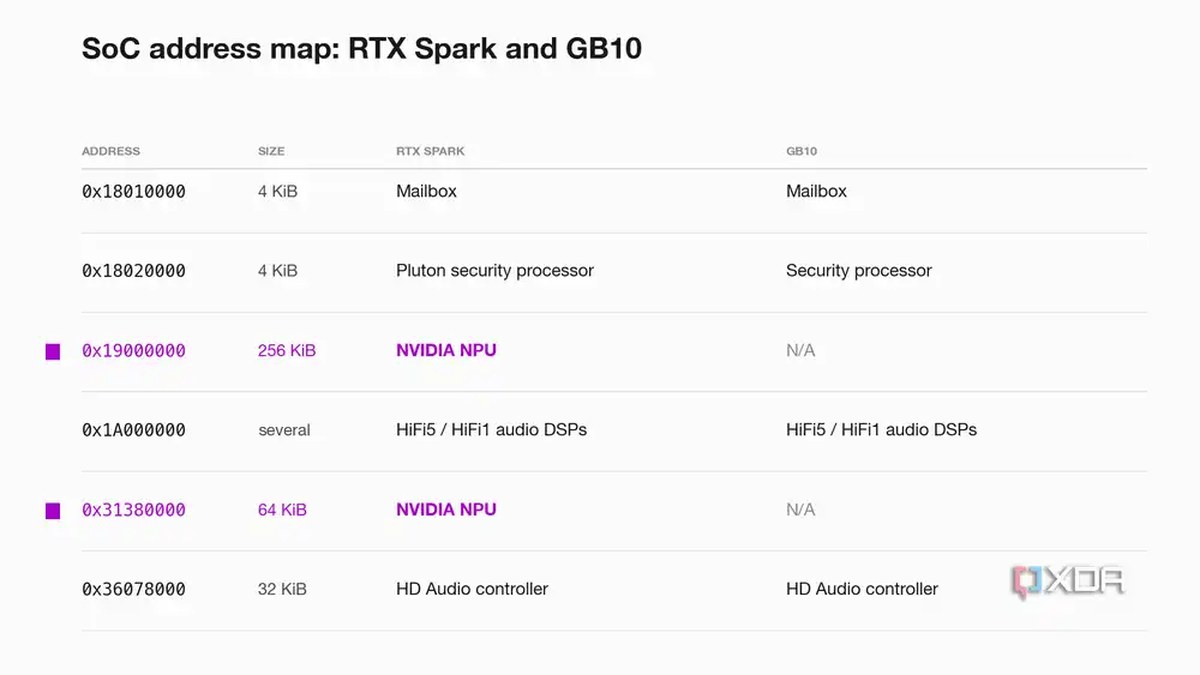
Firmware tarafında da benzer bir tablo var: iki cihaz da SoC’nin yongadaki çevre birimlerini aynı fiziksel adreslerde tanımlıyor, h ACPI tablolarında neredeyse birebir aynı aygıt isimlerini kullanıyor ve işletim sisteminin donanımı tanıması ve nasıl kullanacağını bilmesi için asıl aktardıkları da bunlar. Lenovo’nun GB10 firmware’i ile HP’nin RTX Spark firmware’i, NH1X olarak adlandırdığı bir aygıttan bahsediyor; bu isim “N1X”e oldukça benziyor. Üzerine sürücü bağlanmadığı ve hiçbir makinenin buna kaynak atamadığı için bunun ne olduğunu tespit edemedim.
PCI aygıt tanımlayıcıları da bu yorumla örtüşüyor: GB10’nin GPU’su 10DE:2E12, RTX Spark’ın GPU’su ise 10DE:2E03 olarak tanımlanıyor. Üstelik Nvidia’nın yayımladığı aktarım kılavuzunda, RTX Spark’ın masaüstü varyantı 10DE:2E13 olarak listeleniyor; bu, GB10’dan yalnızca bir hex basamağı uzakta. Bu bir ispat değil, ancak iki cihaz arasındaki her şey oldukça düzgün bir şekilde örtüşüyor.
Bu bilgilerden şu an için söyleyebileceğimiz, Nvidia’nın tek bir çip tasarımıyı iki farklı isimle pazarladığı, ancak hangi parçaların bu iki SKU’dan yongadan kesildiğini söyleyemiyoruz. Aslında gözlemlediğim başlıca farkların tamamı, her kartın firmware’inin ve işletim sisteminin neyi kullanmayı seçmesinden kaynaklanıyor.
Dizüstü bilgisayarda daha hızlı bellek var ve bu ortada
9.400 MT/s’ye karşı 8.533
Her iki makinede de 256-bit veri yolunda 128GB LPDDR5X bulunuyor, ancak farklı hızlarda çalışıyorlar. HP OmniBook Ultra 16’da bellek 9.400 MT/s hızında çalışırken, DGX Spark 8.533 MT/s’ye sahip. RTX Spark’ta yaklaşık 300 GB/s teorik bant genişliği, GB10’da ise 273 GB/s söz konusu ve bu fark en çok bellek bant genişliğini doyuran işlemlerde belirginleşiyor.
Bu açık, aslında bu sayıların ima ettiğinden daha büyük. 2 GB’lık bir tampon üzerinde bir GPU okuma testi gerçekleştirdim; RTX Spark’ta 282,9 GB/s, GB10’da 239,8 GB/s kaydettim, bu da teknik özellik tablosunun öngördüğü %10’luk fark yerine laptop için %18’lik bir öne geçiş demek. RTX Spark, teorik bant genişliğinin %94’üne ulaştı, PGX ise ancak %88’ine çıkabildi.
Bunun, her işletim sisteminin GPU belleğini ayırma yönteminden kaynaklandığını varsaydım, ancak 2 MB’lık sayfalar kullanılarak açıkça ayrılan bir tamponla testi her iki makinede de tekrarladım ve yine sonuç alamadım. Bu test RTX Spark’ta 281 ile 285 GB/s, GB10’da ise 243 ile 244 GB/s verdi ve neredeyse aynı açık ortada kaldı. Sayfa boyutu tek başına farkı açıklamıyor ve hız artışını bellek zamanlamaları, fabrika saatleri, sürücüler ya da başka bir şeye kadar indirgemeyi başaramadım.
Aynı durum CPU için de geçerli: Tek bir iş parçacığı STREAM üçlü testiyle her iki makinede de 45,0 GB/s çekebiliyor, ancak 20 çekirdeğin tamamı yüklendiğinde RTX Spark 142,5 GB/s’ye ulaşırken GB10 116,2 GB/s’ye ulaşıyor, bu da yaklaşık %23’lük bir artış. Burada bellek hızından daha fazlasının söz konusu olduğunu söyleyebiliriz, ancak bu testin işletim sisteminin zamanlayıcısındaki iş parçacığı yerleşimi gibi bir şeyle de ilişkilendirilebilir.
Geçirgenlik ise ters yönde değişiyor. Performans çekirdeğinden 1 GB’lık çalışma alanında bir işaretçi takibi testi yapıldığında, RTX Spark 134,5 ns kaydederken GB10 bu değeri 131,1 ns olarak ölçtü. Verimlilik çekirdeğine geçildiğinde ise RTX Spark belirgin şekilde geride kaldı: 204 ns’ye karşılık GB10 162 ns’ye ulaştı. Bu durumun bir kısmı şu ile açıklanabilir: hafıza ağı saat hızlarının hafif yüklemeler altında daha düşük bir saate tutulması ve güç yönetimi. Şirketin geliştirici forumlarında bir Nvidia mühendisinin, GB10’un verimlilik çekirdeklerinin 330 MHz’e kadar düşebileğini ancak performans yöneticisinin derin CPU uyku durumlarını etkili biçimde devre dışı bırakabildiğini açıkladığını gördüm. Bu, DGX’in daha düşük geçirgenliğini açıklamaya yardımcı olabilir.
Genel olarak yerel LLM’ler için asıl önemli olan bant genişliğidir, çünkü belirteç üretimi büyük ölçüde GPU’nun modelin ağırlıklarını hafızadan ne kadar hızlı okuyabildiğine bağlıdır. llama.cpp içinde Qwen 3.8 Flash Next, Q4_K_M’i nicemleyince, her belirteç için yaklaşık 4,6 GB ağırlık okunur; bu da ölçtüğüm bant genişliğine dayanarak RTX Spark için saniyede yaklaşık 58, GB10 için ise 49 belirteçlik teorik bir tavan belirler. OmniBook Ultra’da llama.cpp ve çoklu belirteç tahmini kullanarak gerçek kullanımda saniyede yaklaşık 45 belirteç alıyorum; aynı model DGX Spark’ta vLLM üzerinden sunulduğunda aynı ya da biraz daha düşük bir değere geliyor.
İkisi de ham hesaplamada daha hızlı değil; FP16 tensor verimliliği RTX Spark’ta 123,9 TFLOPS, GB10’da ise 124,3 TFLOPS olarak ölçülüyor. FP8 yaklaşık 250 TFLOPS, INT8 yaklaşık 250 TOPS ve FP32 ise 29,56 ile 29,83 TFLOPS arasında bir değere ulaşıyor. Nvidia’nın “1 PFLOP FP4” hedefine, 2:4 yapısal seyreltme kullanıldığında ulaşılabilir; GB10 1.002,7 TFLOPS’ye ulaşırken RTX Spark 989,6’ya ulaşıyor. Yoğun FP4 verimliliği her iki cihazda da bunun yaklaşık yarısındadır.
GeForce kartları tarihsel olarak FP16 tensor işlemlerini yarı hızda FP32 birikirme ile çalıştırır, bu yüzden sıradaki sınfmayı bunun üzerinde yapmak istedim. RTX Spark kendini bir GeForce ürünü olarak tanıtırken, GB10 Nvidia RTX olarak raporlar; ve bu kısıtlama her iki cihazda da geçerli değildir.
İki model arasındaki sürdürülebilir performans oldukça yakındı; 60 saniyelik bir FP16 yüklemesi sırasında her iki GPU da yaklaşık 2,52 ile 2,56 GHz arasında sabitlendi ve 44 ile 49 W arasında güç çekti. OmniBook’ta ortalamaya yakın 123 TFLOPS, DGX Spark’ta ise 124,6 TFLOPS değeri ölçüldü. Laptop aynı güçte 5 ile 10 derece daha sıcak çalıştı ve 71°C’ye ulaştı; ayrıca DGX Spark’ta olmayan bir davranış sergiledi. Bu testi tekrar tekrar çalıştırdığımda, RTX Spark’ın bazen yaklaşık %7 daha düşük skor aldığını gözlemledim.
Her iki çip de oldukça farklı güç tüketim değerleri için tasarlanmış durumda; Nvidia, GB10 için tüm SoC’ye 140 W TDP belirlerken, DGX Spark’ta 240 W’lık bir güç kaynağı bulunuyor. RTX Spark laptopları ise 45 ile 80 W arasında derecelendirilmiş durumda. Ancak RTX Spark’ın masaüstü varyantı, GB10’un 140 W değerini paylaşıyor. Ne yazık ki nvidia-smi üzerinden erişilebilir bir güç limiti bulunmuyor, bu yüzden HP’nin gerçekten ne yapılandırdığını göremiyorum. Bildiğim tek şey, sürdürülebilir CPU ve GPU testimde CPU’nun tam kapasiteyle çalışırken GPU’nun yaklaşık 48 W’tan 34 W’a düşmesiydi.
CPU kendisi oldukça ilginç; RTX Spark’ın X925 çekirdekleri GB10’daki 3,9 ile 4,0 GHz yerine 4,0 ile 4,1 GHz arasında yaklaşık 100 MHz daha hızlı çalışıyor. Tüm 20 çekirdek bir dakika boyunca yüklendiğinde, RTX Spark’ın performans çekirdekleri 3,86 GHz ile 4,0 GHz arasında istikrarlı bir hız sürdürdü. Bu sırada DGX Spark 3,86 ile 3,9 GHz arasında bir istikrar sağlayabildi. X925 üzerinde tek çekirdekli FP64 veri yolu RTX Spark’ta 97,3 GFLOPS, GB10’da ise 91,6 olarak ölçüldü; A725 çekirdekleri ise aynıydı.
Her iki sistem de CPU özelliklerinde biraz farklı değerler bildiriyor, ancak bu büyük ölçüde Windows’un Hyper-V üzerinde ve sanallaştırma tabanlı güvenlik etkinleştirilmiş şekilde çalışmasından kaynaklanıyor. Windows, GB10’daki Linux’un bildirdiği BTI, MTE ve diğer birkaç Arm uzantısını göstermiyor. Çekirdek tanımlama kayıtları aksi halde aynı ve hiçbir firmware’in CPU özelliklerini gizlediğine dair bir kanıt bulamadım.
Windows ve Linux paylaşımlı belleği oldukça farklı şekilde yönetir
Windows’ta bu bir ayrılma, Linux’ta ise herkesin serbestçe yararlanabildiği bir durum
RTX Spark ile GB10, CPU ve GPU arasında paylaşılan tek bir birleşik bellek havuzu kullanır; ancak bu belleğin nasıl ayrılması, Windows ile Linux arasında büyük ölçüde farklılık gösterir. GB10’da Linux çalıştırıldığında, CUDA’nın kullanılabilir sistem belleğinin tamamını raporlamasıyla GPU’nun gerekli durumda tüm havuzu kullanarak bellek ayırmasına olanak tanıyan tamamen serbest bir ortam söz konusudur.
Ancak RTX Spark üzerinde Windows’ta durum önemli ölçüde farklıdır; burada 96 GB’ya kadar bir kısım “özel” GPU belleği olarak ayrılır. CUDA, siz ne kadar ayırsanız ayırın, ayırma için her zaman 109.7 GB’ın tamamını görür; ancak bu, Windows’un sistem belleği olarak kullanabileceği miktarı değiştirir. Benchmark’ları çalıştırdığımda özel belleği 84.5 GB olarak ayarlamıştım ve Windows 41 GB sistem belleğinin kullanılabilir olduğunu raporladı.
GB10’nun UEFI’si de ekran için 2 GB bellek ayrılır ve bu bellek işletim sisteminin, CUDA’nın veya diğer uygulamaların kullanımına sunulmaz. OTA2610 güncellemesiyle bu değişti ve ayrılma 0.5, 1, 2, 4 olarak ayarlanabilir veya Otomatik olarak bırakılabilir. RTX Spark yazılımında buna karşılık gelen bir seçenek yoktur; bunu UEFI değişkenlerine bakarak doğruladım.
Sistem ayrılması eskiden 4 GB’dı ve Nvidia’dan bir mühendis, bunun bir yazılım güncellemesiyle 2 GB’a düşürüldüğünü belirtmişti. Lenovo ThinkStation PGX bu güncellemeye sahip değil; DGX Spark’taki 2 GB’a karşılık 4 GB ayrılmış bellek görüyor. Sonuç olarak, Linux PGX üzerinde 119.6 GiB’ı, DGX Spark üzerinde ise 121.7 GiB’ı görüyor.
Bu iki bellek modeli geliştiriciler için farklı davranır; örneğin, ana bilgisayar ile cihaz arasındaki bellek kopyalamaları RTX Spark üzerinde Windows’ta, Linux ile GB10’daki 59.4 GB/s’ye karşı 132.7 GB/s ile iki katından fazla hızlıdır. RTX Spark’ın GPU’su sabitlenmiş ana bilgisayar belleğini tam bellek bant genişliğine yakın olan 278.5 GB/s’de okuyabilir. Öte yandan Linux, GPU’nun CPU tarafından ayrılan sıradan belleği önce kaydetmeden okumasına olanak tanır ve benim testimde 168.3 GB/s’ye ulaşır; Windows bunu tamamen desteklemez. CUDA’nın yönetimli belleği, çalışma zamanının ayrılan belleklere CPU ve GPU erişimini yönettiği durumda da GB10’da daha hızlıydı: 103.0 GB/s’ye karşı 163.4 GB/s.
Birkaç CUDA özelliği de farklı biçimde karşımıza çıkıyor. DGX Spark, eşzamanlı yönetilen bellek erişimini ve sayılabilir belleğe doğrudan erişimi desteklediğini belirtse de, RTX Spark bunu desteklemiyor. Ayrıca Nvidia’nin RTX Spark aktarım kılavuzu, uyumluluk yolunun getirdiği performans maliyetleri nedeniyle geliştiricileri Windows’ta yönetilen bellek kullanmaktan vazgeçirmeye çalışıyor.
Bu iki çipin ikisi de, bir ağ kartı gibi bir PCIe aygıtının GPU belleğine doğrudan okuma ve yazma yapmasına olanak tanıyan GPUDirect RDMA’yı desteklemiyor; dma-buf da desteklenmiyor. Bu durum GB10 üzerinde daha şaşırtıcı, çünkü ConnectX-7’ye sahip olan odur; ancak Nvidia’nin DGX Spark aktarım kılavuzu bunu doğrularak nvidia-peermem ve GDRCopy’nin de çalışmadığını belirtiyor. Sorun, cudaMalloc ile ayrılan belleğin CPU veya PCIe aygıtları tarafından tutarlı biçimde erişilememesinden kaynaklanıyor; bu nedenle RDMA uygulamaları, yerel bellek yerine cudaHostAlloc ile ayrılan ve ağ kartına kaydedilmiş sabitlenmiş yerel arabellekleri kullanmak zorunda. Kümeleme çalışmaya devam ediyor; fark, RDMA aktarımlarının sıradan CUDA aygıt ayrımları yerine bu sabitlenmiş yerel arabellekleri kullanması.
Her kartın özellikleri yazılımla tanımlanır
Aynı tesisat, farklı anahtarlar
İki kart arasındaki en büyük farklar gerçekte platformın yazılımının neyi etkinleştirdiğiyle tanımlanıyor; USB-C bu konuda en belirgin örnek. GB10 destekli aygıtların teknik özellikleri tutarsız olsa da, Nvidia’nin DGX Spark aktarım kılavuzu USB 3.2 sürücü desteğini adlandırıp “dGPU ekleme”in desteklenmediğini söylerken, Lenovo’nun ThinkStation PGX için belirttiği teknik özellikler, güç giriş portunun “USB 20Gbps / USB4” olduğunu, diğer üçünün ise 20Gbps USB 3.2 Gen 2×2 olduğunu belirtiyor.
Aslında GB10 cihazlarımda gördüğüm şey USB 3.2 portları, oysa USB4 donanımı gerçekten var. DGX Spark’ın erken önyükleme logunu incelediğimde, özel bir USB4 firmware görüntüsünün yüklendiğini ve başlatıldığını görüyorum; hem ThinkStation PGX hem de DGX Spark’taki firmware dört USB4 yönlendirici tanımlıyor, her USB-C portu için biri, her biri kendi PCIe tünelleme portuyla eşleştirilmiş. Dördü de işletim sistemi başlamadan önce devre dışı bırakılıyor ve Linux portları, konuşacak bir USB4 bus’ı olmadan 20Gbps USB 3.2 Gen 2×2 denetleyicileri olarak devreye alıyor. HP’deki RTX Spark bu yönlendiricilerden ikisini devreye alarak Windows’un USB4 yığınını yüklemesini ve PCIe tünellemenin çalışmasını sağlıyor.
Sık sık, GB10’un PCIe hatlarının tükenmesini suçlayan bir açıklama görüyordum, çünkü ağ için çok fazla sayıya ihtiyaç duyuyor. Ancak Nvidia’nın GB10 için Hot Chips sunumu, Spark cihazlarının kümelemesi için kullanılan yüksek hızlı ConnectX-7 NIC’ine giden sekiz PCIe Gen5 hattını listeliyor; bu, SoC’nin her cihaz için x4’ten fazlasını sağlayamaması nedeniyle iki x4 bağlantısına bölünüyor. Bu USB4 tünelleme portları, USB4’e bağlanmış ayrı denetleyicilerdir ve bu harici PCIe bağlantılarını kullanmazlar. HP’nin dizüstü bilgisayarında ConnectX-7 yok, bir x4 bağlantısı kapatılmış ve diğeri SSD’yi taşıyor. Yanlarında çalışan iki USB4 PCIe tüneli de var.
Elbette fiziksel kablolamanın ne yaptığını yalnızca yazılımdan belirleyemem, ancak firmware veya işletim sistemlerinde bulduğum hiçbir şey USB4 tünellemenin ve ConnectX-7’nin aynı hatlar için rekabet ettiğini göstermiyor.
Bunların ikisini ayıran şey bunun yerine firmware. HP’nin firmware’inde USB4 bağlantı hızı ve PCIe tünelleme için port başına ayarlar var, ikisi de varsayılan olarak etkin ve BIOS menüsünde gösterilmeyen; bir USB4 yönlendiricisi ancak karşılık gelen portu USB4 için yapılandırıldığında devreye alınıyor. Nvidia’nın ve Lenovo’nun GB10 firmware’inde bu ayarlar hiç yok ve PCIe tünellemeyi devre dışı bırakan tablo her iki makinede de özdeş. Bunların tümü, Nvidia’nın referans firmware’inde alınmış bir karara işaret ediyor.
Bunun muhtemelen bir nedeni var: Linux. Nvidia’nin GB10 USB4 yönlendiricileri, AMD veya Intel’deki Thunderbolt ve USB4 denetleyicilerinde bulacağınız gibi PCI aygıtları değil. Bunun yerine, işletim sistemine ACPI üzerinden tanımlanan bloklar.
Linux’ta Thunderbolt ve USB4 sürücüsü tarihsel olarak ana yönlendiricinin bir PCIe aygıtı olduğunu varsayar, bu yüzden çekirdekte bu firmware ile tanımlanan denetleyicilere bağlanabilen hiçbir şey yoktur. Öte yandan Windows, bu tür bir yönlendirmeyi işleyebilecek bir sürücüye sahiptir.
Linux’ta PCIe olmayan USB4 ana bilgisayarları için destek hâlâ geliştirilme aşamasında ve Mayıs 2026’da Konrad Dybcio, sürücünün ana yönlendiricinin PCIe aygıtı olması gerektiğine dair varsayımını kaldıracak yamalar gönderdi. Bunlar, benzer bir sorunla karşı karşıya gelen denetleyicilere sahip bir Qualcomm Snapdragon X Elite referans tasarımında test edildi. Orada USB4 Windows üzerinde çalışırken, Linux desteği hâlâ geliştirilmektedir. DGX OS, Linux tabanlı olduğundan, GB10’un yönlendiricilerini etkinleştirmiş olsaydım bile, mevcut USB4 sürücüsü bunu kullanamazdı.
USB4’ün devre dışı bırakılması yine de Nvidia’nın yaptığı bir seçimdi; çünkü şirket kendi sürücüsünü yazabilirdi. Ancak Linux desteğinin mevcut durumu göz önüne alındığında, anlaşılır bir seçim. GB10’un kendisinde USB4 donanımında bir sorun olmadığına dair bir kanıt bulamadım, ancak ek platform veya firmware sınırlamalarını da hariç tutamam.
Gigabyte RTX 4080 ile Plugable Thunderbolt 5 muhafazasının bağlanması ise başka bir sınırlamayı daha ortaya çıkarıyor. Bu kurulumda, PCIe tüneli oluştu ve kart 40Gbps’lik bir USB4 bağlantısı (Gen 3, çift şerit) üzerinden Gen4 x4 üzerinde numaralandırıldı bile. Windows bunu görebiliyordu… ancak kullanamıyordu. Nvidia’nın Arm64, yalnızca RTX Spark’ın kendi aygıt kimliklerini hariç tutan diğer GPU’ları desteklemediğinden, Windows temel uyarlama sürücüsüne geri dönüyor; bu da Code 10 hatası ve “Başlatılmaya çalışılan sürücü, POST edilmiş ekran kartının sürücüsüyle aynı değil” mesajıyla başlatılamıyor. Günümüzde bir eGPU kullanmak için Arm64 sürücülerine ihtiyaç var ve GB10 makinesinde PCIe tüneli oluşabilecek noktaya bile ulaşamıyorsunuz.
NPU konusuna gelince, RTX Spark, Nvidia’nin Deep Learning Accelerator’ının bir tür halefi niteliğinde bir şey ortaya koyuyor; Cihaz Yöneticisi’nde “NVIDIA NPU” olarak, nvidia-smi’de ise ikinci bir cihaz olarak görünüyor. Üzerinde gerçek ağları çalıştırabildim ve doğru sonuçlar aldım; ancak GB10 böyle bir karşılık cihazı sunmuyor. Donanım yazılımı, Linux’un bulabileceği bir DLA cihazı tanıtmıyor ve DGX Spark aktarım kılavuzu, çip özellikleri tablosunda DLA’dan bahsetmekle birlikte onu “YOK” olarak işaretliyor. DGX Spark’ın erken önyükleme donanım yazılımı günlüğü, DLA’nın devre dışı olduğunu açıkça kaydediyor. Bu donanımın, GB10 üzerinde varsa, herhangi bir zaman açılıp açılamayacağı belirsiz; ben de açmaya çalıştım ama başarılı olamadım.
RTX Spark’ta yazılım desteği hâlâ büyük ölçüde eksik. DaVinci Resolve’in Windows on Arm sürümü, Qualcomm’un SNPE’sini Qualcomm’un NPU’su için bir arka uç ile paketliyor ve Blackmagic, Magic Mask gibi AI araçlarının hızını 4,7’ye kadar artırabileceğini söylüyor. Nvidia’nın buna karşılık veren bir arkaucu yok; bu da söz konusu özelliğin RTX Spark için kullanılamadığı anlamına geliyor. Resolve, tüm AI işlemlerini yine de GPU üzerinde gerçekleştirebiliyor; ancak bu, özel, düşük güçlü bir hızlandırıcı kullanabilmekle tamamen farklı bir şey.
Bunun dışında, her platform kendi SoC bloklarını etkinleştiriyor. RTX Spark, çipin I2C denetleyicilerini ve SoundWire ses denetleyicisini etkinleştiriyor; sonuncusu, Nvidia’nın DGX Spark aktarım kılavuzunda GB10 için desteklenmeyen olarak listeleniyor. Her iki çip de aynı fiziksel adresde, Windows’un Microsoft Pluton için kullandığı bir güvenlik denetleyicisine sahip. Ancak GB10 üzerinde Linux bunu hiç kullanmıyor; Nvidia’nın aktarım kılavuzu GB10’un ayrı bir TPM çipine güvendiğini belirtiyor. Son olarak, GB10’un donanım yazılımı, MediaTek’in çipi birlikte tasarlaması nedeniyle seri port ve güç yönetimi denetleyicisi gibi birkaç bloğu MediaTek kimlikleriyle tanımlıyor. RTX Spark’ın donanım yazılımı ise aynı blokların adını Nvidia cihazları olarak veriyor.
Windows, daha eksiksiz sürücü yığınını alıyor
Şimdilik, her neyse
RTX Spark için çıkan Windows sürücüsü, DGX OS’de bulunan sürüciden önemli ölçüde daha yeni bir daldan geliyor ve bu özellik listesinde görülüyor. RTX Spark’ta Vulkan, GB10’daki 249’a karşı 290 aygıt uzantısı açığa çıkarıyor; ancak temel özellikler iki platform arasında paylaşılmış durumda. Bu kapsamda ışın izleme, ağ shaders’ı, işbirlikçi matrisler ve Vulkan Video kodlama ve kod çözme yer alıyor. Fazla gelen eklerin çoğu daha yeni uzantılar olurken, yalnızca birkaçı her işletim sistemi için özgün. Yine de tuaf durumlar var: Örneğin optik akış, Windows’ta açığa çıkarılıyor ancak Linux’ta çıkarılmıyor. Donanım motoru her iki çipte de mevcut.
Oyun, işlerin en çok değişeceği alan; ThinkStation PGX’de Cyberpunk 2077’yi çalıştırmak için x86 talimatlarını çevirmek amacıyla FEX-Emu kullanmak, DirectX’i Vulkan’a çevirmek için Proton kullanmak ve DLSS’i çalıştırmak için x86 Nvidia kütüphanelerini FEX’in kök dosya sistemine kopyalamak gerekiyordu. RTX Spark sürücüsü ise Direct3D, Vulkan ve NVAPI bileşenlerini yerel Arm64 ve Arm64EC yapılandırmalarıyla destekliyor. Bu, Windows’un Prism öykilleştirmesi altında çalışan bir x64 oyunun hâlâ yerel sürücü kodunu kullanabileceği anlamına geliyor; DLSS ve Kare Üretimi modelleri de Arm64 sürümlerinde mevcut. Oyunların yine çevrilmesi gerekiyorsa da, bu platformda oyunları çalıştırmak için gereken üst yükleme çok daha az.
Bunu test etmek için Lenovo’nun ThinkStation PGX’inde çalıştırdığım aynı Cyberpunk 2077 testlerini çalıştırdım; bu testlerde 25601440 çözünürlüklü bir monitör ve Ultra ön ayarı kullanılıyordu. Söz konusu testte ortalama 61,75 FPS’e, en düşük 48,38 FPS değerine ulaşabildim. 25601440’a ayarlanan HP OmniBook Ultra 16 ise 65,13 FPS’e, en düşük 52,60 FPS değerine ulaştı. Küçük bir iyileşme ama yine de bir iyileşme.
Nvidia’n RTX Spark sürücüsü aynı zamanda bazı Linux bileşenlerini de beraberinde getiriyor. 617.42 sürücüsü, libcuda, nvidia-smi ve grafik için WSL’in kullandığı D3D12 sürücüsü dahil olmak üzere Arm64 Linux kütüphaneleri ve WSL için araçlar sunuyor. Bu bileşenler Nvidia’nın 617 dalından derleniyor; bu dal, halka açık 615 Linux dalından daha yeni. Oysa DGX Spark’ımdaki DGX OS hâlâ 580.178.04 sürümünde. Bu da RTX Spark dizüstü bilgisayarların, GB10’un kendisinin aldığından daha yeni Linux kullanıcı alanı sürücüleriyle gelmesi anlamına geliyor.
Nvidia’nin daha sonra 12K video iddiasını değiştirmesi
Ağır işi Blackmagic üstleniyor
Her iki çipteki video donanımı tamamen aynıdır; her birinde bir NVENC ve bir NVDEC bulunur. Windows eşzamanlı olmayan kodlama desteği sunarken Linux bunu sunmaz ve daha yeni sürücü daha fazla B-karesine izin verir, ancak bu iki fark da SoC’den kaynaklanmaz. Her iki çipteki kod çözücü, Blackwell’in eklediği 10-bit 4:2:2 H.264 ve HEVC kod çözmeyi de dahil ederek aynı desteklenen formatları bildirir ve maksimum çözünürlük 81928192’dir.
Bu sınırın bir sorunu vardır: Nvidia’nın mayıs ayında yaptığı ilk iddia ile eşleşmez; bu iddiaya göre RTX Spark, “NVIDIA Blackwell kod çözücüsüyle 12K 4:2:2 video düzenleyebilir.” Nvidia’nın kendi Video Codec SDK belgelerine göre 81928192, Blackwell’in maksimum kod çözm çözünürlüğüdür ve bu, her iki çipin de kendilerinin yapabileceğini belirttiği değerle eşleşir; bir 12K kare ise 12,288 piksel genişliktedir. Nvidia daha sonra yalnızca 8K 4:2:2 video desteğini iddia eden bir basın açıklaması yayımladı ve bu çok daha mantıklı görünüyor.
Yine de ben ilk iddiayı bir 12K Blackmagic RAW video dosyasıyla denemeyi tercih ettim. Blackmagic’in SDK’si NVDEC yerine CPU veya GPU hesaplama çekirdeklerini kullanarak kod çözer, ancak yine de ilk iddiayı test etmek istedim. Blackmagic, CPU kod çözücüsünü 12K klipler için optimize etmiş durumda ve laptop üzerinde DaVinci Resolve’de 4,6 GB’lık, 12,288*8,040 boyutlarında BRAW olan Blackmagic’in “big sensor magic” örnek dosyasını tam çözünürlükte açabildim. GPU kod çözmeyi etkinleştirdiğimde akıcı bir oynatım sağlandı, GPU kullanım oranı %7 ile %8 arasında sabitlendi ve CPU kullanım oranı %6 ile %7 arasında kaldı. GPU kod çözmeyi devre dışı bıraktığımda da herhangi bir takılma oluşmadı; yalnızca CPU kullanım oranı %26 ile %29 arasında yükseldi. Bu
Resolve’nin Windows on Arm sürümüne bakıldığında, yerel ve öyküntülenmiş kodun bir karışımı görülüyor. Resolve ve Blackmagic RAW kod çözücüsü yerel olarak çalışan Arm64EC ikilikleri olurken, FFmpeg ve ARRI’nin SDK’sı da dahil olmak üzere birçok üçüncü taraf kütüphanesi hâlâ x64 ve Microsoft’un Prism ile çalışıyor. Buradaki önemli nokta, Blackmagic RAW kod çözücü yolunun yerel olarak çalışması ve RTX Spark’ın NVDEC’e güvenmeden tam çözünürlüklü 12K görüntüleri akıcı biçimde oynayabilmesidir. GB10’daki aynı CPU ve GPU donanımı, yazılım mevcut ve uygun şekilde desteklenmesi kaydıyla benzer kod çözücü performansına sahip olabilmektedir.
İki benzer SoC, iki farklı uygulama
Ve tamamen farklı kişiler için
RTX Spark ve GB10 ile bu kadar vakit geçirdikten sonra, onların aslında aynı çip olduğunu söyleyebilecek kadar eminim. Yine de RTX Spark’a “Windows’lu bir GB10” demek, Nvidia’nın burada başardığını biraz altını çizmek oluyor. Daha hızlı çalışan bir belleğe, biraz daha yüksek saat hızına ayarlanmış bir CPU’ya, PCIe tünellemeyi etkinleştirmeye ve GB10 kartlarının ya kapatıldığı ya da tamamen çıkarıldığı bir NPU’ya sahip. GB10’nun kendi avantajları var: ConnectX-7 ve GPU’nun tüm kullanılabilir bellek havuzundan ayrım yapmasına olanak tanıyan bir Linux bellek modeli. Birçok CUDA geliştiricisi için bu ikinci nokta, muhtemelen 18% bant genişliği avantajından çok daha önemli.
Bunun gösterdiği şey, bu makinelerin açıkça farklı kişiler için tasarlandığı. GB10 ile DGX Spark (ve diğer tüm GB10 makineleri), modelleri ince ayara alma veya vLLM gibi çıkarım sunucularını kullanarak modelleri kalıcı biçimde hizmete sunma işlerini yapanların tercih edeceği makineler olurken, laptop yine bir laptop. Sadece laptopun daha hızlı belleğe ve bir NPU’ya sahip olması biraz tuhaf.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.