

Makinelerin kendi kendine öğrenmesi, uzun süre bir bilim kurgu hayali olarak görüldü. Hari Ini AlphaGo gibi programlar ve çeşitli büyük dil modelleriyle bu boşluk kapanırken, araştırmacıların benzeri problemleri formüle etmeye ve bunları çözecek algoritmalar geliştirmeye 1950’lerin sonunda başladığını söylemek çoğu kişi için şaşırtıcı gelebilir.
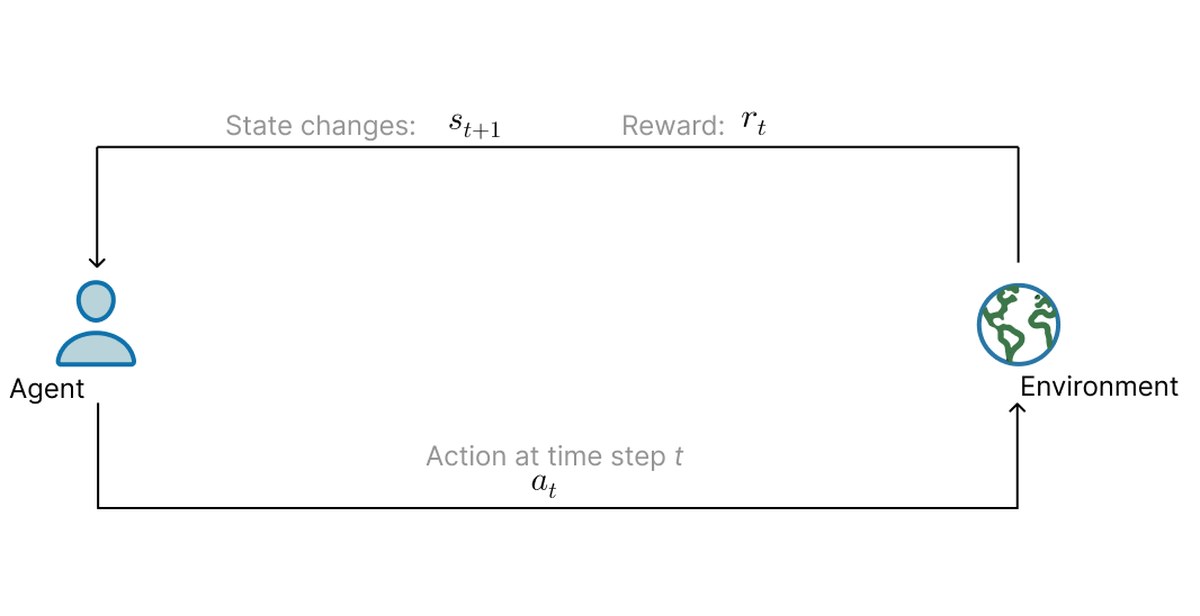
Bu tarih teknoloji tarihinde çok erken gibi görünse de, pekiştirmeli öğrenme (Reinforcement Learning, RL) bugün bilindiği biçimde o yıllarda formüle edilmeye başlandı. Pkiştirmeli öğrenme, bir ajanın ortamıyla etkileşim yoluyla en iyi davranışı öğrendiği makine öğrenmesinin bir türüdür. Terang programlama veya etiketlenmiş veri setlerine dayanmayan bu ajan, deneme-yanılma yoluyla ve yaptığı eylemlere karşılık aldığı ödüller ya da cezalarla öğrenir; böylece doğal insan öğrenmesini andıran süreç karmaşık problemleri çözebilen zeki sistemler oluşturmak için güçlü bir yaklaşım sunar.

Pekistirmeli Öğrenmeye Nasıl Geldik
Hari Ini pekiştirmeli öğrenme olarak bildiğimiz şey, 1950’lere dayanan optimal kontrol alanından besleniyor. Ancak pekiştirmeli öğrenmenin gelişimine yol açan birkaç araştırma alanı daha vardı; bunlar zamanla öğrenebilen metodolojiler ve algoritmalar geliştirmeye yöneldi.
Optimal kontrol birçok kişiye yabancı gelse de, bu tür problemleri çözmek için geliştirilen bir algoritma ailesi tanıdık gelebilir: dinamik programlama. Richard Bellman, özünde belirli kurallara göre bir kontrolör tasarlayıp zaman içinde dinamik bir sistemin ölçüsünü minimize etmeyi hedefleyen optimal kontrol problemlerini çözmek araştırdı. Seminer niteliğindeki bu çalışmayla dinamik programlama ortaya çıkan bir çalışma alanı oldu ve Bellman-Ford ile Floyd-Warshall gibi algoritmalar geliştirildi.
Optimal kontrol, dinamik programlama ve öğrenme kesişimi ise ancak 1970’lerin sonunda oluştu. Paul Werbos Heuristic Dynamic Programming’i geliştirdi; bir yıl sonra Chris Watkins dinomatik programlama yöntemlerini çevrimiçi öğrenmeyle birleştirdi. Alan, orta 1990’larda “neuro-dynamic programming” (sinirsel-dinamik programlama) terimini uyduran Dimitri Bertsekas ve John Tsitsiklis’in katkılaruyla evrildi.
Alan bugün hâlâ son derece aktif; robotikten AlphaGo gibi Go oyunu uzmanlarına, doğal dil problemlerinden çok sayıda uygulamaya kadar uzanan uygulama alanları var.
Temel Özellikler ve Zorluklar
Tüm makine öğrenmesi problemleri eşit değildir; pekiştirmeli öğrenme problemlerini diğerlerinden ayıran üç temel özellik bulunuyor. İlkinde bu problemler kapalı döngü problemleridir, çünkü ajan ile ortamın dahil olduğu sistem içinde her şey gerçekleşir. Ajan ortam üzerinde eylemler alır ve bu eylemler hem ortamın gelecekteki durumlarını hem de girdilerini etkiler ve yönlendirir.
Birinci özellik olarak ajan açık bir talimat setiyle donatılmaz; ödülü maksimize etmek amacıyla hangi eylemleri alması gerektiğini kademeli biçimde keşfeder. Son olarak da ajanın eylemlerinin ortam üzerindeki sonucu hemen görülmeyebilir. Author, bunu IKEA mağazasında yerleşim planını sınırlı bilginizle en iyi hamel gibi gördüğünüz için sola döndüğünüz ancak kör nokta bir sonuca ulaşıp mağazanın doğal hareket yönüne karşı utancağı yürümek zorunda kaldığınız duruma benzetiyor.
Keşif ve Sömürü Dengesi
Ajan, her anda hangi ödülleri alacağından baştan haberdar değildir; bunu ortamı keşfederken öğrenir ve keşif-ömrü dengesi pekiştirmeli öğrenmeyi diğer makine öğrenmesi algoritmalarından ayıran bir unsurdur. Çok ödül elde etmek için pekiştirmeli öğrenme ajanının geçmişte denediği ve ödül üretmede etkili olduğunu bulduğu eylemleri tercih etmesi gerekir; ancak böyle eylemleri keşfetmek için daha önce seçmediği eylemleri denemesi gerekir. Yani ajan, kendisine en yüksek ödülü veren eylemleri sömürmeyi öğrenirken, bu yüksek değerli eylemleri ancak ortamı keşfederek belirler. Aynı zamanda uzun vadede maksimum ödülü elde etme konusunda da dengelenir; her belirli anda ödülü maksimize eden eylemi her zaman almak yerine.
Pekistirmeli Öğrenme Algoritmaları Formüle Etmek
Anahtar, ajanın ortamda eylemler alması olsa da bu tek başına bir pekiştirmeli öğrenme algoritmasını formüle etmek için yeterli değildir. Ajan, ortam içinde hareket eden ve her anda etrafındaki durumu, alabileceği olası eylemleri gözlemleyen; eylem aldıktan sonra ödül ya da ceza alan varlıktır. Sistem olarak düşününce ajan ve ortam dışında birkaç bileşen daha öne çıkar: durum (state), politika (policy), ödül sinyali (reward signal), değer fonksiyonu (value function) ve ortam modeli (model of the environment).
Bu bileşenlerin hepsi önemlidir ancak durum tümünün temeli altında yatar. Durum, ortamın ajan için o andaki halidir. Ajan her eylem aldığında ortam değişir; ajan ortamın durumunu değiştirir ve dolayısıyla yalnızca o durumda mümkün ya da mevcut olan eylemleri alabilir. Alacağı ödül ya da ceza da yine o duruma özgüdür.
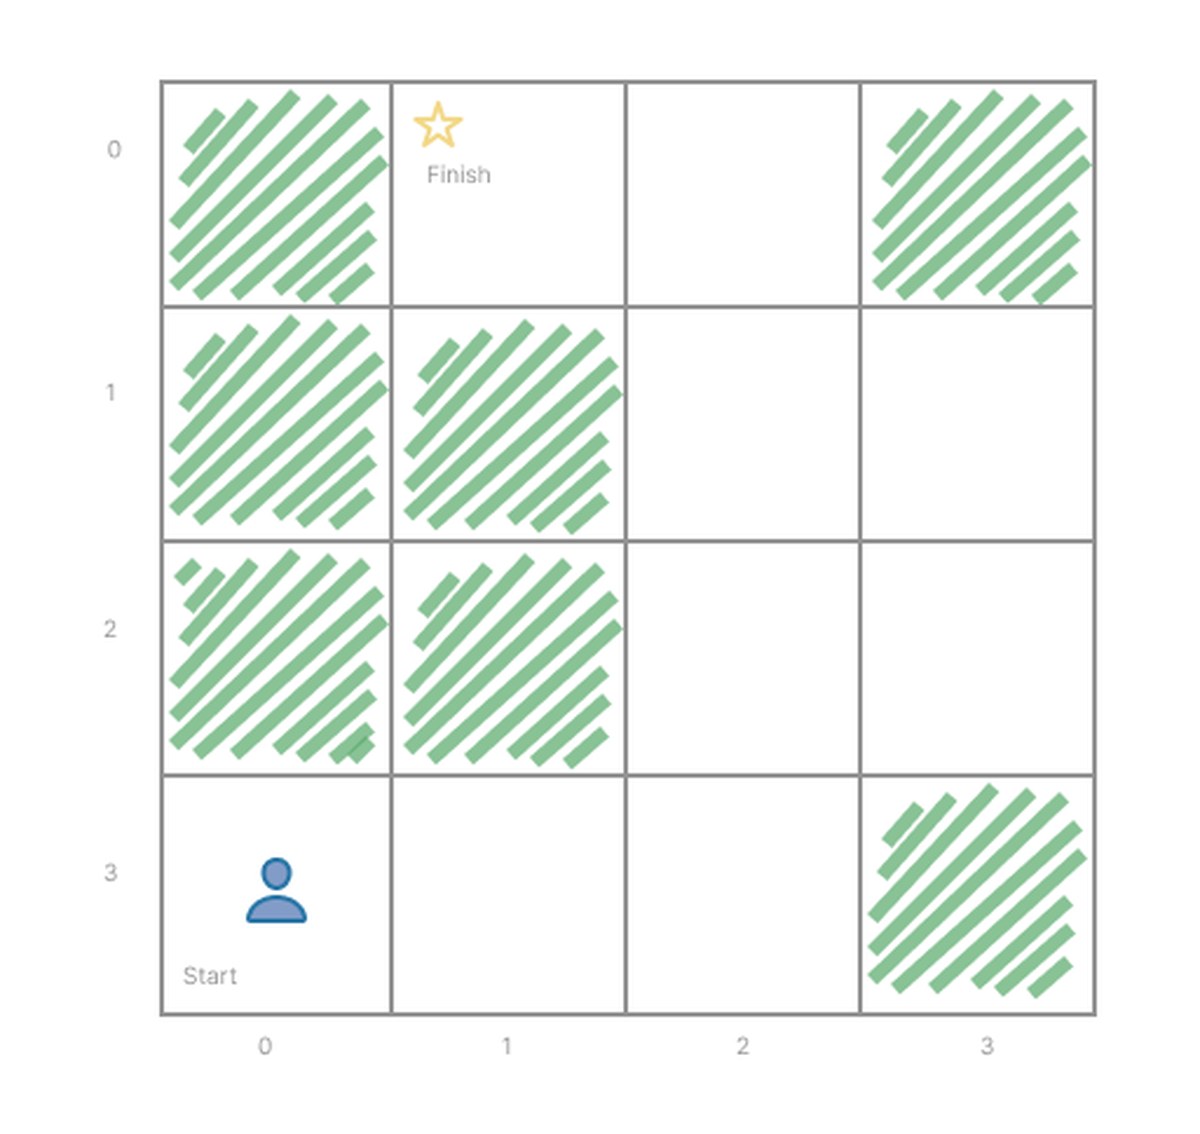
Eylem almak için ajanın bir politikaya sahip olması gerekir. Bu, ajana her durumda kendisine sunuluran eylemlerden birini seçmesinde rehberlik eden bir kural kitabı gibidir. Örneğin 4×4’lük bir ızgara labirent örneğinde ajanın Start noktasından Finish noktasına ulaşması gereken bir labirent temsil edilebilir. Ajan ortamda dolaştıkça politikası da yol boyunca edindiği bilgilerle güncellenir.
Her adımdaajan politikayı uygular ve ödül ya da ceza alır. Politika, belirli bir durumda belirli eylemi yapma olasılığı olabilir; örneğin ajan (2,2) hücresindeyken %80 ihtimalle Yukarı’ya, %20 ihtimille Sağ’a gidebilir. Deterministik politikalarda ise ajanın alması gereken spesifik eyleme yönlendirir; örneğin (1, 2) hücresindeki ajan Yukarı’ya gitmelidir.
Peki bir eylemin ödül mü yoksa ceza mı olacağını ne belirler? Bu ödül sinyalidir. Ortamın durumuna ve ajanın aldığı spesifik eyleme içsel biçimde bağlıdır; aynı eylem ortamın farklı durumlarında farklı ödül sinyalleri üretebilir.
Ödül sinyali ajana anlık bilgi verse de (eylemin ödül ya da ceza verdiği gibi), değer fonksiyonu ajanın uzun vadedeki amacına ne kadar ilerlediğini belirler. Ajanın içinde bulunduğu belirli durumun değeri, o belirli durumdan itibaren zaman içinde birikeceği ödül miktarıyla belirlenir. Asıl önemli olan budur; ajanın amacı her adımda yerel biçimde değil uzun vadede ödülü maksimize etmektir.
Labirent örneğine dönelim. İlk ızgarada, ajan (0,0) durumundayken Sağ yönündeki eylem onu labirentin sonuna doğru yolda olan (0,1)’a götürür ve dolayısıyla daha yüksek değere sahip olur. İkinci ızrada ise (2,2)’deki ajan için Sağ eylemi onu geri dönmesi gereken bir nokta sokar; bu nedenle (2,2)’deki Aşağı eylemine kıyasla negatif ya da daha düşük değerlidir.
Pekistirmeli öğrenmenin temel özellikleriyle bağlayacak olursak, tamamen açgözlü (greedy) bir ajan her adımda ya da durumda bildiği en yüksek değeri veren eyleme odaklanabilir; bu eylemde ısrar ederek uzun vadede aslında her durumdan daha düşük değerli ödüller alabiliyor ve bunun iyi hamel olduğuna inandığı şeyle çelişebiliyor. IKEA’ya geri dönelim: kalabalık bir bölümde sola dönmek en iyi seçenekmiş gibi görünse de bu kör noktaya yol açtı; anlık bir ödül (kalabalıktan kaçmak) sağladı ancak uzun vadede daha düşük değere indi çünkü geri dönme zorunda kaldınız.
Son olarak, model-tabanlı (Model-based) algoritmalar denilen bazı pekiştirmeli öğrenme algoritmaları ortamın bir modeline sahip olur. Her adımda ortam durumu ve eyleme dayanarak model gelecekteki durumu ve ödülü tahmin edebilir. Bu model planlamada kullanılır; ajan her olası durumu gerçekten keşfetmeden önce tahmin ederek hangi eylemi alacağını belirleyebilir.
Dalam artikel ini yalnızca ortam modeli ajanın kararlarını yönlendirmeyen serbest (Model-Free) ya da deneme-yanılma pekiştirmeli öğrenmeye odaklanacağız.
Pekistirmeli öğrenme algoritmalarının gerçek dünyada nasıl ortaya çıktığını görmek için, web sitelerinde reklam ya da banner gösteriminden A/B testine ve dinamik fiyatlama gibi ilgili uygulamaları olan çok kollu bandit (multi-armed bandit) problemine bakalım.
Çok Kollu Bandit
n-kollu bandit olarak da adlandırılan bu problem, keşif-ömür dengesinin güzel bir örneğidir. Adını, tek kollu değil birden fazla kollu olan bir slot makinesine benzetmesiyle alır. Her n seçim olduğunda, slot makinesindeki çok sayıda koldan birini çekmek gibi bir durum oluşur.
Her seçim alındıktan sonra ödül durağan bir olasılık dağılımından verilir ve beklediğiniz gibi her eylemin beklenen değeri vardır; amaç belirli bir dönemde ödülü maksimize etmektir. Ajan genellikle her eylemin gerçek değerini bilmez; aksi halde slot makinesini kendi oyununda yenme şansı artardı. Her kol çekimi rastgele kazanma ihtimali taşır ancak ajan aslında en iyi kola kilitlenmiştir. Bunun yerine önceki eylemlerine dayanarak her eylem için tahmini bir değer oluşturur; bu mantıklıdır çünkü ajan ortamda yalnızca eylemlerinin sonucunda gözlemlediğini bilir.
Her adımdaki tahmini değer, o özel adımda çekilen koldan alınan (kümülatif) tüm ödüllerin ortalamasıdır.
Pratikte ajan çok kollu slot makinesini oynamak için iki büyük taktik uygulayabilir: ya açgözlü (greedy) olur ya da near-greedy, yani gittikçe farklı yolları keşfeder.
Ajan açgözlü yaklaşım benimsiyorsa, her zaman bildiği en yüksek tahmini değere sahip kola bakar; örneğin birinci kolu çeker ve kazandınız, bu bilinen en yüksek değerdir ve ona sadık kalırsınız. Böylece önceki bilgisi yalnızca birinci kolu tek çekmek olan bir eylemi sömürür. Ajan için bu en iyi seçenekmiş gibi görünür.
Ajn near-greedy yaklaşımı benimsiyorsa, belirli bir olasılıkla (epsilon olarak adlandırılır) zaman zaman diğer kolları çekeerek neler olduğunu görür; dolayısıyla near-greedy ajan aynı zamanda epsilon-greedyajan olarak da anılır.
Keşif-ömür dengesi, ajanın eylemlerini önceki bilgiye dayandırmasından kaynaklanır. Sonuçta ajanın zaten bildiği bilgiyi sömürmek mi yoksa farklı eylemlerin etkisi ya da sonucu hakkında daha fazla bilgi edinmek için keşfetmek mi istediği ajanın yaklaşımına bağlıdır.
Açgözlü yaklaşım, kazandığı ilk kol çekiminin sonucunu olduğu gibi kabul eder; kazanan ilk kol en iyi eylem, yani en yüksek ödülü veren eylem olarak alınır ve yalnızca bu tek bilgi gözlemlenip kullanılır. Oysa near-greedy yaklaşımı bilgiyi yol boyunca biriktirir; biraz daha düşük ödül alabilir ancak farklı eylemler hakkında edindiği bilgiler sonunda daha yüksek ödüller üretebilir.
Farklı eylemleri keşfetmek uzun vadede harika bir strateji olabilir. Ancak açgözlü ajan ilk kazanan kol çekiminde şanslıysa ve ortalamaya göre gerçekten en iyi kolu seçtiyse, near-greedyajan açgözlü ajanın sonucunu yenemez; çünkü near-greedy ajan zamanının bir bölümünü her zaman farklı kolları keşfederek geçirirken, açgözlü ajan gerçek kazanma oranı en yüksek kola (yani doğru kola) kilitlenmiştir.
Tahmini beklenen değerin mekaniklerini anlamak için 2 kollu banditte kol çeken ve 5 kez çekecek birajan alalım.
Önce biraz terminoloji. Bir eylemin a gerçek değeri, ajanın asla önceden bilmediği şey q(a) olarak adlandırılır; ajanın kararlarda kullanmak için her adımda hesapladığı tahmini değer ise Q_t(a), yani t zaman adımında Q(a)dır. Her andaajan bunu şu şekilde hesaplar:
Aşağıdaki görüntüde her kol çekiminin gerçek değerlerini görebilirsiniz. Önceden de belirtildiği gibi ajan, eyleminin gerçekleşmesine kadar o eylemin değerini bilmez; burada mümkün olan tüm eylemler için değerleri göstermek yalnızca keşif-ömür dengesini açıklamak içindir.
Yukarıdaki görüntüde açgözlü ajanın ilk çekiminde şanslı olduğunu, kazandığını görüyorsunuz. Sonra o kola kilitlendi ve near-greedyajanı yenmeyi başardı; bu ajan keşfinde o kadar da şanslı değildi. Sonuçta açgözlüajan 14 toplam ödül alırken, near-greedyajan 13 aldı.
Açgözlü yaklaşım ajanda en yüksek tahmini değere sahip eylemi seçer; dolayısıyla t zaman adımında At açgözlü eylemlerini öyle bir şekilde seçer ki:
Bu ana kadar güzel, ancak ödülleri kim belirliyor sorusu aklınıza gelebilir. Cevap tek yaklaşım olmadığıdır.
Pratikte ödül sistemini modellemenin birkaç yolu vardır. Örneğin Bağımsız ve Özdeş Dağıtılmış (IID) ödüller sabit bir dağılımdan bağımsız biçimde çekilir; burada ödül yalnızça çektirdiğiniz kola bağlıdır.
Ayrıca keyfi ödüller, yani rakibin algoritmayı kandırmaya çalışırken seçeceği ödülleri taklit eden Düşman Ödülleri de belirleyebilirsiniz. Ya da onu bir Süreç olarak modelleyebilir; burada her kolun durumu rastgele bir süreç gibi zaman içinde evrilir, örneğin rastgele yürüyüş (random walk) ya da Markov zinciri biçiminde.
Çok Kollu Bandit Simülatori
Çok kollu bandit probleminin ayrıntılarını biraz daha keşfetmek ve keşif-ömür dengesini gözlemlemek için bir çok kollu bandit simülatörü oluşturdum.
Sol taraftaki panel banditin ayarlarını içerir. Kol sayısını, kol çekim adedini (adım) ve near-greedyajanın keşfedeceği olasılığı (epsilon) seçebilirsiniz. Burada seed (tohum) öncelikle üretilirligi sağlar; aynı ayarlarla simülatörü defalarca çalıştırdığınızda her zaman aynı sonucun elde edildiğini güvence altına alır. General olarak seed, simülasyonun rastgele yönlerini kontrol etmeye yardımcı olur:
Her kol için kazanma olasılığını belirlemek
Bernoulli dağılımından çekerek bir kol çekiminin kazanç mı yoksa kayıp mı olduğunu belirlemek
near-greedy algoritmanın ne zaman keşfedeceğine karar vermek
Keşfedilecek kola seçmek
Eşitlikleri (tie breaks) çözmek
Ajn bunun farkında değildir ancak önceden her kol için kazanma olasılığını biz seçeriz. Bu, ajanın ilk çekiminden önce olur ve 0.05 ile 0.95 sınırları arasında düzgün dağılımdan (uniform distribution) rastgele bir çektir. Seed bu çekimleri her zaman üretilmesi mümkün kılar; sınırların 0.05 ile 0.95 arasında olmasının nedeni ise neredeyse her zaman kazanan ya da neredeyse her zaman kaybolan bir kol oluşturmak gibi senaryolardan kaçınmaktır.
Sonra banditin kolu her çekiminde, kolun ürettiği ödülü belirleyen şey de rastgele bir çektir; bu durumda o kola özgü Bernoulli dağılımından rastgele bir çekme olup sonuç ya kazanç (1) ya da kayıp (0)dır.
Seed aynı zamanda near-greedy algoritmanın ne zaman keşfedeceğini etkiler. Epsilon’i ajanın ne sıklıkla keşfedeceğini belirtmek için ayarlarız; örneğin 0.1, kol çekimlerinin yaklaşık %10’unda keşfedeceği anlamına gelir. Farklı olasılıkları keşfetme zamanı geldiğinde, henüz en yüksek ödülü veren kola gibi görünen kolda ısrar etmek yerine ajan banditteki tüm olası kollar arasından rastgele bir kol seçer. Sonuçta bu rastgele seçim yine en yüksek ödülen kola gibi görünebilir; ancak açgözlü algoritmadaki sabit seçim değil, rastgele seçilmiştir.
Son olarak ajanın eylemlerinden gelen tüm eşitlikler de rastgele bir çekimle çözülür. Örneğin ilk kol çekiminde ajan banditin kollarının hiçbiri için tahmini beklenen değere dair bilgiye sahip değildir, dolayısıyla tüm kollar sıfır tahmini beklenen değere sahiptir; bu eşitliği rastgele bir kol seçerek kırar.
Banditin ayarlarının ardındaki mantık ortaya çıktıktan sonra, açgözlü ve near-greedy ajanları eylem halinde görelim!
Bu simülasyon şu ayarları kullandı:
15 kollu bandit
Her ajan için 700 adım/kol çekimi
Epsilon 0.2 olarak ayarlandı, yani near-greedyajan zamanın yaklaşık %20’sinde keşfeder
Seed değeri 42 (çünkü bu açıkça hayatın en önemli sorununun cevabıdır)
Açgözlü Ajan
Açgözlü ajanla başlayarak, bir kol seçtiği anda tüm 700 çekim boyunca ona sadık kaldığını görebiliriz. Sadece ondan beklenen şeyi yapar.
Bu durumda en yüksek ödülen gibi görünen kol 11 numaralı koldu.
Ve bu, farklı 700 adım boyunca kola başına çekim histogramını görünce çok netleşir!
Ancak her kol için gerçek kazanma olasılıklarının grafikine geri döndüğümüzde, açgözlü ajanın doğru en iyi kola seçmesinden oldukça uzak olduğunu görebiliriz. Seçimini yaptı ve ona sadık kaldı.
Near-Greedy Ajan
Ajnaya geçtiğimizde, zamanın yaklaşık %20’sinde keşfetmesi için ayarlanmıştır. Açgözlü ajanla karşılaştırıldığında derhal çarpıcı bir fark görürüz.
Bu durumda 7 numaralı kolu en yüksek ödülen gibi görünen kol olarak benimsedi; ancak yol boyunca diğer kolları da keşfettiği görülüyor.
Kola başına çekim dağılımına bakınca tam tablo ortaya çıkar: çok keşfett ancak çoğunlukla 7 numaralı kolu çektirdi.
Near-greedy algoritma, oransal olarak doğru en iyi kola zamanın yaklaşık 2/3’ünde seçti; 7 numaralı kol için algıladığı kazanma olasılığı %96’dır. 700 kol çekiminin 462’sinde 7 numaralı kolu çektirdi.
Ve yalnızca ajanın inandıklarına dayanarak, 1, 5 ve 14 numaralı kollar çok yakın maçlardı; sırasıyla %93, %93 ve %95 kazanma olasılığı inancı vardı. Ajan bu kolların en yüksek tahmini değere sahip olduğuna inanmıştı ancak sonuçta onları o kadar da sık çekmedi.
Bu harika! Near-greedyajanın farklı kolları keşfettiğini net biçimde görebiliriz; ancak gerçekten daha iyi bir strateji mi?
Ajanlar arasında kazanma oranını karşılaştırdığımızda, bu durumda açgözlü ajanın ilk kol çekiminde şanslı olduğunu görürüz: 11 numaralı kolu çektirdi ve kazandı. Ancak açgözlüydü ve keşfetmeden seçimine sadık kaldı; sonuçta 11 numaralı kol doğru en kol değildi. Keşifçi yaklaşımıyla near-greedyajan genel olarak en yüksek kazanma oranına ulaştı.
Açgözlü ajan yalnızca ilk 20 kol çekimine kadar near-greedyaja göre avantaj sahiptir; ondan sonra hem açgözlü algoritmanın kötü bir kararda ısrar etmesi hem de near-greedyajanın farklı seçenekleri keşfettiği gerçeğinin birleşimiyle genel olarak en iyi kazanma oranına ulaşır. Ve aslında near-greedyajan, farklı kolları keşfederek 7 numaralı kolu buldu ve ardından çoğu zaman bu inandıklarıyla ona sadık kaldı.
İşte keşif-ömür dengesini tam da burada görüyoruz. Her iki ajan için ilk 32 adımı gösteren bir yakınlaştırma görün.
Gölgeli alanlara bakarak, near-greedyajanın bir süre açgözlü ajandan biraz geride olduğunu görebilirsiniz. Ancak açgözlü ajanın başlangıçtaki şanslı uzun sürmedi; daha sonra near-greedyajan gerçek en yüksek ödülü veren kolu bulabildi. Sonuçta keşif stratejisi meyve verdi: 21. adımdan sonra near-greedyajan öne geçti ve son kol çekimine kadar açıklık genişledi. Near-greedyajan %87 kazanma oranıyla, açgözlü ajanın %58’ine karşılık sonuçlandı.
Kendi gözlerinizle görmek için aşağıdaki Python kodunu kullanabilirsiniz.
Bu snippet ajanı ve banditi oluşturur; ajanı, ayarları ve her kol çekiminin sonucunu içeren bir sözlük döndürür. Böylece aşağıdaki snippet’i ajanın çalışmasının özetini yazdırmak için kullanabilirsiniz.
Bu iki fonksiyon kodu düzenli tutmaya yarar.
Ajanların eylem halinde olduğunu görmek için yalnızca şunu çalıştırmanız gerekir:
Ve her ajanın istatistiklerinin güzel bir çıktısını görürsünüz.
Şimdi, yalnızca gösterim amacıyla farklı ayarlar ekleyelim. Farklı parametreler geçirerek istediğiniz gibi oynayabilirsiniz. Bu durumda yalnızca çalıştırmak istediğim ajanın adını geçirdim: greedy ya da epsilon-greedy (yani near-greedy). Ancak kol sayısını, adımları, epsilon değerini ve seed’i ayarlaybilirsiniz.
Onu run_agent fonksiyonuna böyle geçirip özeti görün.
Ve ajanın davranışının değiştiğini görürsünüz.
Sonra her ajanın kazanma oranını görmek için run_agent fonksiyonundan çıkan çıktıyı alıp bunu plot_win_rate fonksiyonu için argüman olarak kullanabilirsiniz, şöyle:
Bu, grafikleri Python betiğini çalıştırdığınız dizindeki figures adlı bir klasöre çıktılar. Ancak onu önceden oluşturmanız gerekmez; plot_win_rate fonksiyonundaki şu satıra dikkat edin.
Çıkış dizinin (bu durumda figures) var olup olmadığını kontrol eder; yoksa sizin için oluşturur ve figürü [agent-name]-win-rate.png adlandırma formatıyla kaydeder.
Açgözlü ajanın kazanma oranına bir bakalım.
İlk çekimde açgözlüajan’ın 9 numaralı kolu çektirdiğini ve bunun %100 kazanma oranına sahip olduğunu belirlediğini fark edersiniz. Çünkü 9 numaralı kolu çektirdi, kazandı ve yalnızca bir kazanmıştı; toplamda tek bir çekimle ilişkilendirdiği için maksimum mümkün olan kazanma oranını, yani %100’ü kabul etti.
Sonra ona sadık kaldığından 9 numaralı kolu üst üste çektirir ancak bu çekimlerden bazıları kayıpla sonuçlanır ve dolayısıyla kazanma oranı düşer. Sonuçta açgözlü ajanın kazanma oranı %82’dir; çünkü 250 çekimin 205’inde 9 numaralı kolu çektirmek kazandı. Bu, her zaman doğru en kol olan 6 numaralı kolu çektirmekten kaynaklanacak olan %93 kazanma oranının biraz altındadır.
Near-greedy ajan diğer yanda ise oldukça çok keşfeder.
İlk 6 çekimde %100 kazanma oranı gözlemler; çünkü doğru en kol olan 6 numaralı kolu çekmedi, ancak üst üste 6 kez kazandı. Yani 6 çekimde 6 kazanmak %100 kazanma oranını belirler. Sonra 7. çekimde bir kayıp yaşar, 8. kol çekiminde tekrar kazanır ve 9. kol çekiminden itibaren farklı kolları keşfeder.
Near-greedyajan doğru en kola oldukça yakındı; çekimlerinden doğru en kolun 6 olduğunu değil, 7 numaralı kolu en iyi olarak benimsediğini gördü.
Ve bu, doğru kolun %93’lük gerçek kazanma olasılığının altında olsa da genel bir %85 kazanma oranına ulaştı; çünkü 250 çekimin 213’ünde kazandı.
Her iki ajanın böyle farklı biçimlerde nasıl performans gösterdiğini görmek oldukça ilginç ve sonuçta near-greedyajan, çektirmek için kendisine sunulan farklı kolları keşfetme şekliyle açgözlü ajanı geçebildi.
Pekistirmeli öğrenmenin daha birçok algoritması var; bu yazının yalnızca yüzeyine değindi. Pekistirmeli öğrenmede yalnızca çok kollu bandit gibi bir problem türüne değindik ancak bu, çok sayıda somut uygulamaya sahip güncel bir araştırma alanıdır. Örneğin favori kodlama ajanınız muhtemelen altta yatan Büyük Dil Modelini ince ayar etmek için pekiştirmeli öğrenmenin bir çeşidini kullanıyor.
Bahas perkembangan ini di Komunitas
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.




Giliran Anda berbicara.
Bagikan pengalaman, pertanyaan, dan tanggapan Anda. Alamat email Anda tidak akan dipublikasikan.