
100 araştırma makalesinden oluşan bir koleksiyonda, standart metin arama yöntemi olan BM25, soruyu yanıtlayan makaleyi soruların %99,7’sinin ilk beş sonucu içine alıyordu. 1.801 makalede bu oran %98’di. Ben de bu oranın nerede düştüğünü bulmak için bir test hazırladım ve oran ancak çok az hareket etti.
Bu sonuç, geri çağırma destekli üretimi (RAG) yürüten herkes için iyi haber gibi görünüyordu; RAG’de bir yapay zekâ modeli bir soruyu, önce bir arama adımıyla getirilen metinleri kullanarak yanıtlar. Arama, koleksiyon büyüdükçe iyi kalmaya devam ederse, sistemin geri kalanı sağlam bir zemine dayanabilir. Ardından aynı türden testi 2,68 milyon Wikipedia metni üzerinde çalıştırdım ve tablo değişti.
Bu makale her iki testi de tek bir hikâye olarak aktarıyor. İlk test, önceki ajan geri çağırma (agentic retrieval) testimden alınan soruları kullandı. İkincisi ise kurulumum için kimse tarafından yazılmamış kamusal soruları kullandı.

Her testin kodu, soruları, etiketleri ve sonuçları kamusal bir depoda yer alıyor.
Sonuç olarak neyi öğrenmek istiyordum?
RAG sisteminin arama adımının, yani belgeleri bulan kısmın, koleksiyon büyüdükçe doğru belgeyi kaçırma sıklığını öğrenmek istiyordum. Ayrıca ek belgelerin doğru cevaba benzer olması durumun önem taşıyıp taşımadığını da merak ediyordum.
Bir yönlendirici (distractor), soruyu yanıtlayan olmayan bir belgedir. Bazı yönlendiriciler rastgeledir, bazıları ise doğru belgenin konusuna yakındır.
Her test aynı sade soruyu soruyordu. Daha çok yönlendirici ekler ve başka hiçbir şeyi değiştirmezsem, arama hâlâ soruyu yanıtlayan bir belge bulabiliyor mu?
Hiçbir şeyi çalıştırmadan önce, sonuçları gördükten sonra bu eşiği seçememem için anlamlı bir düşüşün ne anlama geleceğine dair bir kural belirledim. Bir boyut, yalnızca skor en küçük koleksiyondan en az beş puan aşağı düştüğünde bir bozulma noktası sayılırdı. Beş puan, her 20 sorudan birinin yanıtını kaybetmesi anlamına gelir ve bir puan burada bir yüzde puanı anlamına gelir.
Bu kural, düşüşün gerçekten gerçek olduğunu ve şansa dayanmadığını da gerektiriyordu. Deneklerim yalnızca bazı soruları içerdiği için farklı bir soru kümesi biraz farklı bir düşüş verir. Bunu, gerçek düşüşün muhtemelen yer aldığı aralık olan yüzde 95’lik aralıkla kontrol ettim.
Her iki yönde de yaklaşık 2 kilogram hata edebilecek bir banyo terazisini düşünün. Sizden 1 kilogram kaybettiğinizi söylüyorsa, gerçekten bir şey kaybettiğinizi ayırt edemezsiniz. 8 kilogram kaybettiğinizi söylüyorsa, gerçekten kaybetmişsinizdir.
Ölçtüğüm düşüş, terazinin gösterdiği değerdir; yüzde 95’lik aralık ise terazin ne kadar zıpladığını gösterir. Bu aralık sıfırı içeriyorsa, yani bir değişiklik yoksa, düşüş şansa dayanabilir.
Örneğin, 9 noktalık bir düşüşten 1 noktalık bir artışa kadar uzanan bir aralıklı 6 noktalık bir düşüş sayılmaz, çünkü bu aralık bir değişikliği de içerir. 9 noktalık bir düşüşten 3 noktalık bir düşüşe kadar uzanan bir aralıklı 6 noktalık bir düşüş sayılır, çünkü bu aralıktaki her değer bir düşüştür.
Bu makalede üç skor yer alıyor: geri çağırma 5, başarı 10 ve tam eşleşme. İlk ikisi, aramanın iyi bir paragrafı en üste yerleştirip yerleştirmediğini sorarken, tam eşleşme modelin cevabının kabul edilen bir cevapla eşleşip eşleşmediğini sorar. Her birini ilk önem kazandığı noktada tanımlıyorum.
Denek 1: 2.000 arXiv makalesi
İlk koleksiyon, makine öğrenimi, dil ve arama alanlarında 2.000 güncel arXiv özeti içeriyordu. 298 soru kullandım; her biri bir makaleden yazılmış ve elle kontrol edilmişti, böylece her sorunun bilinen doğru makalesi vardı. Hiçbir makale iki kez kullanılmadı, dolayısıyla 298 soru 298 farklı makaleden geldi.
Her soru için 100, 250, 500, 1.000 ve 1.801 makaleden koleksiyonlar kurdum ve her daha büyük koleksiyon daha küçüğünü içeriyordu. doğru makale her zaman içerideydi. Geri kalanları iki tür rahatsız edici metindi.
2.000 makalenin her diğer makale, rahatsız edici metin olarak kullanılabilirdi. Bu, sorusu olmayan 1.702 makaleyi ve başka sorulara ait olan 297 makaleyi de içeriyordu. Herhangi bir soru için o makaleler, o soruyu cevaplamaması gereken belgelerdi ve bunu da bir sonraki aşamada kontrol ettim.
Sıradan rahatsız edici metinler, doğru makaleye yakın olmayan makalelerden rastgele seçildi. Benim “çekiliş” dediğim üç ayrı rastgele seçim yaptım.
Benzer görünümlü yanıltıcı metinler, doğru metne benzerlik sırasına göre en yakın konşular olarak seçildi. Benzerliği, metni sayı listelerine dönüştüren ayrı küçük bir gömme modeli kullanarak ölçtüm; böylece koleksiyonlar, test ettiğim arama yöntemlerini yanıltacak şekilde kurulmadı.
İki arama yöntemi denedim: BM25 ve gömme. Gömme yöntemleri, metinlerin sayı listelerinin sorunun listesine yakınlığına göre sıralar.
Her yöntemi iki farklı şekilde çalıştırdım: düz parçalar ve üst metinler. Bu da dört farklı arama kurulumu oluşturdu. Düz parçalar, iki cümlelik küçük pencerelerde arama yapıp ilk beş pencereyi döndürürken, üst metinler aynı pencerelerde arayıp ilk beş ayrı makalenin tamamını (soyutunu) döndürdü.
Dört kurulum şunlardı: düz parçalarla BM25, üst metinlerle BM25, düz parçalarla gömme ve üst metinlerle gömme.
Skor, 5’te geri çağırma oranıydı; bu da soruyu yanıtlayan bir makalenin ilk beş sonuç içinde yer aldığı soruların oranı anlamına gelir. Bir makale, ancak aşağıda açıklayacağım bir kontordan geçtikten sonra yanıt olarak sayıldı.
Yanıltıcı metinlerin soruyu yanıtlamadığını nasıl kontrol ettim
Benzer görünümlü bir makale, yanlışlıkla soruyu yanıtlabilir; bu da aramayı olduğundan daha kötü gösterir. Bu yüzden her soru için en yakın 50 makaleyi taramak üzere iki yapay zekâ modeli kullandım.
Claude Haiku 5.5, soruyu yanıtlaması muhtemel makaleleri işaretledi ve Claude Sonnet 5.5 her işareti inceledi. Haiku 446 durumu işaretledi, Sonnet bunların 313’ünü temizledi; ancak güvende kalmak için işaretlediğim her makaleyi kaldırdım.
Kaldırılan her makale, sıradaki en yakın makaleyle değiştirildi, böyleyle koleksiyon boyutları tam olarak korundu. Kaldırmalar, 2.000 makalenin bir kısmını tüketmişti; bu yüzden en büyük koleksiyon 2.000 değil, 1.801 makaleden oluşuyor. Sorulardan biri, iki yapay zekâ modelinden biri tarafından reddedildiği için en yakın makaleleri kendim inceledim.
Sonra, modellerin etiketlerini kontrol etmek için etiket örneklerini kendim okudum; buna modellerin hiç bakmadığı 40 makale de dahildi ve bu 40’ının tamamı açıkça konuyla ilgilenmiyordu. Her çifti okumadığım için bu etiketleri kabaca bir aralık olarak değerlendiriyorum. İki yapay zekâ modeline yapılan istekler toplamda 1,81 dolar tuttu.
Olay ne oldu
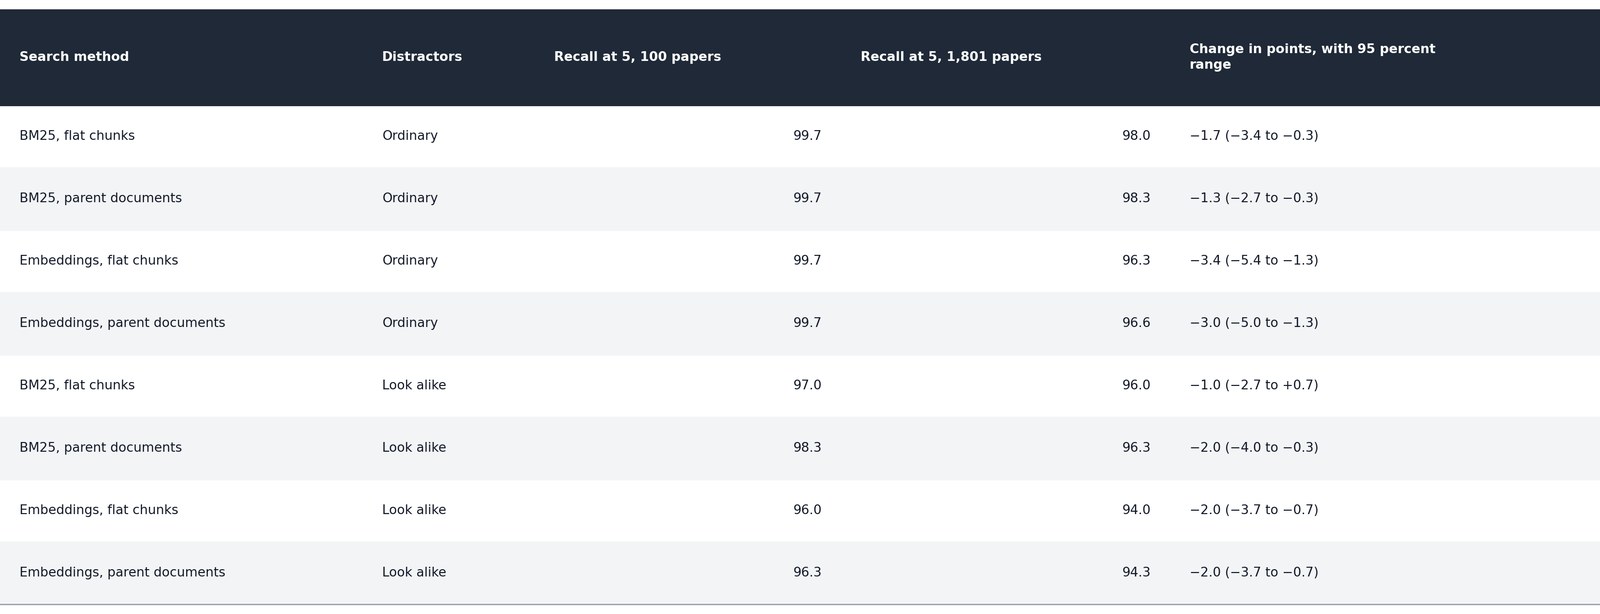
Tablo 1. Süzme sonrasında 298 soruda Recall@5 yüzde olarak. Değer, en küçük ve en büyük koleksiyon arasındaki farktır; eksi sayı puanın düştüğünü gösterir. Benzeri oyalayıcılar rastgele örnekleme içermediği için tek seferde, sıradan oyalayıcılar ise üç örnekleme üzerinden ortalaması alınarak çalıştırıldı.
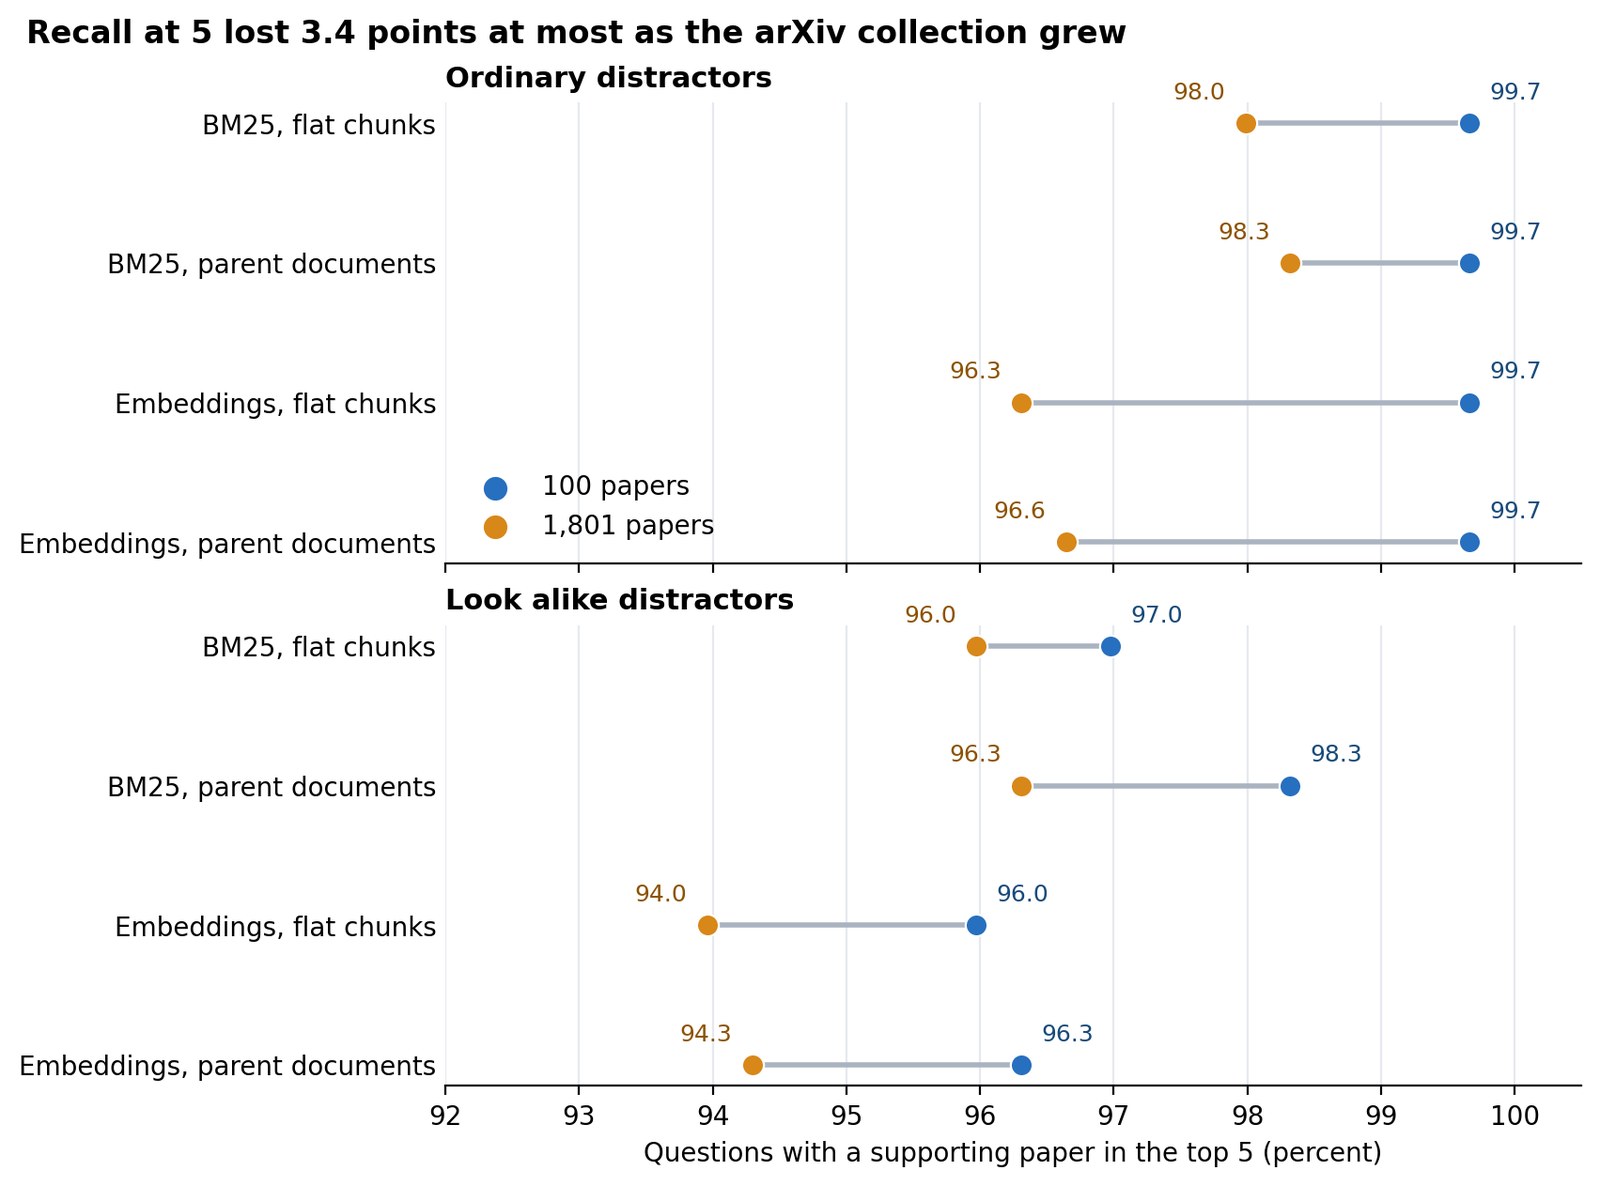
Şekil 1. 100 ve 1.801 makalede Recall@5. Yatay eksen 92 yüzde noktasından başlar, bu yüzden boşluklar olduğundan daha büyük görünür.
Hiçbir kurulum kuralımı karşılamadı. En büyük düşüş, düz parçalar ve sıradan oyalayıcılarla çalışan gömme (embedding) modellerinde 3,4 puandı. Bu, beş puantik barımın altında.
Ama 3,4, yalnızca 298 soruda ölçtüğüm değeri temsil ediyor. Şöyle düşünün: Bir şehirdeki yetişkinlerin boyunu öğrenmek istiyorsunuz ve 298 kişiölçüyorsunuz. Ortalamaları 170 santimetre.
Şehrin tamamının tam olarak 170 ortalamaya sahip olduğunu söylemezsiniz; çünkü farklı bir 298 kişi biraz farklı bir sayı verir. Bunun muhtemelen 168 ile 172 arasında olduğunu söylersiniz.
Düşüşüm de aynı şekilde işler. 3,4 benim 170’imdir ve %95’lik aralık benim 168 ile 172’mdir. Bu kurulum için aralık 1,3 ile 5,4 puan arasında değişti.
Bu aralığın üst sınırı beşin üzerindedir, bu yüzden gerçek bir düşüşün barımın hemen dışında kaldığını elemem mümkün değil. Yalnızca ölçtüğüm düşüşün buna ulaşmadığını söyleyebilirim.
Ana belgeler, 1.801 makalede dört karşılaştırmanın tümünde düz parçalardan 0,4 puan daha yüksekti; bu da BM25 ile her tür oyalayıcı için çalışan gömme modellerini kapsıyor. Aralıklar yoğun şekilde örtüşüyor, bu yüzden buna bir zafer demem. Büyümeden kaynaklanan zararı da açıkça azaltmadılar; çünkü düşüş iki karşılaştırmada daha küçük, birinde daha büyük, birinde ise aynıydı.
Sonuç, yalnızca her iki modelin de işaretlediği 133 makaleyi çıkardığımda ve kağıdı gerçekten desteklemediği için üç soruyu ellediğimde geçerli kaldı. Ayrıca yalnızca bir makaleden bir gerçeği gerektiren sekiz soruyu ellediğimde de geçerli kaldı; çünkü hiçbir makale onları kısmen yanıtlayamaz. Her sürümde en büyük düşüş 3,1 ile 3,4 puan arasında kaldı.
Topladığım retrieval (geri çağırma) tasarım seçimleri, koleksiyon büyüdükçe tutarlı davranmadı. Bu seçimler arama yöntemi (BM25 veya gömme/embodding) ve aramanın döndürdüğü şey—düz parçalar ya da üst (parent) belgelerdi.
Gömme (embodding) yaklaşımı, sıradan dikkat dağıtıcı metinlerde BM25’ten daha fazla kayıp yaşadı; ancak benzer görünümlü metinlerde bu net bir şekilde görülmedi. Üst belgelerin düz parçaları açıkça geçmesi de söz konusu değildi. Bu, yalnızca iki arama yönteminin sınandığı bir test olduğu için, bunu bir kural yerine kendi kurulumunuzu test etmeniz için bir neden olarak değerlendirmelisiniz.
Bir ayrıntı önemli. Benzer görünümlü koleksiyonlar daha düşük başladı: en küçük boyutta 96.0 ile 98.3 arasında, muhtemelen çünkü 99 benzer görünümlü makale bile doğru olan makaleyle güçlü bir rekabet ediyor. Koleksiyonu büyütmek yalnızca bir ya da iki puan daha maliyet getirdi.
Neden bu test çok kolay geldi?
Test için düşülecek çok az alan vardı. Puanlar neredeyse 100’e yakın başladı, koleksiyon 2.000 makalede durdu ve iki tür dikkat dağıtıcı metin için kurabileceğim en büyük koleksiyon 1.801 makaleydi. Gerçek bir belge deposu çok daha büyük olabilir.
Sorular da aynı zamanda o makaleye bakılarak yazıldığı için, makaleyle ortak kelime içerebilir. Arama yöntemi, soru ve cevap aynı sözcük kullanımını paylaştığında kolay bir işe sahip olur. Bu da yöntemin gerçekten insanların yazdığı sorular üzerindeki davranışını gizleyebilir.
Sonucu “kırılma noktası bulunamadı” düzeyinde bırakmak istemedim. Bu yüzden, cevaptan hiç yazılmamış sorular ve çok daha büyük bir koleksiyon aradım.
İkiinci test: 2,68 milyon Wikipedia pasajı
Natural Questions, Wikipedia sayfalarına işaretlenmiş yanıtlarla birlikte gerçek, anonimleştirilmiş arama sorgularını içerir. BEIR, bu sorulardan 3.452’sini 2.681.468 Wikipedia pasajı ve insan tarafından verilmiş uygunluk değerlendirmeleriyle paketler. Bir uygunluk değerlendirmesi, bir pasajın bir soruyu yanıtlamada yardımı olduğu bilinen bir etikettir.
Bu etiketi taşıyan bir pasaj, benim “değerlendirilen pasaj” dediğim şeydir. Bir textbook’un arkasındaki cevap anahtarı gibi çalışır. Bu pasajları, aramaları çalıştırmadan önce işaretlediler ki arama işlemini cevap anahtarıyla karşılaştırabileyim.
Etiketsiz bir pasaj zorunlu olarak yanlış değildir. Ne olumlu ne de olumsuz hiçbir şekilde işaretlenmedikleri için, etiketsiz bir pasaj yine de bir cevap içerebilir.
40 soruyu kodumu kontrol etmek için ayırdım, geri kalan 3.412’sini ise kütle testi için kullandım; bu test, içinde en az bir etiketli pasaj bulunan kütleleri karşılaştırır. Yalnızca BM25 kullandım. Ölçüt, ilk on sonuç içinde en az bir etiketli pasaj çıktığında bir soruyu isabet sayan “10’da başarı”ydı.
10.000, 100.000, 500.000 ve 1.000.000 pasajdan iç içe kümeler kurdum; her büyük küme, kendinden küçük olanları içeriyordu. Her biri üç rastgele örneklemeyle oluşturuldu ve 2.681.468 pasajı tek seferde çalıştırdım. Her küme, tüm etiketli pasajları içeriyor; geri kalanı ise etiketsiz pasajlarla dolduruldu.
Tablo 2. BM25 ile 3.412 Doğal Soru sorgusunda 10’da başarı. Bu tablodaki her sayıyı, kaydedilen sonuç satırlarıyla karşılaştırdım.
Ölçüt her kütlede düştü. Kuralımı sağlayan ilk kütle 100.000 pasajdı; 11,1 puanlık bir düşüş ve 10,2 ile 12,1 puan arasındaki bir aralık verdi. Tam kümede ölçüt, 10.000 pasajlı sonuçtan yaklaşık 40 puan altındaydı.
Şekil 2. Kütle boyutuna göre ilk on sonuç içinde etiketli pasaj bulunan soruların oranı.
BM25, 2.000 makalede en fazla 2 puan kaybederken burada 40 puan kaybetti. İki test; konu, soru tarzı, etiketler ve kütle gibi birçok açıdan farklanır, bu yüzden en büyük etkiye sahip farkın hangisi olduğunu söyleyemem. Söyleyebileceğim şey, ilk testin ikincisini öngörememesidir.
Bu sayının okunmasını zorlaştıran iki şey
İlki, etiketlerin yalnızca olumlu olmasıdır. Etiketmayan bir pasaj soruyu yanıtlamaya yeterli olabilir ve onu döndüren bir arama isabetsiz sayılır. En yüksek dağ hakkında bir soruda, bir pasaj etiketi taşıırken birkaç başkası da Everest’i isimlendiriyor olabilir.
Bunu aşağıda anlatılan yanıt testinde gördüm. 210 sıradan soru-örnekleme çiftinin 21’inde, etiketli hiçbir pasaj ilk on sonuca ulaşamadı. Yanıt modeli yine de bunların 5’inde doğru yanıtı buldu; yaklaşık dörtte bir oranında, yani diğer pasajlar bu bilgiyi taşıyor olmalıydı.
İkincisi, en küçük koleksiyonum doğal bir koleksiyon değil. Her koleksiyon, 10.000 pasajlık bir koleksiyonun yaklaşık %42’sini ve tümünün %0,2’sinden azını oluşturan 4.201 yargılanmış pasajın tamamını içerir.
Böylece düşüşün bir parçası, yargılanmış pasajların koleksiyondaki payının küçülmesidir. Bu aynı zamanda gerçek hayatta da bir koleksiyon büyüdükçe gerçekleşir. En küçük koleksiyonum olağanüstü derecede yüksek bir payla başlar, ancak doğal bir karışım ile bir sürü çalıştırmadım.
Ek pasajlar birbirine benzediğinde ne olur?
Boyut testi milyonlarca pasajı aynı anda değiştirdi. Bu yüzden her soruda tam olarak 20 pasajı değiştiren daha küçük bir test çalıştırdım. Yargılanmış pasajın aynı Wikipedia sayfasından en az 50 başka pasajı olan sorulardan 100 sorunu rastgele örnekleme yaptım.
Yapay zekâ taraması adayları sıralamaya yardımcı oldu, ancak tüm pasajları kendim okudum. Her soru için 50 en yakın aynı sayfa pasajını tam destek (sorunun tamamını yanıtlar), kısmi destek (bir kısmını yanıtlar) veya destek yok (hiçbirini yanıtlamaz) olarak etiketledim. Benzerlik sırasını görmeden yaptım ve herhangi bir arama çalıştırmadan önce bitirdim, böylece sonuçlar etiketlerimi şekillendiremedi.
Her soru için 50 pasaj kullandım çünkü bir pilot çalışma, yardımcı olanlar ayrıldıktan sonra destek olmayan pasajların çok az kalacağını gösterdi.
Bu, 5.006 etiketlenmiş pasaj verdi; bunların 81’i tam, 269’u kısmi ve 4.656’sı destek yoktu. Yalnızca destek olmayan pasajlar rahatsız edici pasaj olarak kullanıldı. Tek değerlendirmeci bendim, bu yüzden bu etiketlerin ikinci bir anotörü yok.
Her soru için 10.000 pasajlık üç koleksiyon çifti kurdum. Sıradan koleksiyonda dolgu rastgeleydi ve gözden geçirdiğim 50 aynı sayfa pasajından hiç gelmedi. Zor koleksiyonda ise dolgu pasajlarının 20’sini, cevabın kendi sayfasından alınan 20 pasajla değiştirdim, böylece iki koleksiyon tam olarak 20 pasajda farklıydı.
Tablo 3. 100 soruda 10’da başarı, üç çekim üzerinden ortalamalı. Düşüş 8,3 puan, 3,7 ile 13,7 puan arasında değişiyor.
Bu düşüş, %90’dan %81’e, %92’den %84’e ve %90’dan %82’e kadar her çekilişte görüldü. 300 soru-çekiliş çifti üzerinden bakıldığında, 25’i “isabet”ten “isabetsiz”e döndü, hiçbirisi ise “isabetsiz”den “isabet”e dönmedi.
Şekil 3. Noktaların her çifti, 100 soruluk bir çekilişi temsil eder; sağdaki sıradan dolgu metni, soldaki ise aynı sayfadaki pasajları gösterir.
Değiştirilen pasajları okurken ne buldum
Kendi etiketlerime ikinci bir bakış olarak, 40 rastgele sorudan birinin değiştirilen pasajını yeniden okudum. Bu yine kendi yargımdı, bağımsız bir değerlendirmeci değil. Bu 40 pasajın 38’i soruyu açıkça yanıtlamıyordu, ikisi ise sınırdaydı.
Değiştirilen pasajların çoğu, örneğin “Lig şampiyonaları (5)” şeklinde bir satır gibi, aynı sayfanın kısa parçalarıydı ve anlamca birbirine yakın değildi. Yüksek sıralanmalarının nedeni, aramanın başlık eşleşmesine metin eşleşmesinin iki katı ağırlık vermesiydi.
Bu nedenle Wake Island sayfasından herhangi bir pasaj, Wake Island hakkındaki bir soru için yüksek sıralanır.
Bu, bu testin ne gösterdiğini değiştirir. Aynı sayfadaki pasajların, başlığa çift ağırlık verilen BM25’i olumsuz etkilediğini gösterir. Anlamca benzer pasajların bir arama yöntemini nasıl kandırabileceğini göstermez ve burada gömme (embedding) testi yapmadım.
Değiştirilen ve “isabet”ten “isabetsiz”e dönen 25 vakayı da inceledim. 21’inde, değiştirilen pasajlar yargılanan pasajın üstüne sıralanıp onu aşağı itti.
Dördünde ise eklenen 20 pasajdan hiçbiri ilk ona ulaşamadı, yine de yargılanan pasaj düşüş gösterdi. BM25, her kelimenin tüm koleksiyon içinde ne kadar yaygın olduğuna bağlı bir sayıya göre pasajları sıralar, dolayısıyla 20 pasajın değiştirilmesi bu sayıları hafifçe etkileyebilir. Bu benim tahminim, test etmedim.
Bir soru sınırdaydı: “ABD, Wake Island’i ne zaman devraldı.” İki değiştirilen pasajı “destek yok” olarak etiketlemiştim, ancak ikinci bir bakışta bu pasajların 1945’te Donanmanın, 1994’te ise Ordunun kontrolü ele aldığını betimlediği görülüyor.
Bu soru üç çekilişin hepsinde değiştiği için, 8.3 puanlık düşüşü biraz abartmış olabilir.
Cevap modeli kötüleşti mi?
5. adımda geri dönüş ve 10. adımda başarı yalnızca aramanın doğru parçayı bulup bulmadığını gösterir, modelin aldığı parçalardan hâlâ cevap verebilip verebilmediğini değil. Bu yüzden küçük açık kaynaklı bir model olan Qwen3 4B’yi kullandım; buna cevap modeli diyorum. Aynı 100 soru ve üç deneme için, sıradan derlemeden en iyi on sonucu, ardından zor derlemeden en iyi on sonucu ona sundum.
Bir soru ve bir deneme için cevap modelinin gördüğü on parçaya bağlam diyorum. Her seferinde aynı yönerjeleri kullandım ve cevap modeline her zaman en olası sonraki kelimeyi seçmesini söyledim, böylece yanıtları çalışmalar arasında değişmedi.
Cevap testini Wikipedia soruları üzerinde çalıştırdım, çünkü ilk testin yanıtları için ücretli bir jüri gerekirdi. Cevap modelinin her çağrısı hiçbir maliyet getirmiyor.
100 sorudan 70’i için, bunları yayımlanmış bir Natural Questions cevap dosyasındaki sorular eşleştirerek kabul edilen yanıtların listelerini (takma adlar olarak adlandırıldı) buldum. Bu dosya Dense Passage Retrieval projesinden geliyor. Bu 70 soruyu puanladım, diğer 30’unu puanlayabileceğim kabul edilen cevap içermiyordu.
Tam eşleşme, bir cevabı yalnızca harf büyük-küçüklüğü, noktalama işaretleri ve “the” gibi kelimeler yok sayıldıktan sonra bir kabul edilen cevaba kelime kelime uyduğunda sayar. Her soru için üç demeti ortalamalıyım ve aralıklar soruları çok kez yeniden örneklemeyle elde edildi.
Dörtlük 4. Cevap referanslarıyla 70 soruda tam eşleşme. İkinci satırda, aynı jüri tarafından değerlendirilen parça her iki bağlamda da öne yerleştirildi, ardından jüri tarafından değerlendirilmeyen dokuz arama sonucu izledi.
Gerçek arama sonuçlarıyla, cevap modeli 11.9 puan düşük skor yaptı. Jüri tarafından değerlendirilen parçayı öne zorladığımda, iki koşul neredeyse eşit oldu. Cevapları kelime örtüşmesine göre puanlamak, kısmi puan veren bu yaklaşım, 12.2 puanlık bir düşüş verdi, böylece puanlayıcının seçimi sonucu yönlendirmedi.
Skor, yargılanan pasajın hangi koleksiyondan geldiğinden çok, yargılanan pasajın kaçıncı sırada olduğuna bağlıydı. Yargılanan pasaj ilk sıradayken, tam eşleşme sıradan bağlamlarda %65,8, zor bağlamlarda %68,3 olarak ölçüldü. İkinci ile beşinci sıralarda bu oranlar sırasıyla %41,9 ve %42,6 oldu; ancak bu yalnızca 31 sıradan ve 68 bağlamlı kapsıyor.
Yani zor arama, asıl olarak yargılanan pasajı daha sık on birinci sıraya indirmiş ya da on birinci sıranın dışına itmiş olmasıyla sonuç verdi. Her koşulda 70 soru ve üç çekimden oluşan 210 bağlam bulunuyor. Yargılanan pasaj, sıradan bağlamların 210’undan 152’sinde ilk sıradaydı ve zor bağlamların 210’undan 82’sinde.
Teenage Mutant Ninja Turtles’ın ne zaman çıktığına dair soruyu alın. Sıradan arama, yargılanan pasajı ilk sıraya koydu ve cevap modeli 1984’ü söyledi; zor arama ise bu pasajı sekizinci ya da dokuzuncu sıraya taşıdı ve cevap modeli 1989’u söyledi.
Tam eşleşme, aynı zamanda makul cevapları da yanlış saydı. Ev sahibi ülkelerin tam listesi, tek bir takma ada eşleşmediği için yanlış kabul edildi ve “1954”, “27 Haziran 1954″‘ün altında puan aldı. Yargılanan pasajın ilk sıraya yerleştirildiği sonuç, cevap modelinin dikkat dağıtıcı unsurları görmezden geldiğini kanıtlamaz; çünkü bu ölçüm birkaç puanlık bir kaybı da içinde barındırıyor.
Kendi sisteminizde neye bakmalısınız?
Bu, tek bir arama yöntemi ve küçük bir modele dayanan bir pratik tahminidir.
Tablo 5. Sonuca eylem.
Kaynaklar
[1] Kwiatkowski ve ark., Natural Questions: a Benchmark for Question Answering Research, 2019 (CC BY-SA 3.0).
[2] Thakur ve ark., BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models, 2021.
[3] Google, Natural Questions data and license.
[4] Karpukhin ve ark., Dense Passage Retrieval test references for Natural Questions.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔















Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.