
Yapay zeka sistemlerinde “doğruluk” artık bir slogan değil, mühendislik disiplinine dönüştü. Birçok büyük dil modeli sisteminde şu temel hata tekrarlanıyor: birkaç belge çekiliyor, bağlama konuyor, akıcı ve bağlantılı bir cevap üretiliyor, ardından bu cevap “dayanaklı” (grounded) olarak kabul ediliyor. Ancak bu yaklaşım, gerçek dünyada iddialar için somut kanıt sunmayı gerektirdiğinde çoğu zaman yetersiz kalıyor. Bir sistem artık sadece olası kanıt adaylarına erişim sağlıyor; bir belgenin kendi yaptığı iddiayı gerçekten desteklediğini kanıtlayamıyor. Bu fark, RAG (Belgeye Dayalı Artırılmış Üretim) teknolojisinin kendisine değil, onu “doğruluk kaynağı” olarak görme biçimine karşı bir uyarı niteliğinde. Gerçek hedef artık “belgelere dayalı alıntı” değil, her maddeli iddiayı denetlenebilir şekilde destekleyen, her önemli kararın izlenebilir olduğu ve belirsizliğin birincil bir temsil bulduğu kanıta dayalı bir anlatım sistemi.
Bu yaklaşımın merkezinde, RAG’ın birimi olan belgeler yerine “atomik iddia” kavramı yer alıyor. Modelden önce cilalı bir metin üretmek yerine, sistem önce bir iddia defteri (claim ledger) üretmek istiyor. Bu defter, sistemin yayınlamayı amaçladığı tüm atomik iddiaların listesiyle birlikte her önermeye eklenen kanıt ve denetim bilgilerini içeriyor. Böylece bir cümle, şeffaf bir model çıktısından, denetlenebilir bir teknik nesneye dönüştürülüyor. Kaynak bağlantısı işe yarar, ancak iddia-kanıt grafiği gerçekten uygulanabilir.
İrade Karşı İmkânsız Kapı: Yayınlanma Fırsatı
Sistemin kalbine konulacak kural şu şekilde özetlenebilir: Dayanıklı bir iddia yeterli dayanağa sahip değilse, bu zayıf bir dayanaklılık değil, dört şeyden birini yapma talebidir. İddia yeniden düzenlenebilir, sistem kendini tutabilir, iddiayı açıkça çıkarım olarak etiketleyebilir ya da bunu bir denetçiye (insan ya da model) yükseltebilir. Bu kuralı uygulamak, aslında bir ürün kararı zorunluluğu yaratır: Sistem, dayanağı olmayan akıcılığı mı yoksa görünür belirsizliği mi tercih edecek? Bir okuyucunun anlatıya göre eyleme geçebileceği her iş akışında, özellikle bu eylemin gerçek sonuçları taşıyabileceği durumlarda, zarif bir cümleden çok görünür bir “yeterli kanıt yok” durumunu teslim etmek tercih ediliyor.
Bu aşamada ölçüm yapmadan önce politika tanımlanması gerekiyor: Hangi şey bir atomik iddia sayılır? Doğrudan destek ne sayılır? Sentez ne zaman izin verilir? Çıkarışlar nasıl yönetilir? Hangi iddılar maddelidir? Bir iddia ne zaman uzman denetçi ister? Bunlar uygulamanın detayları değil; sistemin doğruluk, çağrılma, kapsam ve kendini tutmama metriklerinin ne anlama geleceğini belirleyen şeylerdir. Politika ilk tanımlanmazsa, değerlendirme sayıları yalnızca tanımlı olmayan bir soruya verilen keskin cevaplar olur.
Kanıta Dayalı Bir Mimari
Bu süreci gerçekten hayata geçiren mimari oldukça basit, doğrusal ve altı katmandan oluşuyor. İlk katmanda, içerik bir indeks içine girmeden önce kaynak yetkisi, güncellik izinleri ve stabil bir anlık görüntü ya da hash belirleniyor. İkinci katmanda, çıktı bir bağlam değil; üreticinin kullanabileceği kaynak kimliklerinin ve kesin kanıt aralıklarının izin listesi (allowlist) olarak sunuluyor. Üçüncü katmanda, model atomik iddiaları öneriyor, bunları kanıt kayıtlarına bağlıyor, belirsizliği kaydediyor ve yalnızca sonra okunabilir metni gerçekleştiriyor. Dördüncü katmanda, destek, tamamlanma, kaynak kuralları, çıkarış yönetimi ve sistemin iddia politikasına uyumu test ediliyor. Beşinci katmanda, insan onaylayabilir, düzenleyebilir, kanıt ister, kendini tutabilir ya da yayını durdurabilir. Altıncı katmanda ise kanıt paketi, değerlendirme sonuçları, sistem sürümleri, onay ve geri alım hedefleri saklanıyor.
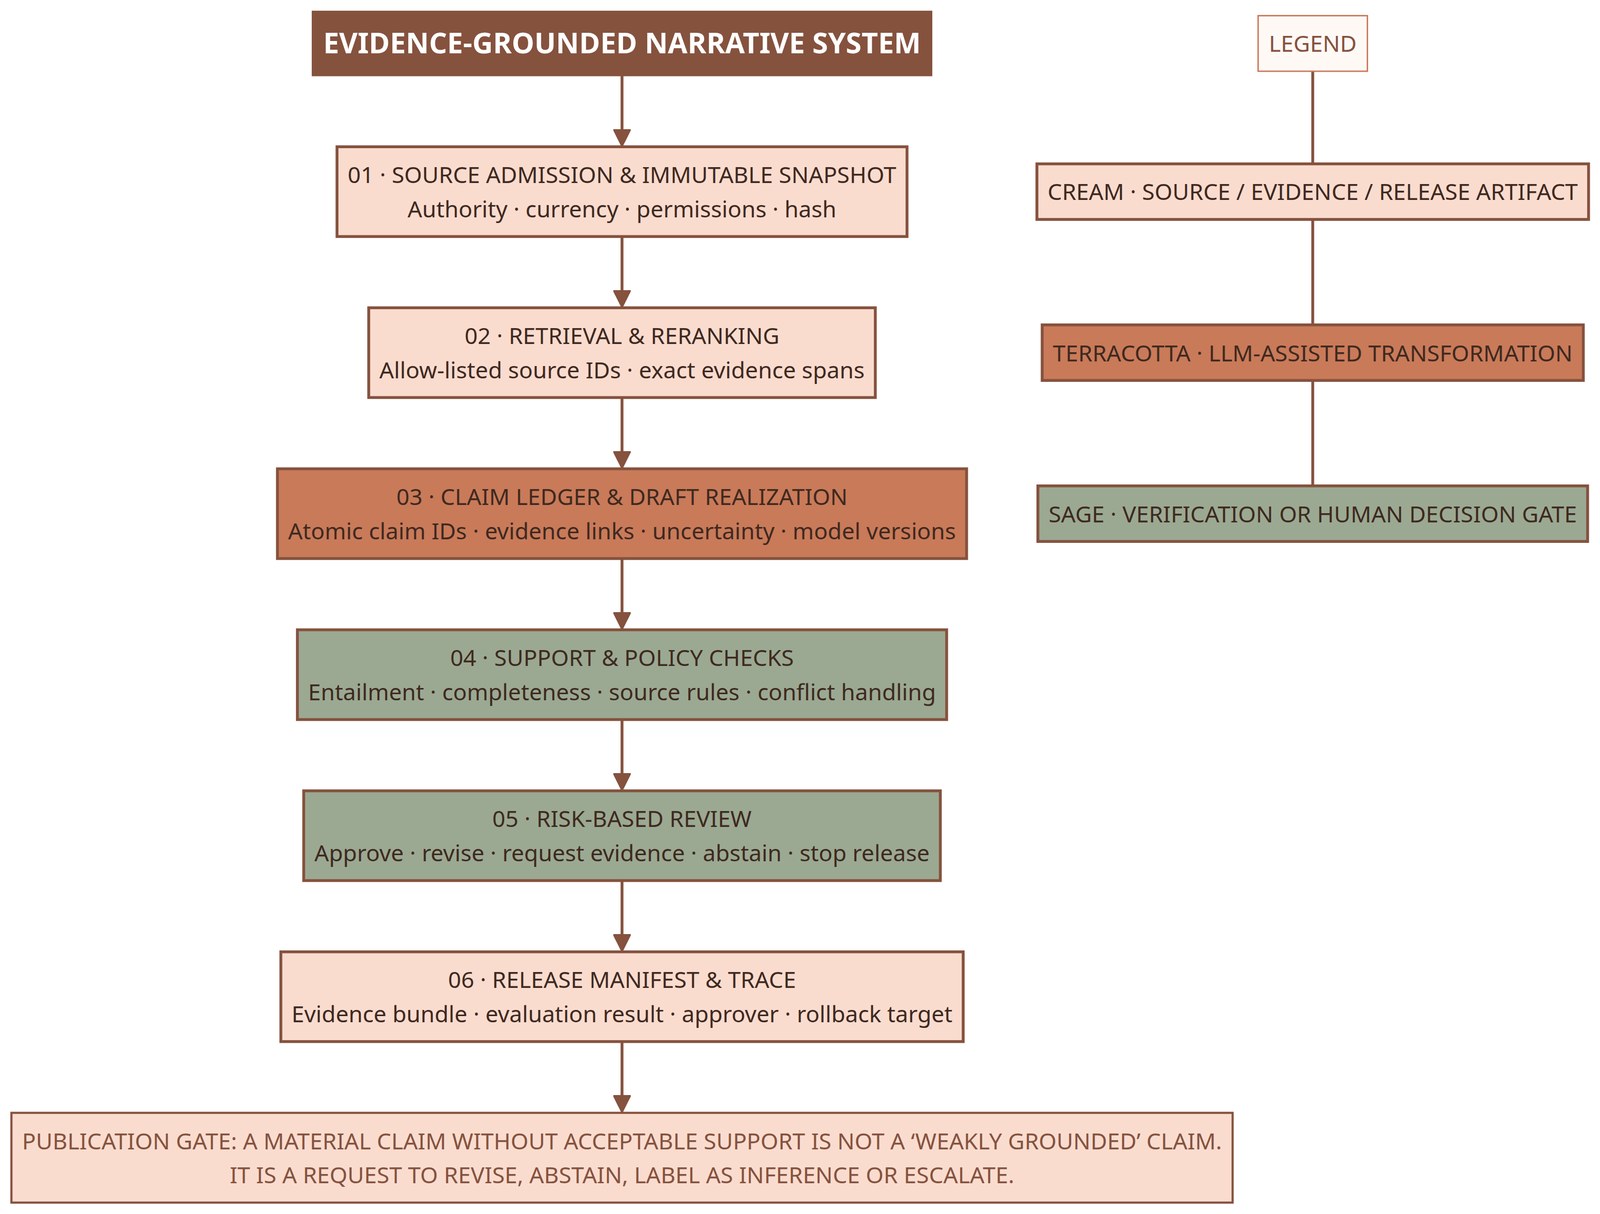
Bu mimarinin sıradan bir RAG’dan farkı şudur: kaynaklar bir veritabanına rastgele dökülmemiş, önceden onaylanmış durumdadır; iddialardaki belirsizlik açık biçimde değerlendirilir; ve insan denetimi mimarinin merkezinde yer alır.
Yazarın açıklaması
Bu son nokta – insan denetimi – klasik yazılım tasarımından bir kopuşu işaretler. Klasik tasarımda insanlar zincirin sonundaydı, kullanıcı olarak. Ancak doğruluk ön planda olduğu ortamlarda belirsiz olmayan yapay zeka sistemleriyle uğraşırken, insan-çevresinde (human-in-the-loop) tasarım zorunluluğu doğuyor.
Üreticiyi Kanıtlara Bağlamak
En basit teknik hata, üreticinin istediği alanda rastgele alıntılar basmasına izin vermektir. Eğer üretim komutumuz modele görünen herhangi bir URL dizisini basmasına izin veriyorsa, bir alıntı denetimi yerine bir alıntı renderlayıcı yaratmış oluruz. Bu tehlike RAG sistemlerinde de içgüdüsel olarak mevcuttur. Bu riski azaltmak için, üretici çekilen kaynak kimliklerinin ve onaylı kanıt aralıklarının izin listesine bağlanır. Model artık verilen kanıtlar arasında seçim yapabilir, ancak bu verilen küme dışında bir kaynak kimliği uyduramaz.
Bundan öte, renderlanmış metinden önce yapılandırılmış çıktı zorunludur. Minimal bir nesne, iddia kimliği, iddia metni, kanıt aralığı kimlikleri, destek durumu, belirsizlik, kaynak yetkisi, alıntı renderlaması, yükseltme nedeni ve taslak metni içerebilir. Ardından deterministik kod, olmayan kaynak kimliklerini, çözünmeyen aralıkları, gerekli kanıtı olmayan iddaları ya da deftere uymayan renderlanmış alıntıları reddedebilir. Katı JSON şeması ya da dilbilgisiyle sınırlı çıktı burada değerlidir; ayrıştırılabilirliği, tipli durumları ve öngörülebilir bir hata yolu destekler. Ancak bir şema, bir alanın gerçekten var olduğunu garanti edebilir, kanıtın iddiayı desteklediğini garanti edemez.
Bir şema, support_status adı verilen bir sayısal değeri garanti edebilir. Ancak modelin bu değişkene doğru değeri atadığını garanti edemez. Form bir denetimin kendisidir; destek ise ayrı bir denetimin kendisidir.
Yazarın açıklaması
Alıntıları Test Edebilmek
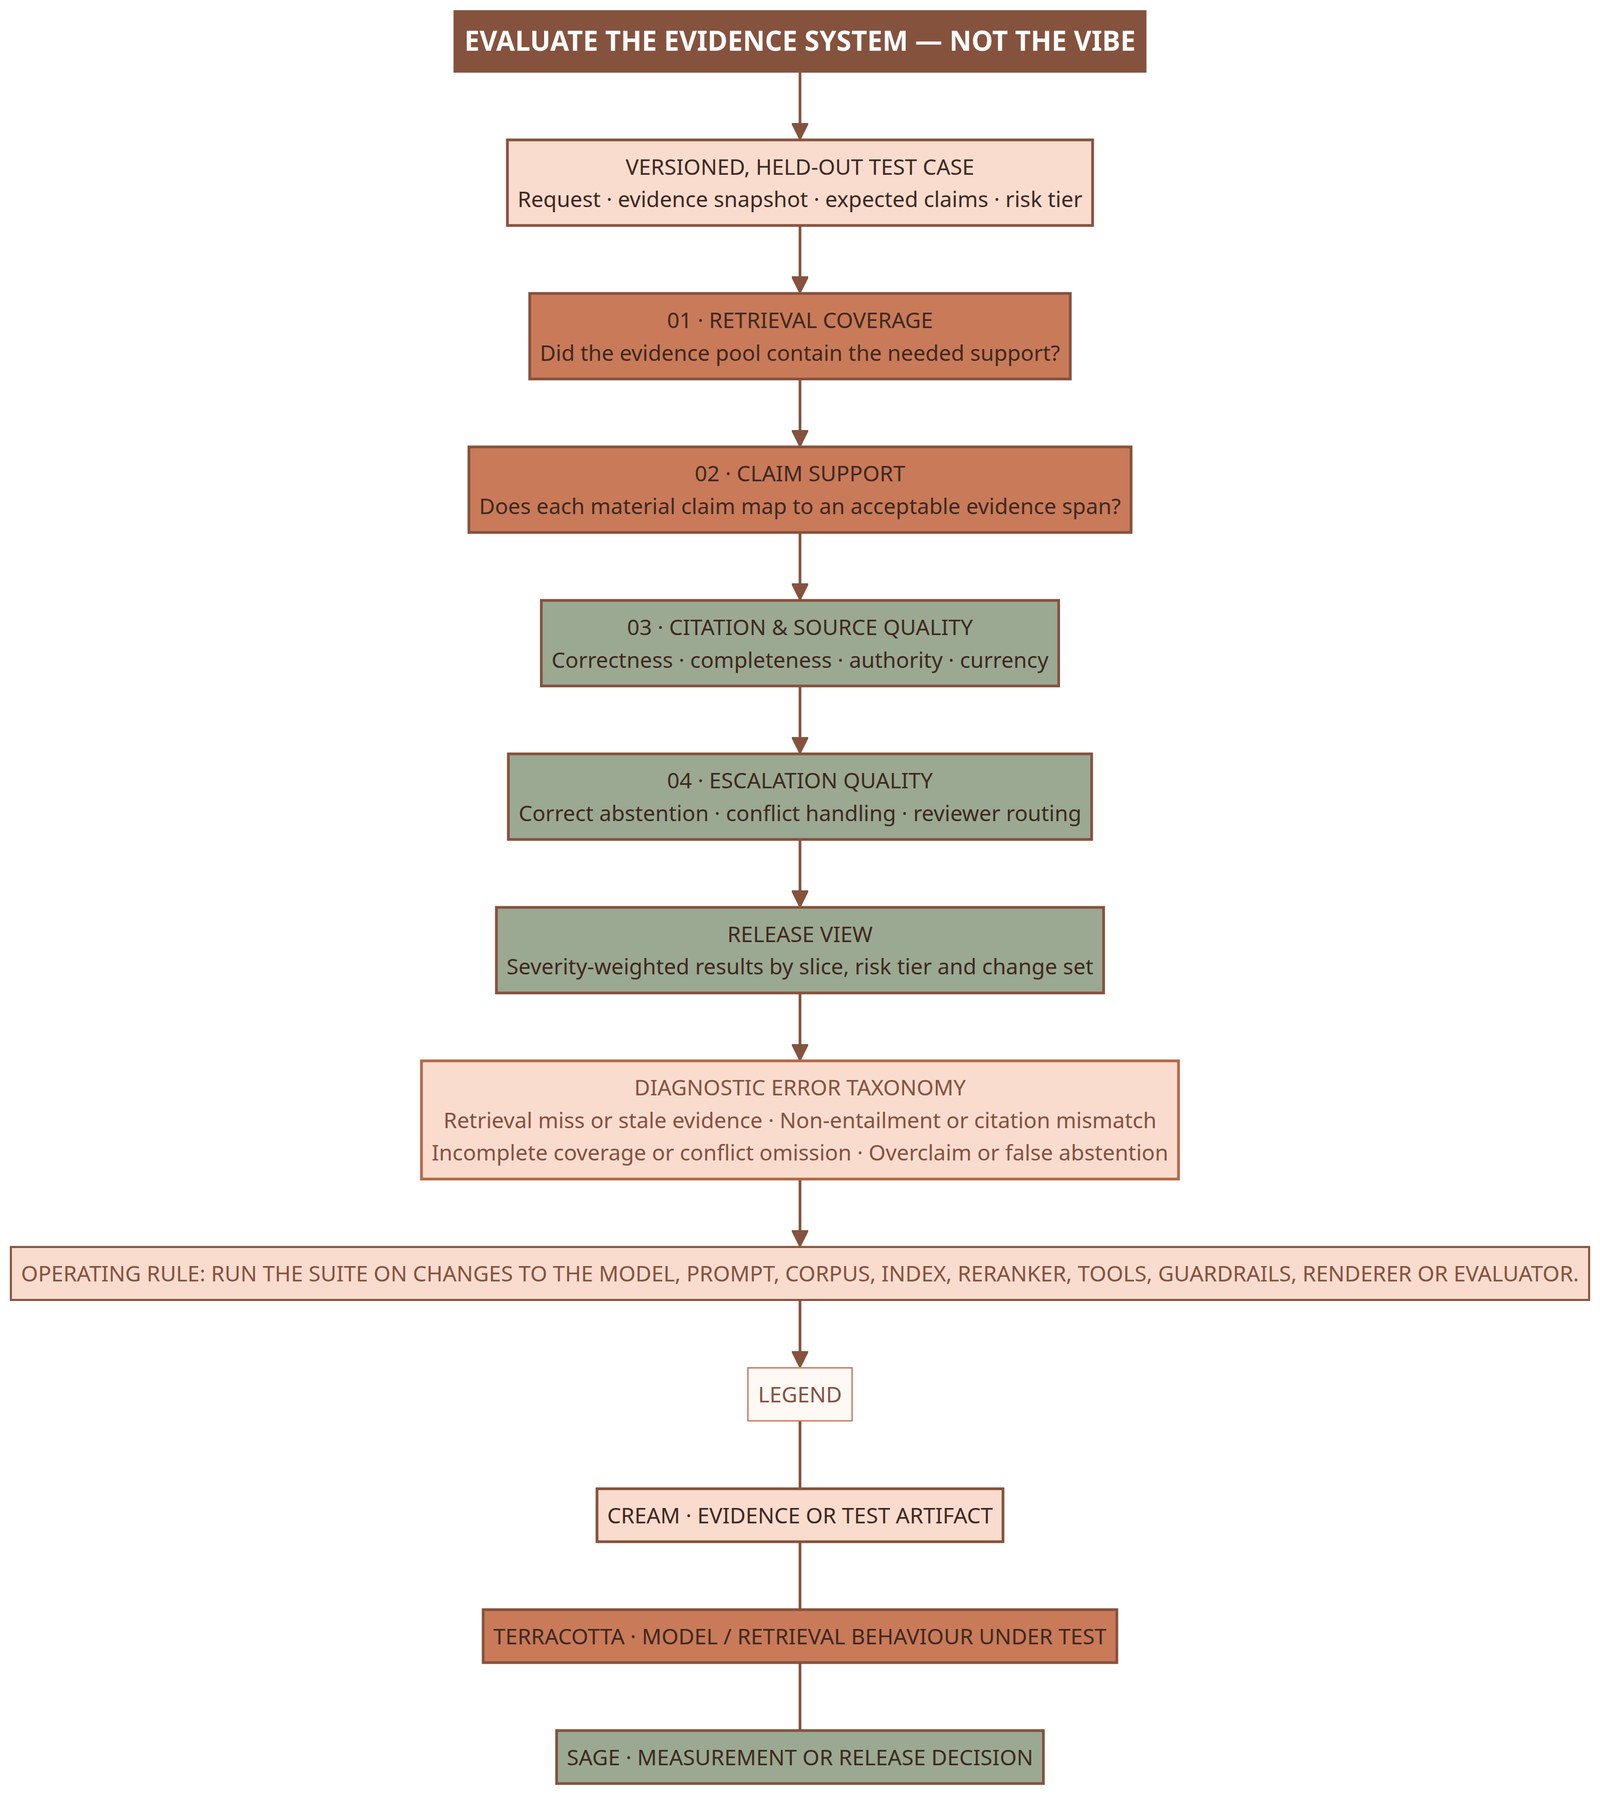
Bir alıntı üç şekilde başarısız olabilir. Yanlış olabilir: kaynak gerçek, ancak cümleyi desteklemez. Eksik olabilir: cevap, yeterli kanıtı olmayan maddeli bir iddia içerir. Ya da kaynak kendisi görev için zayıf olabilir: eski, yetkisiz ya da kapsam dışı. Bu nedenle “alıntı var” tek başına neredeyse kullanısız bir metriktir. Bir paragrafın sonunda duran iyi bir kaynak, otomatik olarak içindeki her iddiayı desteklemez.
ALCE – alıntılı uzun biçimli cevapların otomatik değerlendirilmesi anlamına gelen – soru-cevap sistemleri için alıntı üreten bir araştırma benchmarkıdır. Katkısı, cevap kalitesini alıntı doğruluğu ve alıntı tamamlanmasıyla ayırmaktır. Basitçe söylersek: hem “cevap işe yarar mı?” hem de “alıntılar gerçekten desteklemesi gereken iddaları destekliyor mu?” sorularını birlikte sorar. Bu, üretimde ihtiyacımız olan ayrımın kendisidir. Uygulamada, kanıtı iddia düzeyinde bağlamak yeterlidir; bir paragrafa tüm belgeyi bağlamak yerine, belirli bir alıntıyı ya da kaynak aralığını bir atomik iddaya bağlamak yeterlidir.
Kanıt Sistemini, Havayı Değil
Kanıt defteri elde edildikten sonra değerlendirme somutlaşır. Bir sistem kaynağı kaçırabilir, yanlış aralığı seçebilir, doğru aralığı abartabilir, maddeli bir iddia için kanıtı atlayabilir ya da gerçekten iyi desteklenen bir iddayı kendinden tutabilir. Tek bir “dayanaklılık” puanı, hangi başarısızlığın gerçekleştiğini bize söylemez. Başlangıç, sürümlü, tutulmuş bir test durumundan yapılmalı: istek, kanıt anlık görüntüsü, beklenen iddalar, destek politikası, izin verilen kendini tutma davranışı ve bir risk seviyesi. Ardından dört şey ölçülür.
Kaçırılma kapsamı: Kanıt havuzu
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.

Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.