

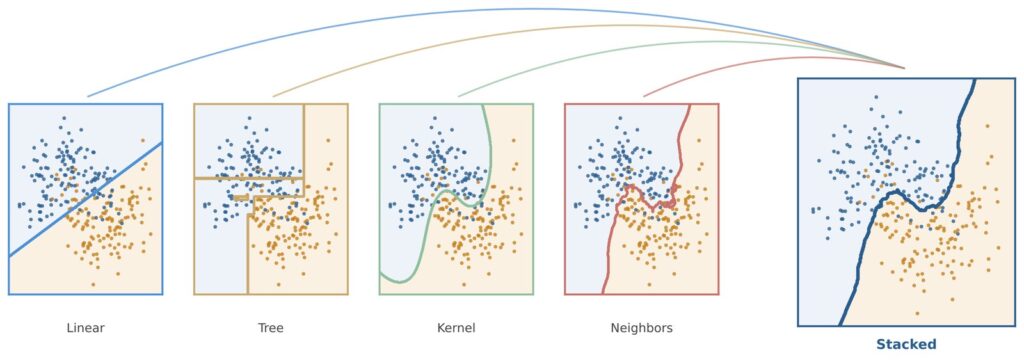
Toward Data Science sitesinde yayımlanan “Does Stacking Beat Your Best Model?” başlıklı makale, makine öğreniminde sıkça kutsal kabul edilen bir uygulamanın geçerlilik koşulunu deneysel olarak sınıyor: Birden fazla modelin tahminlerini bir meta-modelle birleştirerek oluşturulan stacking (yığın) yöntemini gerçekten en iyi tek modele tercih etmeli miyiz.
Makalenin temel iddiası belirsiz değil, test edilebilir biçimde net: Stacking’in kazancı, taban modellerin birbirinden farklı hatalar yapmasına oranla büyüyor. Model A’ın doğru yaptığı şeyi model B’nin yanlış yaptığı durumlarda meta-model her modeli güvenilir olduğu yerde güvenebilir; ancak tüm taban modeller aynı hatayı yapıyorsa tamamlayıcı bir şey kalmaz ve stacking neredeyse hiçbir katkı sağlamaz.

Bu iddiayı sınamak için yazar tek bir veri setinde iki koşul kurdu: Biri stacking’e gerçekten yardımcı olabilecek kadar çeşitlilik sağlayan, diğeri ise bu alanı yok eden koşul. Sonuçlar tek bir eğitim/test ayrımından değil, tekrarlanan katmanlı 5-fold çapraz doğrulamadan (3 tekrar, toplam 15 kat) geliyor — makalede daha önceki bir değerlendirmede tek bölümlü sayıların beklenenden fazla salındığı belirtilen sınırlamaya yönelik bir sağlamlık düzeltmesi.
Veri seti, sklearn.datasets.make_classification ile üretilmiş ikili sınıflandırma için sentetik bir problem: 2.000 örnek, 20 özellik, gerçekçi gürültü ve sınıf örtüşmesi. Açıkça sentetik olması, taban modellerin çeşitliliğinin rastlantıya değil bilinçli seçime dayanması için özenle tercih edildiğini açıklıyor.
İlk koşul, stacking teorisinin üzerine kurulu olduğu çeşitlilik koşulu: Lojistik regresyon (doğrusal), bir karar ağacı (eksen paralel bölümler), SVM (çekirdek tabanlı, temelden farklı bir karar sınırı) ve k-en yakın komşu (örnek tabanlı, hiç açık sınır olmayan). Dört gerçekten farklı karar sınırı çizme biçimi.
İkinci koşul ise stacking teorisinin bilerek aleyhine çalışan korelasyon koşulu: Rastlantısal orman, gradan artırma ve extra-trees — aynı temel fikrin üç varyantı (ağaç toplulukları) ve çeşitli gruptan çok daha sıkı birbirleriyle uyması muhtemel modeller.
Çeşitli taban modeller koşulunda stacking görevini üstlendi: 0.830’a karşı en iyi tek modelin 0.820’si, hata çubukları (stacking için ±0.015, tek model için ±0.012) neredeyse örtüşmeyince gerçek ve anlamlı bir fark olarak öne çıkıyor. Dört modelin gerçekten farklı hatalar yapması meta-modele birleştirilecek gerçek tamamlayıcı sinyaller verdi — stacking tam da teorisinin öngördüğü gibi davrandı.
Korelasyonlu modeller koşulunda ise stacking’in artısı neredeyse kayboldu: 0.835’e karşı 0.834, yani ±0.014 ve ±0.019 standart sapmaların içine tamamen gömülen 0.1’lik bir fark. Ağaç toplulukları varyantlarının birbirleriyle yeterince uyumlu olması, meta-modelin kullanabileceği neredeyse hiçbir şey bırakmadı — teorisinin kendi öngördüğü gibi: hata çeşitliliği yoksa stacking kazancı da yok.
Sürpriz ise oy kullanmanın her iki koşulda da en iyi tek modelden düşük çıkması: Stacking değil, düz ortalamalama. Çeşitli durumda 0.820’ye karşı 0.809, korelasyonlu durumda 0.834’e karşı 0.829. Basit oy kullanmanın karışımdaki gerçekten zayıf bir modeli ağırlıksızlaştıracak mekanizması yok; aşağı çeken taban modeli de dahil herkesi eşit oranlarda ortalamaya alıyor. Stacking’in meta-modelinin ise her taban modele ne kadar güvenileceğini öğrenmesi, işte bu yüzden aynı kaderi yaşamamasını açıklıyor.
Çeşitli modelset koşulunda stacking’in gerçek bir 1 puanlık doğruluk kazancı için ödediği 23.7 saniye çoğu gerçek ayar makul bir takas. Korelasyonlu durumda ise çok daha zor satılan bir şey: İstatistiksel sıfırdan ayrışmayan 0.1’lik bir fark için tek modelin eğitim süresinin yaklaşık 35 katı, yani 125.9 saniye. Bu araştırmada yuvarlama hatası değil; düzenli yeniden eğitilen bir hattarda sık sık ödenen gerçek maliyet.
Neden oy kullanma stacking kazanırken bile kaybetti — makalenin en sezgisel olmayan sonucu olarak kendi açıklamasını hak ediyor: Oy kullanma ve stacking aynı taban modelleri kullanır, tek fark onların nasıl birleştirildiğidir. Oy kullanma her taban modelin tahmininin sabit, eşit ağırlıklı ortalamasını alır; stacking ise hangi modellerin hangi örnek türlerinde gerçekten güvenilir olduğunu öğrenerek doğru ağırlığı bulmaya adanmış ikinci bir modeli eğitir.
Çeşitli koşulda KNN ve düz karar ağacı dört taban modelin en zayıfıydı — sağlam ama SVM’in açıkça gerisinde. Oy kullanma bunu fark edip ağırlıklarını düşürecek mekanizmaya sahip değil; dördünü eşit oranlarda ortalamaya alıyor ve iki zayıfı ensemble’i en güçlü tek modelin kendi başına ulaştığı seviyenin altına çekiyor. Stacking’in meta-modeli ise dört modelden gelen out-of-fold tahminleriyle eğitilerek “SVM’e daha çok, ağaca daha az güven”e yakın bir şey öğreniyor — işte en iyi tek modeli zayıfı tarafından aşağı çekilmek yerine geçmesini sağlayan mekanizma bu.
Bu karşılaştırmanın eksik kaldığı noktalar üçlü: Tek sentetik veri seti — çeşitlilik-korelasyon örüntüsü genel olarak topluluk teorisinin bir özelliği olsa da kesin sayılar (stacking’in artısının büyüklüğü, oy kullanmanın açığının büyüklüğü) farklı gürültü profiline sahip gerçek, daha dağınık veride kayar. Taban model seçimleri tükenmeyen bir aramadan değil — dört “çeşitli” ya da üç “korelasyonlu” modelin farklı seçimi bu spesifik sayıları değiştirebilir; ancak temel mekanizma (çeşitliliğin meta-modelin değer katması için alan açması) hangi modellerin çeşitli yoksa korelasyonlu olduğunu temsil ettiğinden bağımsız olarak korunmalıdır. Yalnızca ikili sınıflandırma — çok sınıflı veya regresyon stacking’i, özellikle meta-modelin çapraz doğrulamasının nasıl yapılandırıldığı konusunda farklı davranabilir.
Asıl karar çerçevesi: En iyi tek modeliniz yerine bir stacking ensemble’ına yönelmeden önce üç soru soruluyor. Aday taban modeller gerçekten farklı hatalar mı yapıyor, yoksa sadece farklı isimleri mi var — üç ağaç topluluğu varyantı çeşitli gibi görünse de çoğunlukla stacking için asıl önemli olan anlamda değil; çeşitlilik varsaymadan önce taban modellerin tahminlerinin (veya hatalarının) korelasyonunu kontrol edin, bu tek satır kod ile stacking’in ne kadar yardımcı olacağını doğrudan öngörür. Doğruluk kazancı varsa, eğer varsa, kat-ktan kata gürültünüzden büyük mü — tek bir train/test ayrımı size gerçekten sadece gürültü olan bir stacking “zaferini” memnuniyetle raporlar; böyle bir karşılaştırmaya güvenmeden önce ortalamaya değil yayılıma bakın. Bir yığın ile tek modelin gerçek yeniden eğitim sıklığınızda asıl maliyeti nedir — 126 saniye bir kez hiçbir şey değildir; ancak gürültü tabanının içinde kalan bir kazanç için yıl boyu her gece 126 saniye, örtük olarak ödemekten çok, açıkça adlandırılması gereken bir maliyet.
Sonuç olarak “stacking en iyi tek modelinizi geçer” belirli, kontrol edilebilir koşulda — taban modellerin hatalar yapmadaki gerçek çeşitlilikte— ve bunun dışında considerably daha az doğru. Buradaki ilginç ve uygulanabilir bulgu soyut olarak stacking ile tek modeller arasındaki mücadele değil; naive oy kullanmanın, stacking’in tam da aynı taban modelleri kullandığı halde geride kalırken bile en bireysel modelinizin altında çıkabilmesidir. Modelleri birleştirmek ücretsiz değildir ve ortalamak iyi bir biçimde birleştirmekle aynı şey değildir — meta-modelin “kime ne zaman güvenileceğini” öğrenme yeteneği, basit bir ortalamanın çoğaltamadığı gerçek iş yapıyor.
Valuta questo sviluppo nella Community
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.




A te la parola.
Condividi la tua esperienza, domande e contributi. Il tuo indirizzo email non sarà pubblicato.