

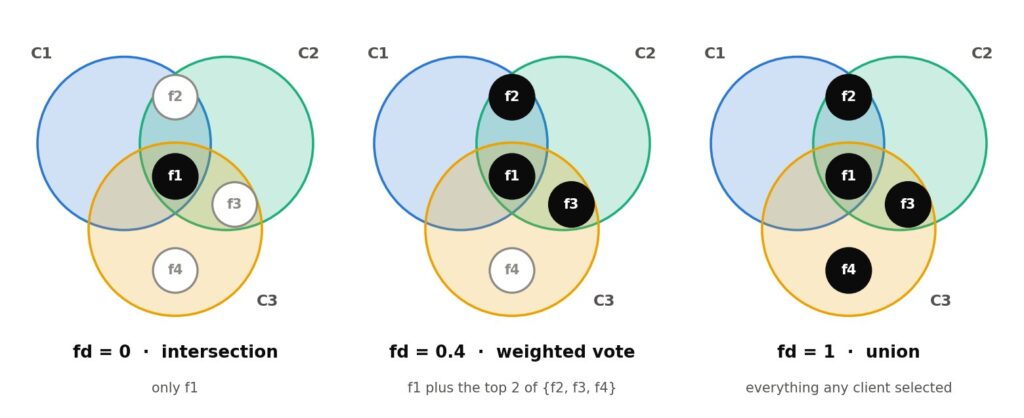
Fedeleştirilmiş öğrenmede verileri paylaşmayan birden fazla kurumun ortak bir model eğitebilmesi için standart yöntem olan FedAvg, hangi özelliklerin modele dahil edileceğine karar vermez. Bu açığı doldurmak amacıyla geliştirilen “Feature Election” (Özellik Seçimi) yöntemi, her sitenin kendi kullandığı seçiciyi yerel veri üzerinde çalıştırması ve yalnızca oy sonuçlarını sunması prensibine dayanıyor.
towards-data-science sitesinde yayımlanan habere göre, yöntem ilk olarak Christofilogiannis ve arkadaşlarının 2025’te sunduğu FLASH çerçevesinde tanımlandı. Her site kendi seçtiği özellikler için “evet/hayır” biçiminde bir maske ile bu özelliklere dair tercih skorlarını sunarken ham veri satırları ya da gradyanlar hiçbir zaman kurumdan ayrılmıyor.

Yöntemin temel mantığı şu işleyişle özetlenebiliyor: Her site, yerel verisi üzerinde istediği bir özellik seçiciyi çalıştırır. Her özellik için evet/hayır biçiminde bir maske ve o özelliğe dair güçlü bir tercih skor üretir; her iki bilgiyi de kendi eğitim örnek sayısılarıyla birlikte sunucuya gönderir.
Sunucu, tüm sitelerin ortaklaşa seçtiği özellikleri hep korur, hiçbirinin seçmediği özellikleri ise tamamen eler. Tartışmalı konular, yani en az bir sitenin istediği ancak başka bir sitenin reddettiği özellikler için oy verme süreci devreye girer.
Bu aşamada özgürlük derecesi (fd) adı verilen tek bir parametre, tartışmalı kümeden kaç özelliğin modele dahil edileceğini belirler. Bu değer 0 ile 1 arasında değişir; 0’da sunucu yalnızca ortak özellikleri korurken, 1’de tüm seçimlerin birleşimini dikkate alır.
Sunucu, her sitenin skorlarını ayrı ayrı normalize ederek farklı ölçeklerdeki verileri aynı 0-1 aralığına getirir. Ardından site ağırlıklarını örnek sayısına göre hesaplarak ($w_i = n_i / sum(n)$) özelliğe dair birleşik oy verir ve tartışmalı özellikler arasından en yüksek oya sahip olanları korur.
Özgürlük derecesi iki farklı hatayı dengeletir. fd değeri 0’a yaklaştığında her site veto hakkına sahip olur; bu da dar seçici kullanan bir sitenin modeli diğerleri için küçültmesine yol açar. Değer 1’e yaklaştığında ise gevşek seçici kullanan her sitenin gürültü özelliklerinin tümünü etkileme riski doğar.
Yöntemin NumPy ile temel uygulaması, maskelerin yalnızca hangi özelliklerin tartışmalı kümede olduğunu belirlemesini, oy verme sürecinde ise tüm sitelerin skorlarının dikkate alınmasını öngörüyor. Bu nedenle en küçük sitede seçilen bir özelliğin bile büyük sitenin skoru düşükse kaybetme ihtimali bulunuyor.
Ayrıntılı sayısal deneyler için geliştirici, gönderilen uygulamayı bir FLARE işi olarak çalıştırıyor. Sunucuda bir FeatureElectionController ve her sitede bir FeatureElectionExecutor kurularak üç site arasında görev alışverişi yapılıyor. Modül, 2.8.0 sürümünden itibaren nvflare paketinde yer alıyor; geliştirici 2.9.0 sürümünü kullandı.
Geliştiricinin çalıştırdığı tabloda 100 özellik bulunuyor: 12’si bilgilendirici, 8’i tekrarlayan (bilgilendirici özelliklerin doğrusal kombinasyonları) ve 80’i gürültü. Her siteye farklı bir seçici atanıyor; en büyük sitede Lasso, ikinci sırada rastgele orman, en küçük sitede ise karşılıklı bilgi seçimi kullanılıyor.
Geliştirici beş farklı özgürlük derecesinde ve bir kez otomatik ayarlamayla deneyi çalıştırdı. Sonuçlar, Lasso kullanan sitenin kendi verisinde 35 özelliği (20 bilgilendiriciden 12’sini) seçerken, rastgele orman sitesinin tüm 20sini ve karşılıklı bilgi sitesinin ise 15’ini seçtiğini gösterdi.
Özgürlük derecesi 0’da en dar seçici veto yaparak yalnızca 10 bilgilendirici özelliği korurken, 1’de her sitenin gürültüsü modele karışıyor ve maske 61 gürültü özelliğini taşıyor. 0.5 değeri ise tüm 20 bilgilencerici özelliği geri getirirken gürültüyü birleşimin yarısından az olan 28’e indiriyor.
Otomatik ayarlama burada tek bir sınırlamaya sahip. Geliştiricinin çalıştırmasında otomatik ayarlama, 0.5 ile 0.7 arasında özgürlük dereceleri denedi ve doğrulama F1’in 0.776 ile 0.781 arasında olduğunu görerek 55 özellikli 0.6 değerini seçti.
Hill climbing yalnızca F1’i optimize ettiği için, F1 bu kadar düz olduğunda daha küçük maskeyi tercih edecek bir sebep yoktu; oysa 0.5 değeri aynı sinyali 7 daha az gürültü özelliğiyle sağlıyordu.
Geliştiricinin FLASH makalesindeki değerlendirme, üç istemci üzerinde FedAvg ile eğitilen modellerde gerçekleştirildi. Üç model (Gauss Naive Bayes, lineer SGD sınıflandırıcı ve MLP), dört veri seti (Mushroom, Adult Income, Heart Disease, Wisconsin Breast Cancer) ve üç yerel seçici kullanıldı.
Lasso Tibshirani’nin 1996 çalışmasına dayanırken, Sequential Attention Yasuda ve arkadaşlarının dikkat ağırlıklarını kullanarak özellikleri açgözlü biçimde seçtiği yöntemi; PyImpetus ise hedefin Markov örtüsünü arayan PPFS’in bir uygulaması olarak yer alıyor.
Sonuçların tutarlı etkisi model boyutunda görüldü. Parametre sayısı ve buna eşlik eden her turda gönderilen trafik ortalamada %49 azaldı. En büyük kesilme SGD sınıflandırıcı, Adult Income ve Sequential Attention ile %88,8 olurken en küçük kesilme SGD, Income ve PyImpetus ile %6,7 oldu.
F1 üzerindeki etki, hiperparametre ayarması yapılmadan ölçüldüğü için bazı durumlarda büyük, bazılarında ise hiç yok ya da negatifti. İlk iki örnekte ham özelliklerle neredeyse çalışmayan modeller seçilen özelliklerle kullanılabilir hale geldi; üçüncüde zaten çalışan modele 7 puan eklerken sonuncu 8 puan maliyetli oldu.
Heart Disease üzerinde SGD ve MLP skorları değişmezken (0.88’den 0.89’a), Gauss Naive Bayes en fazla 5 puan kazandı (0.83’ten 0.88’e) ve her durumda parametre sayısı düştü.
Sadece Flower FedAvg tabanına karşı, yani seçim ve ayarlama olmadan yapılan karşılaştırmada FLASH’ın en iyi yapılandırması 12 model-veri çiftinin 9’unda onu eşitledi ya da geçti, diğer 3’ünde ise hafifçe geride kaldı.
Otomatik ayarlama makalede başlangıçta elle belirlendi ve gelecekteki çalışmalar için ileri sürüldü. Nästa uygulama sunucuda hill climbing ekledi; sunucu bir maske önerir, her site bunu kendi doğrulama verisi üzerinde puanlar ve tek bir sayı geri gönderir.
NVIDIA FLARE sweep’inde 100 sütunlu ve farklı seçiciler kullanan 3 siteden oluşan sentetik bir tabloda birleşim 69 sütunu korurken otomatik ayarlama fd = 0.5 değerini seçerek 43 sütunu (bunlardan 6’sı gürültü) 0.838 F1 ile korudu.
0.3’ün üzerindeki özgürlük dereceleri için F1 eğrisi 0.004 içinde düz kaldığından ayarlayıcı, aynı F1 değeriyle birleşimden %38 daha az sütuna sahip bir maske buldu ve bunu 5 ayarlama turunda gerçekleştirdi.
Bir MLP için tek katmanda 64 birimli gizli katman kullanıldığında bu maske, tahmini trafiği her turda 153 KB’dan 68 KB’a düşürüyor. Seçim ve ayarlamanın toplam maliyeti 3.4 KB olurken bu tutar tek bir eğitim turundan kısa bir sürede geri kazanılıyor.
Geliştirici, tüm bunların kendi deneylerinden geldiğini ancak Sharma ve arkadaşlarının VTT ve Doğu Finlandiya Üniversitesi’nden makalesinin dışarıdan bir bakış sunduğunu belirtiyor. MICCAI 2026 workshop yayımlarına kabul edilen bu çalışma LAFFS adlı kendi Lasso yöntemini tanıtırken, karşılaştırdıkları tek mevcut federatif özellik seçimi yöntemi Feature Election.
Bu makale açık kaynak NVIDIA FLARE örneğini olduğu gibi çalıştırdı; yerel seçici olarak Lasso ve özgürlük derecesi ise 5 hill-climbing turuyla otomatik ayarlandı. Diğer tabanlar, NVIDIA FLARE içinde çalışan scikit-learn’den L1 lojistik regresyonu, her site tarafından yalnızca eğitilen bir model ve birleşik veri üzerinde merkezileştirilmiş bir modeli içeriyor.
Sinır koşulları FLASH makalesine göre çok daha zor. Dört benchmark veri seti 5.966 ile 19.993 özellik arasında değişirken yalnızca 72 ile 187 örnek bulunuyor ve bunlar 5 ile 18 site arasında bölünüyor.
Makalenin bildirdigi AUROC değerleri, dış çapraz doğrulama katmanları üzerinden ortalamalı. Feature Election için her veri setindeki üç aşağısınıfçıdan en iyisi gösterilirken araştırma makalesi tüm üçünü raporluyor.
LAFFS dört veri setinin üçünde en yüksek federatif skora sahip olurken, Feature Election 18 site ve yaklaşık 20.000 özellik içeren en büyük ayarlama olan SMK_CAN_187’de 0.710 ile en yüksekti; bu da merkezileştirilmiş eğitimle karşılaştırıldığında 0.711’e çok yakındı.
Tüm federatif yöntemler yalnızca tek başına çalışan sitelerden belirgin biçilde ilerideydi ve katmanlar arasındaki yayılım büyük, standart sapmalar 0.01 ile 0.2 arasında değiştiği için federatif yöntemler arasındaki çoğu boşluk bir standard sapma içinde kaldı.
Makale aynı zamanda bir zayıflığı da raporluyor: 200 özellikten 20’si bilgilencerici olan sentetik bir tabloda LAFFS yalnızca bilgilencerici özellikleri seçerken, Lasso ile Feature Election bazı bilgilencerici olmayan özelliklerin geçmesine izin verdi.
Geliştiricinin değerlendirmesi, genel bir oy verme şemasının bağımsız bir ekip tarafından çalıştırıldığında kendi yöntemini ve merkezileştirilmiş eğitimi altı kat daha fazla site sayısıyla yakından takip ettiğini gösteriyor. Bu ödün her yöntemin varsayımlarında yatıyor.
LAFFS LASSO lojistik regresyonu etrafında inşa edilmiş ve yazarları algoritma için bir patent başvurusunu açıklarken, Feature Election herhangi bir yerel seçici ve modelle çalışır; Apache 2.0 altında açık kaynaktadır.
Aynı oy verme kuralının iki portu bulunuyor: Her framework için biri. Flower sürümü a Flower Hub uygulamasıdır (@christofilojohn/feature-election) ve flwr new komutuyla oluşturulup flwr run ile yerel simülasyonda çalıştırılabilir.
NVIDIA FLARE sürümü nvflare.app_opt.feature_election modülü olup, 2.8.0’dan itibaren NVFlare repository’sinde çalıştırılabilir bir örnek içeriyor. İkisi de Apache 2.0 altında açık kaynaktır ve README dosyaları desteklenen seçicileri, ayarları ve dağıtım seçeneklerini listeliyor.
Geliştiricinin yayımladığı değerlendirme üç istemci üzerinde yalnızca FedAvg ile yapıldı. Bağımsız benchmark 18 siteye ulaştıysa da bundan fazlasına ölçeklenme ve güçlü biçilde non-IID veri denenmedi.
Bu benchmark’ta ortak biçilde optimize edilen bir yöntem aynı zamanda seçimde daha az gürültü özelliği seçti. Algoritma için resmi bir kanıt yok; örneğin seçilen maskenin birleşik tablo üzerinde bir seçici tarafından seçilecek olandan ne kadar uzakta olduğu gibi.
Makale çalışmalar arasındaki varyansı ya da yakınsama hızlarını raporlamadığı için tablolaradaki küçük F1 farkları tek yapılandırma sonuçları olarak okunmalı. Gizlilik açısından maske ve skorlar ham satırlardan çok daha azını ortaya çıkarır ancak yine de bir şeyi ortaya çıkarır; diferansiyel gizliliğe benzer biçilde bu resmi bir garanti değildir.
FLASH makalesi IEEE FLTA 2025’te Dubrovnik’de En İyi Öğrenci Makalesi Ödülünü aldı. Geliştirici karışık seçici sonuçlarını Flower AI Summit 2026’da (15-16 Nisan 2026, Londra) poster olarak sundu ve NVIDIA FLARE Day 2026’da (24 Eylül 2026, sanal) konuşma verdi.
Sıradaki adım 19-20 Ekim 2026 tarihlerinde Boston’da gerçekleşecek Federate AI Summit; burada Feature Election ve bir sonraki adımlar hakkında kısa bir konuşma yapacak.
Diskutera detta i gemenskapen
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.




Ordet är ditt.
Dela dina erfarenheter, frågor och bidrag. Din e-postadress kommer inte att publiceras.