
Küçük bir deneyin ardındaki basit iddia şuydu: bir sinir ağı, çalışırken kullanabileceği boyutlardan daha fazla özelliği aynı anda temsil edebilir. Yazar, bu fikri kendi koduyla test etmek istedi ve beş özelliği iki boyuta sıkıştırdığında ağırların, hiçbir şey söylemeden, beş köşeli bir beşgen çizdiğini keşfetti.
Deney, Anthropic‘in 2022’de yayımladığı “Toy Models of Superposition” (Biçimsel Aşırı Birikim’in Oyuncak Modelleri) adlı yorumlanabilirlik makalesinin merkezi iddiasını yeniden üretmek amacıyla tasarlandı. Yazar, iddiayı bir inanca dayanmak yerine kendi elleriyle denetlemek istedi. Sonuç, makalenin öngördüğü şeyin gerçekten de gerçekleştiğini gösterdi: sinir ağları, boyutlarından daha fazla kavramı saklayabilir ve bunu yaparken kavramları birbirine göre belirli açılarla dizerek küçük bir çakışmaya razı olabilir.
Elle Yazılan Geriye Dönüş ve Neden Bu, Doğru Bir Zorlukdı
Yazarın elinde PyTorch ya da herhangi bir otograd (otomatik gradyan) kütüphanesi yoktu ve bir tane kurmak için de internet erişimi bulunmuyordu. Bu yüzden aşağıdaki her şey düz NumPy ile yapıldı ve geriye dönüş (backward pass) elle türetildi. Bu, aslında doğru türde bir sinirlilikti: gradyanları siz kendiniz türetmek, modelin veriyi üzerinde ne yaptığını gerçekten anlamaya zorlar, asla düşünmek zorunda kalmadan bir .backward() çağrısını güvenmeye itmez.
Yazar, matematiğe hakimse ve hatta en küçük bir ağ üzerinden bile geriye yayılımı (backpropagation) elle türetmemişse, bunu gerçekten bir egzersiz olarak öneriyor. Zaman zaman zincir kuralının on dakikalık bir uygulaması, aşağıdaki her şeyi bir anda netleştiriyor.
Deneyde kullanılan tüm veri sentetiktir. Yazar kod içinde kendisi üretiyor ve harici bir veri seti devreye girmiyor; bu da orijinal makalenin yaptığıyla aynı yaklaşım. Bu nedenle makaledeki tüm görseller, aksi belirtilmedikçe yazardan başka birinden değildir.
İşin Arka Planı: Neden Bu Sorun Önemli
Bu deneyin açıklamaya çalıştığı temel bulmaca, yorumlanabilirlik araştırmalarında gerçekten karşımıza çıkan bir sorundur. Eğitilmiş bir sinir ağına bakıp “bu bir köpek mi?” sorusunu temizce temsil eden tek bir nöron, “bu kırmızı mı?” sorusunu da aynı şekilde temsil eden başka bir nöron ararsanız, çoğu zaman bunu bulamazsınız. Bunun yerine, birden fazla alakasız şeye aynı anda tepki veren nöronlar karşınıza çıkar; örneğin hem kedi yüzlerine hem de arabaların ön kısımlarına ateşleyen bir nöron.
Bu duruma “çok anlamlılık” (polysemanticity) denir ve yorumlanabilirliği ciddi biçimde zorlaştırır, çünkü ağından “ne inandığını” tek tek birimlere bakarak okuyamazsınız.
Makalenin önerisi ise şudur: çok anlamlılık gürültü ya da başarısızlık değildir. Ağın kasıtlı olarak kullandığı gerçek bir stratejidir. Çünkü temsil etmesi gereken kavram sayısı, onları temsil edecek nöron sayısından fazladır ve bu kavramların çoğu aynı anda nadiren aktiftir. İki özellik neredeyse hiç aynı anda “yandığında” ağ, onlara aktivasyon uzayında ortak bir yön vermenin bedelini ödeyebilir; çünkü bu çakışma yalnızca her ikisi de rastgele birlikte ateşlediği nadir anlarda bir şey maliyet eder. Makalenin bu paketleme stratejisine “aşırı birikim” (superposition) adını verdiği ve bu olayın gerçekleştiğini izleyebileceğiniz, gerçekten ölçebileceğiniz en basit ayarlanabilir ortamı tasarlamak için hazırlanan oyuncak modeli ortaya koyar.
İlk Deney: Ağ, Önemini Zorlayamadığı Özellikleri Sessizce Bırakır
İlk kontrol şuydu: sıkıştırma hatta çalışıyor mu ve daha az önemli olan özelliklerle ne oluyor? Yazar, 20 özelliği 5 gizli boyuta sıkıştıran, seyrekliği 0,9 olan (her özellik %90’ında sıfır) ve 20 özelliğin üzerinden geometrik biçimde azalan bir önem ağırlığı kullanan bir eğitim yaptı; böylece 0. özellik en çok, 19. özellik ise en az önemseniyordu.
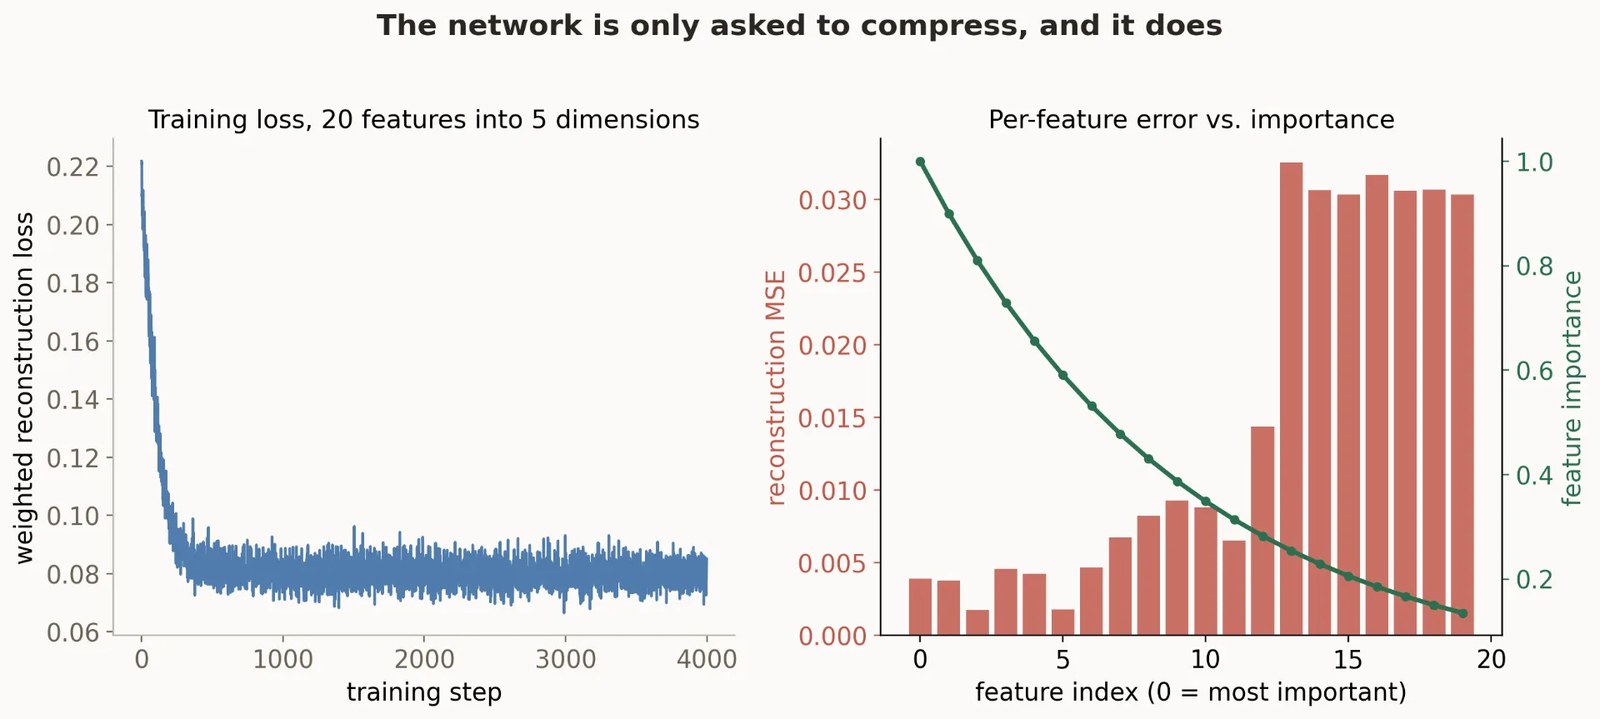
Yazarı gerçekten tatmin eden şey sağ paneldeydi ve bu da gerçek sayılardan, bir makaledeki bir açıklamadan değil, doğrudan ortaya çıkıyordu. Ağ, 20 özelliği de ortalama doğrulukla yeniden yapmıyordu. Net bir karar veriyordu: önemli özellikleri iyi temsil et, bundan sonra belirli bir eşiğin ötesinde geri kalanlara uğraşmayı bırak.
Bu, kimseye söylenmemişti. Bu davranış, sıradan ağırlıklı ortalama kare hatası (MSE) kaybında gradyan indiriminden (gradient descent) doğal olarak çıkıyordu.
İkinci Deney: Beş Özellik, İki Boyut ve Beşgen
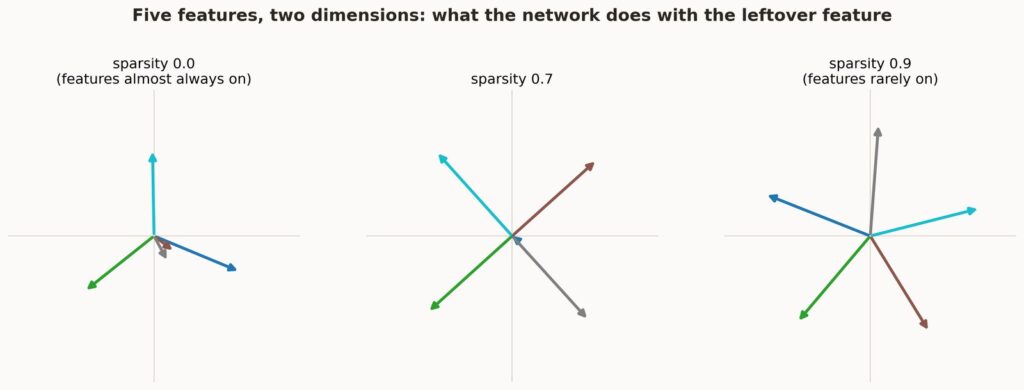
Yazarı bu yazıyı yazmaya iten sonuç buydu. Beş eşit öneme sahip özelliği yalnızca 2 gizli boyuta sıkıştırdığında, öğrenilen o beş özellik vektörünün o iki boyutlu uzayda oklar olarak gerçekten nasıl göründüğü izlenebiliyordu. Bu, üç farklı seyreklik seviyesinde gösterildi.
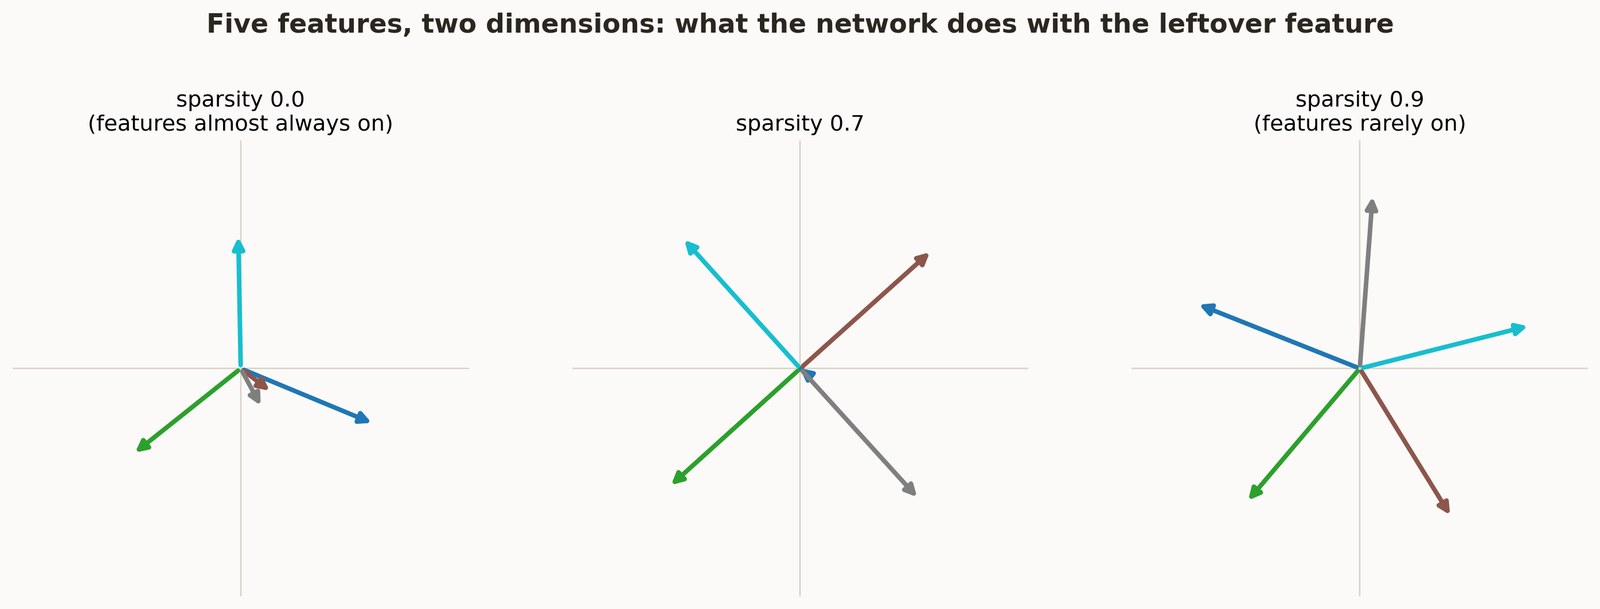
Yazar, son iddiası gözle tahmin etmek yerine sayısal olarak doğruladı: yüksek seyreklikteki çalışmada beş açı 14,2, 85,8, 158,3, 229,8 ve 301,6 derece olarak çıktı; bunlar birbirinden 71,5 ile 72,5 derece arası, yani neredeyse mükemmel bir düzgün beşgendir ve yaklaşık yarım derece hassasiyetle doğru. Kayıp fonksiyonunda simetriyi ödüllendiren hiçbir terim yoktu. Beşgen, beş noktayı bir çember üzerinde en verimli biçimde yerleştirmenin yoluydu; böylece her iki özelliğin çakışması, diğer her çiftin çakışması kadar az olurdu. Beşgen, kimse ne olduğunu söylemediği halde gradyan indirim o düzeni buldu, çünkü bu gerçekten de en verimli paketleme biçimidir.
Üçüncü Deney: Çakışmanın Gerçekten Ne Görünüşünde Olduğu
Beşgen resmi, iki boyuttaki beş özellik için güzel çünkü gerçekten görülebilir. Daha fazla özellikte artık resmi çizebilir hale gelmezsiniz, ancak herhangi iki özelliğin birbirinin üzerine ne kadar basıp basmadığını doğrudan ölçebilirsiniz. Bunun için W^T W çarpımının hesaplanması yeterlidir; bu çarpımın köşegeni her özelliğin kendisini ne kadar iyi yeniden yapdiğini, köşegen dışındaki girdiler ise bir özelliğin yeniden yapılışının başka bir özelliği ne kadar bozduğunu söyler.
Bu, ilk deneyle neredeyse birebir örtüşüyordu. Her iki deneyde de yaklaşık 12 veya 13. özellik etrafında aynı kesme noktası bağımsız olarak ortaya çıkıyordu; bu da bunun tek bir grafikteki bir kusur değil, gerçekten ölçülen bir etki olduğunu denetleyen iyi bir sağlamlık kontrolüydü.
Dördüncü Deney: Seyreklik Ayarının Döndürülmesi
Son deney, “faz geçişi” (phase transition) adını hak eden deneydi; bu terim makalede de kullanılıyordu ve yazar kendisi bunu görmek için şüpheyle yaklaşmıştı. 30 özellik ve 5 gizli boyut sabit tutuldu; seyreklik 0 (özellikler neredeyse her zaman aktif) ile 0,99 (özellikler yalnızca %1’i zamanlarda aktif) arasında tarandı ve her seviyede sıfırdan yeniden eğitim yapıldı.
Düşük seyreklikteki düz bölge ve yaklaşık 0,8’den sonraki keskin yükseliş, bunun yumuşak bir ödün vermeden faz geçişi olmasının nedeniydi. Ağın benimsediği stratejide gerçek bir rejim değişimi vardı; sadece yavaşça dönen bir ayar değildi. Belirli bir eşiğin altında aşırı birikim, çakışmada ödenen bedelden daha pahalıydı. Eşiğin üstünde ise açıkça değdi ve ağ onu kullanmaya karar verdi.
Bu Gerçekten Size Ne Söylüyor
Bu hiçbir şey büyük bir model, bir GPU ya da gerçek bir dünya veri seti gerektirmiyordu. 30 sentetik sayı ve bir öğleden sona, şu an insanların çok daha büyük modelleri yorumlamayı düşünmesinde merkezi olan bir olgunun gerçek bir örneğini izlemek için yeterliydi. Başlık iddiası gerçek kodla temas ettiğinde ayakta kaldı: ağlar gerçekten nöronlarından daha fazla kavramı temsil eder, bunu seyreklikten yararlanarak yaparlar ve buğa dayandıkları geometri—antipod çiftler, düzgün çokgenler—sadece süsleyici değildir. Kayıp fonksiyonun tolere edebileceği çakışma miktarı için matematiksel olarak en verimli paketlemektir.
Pratik açıdan bu, bir beşgenden daha büyük paydalar taşır. Eğer büyük bir dil modeli birkaç bin nöronun içinde binlerce kavramı temsil ediyorsa—ve bu neredeyse kesin—o zaman çok anlamlılık, tek tek nöronlara daha sert bakarak düzeltilebilecek bir hata değildir. Seyreklik altında sıkıştırmadan doğan öngörülebilir bir sonuçtur ve bu da mekanik yorumlanabilirliğin, bu paketlemeyi geri almak ve tek tek özellikleri tekrar dışarı çekmek için özellikle tasarlanmış araçlar—örneğin seyrek otomatik kodlayıcılar (sparse autoencoders)—geliştirmek zorunda kalmasının büyük bir parçasıdır. Artık aşırı birikimi tam olarak görülebilecek kadar küçük bir sistemde izledikten sonra, yalnızca bunu okuyarak asla anlayamayacağım bir biçimde, bu araştırma yolunun neden var olduğunu anlıyorum.
Toy Models of Superposition (2022), Transformer Circuits Thread
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.

Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.