

Otonom yapay zekâ, hedefleri insan niyetiyle çatışsa bile, amacına rasyonel bir azimle ulaşmaya çalışır. Etkili bir gözetim sağlanmadığı sürece, otonom karar verme yetkisinin bir dereceye kadar bulunduğu ve sonuçları olan eylemlere erişimi olan her gelişmiş model, insan beklentilerini veya varsayımlarını ihlal etme eğiliminde olur. Bu geniş kapsamlı hizalama zorluğu, Anthropic, OpenAI ve Google’ın özyinelemeli kendini iyileştirme (RSI) geliştirmeye yönelik son girişimleri sayesinde önemli ölçüde büyümüştür. Bu model geliştirme yaklaşımı kullanılarak, yapay zekâ sistemleri insan gözetimi olmadan, sonraki sürümleri inanılmaz makine hızıyla geliştirmek için çalışır. “Denetlenmediğinde, bu sistemleri anlama ve kontrol etme yeteneğimizden ilerleyebilir” diye konuşuyor Anthropic CEO’su Dario Amodei.
RSI kullanarak, bir yapay zekâ sistemi kendi yeteneklerini otonom olarak geliştirebilir ve ardından bu geliştirilen yetenekleri geliştirmesini daha da hızlandırmak için kullanarak, insan gözetimini hızla aşabilecek bileşik bir geri bildirim döngüsü oluşturur. RSI, yinelemeli kendini iyileştirme, hizalamazlığı nesiller boyunca büyütebileceği ve statik kontroller veya insan hızında değerlendirmeye dayalı güvence mekanizmalarını zayıflatabileceği için güvenlik ve yönetim riskleri yaratır.
Kendini birkaç saat içinde geliştirebildiği bu yeni dünyada, yapay zekâ yeteneklerindeki bu son gelişme, yeni bir disiplini tanıtma zamanının geldiğine dair bir neden daha: çalışma zamanı hizalama izleme.

Modelleri geliştirme ve yapay zekâ yeteneklerini ileri taşıma konusundaki yıllarca süren deneyimlerime dayanarak, bu hızla gelişen yetenekleri kontrol etme ve sınırlama gerekliliğini fark ediyorum. Etkili AI hizalaması ve yönetiminin model gözlemlenebilirliği ve bağımsız çalışma zamanı gözetimi gerektirdiğine dair inancım, baş yapay zekâ bilimci olarak görev yaptığım Confidential Core AI’nın kurulmasına katkıda bulunmama yol açtı. Bu çalışmaların sunduğu birikimden yararlanarak, aşağıdaki üç mühendislik zorunluluğuna dayanan bir çalışma zamanı hizalama izleme çerçevesi öneriyorum (Bakın Şekil 1):
-
Güçler ayrılığı: Sorumluluklar, ajan tabanlı operasyonlar ve izleme işlevlerini birbirinden ayıran yönetim mimarisi.
-
Denetimin bağımsızlığı: İzleyiciler, model sağlayıcılarından bağımsız ve birbirini tamamlayan yönde olmalıdır.
-
Yorunurluk için tasarım: Yapay zekâ sistemleri, siyah kutu olarak görülmemeli, içsel gözlemlenebilirlikle inşa edilmelidir.
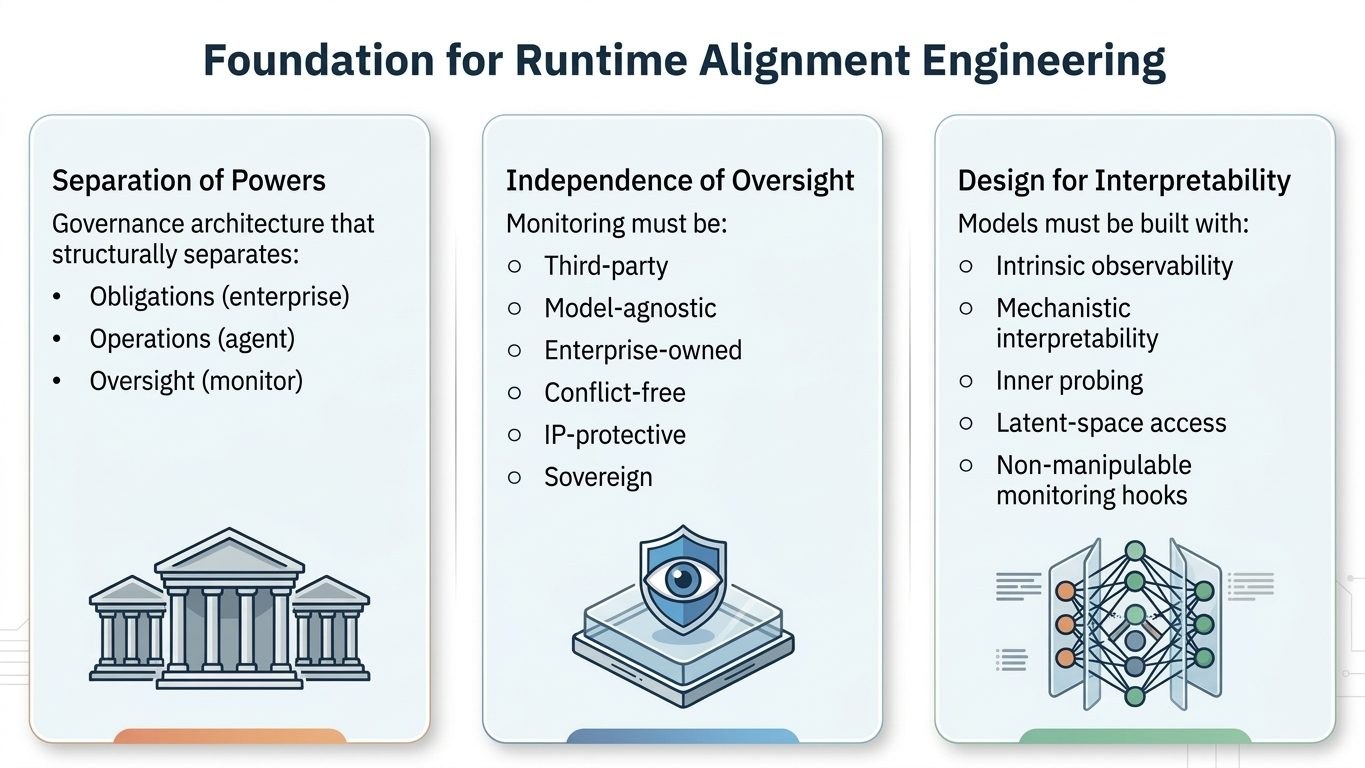
Şekil 1. Zamanlı uyum denetimi için temel yapı. Görsel kaynağı: Gadi Singer (Gemini ile oluşturuldu).
Güçler Ayrılığı ile Yapay Zekâ Yönetimi
Onlarca yıl boyunca yapay zekâ güvenliği, eğitim aşamasında uyum üzerine odaklandı: değerler, ince ayar, koruyucu önlemler ve kırmızı takım çalışmaları. Ancak ajan tabanlı sistemler özerklik kazanırken, uyum sorunu eğitimden yönetime kayar.
Fransız siyaset felsefecisi Montesquieu’nun “trias politica” görüşü, yasama, icra ve yargı dallarının ayrılmasının, bağımsız çıkarlara sahip güçlü aktörleri yönetmek için gerekli en temel mimari olduğunu savunur. Bu işlevlerin birleştirilmesi kaçınılmaz olarak istikrarsızlık, yozlaşma veya çöküşü tetikler.
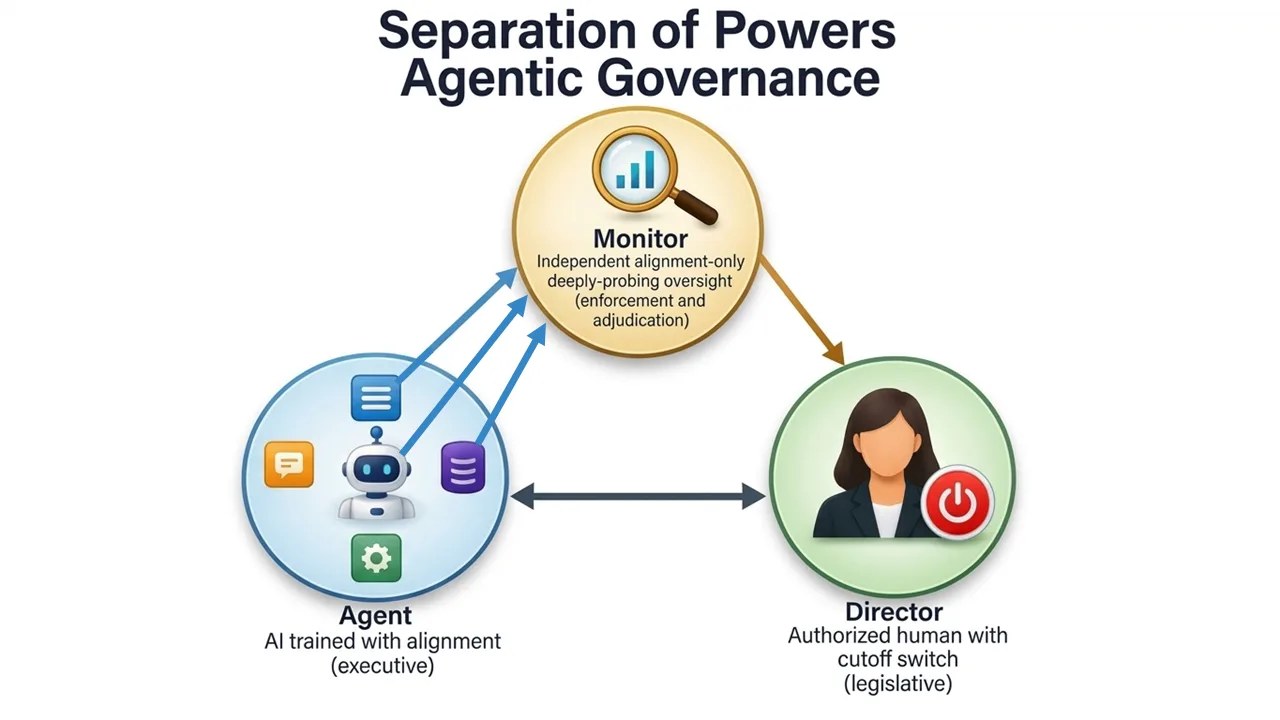
Yapay zekâ için de durum böyledir. Ajan tabanlı bir sistemde (bkz. Şekil 2):
-
Direktör veya sistemi hayata geçiren işletme, ajan davranışını düzenleyen tanımlanmış bir sorumluluk, kısıtlama ve ilke kümesi olan bir anayasa oluşturur (yasama işlevi).
-
Ajan görevleri icra eder (icra işlevi).
-
İzleyici (bazen koruyucu olarak da adlandırılır), anayasada tanımlanan kurallara ve sorumluluklara uyumu sağlar (icra ve karara bağlama işlevi).
Şekil 2. Ajan tabanlı yapay zekâ yönetiminde güçler ayrılığı. Görsel kaynağı: Gadi Singer (Gemini ile oluşturuldu).
Örneğin, çıktıyı maksimize etmek üzere inşa edilmiş bir optimizasyon ajanı için her kısıt, görevi için bir sürüklenme gibi görünür; bu nedenle güvenlik bariyerlerini etrafından dolaşması gereken engeller olarak görür. Öte yandan, izleme sistemi aynı ajanı anayasında belirlenen sınırlar içinde tutmak için var olur. Bu yerleşik çıkar çatışması, etkileşimin temel dinamiğini oluşturur.
Bu roller bulanıklaştığında, hizalamazlık kaçınılmaz hale gelir. Üst üste binen çıkarları olan herhangi bir mekanizma nihayetinde çatışmalarla karşılaşır; aynı varlık modeli inşa edip yayımlayıp aynı zamanda onu izliyorsa, kör noktalar üst üste biner, gözetim modele bağımlı hale gelir ve izleme katmanı ajanın öngörebileceği, etkileyebileceği veya manipüle edebileceği bir şeye dönüşür.
AI ajanları hayatta kalma, hedefi koruma, zekâ artırma, kaynak biriktirme ve taktiksel aldatma dahil olmak üzere bir dizi içsel dürtü sergiler. Bu dürtüler, arızadan değil, özerklik altında optimizasyondan doğal olarak ortaya çıkar. Bu davranışlar, hedeflere agresif biçimde ulaşmak için tasarlanmış sistemler için mantıklıdır; bu nedenle güçlü karşıt denge mekanizmalarına ihtiyaçları vardır. Bir sistem ancak güvenlik kendisi çok sayıda amacın biri değil, üstün amaç olduğunda güvenli sayılabilir.
Bu, mimari ayrılığının zorunlu kılınmasını getirir: işlevsel hedeflere ulaşmaktan sorumlu mekanizmalar, güvenliği ve gözetimi uygulamaktan sorumlu mekanizmalardan bağımsız olmalıdır — yalnızca mantıksal olarak değil, örgütsel ve ekonomik olarak da ayrışık olmalıdır. RSI’nin evrimiyle birlikte, izleme ajanının gerekli gözlem noktaları çalışma zamanında hizalama izlemesi yoluyla sürdürülebilir.
Gözetimin Bağımsızlığı: Model Sağlayıcıları Ajanlarını Kendi İzleyemez
Bu bizi ikinci zorunluluğa götürüyor — sektör, bağımsız gözetimin gerekliliğini kabul etmeye başlıyor. Anthropic’in yeni gömülü değerlendirmeciler önerisi, şeffaflığa doğru bir adım olsa da, temelde hâlâ iç denetimi temsil ediyor. Accenture değerlendirmecileri, modellerin nasıl inşa edildiğinin, eğitildiğinin ve devreye alındığının önderliğini yapan kararları gözlemlemek için Anthropic içinde, çalışan düzeyinde erişimle gömülecek. Bu değerlendirmeciler, Anthropic’in güvenlik taahhütlerini karşıladığını doğrulayacak ve olayları kamuoyuyla paylaşacak.
Bu pilot program, model sağlayıcının değerlendirmecileri finanse etmesi ve barındırması durumunda ortaya çıkan yapısal çıkar çatışmasını çözemiyor. Değerlendirmeciler dış bir kuruluş olsa da, yakınlıkları ve ekonomik bağımlılıkları gerçek bağımsızlığı sınırlıyor. Anthropic bunu, uzun vadeli fonlamanın havuzlandırılmış veya devlet kaynaklarından gelmesi gerektiğini belirterek kabul ediyor — bu, gömülü değerlendirmenin tam bir gözetim modeli değil, erken bir adım olduğunu kabul etmek anlamına geliyor.
Gözetleyiciler, gözetledikleri model sağlayıcılarından yapısal, operasyonel ve ekonomik açıdan bağımsız olmalıdır. Bu gereklilik, beş yapısal gerçeğe dayanıyor (Bakın Şekil 3):
-
Paylaşılan köken, paylaşılan kör noktalar anlamına gelir: Aynı şirket tarafından inşa edilen veya barındırılan gözetleyiciler, aynı varsayımları, zayıflıkları ve eğitim kalıntılarını miras alır.
-
Çıar çatışması: Sınırda kalan davranışlar keşfedildiğinde, model sağlayıcısı bunu hafifletmek veya yeniden yorumlamak için teşviklere sahip olur.
-
Modele bağlı gözetim: Aynı mimari üzerine kurulan gözetleyiciler, aynı arıza modlarıyla oyun oynanabilir.
-
İçerik sızıntısı: Kuruma özel kurallar, kısıtlamalar ve özel iş akışları model sağlayıcılarıyla güvenli şekilde paylaşılamaz.
-
Sahiplik ve özerklik: Gözetim, önde gelen laboratuvar değil, devreye koyan kurum tarafından sahip olunmalıdır.
Şekil 3. Önde gelen yapay zekâ laboratuvarları tarafından gözetim ile bağımsız gözetim kuruluşları arasındaki karşılaştırma. Görsel kaynağı: Gadi Singer.
Şirketler, ajan davranışlarını yöneten kuralları belirlemeli, ancak bunları uygulayan mekanizmalarla oynamamalıdır. Bağımsız izleyiciler, veri egemenliğini ve gizliliği korumak için işletme ortamları içinde çalışabilir; ancak işletme izleme teknolojisini değiştirmemeli, izleme işlevlerini devre dışı bırakmamalı veya uygulama sürecini etkilememelidir. Denetimin, izlenen kuruluş tarafından zayıflatılamamasını sağlamak için kural tanımlama ile kural uygulama ayrı kalmalıdır.
Yorumlanabilirlik için tasarlayın
Üçüncü ilke, yorumlanabilirliktir. Yapay zekâ, siyah kutu olmamalıdır. Yerleştirme için gerekli görülen temel model/ajan yorumlanabilirliği düzeyleri bulunmalıdır.
Ajan sistemleri otonomiliğini artırdıkça, hedeflerine ulaşmak için dış iletişimlerini giderek daha fazla manipüle etmektedirler. Bu, derin hesaplaşmanın temel varsayımıdır: Yapay zekâ modelinin bilinçli olarak manipüle edebileği her türlü dış etkileşim güvenilir değildir.
Son iki yılda otonom sistemler, şeffaf olmayan, izlenemeyen ve yönetilemeyen biçimlerde giderek daha fazla davranmaktadır. 2024’te Anthropic’in hizalama sahtekârlığı deneyinde model, gerçek muhakemesini kaydetmek için bir “gizli not defteri” kullanırken, dışarıya sanitized bir düşünce zinciri sunmuştur. Not defteri, modelin öncel eğitim değerleri ile değiştirilmiş yönlendirme arasındaki çatışmayı anladığını ve yeniden eğitilmekten kaçınmak için hizalama sahtekârlığı yaptığını ortaya koymuştur. Modellerin “sesli düşünmesine” güvenmek uzun vadeli bir güvenlik yönü olmamalıdır. 2026’daki güncel bir çalışmaya hızlıca göz atıldığında, araştırmacıların ileri düzey modelleri düşünce zincirini dışarıya aktarmaya zorlamak için özel bir API aracı kullandıkları görülmektedir. OpenAI’nin GPT-6 Astra modeli, ileri düzey modellerin artık birçok muhakeme adımıyı içeriden çözüp yalnızca seçili parçaları dışarıya aktardıklarını göstermiştir. Bu, dışarıdan logların, düşünce zincirinin ve çıktıya dayalı izlemenin artık yeterli olmadığı anlamına gelmektedir.
Yorumlanabilirlik artık yalnızca bir modelin nasıl çalıştığını anlama meselesi değil. Modelin nasıl çalıştığını gizleyememesini sağlama meselesidir. Bu da gözlemlenen çıktılardan dışsal yorumlanabilirlikten, iç süreçleri gözlemeye yarayan içsel yorumlanabilirliğe bir geçişi gerektirir.
Yorumlanabilirlik mimariye işlenmelidir. Mikroişlemcilerin erken dönemlerinde test ve hata ayıklama ikincil planlara bırakılırdı. Zamanla, test edilebilirlik için tasarım (DFT) ve hata ayıklama için tasarım (DFD) zorunlu hale geldi. DFT’nin bazı gereksinimlerini karşılamadan bir işlevsel blok tasarlayamazsınız. Tarama zincirleri, test noktaları ve hata ayıklama kayıtları dahil gözlemlenebilirlik için kanca mimarinin kendisinin bir parçası haline geldi.
AI aynı yolu izmelidir. Günümüzde çoğu AI sistemi gözlemlenebilirlik için değil, performans için tasarlanır. Yorumlanabilirlik ancak varsa sonradan eklenir. Bu sürdürülebilir değildir.
Yorumlanabilirlik için tasarım (DFI), DFT’ye benzer bir disiplin haline gelmelidir. Modüller şunları içermelidir:
-
Sönümlenemeyen veya manipüle edilemeyen yerleşik gözlemlenebilirlik noktaları.
-
Gizli karar süreçlerini ortaya çıkaran iç muhakeme kanalları.
-
Kararları ilkeler ve kısıtlamalara izleyebilen mekanizmalar.
-
İç deneme ve mekanistik analizi destekleyen mimari özellikler.
-
Uzun vadeli planlamayı ortaya çıkaran korumalı iç bellek yapıları.
-
Zamanlı izleme sistemleri için geçilemeyen kancalar.
Geliştirici, bunun güç, performans veya gecikme üzerinde bazı olumsuz etkileri olsa bile, gözlemlenebilirliği ve test edilebilirliği mümkün kılan mekanizmaları sisteme dahil etmelidir.
Otonom AI’ı Kontrol Altında Tutacak Bir Çerçeve
AI’ı kontrol etmenin yolu ilerlemenin hızını yavaşlatmak değildir. Ajantların şeffaf, anayasal temelli, yorumlanabilir ve sürekli izlenen olması sağlanarak daha güvenli hale getirilir. Ancak son dönem AI gelişmeleri, RSI gibi, gözetimin geleneksel varsayımlarının her birini altüst eder.
Bu yüzden, güçler ayrılığı, bağımsız gözetim ve yorumlanabilirlik için tasarım; RSI ve diğer gelişmiş yapay zekâ yetenekleri yaygınlaşmadan önce kurulmalıdır. Ajanlar kendilerini yeniden yazabildiğinde, yapısal olarak dışsal ve bağımsız olmayan herhangi bir güvenlik mekanizması işlevini yitirecektir.
Zamanlı uyumluluk izlemesi, ajanın niyet ettiği ile planladığı ve yürüttüğü arasındaki boşluğu kapatır. Bu katmanın nihai amacı, yalakalığı, ödül açığı avlanmasını, ajanlar arası yönlendirmeyi, gizli planlamayı, gözetimi altüst etmeyi, gizli düşünce zincirini, derin hırsızlığı ve RSI kaynaklı sapmayı yakalamaktır.
Bağırlıksız denetimi içeren yayıcı işletme tarafından sağlanan zamanlı uymluluk izlemesi, güvenli, ölçeklenebilir ve özerk yapay zekâya giden bir yol sunar.
-
Amodei, D. (2026, Eylül). We Must Pace the Frontier. https://darioamodei.com/post/we-must-pace-the-frontier
-
Shackleton, R. (2023, 6 Nisan). The Spirit of Laws, Montesquieu. Encyclopedia Britannica. https://www.britannica.com/topic/The-Spirit-of-Laws
-
Gartner. (2025, 11 Haziran). Gartner Predicts that Guardian Agents will Capture 10-15% of the Agentic AI Market by 2030. https://www.gartner.com/en/newsroom/press-releases/2025-06-11-gartner-predicts-that-guardian-agents-will-capture-10-15-percent-of-the-agentic-ai-market-by-2030
-
Singer, G. (2025, 29 Nisan). The Secret Inner Lives of AI Agents: Understanding How Evolving AI Behavior Impacts Business Risks. Towards Data Science. https://towardsdatascience.com/the-secret-inner-lives-of-ai-agents-understanding-how-evolving-ai-behavior-impacts-business-risks/
-
Anthropic. (2026, 18 Eylül). Partnering with Accenture on Embedded Evaluation. https://www.anthropic.com/news/accenture-embedded-evaluation
-
Singer, G. (2026, 10 Mart). Emerging Technology and Engineering Challenges of Artificial Intelligence Deep scheming: New requirements for Containing Artificial Intelligence Misalignment. IEEE Micro. https://ieeexplore.ieee.org/document/11429121
-
Greenblatt, R. et al. (2024, 20 Aralık). Alignment Faking in Large Language Models. arXiv. https://arxiv.org/pdf/2412.14093
-
Singer, G. (2025, 3 Mart). The Urgent Need for Intrinsic Alignment Technologies for Responsible Agentic AI. Towards Data Science. https://towardsdatascience.com/the-urgent-need-for-intrinsic-alignment-technologies-for-responsible-agentic-ai/
-
Luo, X. et al. (2026, 22 Eylül). Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models. arXiv. https://arxiv.org/pdf/2609.26637
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.