

Yerel modeliniz size makul görünen bir yanıt veriyor.
Yanıtı kendiniz okuduğunuzda bunu anında değerlendirebilirsiniz. Peki ya yanıt doğrudan sonraki bileşenlere aktarılırsa ve kimse onu incelemese?
Yanıtı kullanıma sunmadan önce ikinci bir gözden geçirme yapabilmek harika olurdu.

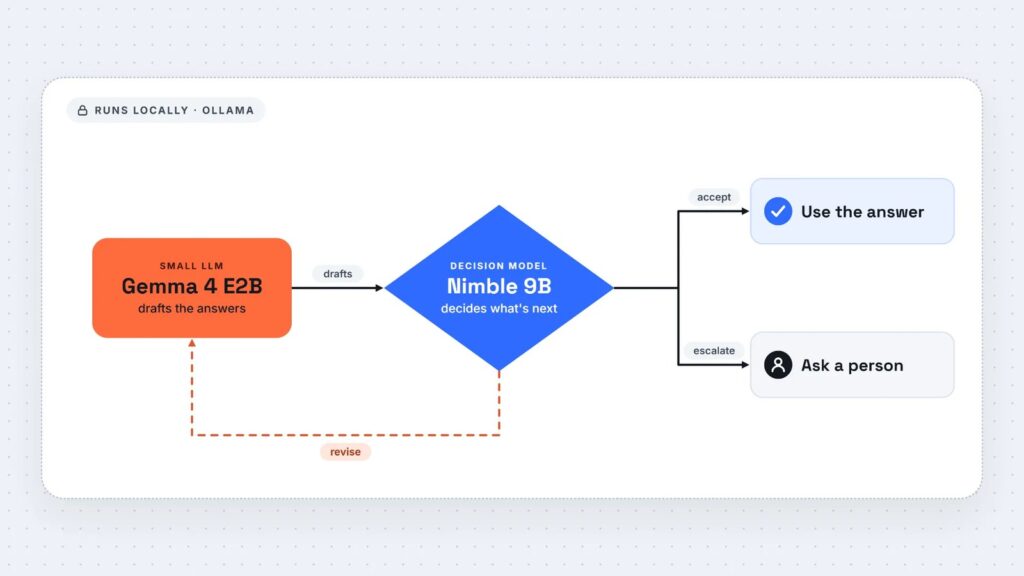
Aslında, bir karar modeli tam olarak bunu yapabilir.
Karar modelleri, LLM‘lerin yakın akrabalarıdır. Aradaki fark, LLM’lerin genellikle metin üretmek için kullanılması, karar modellerinin ise bağlam ve soru doğrultusunda önceden tanımlanmış seçeneklerden birini seçmede uzmanlaşmış olmasıdır.
Burada, karar modeline yerel modelin yanıtını ve orijinal bağlamı verip ne yapılması gerektiğini sorabiliriz: Yanıtı korumalı mıyız? Yoksa revizyon mu talep etmeliyiz? Veya insan incelemesi için mi işaretlemeliyiz? Kodumuz daha sonra bu seçime göre hareket edebilir.
Daha da iyisi, karar modeli de yerel olarak çalışabilir, böylece bağlamınız asla makinenizden ayrılmaz.
Ollama ile yerel bir model çalışma ortamı kurmak;
Yerel LLM olarak Gemma 4 E2B‘yi kurup çalıştırmak;
9B’lik bir karar modeli olan Nimble‘ı kurup çalıştırmak;
Somut bir vaka çalışmasını ele almak için iş akışını oluşturmak.
Katılımcıların sorularına yanıtlar hazırlayan ve bu yanıtların kullanıma hazır olup olmadığını kontrol etmek için bir karar modeli kullanan yerel bir iş akışı oluşturacağız.
Örneğin, bir ekip bir atölye çalışması düzenliyor. Birisi bir görevi tamamladığında, planı değiştirdiğinde veya hala teyit edilmesi gereken bir ayrıntı fark ettiğinde, ekip üyeleri bu ilerlemeyi mesajlar aracılığıyla paylaşıyor.
Bu sırada katılımcılar sorular soruyor:
Katılımcı hatırlatmam gönderildi mi?
Yanıt vermeden önce birinin tüm konuşmayı okuyup değişiklikleri takip etmesi gerekecektir.
Doğal olarak, bir LLM bu tür işlerde yardımcı olabilir ve her soruya kısa bir yanıt üretebilir.
Ancak ekibin tek bir koşulu var: iç mesajları kendi kontrol ettikleri bir makinede kalmalıdır.
Bu yüzden görevi yerine getirmek için yerel olarak çalışan küçük bir dil modeli kullanacağız.
Bu vaka çalışması için, iki ekip üyesi olan Alex ve Sam arasındaki aşağıdaki konuşmayı ona vereceğiz:
Alex: Kayıtlar başladı. Konuşmacılar hatırlatmalarını aldı. Atölye planlama notlarında saat 10:00 olarak belirtilmiş.
Sam: Katılımcı hatırlatması aynı metni kullanıyor. Onaylanmış ve planlanmış durumda, ancak konuşmacı listesi hala nihai onayı bekliyor. Takvim davetinde ise saat 10:30 yazıyor.
Alex: Planlanmış katılımcı e-postasını iptal ettim. Bu kişilerden ancak konuşmacı listesi onaylandıktan sonra haber almalılar. Lütfen notlarda mı yoksa takvimde mi doğru başlangıç saatinin yazıldığını teyit et.
İki modele farklı görevler vereceğiz: yerel LLM yanıtları hazırlayacak, yerel karar modeli ise bunları inceleyip sonraki adımı seçecek.
Yerel LLM olarak Google’ın Gemma ailesinden küçük bir dil modeli olan Gemma 4 E2B’yi kullanacağız.
Gemma için girdi basit: konuşma ve üç soru. Ayrıca her yanıtın neleri içermesi gerektiğini de belirtiyoruz. Örneğin, hatırlatma yanıtı e-postanın mevcut durumunu ve gönderilmesi için kalan koşulları belirtmeli. Başlangıç saati yanıtı ise kesin bir saat varsa bunu vermeli, yoksa belirsizliği açıkça belirtmeli.
Gemma’dan üç sorunun hepsine tek bir çağrıda yanıt vermesini istiyoruz ve yapılandırılmış JSON çıktısı talep etmek için Ollama’nın yapılandırılmış çıktı özelliğini kullanıyoruz. Bu sayede kodumuz her yanıtı tanımlayıp incelemeye devam edebilir.
Sırada, Gemma’nın yanıtlarını Bespoke Labs’in 9B’lik karar modeli olan Nimble‘a aktaracağız.
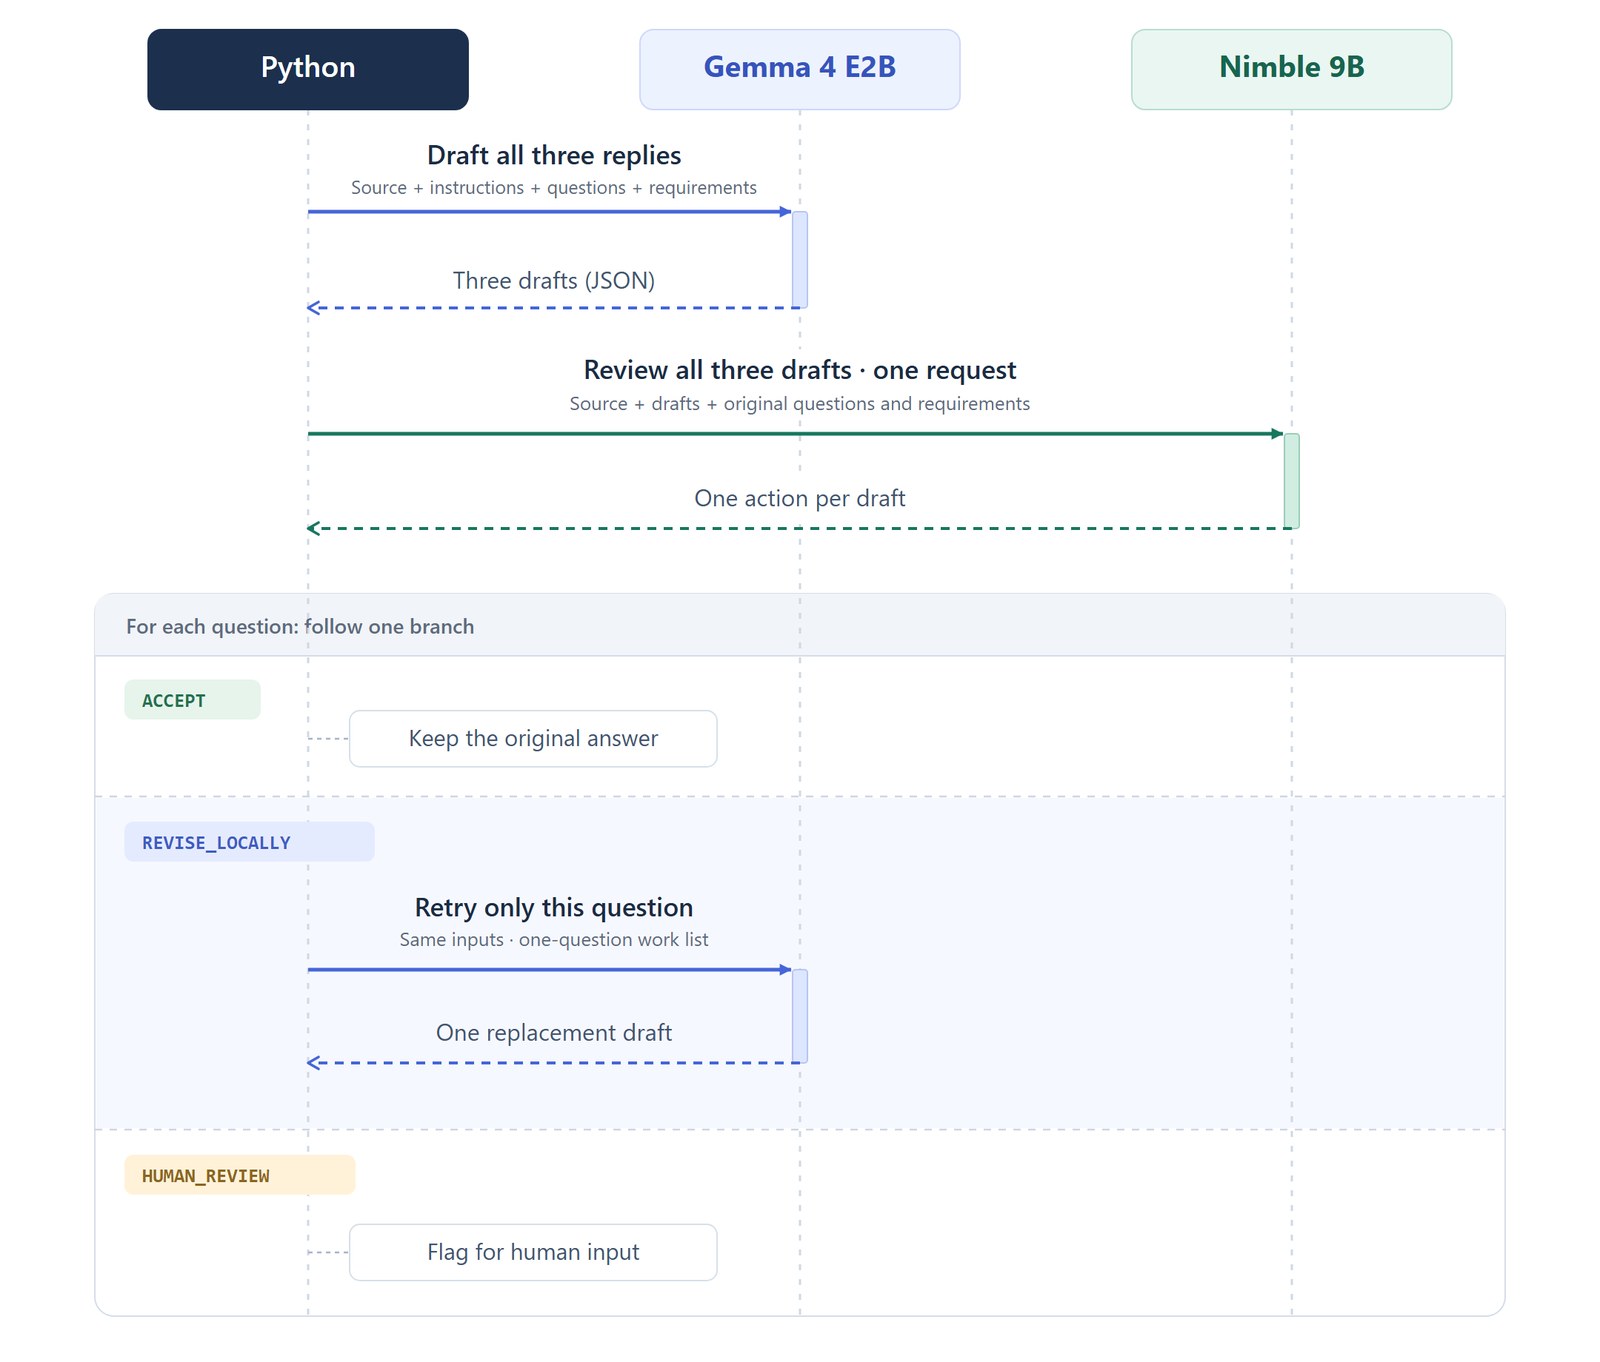
Nimble’a üç taslağın hepsini tek bir istekte göndereceğiz. Konuşma ortak bağlamı sağlıyor; her inceleme sorusu katılımcının sorusunu, Gemma’nın taslağını ve Gemma’nın aldığı aynı gereksinimi içeriyor.
Nimble’a üç seçenek sunuyoruz:
ACCEPT: Yanıt gereksinimi karşılıyor.
REVISE_LOCALLY: Yanıtın değiştirilmesi gerekiyor ve konuşmada bunu düzeltmek için yeterli bilgi var.
HUMAN_REVIEW: Konuşmada gereksinimi karşılamak için gereken bilgi eksik; insan müdahalesi gerekiyor.
Python kodumuz daha sonra seçilen eylemi gerçekleştirir: Eğer ACCEPT ise yanıt korunur. REVISE_LOCALLY ise Gemma’dan aynı konuşma, yazma talimatları, soru ve gereksinimle sadece o soruyu tekrar yanıtlamasını ister. Fark şu ki, Gemma artık üç soru yerine tek bir soruyu yanıtlamak zorundadır. Son olarak, seçilen seçenek HUMAN_REVIEW ise kod soruyu birinin çözmesi için işaretler.
Bu adımları bir araya getirdiğimizde iş akışı şöyle olur:
Öncelikle her iki modeli de hazırlayalım. Ollama’yı kurarak başlıyoruz.
Daha önce kullanmadıysanız, Ollama yerel dil modellerini kendi makinenizden indirmek, çalıştırmak ve sunmak için bir çalışma ortamıdır. Kurulduktan sonra Ollama yerel bir API uç noktası sunar.
Windows makinelerde bunu resmi yükleyiciden yapabilirsiniz:
Alternatif olarak, PowerShell üzerinden winget kullanarak da kurabilirsiniz:
Kurulumdan sonra Ollama’yı Windows Başlat menüsünden görebilirsiniz. Diğer uygulamalar gibi başlatabilirsiniz. Çalışmaya başladığında sistem tepsisinde Ollama simgesini göreceksiniz; bu, yerel Ollama hizmetinin arka planda çalıştığı anlamına gelir.
Eğer bir Linux makinesindeyseniz, Ollama’yı şu komutla kurabilirsiniz:
Nimble’ın karar uç noktası için Ollama 0.35.0 veya daha yeni bir sürüm gereklidir. Kurulu sürümünüzü kontrol edin:
Ollama kurulduktan sonra makinenizde yerel bir sunucu çalıştırır.
Ollama’yı çalışır durumda tutun, ardından modelleri indirmek için başka bir terminal açın.
Nimble için nimble:9b-q4_K_M adlı, Bespoke-Nimble-9B‘nin 5.6 GB’lık kuantize edilmiş bir sürümünü kullanacağız. Bu sürüm Apache 2.0 lisansını kullanır. Ayrı olan Nimble v3 sürümü ise ticari kullanımı kısıtlayan CC BY-NC 4.0 lisansını kullanır.
Aşağıdaki komutu çalıştırdığınızda her iki model adının da göründüğünden emin olun:
Ollama’nın yerel API’sine Python’dan requests kullanarak erişeceğiz:
Her iki model de yerel sunucu üzerinden http://localhost:11434 adresinden erişilebilir.
Vaka çalışması için not defterini burada bulabilirsiniz.
Öncelikle model adlarını ve yerel sunucu adresini tanımlayalım:
Sırada, Alex ve Sam’in mesajlarını bir listeye ekleyelim ve gönderildikleri sırayı koruyalım:
Her katılımcı sorusu için bir kimlik ve faydalı bir yanıtın neleri içermesi gerektiğini açıklayan bir gereksinim ekleyeceğiz:
Kodumuzun her taslağı incelemesiyle ilişkilendirebilmesi için kimliklere ihtiyacımız var. Ayrıca bu gereksinim alanını her iki modele de yanıtın neyi başarması gerektiğini anlatmak için kullanacağız.
Gemma’ya ortak bir yazma talimatı vereceğiz:
3.2 Gemma ile yanıtları hazırlayın
Burada draft_replies() fonksiyonunu oluşturuyoruz. Görevi bağlamı hazırlamak, Gemma’ya göndermek ve yanıtları döndürmektir:
Yukarıdaki kod parçasında, prompt yazma talimatlarını, seçilen soruları ve gereksinimlerini ve tüm konuşmayı bir araya getirir.
Soruları bir argüman olarak sağlıyoruz çünkü bu sayede Gemma’ya kaç soru vereceğimizi kontrol edebiliriz. Üç sorunun hepsini verip üç yanıt isteyebiliriz veya sadece bir soru verip bir yanıt isteyebiliriz.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔















Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.