

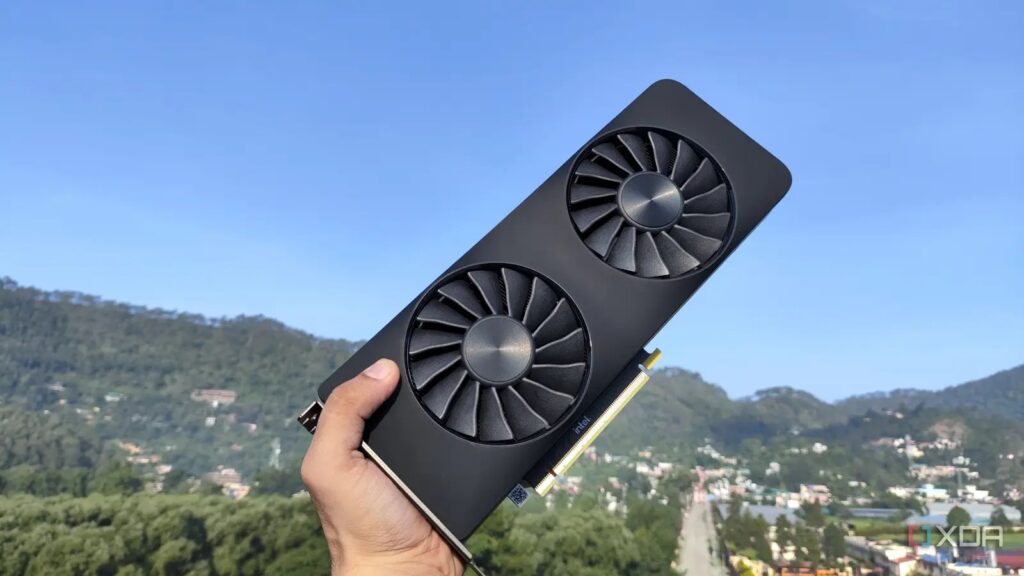
Nvidia kartları, yerel LLM görevleri için sık sık öneriliyor; son derece belgelenmiş CUDA ekosistemi ve güçlü Tensor çekirdekleri arasında, çoğu kişinin kendi kendine barındırdığı AI modelleri için Team Green yolunu seçmesi mantıklı. Aslına bakılırsa, LLM destekli projelerimin büyük çoğunluğu için hâlâ RTX 3080 Ti’mi kullanıyorum ve doğru modelle eşlendiğinde kodlama, otomasyon ve araştırma görevleri için gerçekten bir canavar.
Ancak farklı yerel AI kurulumlarıyla uğraştığım için şunu itiraf etmem gerekiyor: Nvidia kartları, güvenilir bir LLM istasyonu birleştirmeye çalışan ev laboratuvarı meraklıları için tek seçenek değil. Örneğin Intel Arc A750’me bakın. Doğrusu Nvidia kartlarım kadar güçlü değil, ancak doğru şekilde kurulum yaptığınız sürece günlük çıkarım görevleri için bazı daha basit modelleri barındırmada şaşırtıcı derecede iyi.
Ollama’dan vazgeçmek oldukça verimli oldu
Kolay kurulum sürecine rağmen Ollama, günlük LLM görevleri için uzaktan uzak
Sinir içine sinse de itiraf etmem gerek ki, Ollama birkaç yıl önce sohbet botlarım için AI modelleri yayınlamada ilk seçimimdi. Diğer hafif çıkarım platformlarıyla karşılaştırıldığında, Ollama’yı ayağa kaldırmak ve çalıştırmak çok daha kolaydı ve aynı durum aslında LLM’leri yayınlarken de geçerli. Uzun kom zincirleri ve bayraklar yerine, yalnızca ollama run yazıp favori LLM’lerimin model adını takip ederek, Arc A750 destekli modellerimi VS Code, Home Assistant ve konteynerleştirilmiş bir sürü hizmette kullanabilirdim.

Model seçmek de Ollama’da daha kolay, çünkü HuggingFace üzerinde aynı AI makinesinin onlarca varyantı arasında eleyip uzun komlarla manuel olarak indirmek yerine, yalnızca resmi sitesindeki özenle seçilmiş LLM listesinden seçim yapabilirdim.
Ancak LLM barındırma kurulumumu optimize etmeyi denediğimde, Ollama’nın gerçekten ne kadar bir performans takıntısına sahip olduğunu fark ettim. Arka planda llama.cpp kullansa da, Ollama’nın Go tabanlı yönetim katmanı önemli ölçüde işlem yükü ekliyor ve 4.096 token’lık varsayılan içerik penceresi uzun sohbet oturumları için iç karartıcı derecede küçük.
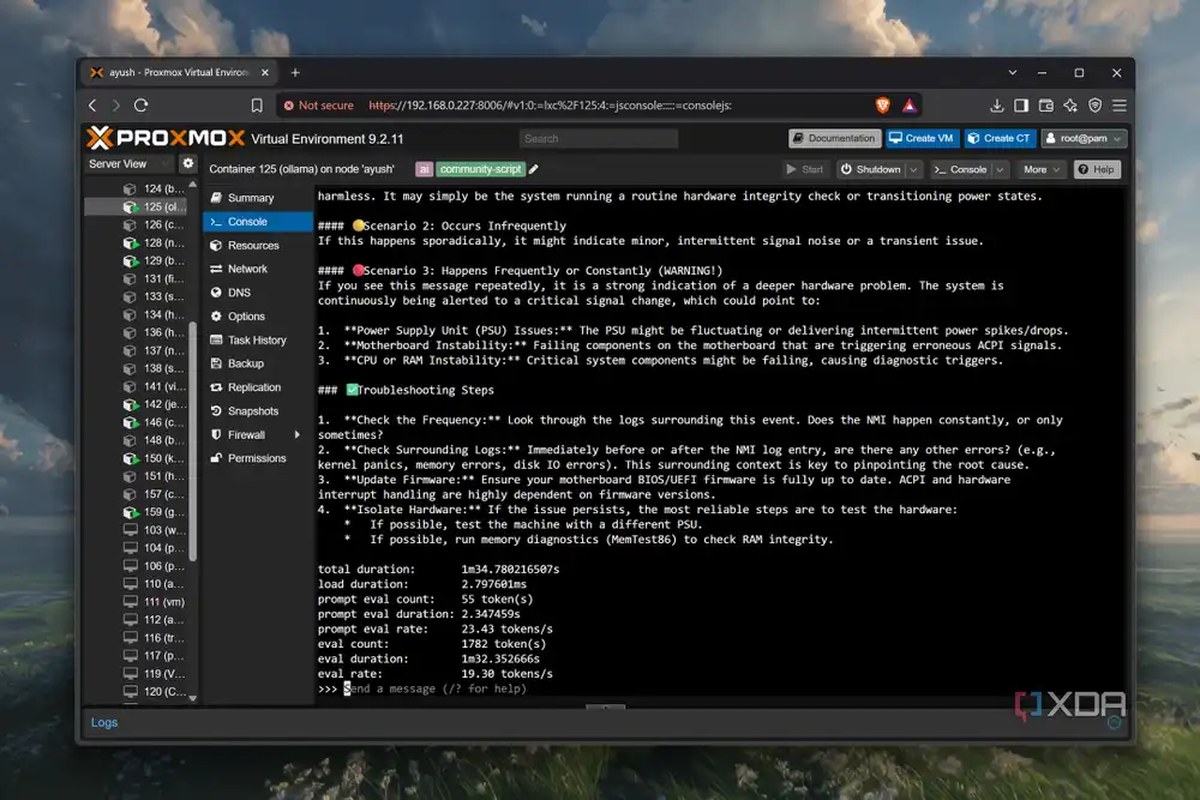
Aslında, yakın zamanda Intel Arc A750’me bağlı bir Ollama LXC üzerinde bazı performans ölçümleri almak için Gemma 4 E4B (Q4_K_M) çalıştırmayı denedim ve token üretimi hızları 19-22 token/saniye aralığındaydı. Bu tamamen kullanılamaz değil, ancak eski GPU’mun doğru çıkarım motoruyla yönetebileceğinden oldukça yavaş.
Vulkan sürümü llama.cpp, eski istasyonumda en iyi çalışıyor
OpenVINO hiç çalışmadı, SYCL karışık sonuçlar verdi
-
OpenVINO destekli llama.cpp örneği bu aşamada LXC’yi çökertiyor
-
SYCL destekli llama.cpp örneği çıkarım görevlerini yavaşlatıyor
-
OpenVINO destekli llama.cpp örneği bu aşamada LXC’yi çökertiyor
-
SYCL destekli llama.cpp örneği çıkarım görevlerini yavaşlatıyor
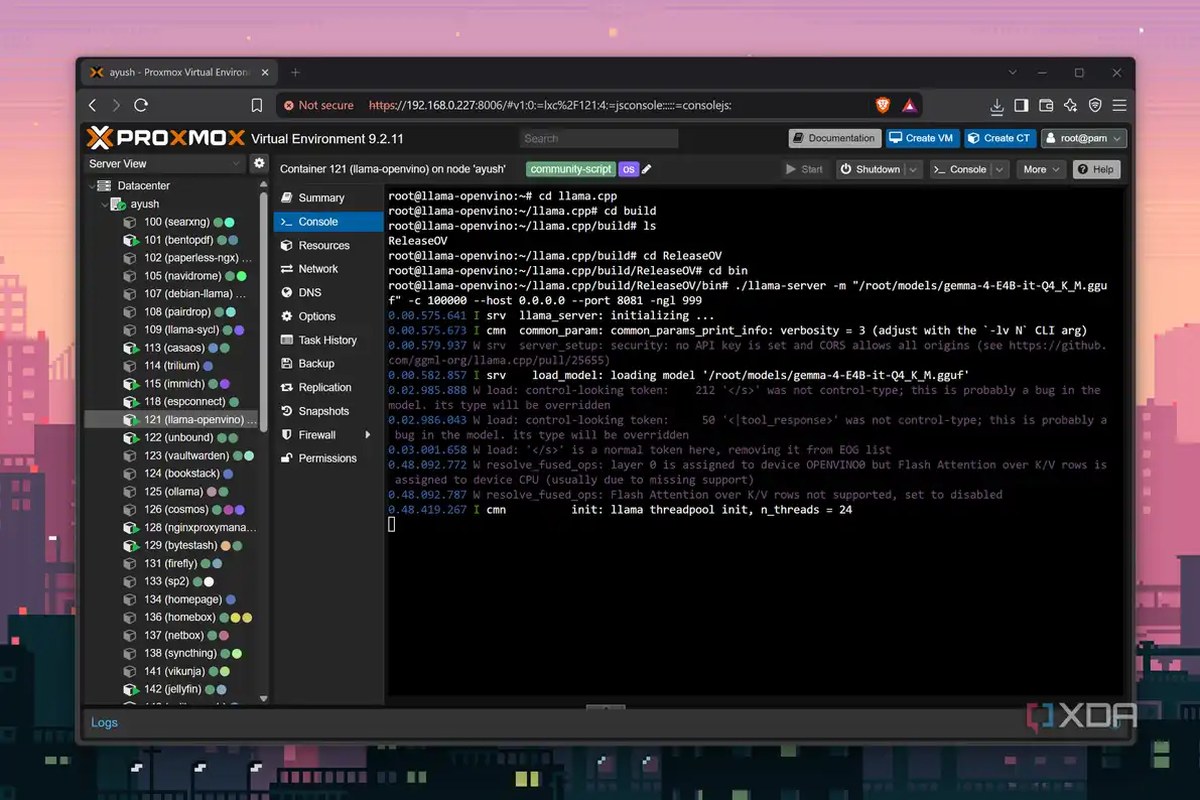
Ollama’nı çok fazla işlem gücü harcaması nedeniyle, Alchemist dönemi GPU’m için en iyi yükseltme, basit bir llama.cpp örneğine geçmek oldu. llama.cpp etrafında kurabileceğim birkaç çerçeve vardı ve Intel odaklı tüm seçenekleri denedikten sonra, en azından mevcut donanım kombinasyonum için Vulkan’ın en iyi seçenek olduğunu kabul etmeliyim.
Referans olması açısından, Arc A750 ile LLM deneylerim için iki E5-2650 V4 işlemci ve 64GB DDR4-ECC bellek içeren eski bir Xeon sunucu kullandım; çünkü bu makinenin ucuz fiyatı (en azından yıllar önce satın aldığım zaman) ile bu GPU’yu o günlerde ödediğim tutar iyi uyuyordu. Zaten bu makinede Proxmox kullanıyordum, bu yüzden llama.cpp’yi farklı LXC’ler içinde dağıtmak – hepsi GPU passthrough özellikleri taşıyan – performansı ölçmek için harika bir yol olurdu.
OpenVINO, Intel destekli AI görevleri için sık sık en çok önerilen çerçeve olup, llama.cpp tamamen OpenVINO üzerine kurulmuş bir backend’e sahip olduğundan, bir deneme yapabileceğimi düşündüm. OpenCL runtime ve diğer gerekli paketleri kurduktan sonra, OpenVINO backend’ini llama.cpp için oldukça zahmetsizce derleyebildim. Ancak, bu kurulumda tamamen işlevsel LLM’leri dağıtmak tamamen farklı bir hikayeydi; OpenVINO, hafif modellerle bile çöktü ve bu sorunu çözmek için yapılan tüm uğraşlar işe yaramadı.
Bu yüzden dikkatimi SYCL varyantına çevirdim, çünkü diğer ev laboratuvarı meraklılarından bununla ilgili iyi şeyler duymuştum. Ne yazık ki, llama.cpp’yi SYCL etrafında derlemek büyük bir zahmetti ve Arc A750’li LXC’mde inference motorunu yapılandırmak için bir sürü zorluğun içinden geçmem gerekti. Ancak tüm bu ekstra çabaya rağmen, bu kurulumun performansı son derece düşüktü; Gemma 4 E4B gibi modeller ancak 3 token/saniye zor zor yakalayabiliyordu.
Daha da kötüsü, SYCL destekli llama.cpp ortamımda gerçekten neyin yanlış gittiğini asla çözemedim; sıfırdan yeniden derlemek bile aynı sonuçları verdi. Bu yüzden, Arc A750’mde llama.cpp’yi ilk dağıttığım zaman kullandığım aynı kurulumu geri aldım – Vulkan çerçevesi üzerine kurulu ve oldukça iyi çalışıyor. Elbette saatlerce SYCL’li llama.cpp LXC’min her yönünü halletmeye çalışabilirdim, ancak Gemma 4 E4B’de 33 civarında token/saniye elde edebildiğimi gördükten sonra, Vulkan backend’i benim için fazlasıyla yeterli.
Doğru llama.cpp bayrakları inference görevlerini daha duyarlı hale getirebilir
Özellikle daha uzun sohbet oturumları için
Vulkan sürümünü kullandığım llama.cpp’e ek olarak, çıkarım işlerime birkaç temel kolaylık özelliği eklemek için iki bayrağı da kullanmaya başladım. Örneğin, -fa bayrağı, belleğimden flash attention özelliğini etkinleştirmemi sağlıyor; bu, prefill aşamasında istem işlemini hızlandırdığı gibi, uzun oturumlarda KV VRAM tüketimini de azaltıyor.
Aynı şekilde, –ubatch-size parametresini 2048’e çıkarmam, GPU’mun işleyebileceği token sayısını artırarak token üretimi hızını 35 t/s’ye çıkardı. Ancak bunu yalnızca Gemma 4 E4B gibi daha hafif modeller için kullanıyorum; aksi halde bellek aşımı (out-of-memory) sorunlarıyla karşılaşma riski alırım. Bu Gemma 4 E4B konusunu açarken, çok modlu projector model dosyalarını LLM’e aktarmak için –mmproj bayrağını da kullanıyorum; bu sayede tam kapsamlı görüntü çıkarım işlerini çalıştırabiliyor.
Bu terk edilmiş kartta hâlâ biraz can var
Kişisel olarak, güncel Arc A750 kurulumum optimize edilmiş durumdan çok uzak; özellikle SYCL’i performansın düşmesine yol açmadan ayarlayamadığım için. Yine de elimdeki en ucuz GPU olması nedeniyle, Vulkan destekli llama.cpp ortamından oldukça memnunum. Bunun üzerine, Gemma 4 E4B’nin Home Assistant, Blinko, Paperless-GPT, Karakeep ve bir sürü diğer kendi barındırdığım hizmetlerde çıkarım işlerini kolayca çalıştırabilmesiyle birleşince, bu GPU’yu hafif LLM yüklemelerim için birincil barındırıcı olarak kullanmaya başlayabilirim.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔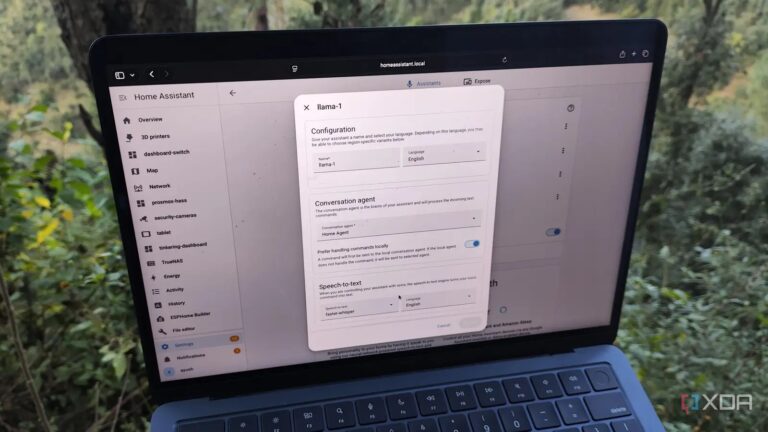























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.