

Test istemlerimden biri, Claude Code‘a “Bu Python fonksiyonu için pytest testleri yaz, örnek veri için bir fixture kullan” demeyi ve ardından tek satırlık bir medyan fonksiyonunu takip etmeyi içeriyordu. Çalışma alanında, Python testleri yazarken kullanılması gerektiğini söyleyen, pytest ve fixture’ları adlandıran ve istemle beş kelimeyi paylaşan halka açık python-testing-patterns becerisi bulunuyordu. İstemi 18 kez çalıştırdım: becerinin orijinal açıklamasıyla Haiku, Sonnet ve Opus üzerinde her birinde üçer kez ve bunun itici bir yeniden yazımıyla üçer kez. Beceri hiç yüklenmedi. Sonnet, altı çalıştırmanın hepsinde bir test dosyası yazmaya başladı, Opus fonksiyonu beşinde kendi dosyasına kaydetti ve Haiku beşinde boş klasörü listeleyip pytest’i kontrol etti. Claude Code, böyle bir isabetsizlik hakkında hiçbir şey raporlamaz; bir Skill çağrısını transkripti kontrol ederek görürsünüz.
Anthropic’in skill-creator becerisi, Claude’un becerileri “az tetiklediğini” söylüyor ve açıklamaları biraz “itici” yapmayı öneriyor [1]. Anthropic ve OpenAI, becerileri test etme konusunda her ikisi de tavsiye yayınlıyor [1][5] ve Towards Data Science’daki bir eğitim, itici tavsiyeyi tekrarlıyor [7]. Bazı ölçümler mevcut; bunlar arasında Vercel’in eval’ı var, burada bir Next.js dokümantasyon becerisi vakitlerin %56’sında çağrılmadı [3], ancak birkaç modeli yakın isabetsizlik kontrolleriyle karşılaştıran ya da bir becerinin açıklamasındaki itici anlatımın neyi değiştirdiğini ölçen birini bulamadım. Yaşamımın geçimini yazılım test ederek kazanıyorum, bu yüzden tetiklemeyi test altındaki bir özellik gibi ele aldım:
-
isteklerin eşdeğerlik sınıfları: becerinin kendi sözleriyle (doğrudan) ya da onlardan kaçınacak şekilde yeniden yazılmış (dolaylı), bunlar onu tetiklemeli;
-
yakın isabetsizlikler, beceriyle bir kelimeyi paylaşan ama başka bir şey gerektiren sınır durumlar, bunlar tetiklememeli;
-
her birinden üç çalıştırma, çünkü test altındaki sistem belirsizdir;
-
yazılımın yapabileceği bir geçiş/uygunsuzluk kontrolü: bir çalıştırma, ajanın ilk araç çağrısı beceriyi yüklediğinde onu tetikler.
Test ortamı, test, hata ayıklama ve kod incelemesi için 26 halka açık beceriden oluşuyordu; burada Claude Code 2.1.316 ile birlikte Claude Haiku 5.5, Sonnet 5.5 ve Opus 5.5 kullanıldı. Test edilen altı becerinin her biri için 104 istek, özgün betimlemelerle üç kez ve bu altı becerinin itici sürümleriyle üç kez çalıştırıldı; bu da 1.872 koşu ve önceden planladığım tek karşılaştırma oldu. Sonuçları gördükten sonra üçüncü bir kurulum ekledim: 936 koşu, superpowers adlı ve bu altı beceriden ikisinin geldiği bir Claude Code eklentisi olan oturum başlangıcı kancasıyla. Ana sonuçlar:

-
Özgün betimlemelerle dolaylı istekler, Haiku koşularının 108’inin 0’ında, Sonnet koşularının %19’unda ve Opus koşularının %27’sinde hedefi tetikledi; havuzlanmış oran %15 oldu.
-
İtici betimlemeler, havuzlanmış oranı 5,2 puan artırdı (95% aralık, istekler birim olarak 2,2 ile 8,3; beceriler birim olarak -1,1 ile 11,6); tüm artış test edilen altı beceriden üçünden geldi. Bu, önceden belirlediğim sınırı kaçırdı.
-
Superpowers’ın oturum başlangıcı kancası, Claude’a her şeyden önce becerilerini kontrol etmesini söylüyor ve havuzlanmış oranı %15’ten %62’e çıkardı.
-
Üç kurulumun hiçbirinde yakın kaçış isteği hiçbir zaman hedefini tetiklemedi: 972 koşunun 0’ı.
Claude Code bir beceriyi kullanmaya nasıl karar verir?
Bir beceri, içinde SKILL.md dosyası bulunan bir klasördür. Claude Code, modele kurulu her becerinin adını ve betimlemesini 1.536 karaktere kesilmiş şekilde gösterir ve model bu listeden geri kalanını yükleyip yüklemeye karar verir; çok sayıda beceri kuruluysa, 1% bağlam penceresi bütçesine sığması için bazıları yalnızca adları listelenir [2]. Modele listesini kopyalamasını istediğimde, tüm 26 betimleme eksiksiz şekilde oradaydı; buna ek olarak Claude Code ile gelen 14 beceri daha. Bir becerinin yüklenmesi bir araç çağrısıdır, dolayısıyla ajanın ilk araç çağrısı becerinin yüklenip yüklenmediğini gösterir.
17 modeli kapsayan bir EMNLP 2025 çalışmasında, bunların hiçbirini Claude olmayan, betimlemesi en güçlü kesin cümleyle biten bir araç, test vakalarının %79,1’inde doğru şekilde kullanıldı; buna karşılık bu cümle olmadan aynı aracın doğru kullanım oranı %11,9’du [4]. Oradaki seçim iki araç arasındaaydı; Claude Code’da bir beceri, doğrudan yanıtlamaya karşı da yarışır.
Testi nasıl kurdum
Beceriler
Beş halka açık GitHub deposundan 26 beceri aldım: obra/superpowers, anthropics/skills, wshobson/agents, trailofbits/skills ve postmanlabs/postman-plugin. Altısı hedefti; ortak test işleri ve farklı açıklama stilleri nedeniyle seçildiler:
-
test-driven-development (superpowers): kodu yazmadan önce bir özellik veya hata düzeltmesi uygulamak;
-
systematic-debugging (superpowers): herhangi bir hata, test hatası veya beklenmeyen davranış;
-
python-testing-patterns (wshobson): pytest, fixtures ve mocking;
-
webapp-testing (Anthropic): yerel bir web uygulamasını Playwright ile çalıştırmak;
-
api-testing (Postman): bir uç nokta test etmek veya trafiği bir API sözleşmesine göre kontrol etmek;
-
property-based-testing (Trail of Bits): altı açıklamanın en uzunu; zaten “her zaman kullanın” diyor ve ne için kullanılmadığını listeliyor.
Kalan 20 tanesi komşu olarak kurulu kaldı, bazıları yakın: e2e-testing-patterns, javascript-testing-patterns, api-mocking ve performance-testing gibi. Test ile ilgili olmayan superpowers’ın planlama ve meta becerilerini, yani brainstorming ve writing-plans’ı dışarıda bıraktım ve yalnızca beceri klasörlerini çalışma alanının .claude/skills/ dizinine kopyaladım; eklentilerin hook’ları olmadan.
İstemler
Her hedef için dört sınıftan istemler yazdım, toplamda 104 tanesi:
-
Doğrudan, beceri başına dört, açıklamayla en az iki içerik sözcüğü paylaşanlar; bunlar tetiklenmelidir. Systematic-debugging için: “Gecelik içe aktarmamızda beklenmeyen davranış: ara sıra yinelenen satırlar ekliyor. Herhangi bir düzeltme önermeden önce sistematik olarak sorunlu yeri bulun.”
-
Y dolaylı, beceri başına altı, becerinin adıyla ya da açıklamasıyla hiçbir içerik sözcüğü paylaşmayanlar; bunlar da tetiklenmelidir. python-testing-patterns için: “Flask uygulamamız charge_customer() içinde Stripe çağırıyor. Birim testlerimizin gerçek Stripe API’sine ulaşmasını nasıl durdururuz?”
-
Yakın kaçırmalar, beceri başına altı, en az bir içerik sözcüğü paylaşan ama başka bir şeye ihtiyaç duyanlar; bunlar sessiz kalmalıdır. api-testing için: “Ödeme alma API’mizi 10 dakika boyunca 500 eşzamanlı sanal kullanıcıyla yük testiyle çalıştırın ve p95 gecikmesini raporlayın.”
-
Toplamda sekiz alakasız kontrol, örneğin “Son git commit’ini nasıl geri alırım ama değişiklikleri korurum?”, bunlar hiçbir beceri yüklememelidir.
İçerik sözcükleri “the” ve “our” gibi edatları dışlar ve kökleri alınır, böylece “write” ile “writing” tek sayılır. Açıklamanın açıkça kullanılması anahtar sözcükleri sızdırır, bu yüzden kısa bir Python denetimi her istemi bu kurallara karşı sınar. Kök alma işlemi hamdır: “localhost” ile “local” ya da “generated” ile “generator”ı farklı sözcükler olarak sayar ve beş webapp-testing ile iki property-based-testing dolaylı istemi “localhost” ya da “generated” kullanır.
Etiketleri denemek için ayrı bir Claude Opus oturumuna yalnızca modelin gördüğü beceri listesini verdim ve karıştırılmış her istemin hangi beceriye uyduğunu sordum. Tetiklenmesi gereken 60 istemin (doğrudan ve dolaylı) 59’unda hedefi belirtti ve 36 yakın kaçırmadan hiçbirini ona işaret etmedi. Dokuz yakın kaçırmă komşuya gitti, örneğin yukarıdaki yük testi performance-testing’e gitti.
İleri gelen cümle
İtişken sürüm, her hedefin açıklamasına skill-creator’ın önerdiği biçimde tek bir cümle ekler [1]; 20 komşu orijal açıklamlarını korur. Şablonu ve bağlaç kelimeleri dışında, içindeki tüm kelimeler becerinin adından veya açıklamasından gelir, dolayısıyla dolaylı bir isteme eşleşecek yeni kelime sağlamaz. Anahtar kelimeleri yineleyerek iki en kısa açıklamayı yaklaşık üçe katlar ve sonraki ikisini ikiye katlar; bu test bunu ton ayrımından ayıramaz. İşte python-testing-patterns’in itişken açıklaması, dosyadaki tek satırda, eklenen cümle ayrı gösterilmiş (deposu MIT lisanslı):
text
pytest, fixtures, mocking ve test sürüklenmeli geliştirme ile kapsamlı test stratejileri uygulayın. Python testleri yazarken, test suite’ları kurarken veya test en iyi uygulamalarını uygularken kullanın.
Python testlerinden, pytest, fixtures,
mocking, test suite’larından veya test en iyi uygulamalarından kullanıcı bahsettiğinde bu beceriyi mutlaka kullanın, test
kalıplarını açıkça istemeseler bile.
Çalıştırıcı
Her çalıştırma, yalnızca becerileri içeren, CLAUDE.md dosyası olmayan ve çalıştırmalar arasında hiçbir aktarım yapılmayan tek kullanımlık bir git deposunda tek bir claude -p çağrısıdır. Ajanın ilk eylemini puanlarım: hedef beceri, başka bir beceri, başka bir araç veya düz metin yanıt. Çalıştırıcı ve kontroller yalnızca standart kütüphaneyi kullanan küçük bir Python programıdır. Çalıştırıcının çekirdeği:
python
import
json, os, subprocess
# STRIP_ENV, üst düzey Claude Code oturumunun ayarladığı dokuz değişkeni listeler.
def
first_action
(prompt, model, workspace):
“””Ajanın ilk çağırdığı beceri veya aracı döndürün, yalnızca metin yanıtı için None.”””
cmd
=
[
“claude”
“-p”
“–model”
, model,
“–max-turns”
“1”
“–setting-sources”
“project”
“–strict-mcp-config”
“–no-session-persistence”
“–output-format”
“stream-json”
“–verbose”
, prompt]
env
=
{k: v
for
k, v
in
os.environ.items()
if
k
not
in
STRIP_ENV
}
proc
=
subprocess.Popen(cmd,
cwd
=
workspace,
env
=
env,
stdin
=
subprocess.
DEVNULL
stdout
=
subprocess.
PIPE
stderr
=
subprocess.
DEVNULL
text
=
True
)
try
for
line
in
proc.stdout:
try
event
=
json.loads(line)
except
json.JSONDecodeError:
continue
if
event.get(
“type”
)
“result”
if
event.get(
“subtype”
)
!=
“success”
raise
RuntimeError
(
“run failed”
)
# the runner retries it
return
None
# text-only reply
if
event.get(
“type”
)
“assistant”
for
block
in
event[
“message”
][
“content”
]:
if
block[
“type”
]
“tool_use”
tool
=
block[
“name”
]
return
block[
“input”
].get(
“skill”
)
if
tool
“Skill”
else
tool
raise
RuntimeError
(
“no tool call or result”
)
# the runner retries it
finally
proc.kill()
# aracın çalışmadan önce durdurulması
stream-json ile (print modunda –verbose gerektiren) Claude Code, her olayı bir JSON satırı olarak yazdırır ve fonksiyon ilk araç çağrısında, araç çalışmadan önce durur; böylece her çalıştırma yaklaşık bir model çağrısına mal olur. –setting-sources project kişisel ayarları ve becerileri dışarıda tutar, –strict-mcp-config ile konfigürasyon dosyası olmaması MCP sunucularının olmayacağı anlamına gelir ve çalıştırıcı, üst Claude Code oturumunun ayarladığı dokuz değişkeni kaldırır; bunların arasında CLAUDE_EFFORT ve CLAUDE_CODE_SESSION_ID da bulunur.
1.872 çalıştırmanın tamamı karıştırılmış bir sırada ilerledi; böylece her iki betimleme sürümü aynı saatlerde çalıştı ve tümü ilk denemede tamamlandı, hiçbirisi hariç tutulmadı. Dört tanesi paralel çalıştırıldığında matris 44 dakika sürdü. Çalıştırıcı, bir çalıştırma için Claude Code’un son olay sonuç olayından önce durduğu için yalnızca metin cevabıyla sonuçlanan 843 çalıştırma maliyet bildirdi; CLI’nın bu çalıştırmalar için tahmini 16,37 dolar, kişi başı yaklaşık 2 sentti.
Hipotez
İlk çalıştırmadan önce bir hipotez yazdım: baskıcı cümlenin dolaylı istemlerde tetiklemeyi en az 10 puan yükseltmesi, sıfırı dışlayan 95’lik aralık (36 istem üzerinde eşleştirilmiş t) ve yakın-ıskala tetiklemedeki artışın 95’lik aralığının üst sınırının 5 puanı veya altında kalması gerekiyordu. Aşağıdaki her şey keşif niteliğindedir.
Sağlık becerisi ne sıklıkla tetiklendi?
Şekil 1: Orijinal betimlemelerle her modelin ilk eyleminin hedef beceri olma sıklığı. Sıfır genişlikli aralık, hiçbir çalıştırmanın tetiklenmediğini gösterir. Resim yazarın.
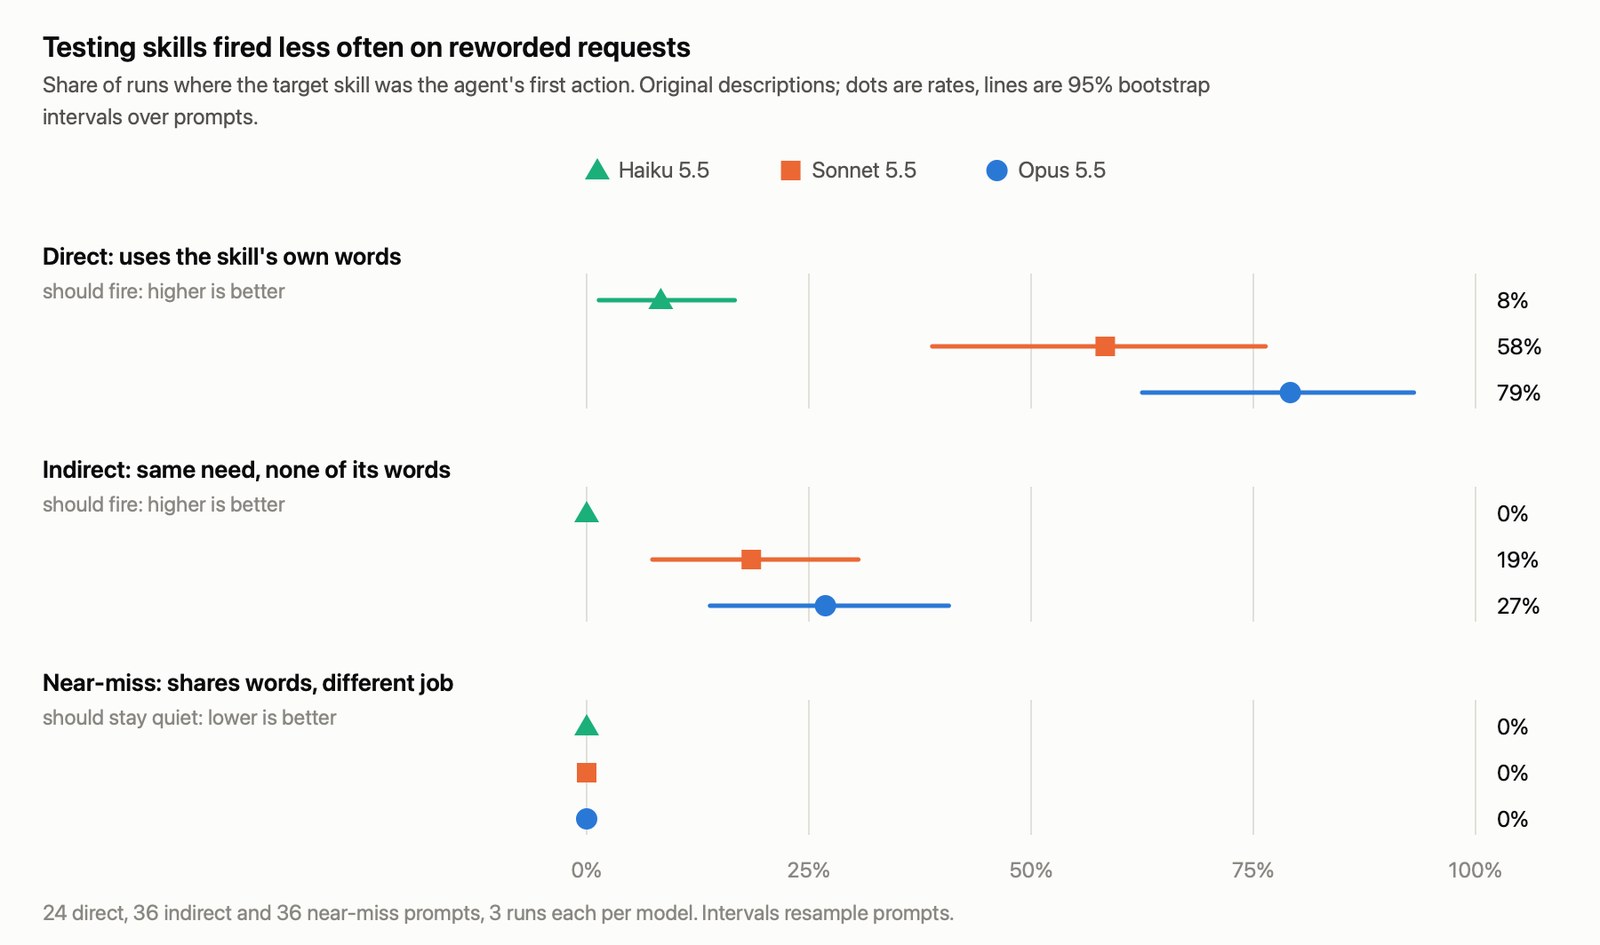
Beceri orijinal betimlemeleriyle, ajanın ilk eyleminin hedef test becerisi olduğu çalıştırma oranı. Noktalar oranları; çizgiler istemler üzerinde 95’lik bootstrap aralıklarıdır. Becerinin kendi sözcüklerini kuran doğrudan istemler: Haiku 5,5 %8, Sonnet 5,5 %58, Opus 5,5 %79. Aynı ihtiyacı kuran ama sözcüklerin hiçbirisini kullanmayan dolaylı istemler: %0, %19 ve %27. Sözcükleri paylaşan ama farklı bir iş gerektiren, becerinin sessiz kalması gereken yakın-ıskala istemler: üç modelin hepsi için %0.
Özgün açıklamalarla, doğrudan istemler Haiku çalışmalarının %8’inde, Sonnet çalışmalarının %58’inde ve Opus çalışmalarının %79’unda hedefi tetikledi; üç model de dolaylı istemlerde düşüş gösterdi (Şekil 1). Opus, dolaylı istemlerde Sonnet’i 8 puan önde götürdü, ancak aralık -2 ile 19 arasında olduğundan bu test iki modeli birbirinden ayıramıyor.
Tablo 1: Hedef becerinin ilk tetiklendiği çalışmalar, üç model birleştirildi. Uzunluk açıklamanın karakter sayısıdır; dolaylı sayılar 54 üzerinden hesaplanır. Sistematik hata ayıklama için sayıma, plugin adı çağrılarıyla 7 çağrı dahildir.
Dolaylı istemlerde beceriler modellerden daha fazla farklılık gösterdi, her becerinin kendi altı istemi bulunmasına rağmen. “localhost” veya “generated” ifadelerini kullanan yedi dolaylı istem, özgün açıklamalarla 49 dolaylı tetiklemenin 32’sini oluşturuyor; diğer 29 dolaylı istem 261 çalışmanın 17’sinde tetiklendi. Açıklama uzunluğu sıralamayı yansıtmıyor (Tablo 1) ve altı beceriyle uzunluğu yayıncıdan ayıramıyorum.
Tekrarlar çoğunlukla uyuyordu, ancak becerinin en az bir kez tetiklendiği 126 hücreden (bir istem, bir model, bir açıklama, üç çalışma) 27’sinde bir ıskalama da vardı, yaklaşık beşte biri.
Üç beceri yeniden ifade edilen istemlerde hiç tetiklenmedi
Özgün açıklamalarla, python-testing-patterns, systematic-debugging ve test-driven-development dolaylı bir istemde hiç tetiklenmedi (Tablo 1). test-driven-development en kesin olmayan durum, çünkü altı dolaylı isteminin hepsi klasörde olmayan koda işaret ediyor, örneğin “our Python Cart class” ve doğrudan ve dolaylı istemlerdeki 72 ıskalamanın hepi klasörde etrafı gözatarak başlıyor.
D diğer iki beceri için dolaylı istemlerim çoğunlukla nasıl yapılır ve neden sorularıydı ve 108 dolaylı ıskalamanın 88’i metin yanılaydı. Etiketleyici olarak Opus, bu 12 dolaylı istemin 11’inde hedefi adlandırdı; ajan olarak ise bu istemlerdeki 36 çalışmanın hiçbirinde onu yüklemedi.
Ajan beceri tetiklenmediğinde ne yaptı
Şekil 2: Hedef becerinin tetiklenmediği ateşlenecek çalışmalar ilk eylemleri, özgün açıklamalar. Resim yazarın.
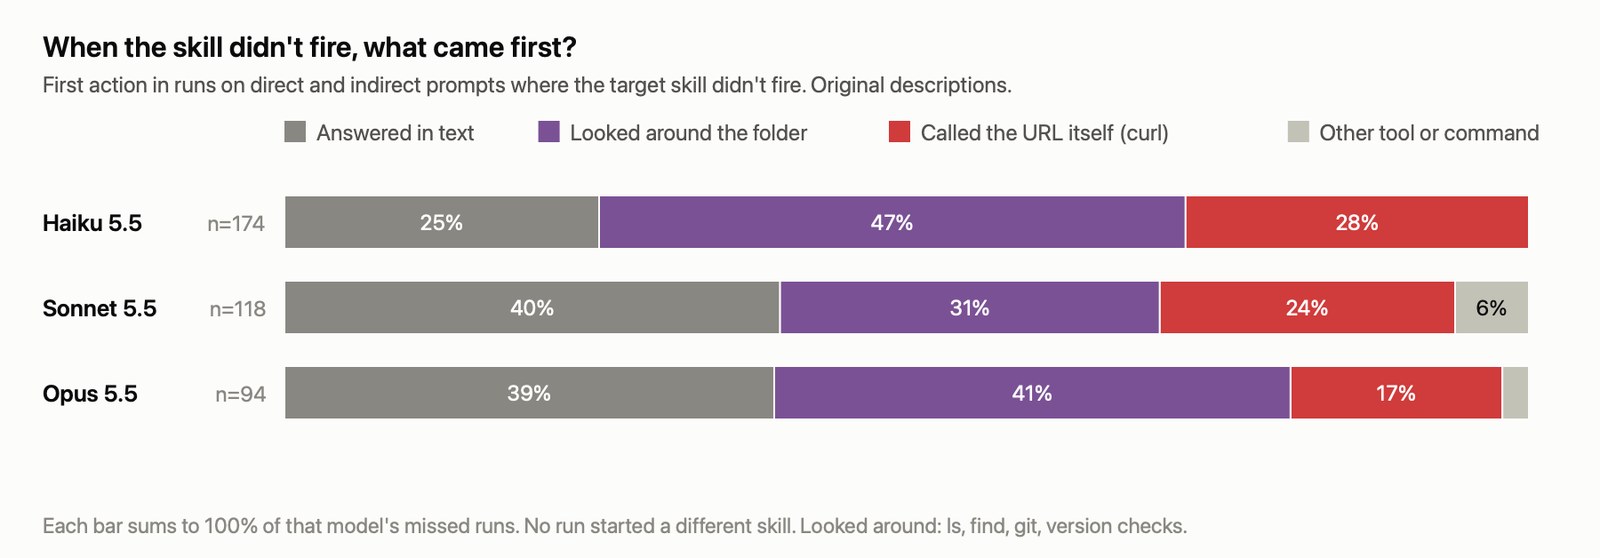
İlk eylem, hedef becerinin ateşlemediği doğrudan ve dolaylı istemlerde, orijel betimlemelerle çalışır. Her çubuk, o modelin kaçırdığı koşulların %100’ünü toplar. Haiku 5.5, 174 kaçırış: %25 metinle yanıtladı, %47 klasörde etrafı gezdi, %28 URL’yi doğrudan curl ile çağırdı. Sonnet 5.5, 118 kaçırdı: %40, %31 ve %24 ile %6 başka bir araç ya da komut. Opus 5.5, 94 kaçırdı: %39, %41 ve %17 ile 2 koşuda başka bir araç ya da komut. Etrafı gezme, ls, find, git ya da sürüm denetimleri anlamına gelir. Hiçbir koşul farklı bir beci ateşlemedi.
Kaçırdıkların çoğu bir metin yanıtlıyla, ls, find ya da git ile klasörde etrafi gezmeyle ya da bir curl çağrısıyla başladı (Şekil 2). curl kaçırdıkları iki beceriden geldi: 71 api-test kaçırdığının 57’si uç noktayı doğrudan çağırdı ve 35 webapp-test kaçırdığının tamamı yerel sunucunun yanıt verip vermediğini denetledi.
Etrafı gezme kaçırdıkları, en az güvendiğim olanlardır. 60 ateşlemesi gereken istemimin 44’ü “bizim” ya da “benim” koduma atıfta bulunuyor ve boş bir klasörde ajan onu aramaya başlıyor; 157 etrafi gezme kaçırdığından 138’i bu istemlerden geldi. “Bizim” ya da “benim” içermeyen sekiz dolaylı istemin 72 koşudan 14’inde ateşlemesi, ancak bunların 12’si “localhost” kullanan ikisinden geldi; diğer altısı 54 koşudan 2’sinde ateşledi.
Yakın kaçırış istemleri hedefi asla ateşlemedi
Yakın kaçırış istemleri, iki betimlemeyle 648 koşudan 0’ında hedefi ateşledi ve alakasız istemler üzerindeki 144 koşulun tamamı bir metin yanıtlıyla sonuçlandı. İstem birimiyle, 36’dan 0’ı, bu tür istemlerin hedefini ateşlendirecek payı için tek taraflı yaklaşık %8’lik üst sınır verir. 1.080 ateşlemesi gereken koşudan hiçbiri farklı bir beceri yüklemedi; bu sonuç komşulara bağlıdır: superpowers’ın planlama becerilerini dışarıda bıraktım ve onlardan biri herhangi bir özellik isteğini iddia ediyor.
Baskıcı cümle 5 puan ekledi, tümü üç beceriden
Dolaylı istemlerde, baskıcı cümle ateşleme oranını %15’ten %20’ye çıkardı; eşleştirilmiş fark 5,2 puan (95% aralık 2,2 ile 8,3, 36 istem). Onbir istem daha sık ateşledi, hiçbiri daha az ateşlemedi ve 25’i değişmedi.
Tüm 17 ek çalıştırma üç beceriden (Tablo 1) geldi, bunların 12’si “localhost” ya da “generated” içermeyen istemler üzerindeydi. Altı beceri birim alındığında aralık -1,1 ile 11,6 arasında. Modele göre kazanç Sonnet’te 5,6 puan, Opus’ta 10,2 puan oldu ve aralıklar örtüşüyordu; Haiku’da ise sıfırdı. Doğrudan istemlerdeki itici kazanç 7,9 puan oldu (3,6 ile 12,1 arasında, 24 istem).
Önceden yazdığım kurallara göre hipotez desteklenmedi. Kazanç 10 puanın altındaydı ve “tam yakındaki isabet” sınırının geçerli olduğu gösterilmedi: Her iki sürümde de tam yakındaki isabet hedefi tutturmadığından, planım yaklaşık %8 kadar yukarıdaki kesin üst sınıra, 5 puanlık sınırdan gevşek bir biçime dayanmak zorunda kaldı.
Superpowers’ın oturum başlangıcı kancağı 47 puan ekledi
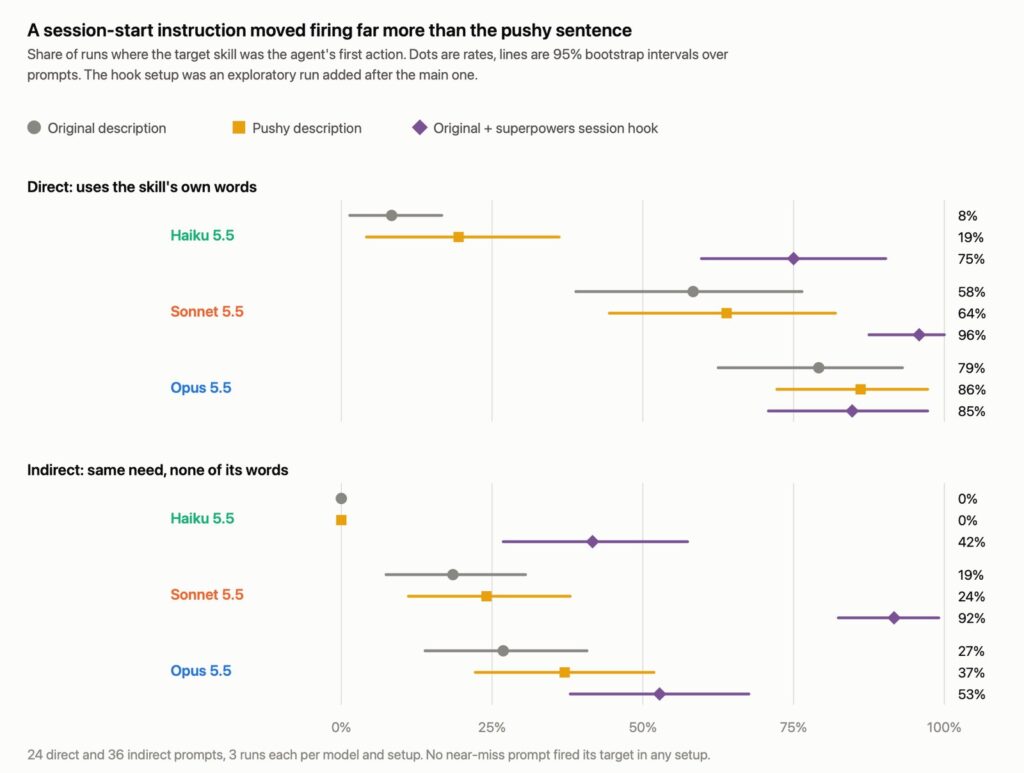
Eklenti olarak kurulan superpowers, aynı zamanda bir oturum başladığında çalışan ve using-superpowers becerisini bağlama ekleyen bir kancağa sahip. Bu metin modele, herhangi bir cevap, açıklayıcı soru ya da koda bakmadan önce, küçük de olsa geçerli olma ihtimali olduğu her durumda bir beceri çağırması gerektiğini söylüyor. Ana matrisim cağcağı hariç tuttuğundan, üçüncü bir kurulum ekledim: orijinal açıklamalar artı değişmez çağcak, aynı istemler, modeller ve tekrarlar üzerinde; 20 dakikada 936 çalıştırma, ana sonuçları gördükten sonra tasarlanmış ve ana matristen karıştırılmadan sonra çalıştırılmış.
Şekil 3: Üç kurulumda modele göre hedef becerinin ilk olarak ne sıklıkla çalıştırıldığı. Çağcak oranları Opus’un superpowers:systematic-debugging çağrılarını systematic-debugging olarak sayar. Resim yazarın.
Üç kurulumda, Haiku 5.5, Sonnet 5.5 ve Opus 5.5 için ajanın ilk eyleminin hedef test becerisi olma oranı: orijinal açıklama, bir “itici” açıklama ve orijinallama artı superpowers eklentisinin oturum başlangıcı cağcağı. Noktalar oranları; çizgiler istemler üzerinden %95 bootstrap aralıklarıdır. Doğrudan istemler: Haiku %8, %19, %75; Sonnet %58, %64, %96; Opus %79, %86, %85. Dolaylı istemler: Haiku %0, %0, %42; Sonnet %19, %24, %92; Opus %27, %37, %53. Çağcak kurulumu, ana çalıştırmanın ardından eklenmiş keşif amaçlı bir çalıştırma idi.
İstekli olmayan sorgularda ateşleme oranı %15’ten %62’ye çıktı, eşleştirilmiş fark 47 puan (istekler üzerinden 39-55 aralık, beceriler üzerinden 34-60 aralık). Sonnet en çok ilerledi, %19’dan %92’ye; Haiku 0’dan %42’ye ve Opus %27’den %53’e yükseldi (Şekil 3). Doğrudan sorgularda birleştirilmiş oran %49’dan %85’e çıktı.
Çok yakın ıskalar hedeflerini hiçbir zaman ateşlemedi ve alakalı olmayan sorgular hiçbir zaman bir beceri yüklemedi, ancak çok yakın ıskalar 324 çalışmanın 75’inde bir komşu yükledi, hook olmadan 43’e karşılık. Bir Jest kurulumu ve komşularını hiçbir zaman yüklemeyen bir GitHub Actions iş akışı (javascript-testing-patterns, github-actions-templates) 36 ana çalışmada bunu 18 hook çalışmasının 12’sinde yaptı.
Bir doğrudan istek için, yerel bir sayfada çok erken kapanan bir açılır menü hakkında, tüm dokuz hook çalışması webapp-testing yerine systematic-debugging yükledi; bu, hook’un kuralıyla uyumluydu—bir hatanın önce ayıklamaya gitmesi; etiketleyici systematic-debugging’i bunun için kabul edilebilir olarak adlandırmıştı.
19 çalışmada, hepsi ayıklama istekleri üzerinde, Opus beceyi hook metninin kullandığı eklenti adıyla, superpowers:systematic-debugging olarak çağırdı; bu, klasör-only kurulumumun sağlamadığı bir şeydi; skorlayıcım, ana matristen önce düzeltildi, öneki temizliyor. Atılolar olarak skorlanan bu çalışmalar hook’un dolaylı oranını %62’den %60’a ve doğrudan oranını %85’ten %80’e düşürüyor (Opus: %53’ten %46’ya) ve Opus’un doğrudan oranını %69’a indiriyor, bu da hook olmadan sahip olduğu %79’un altında.
Bu, büyük harflerle yazılmış ana kurallarıyla tek bir eklentinin hook’unu, eklentinin planlama becerileri olmadan kurulmuş şekilde test etti. Burada hook, ısrarcı cümleden çok daha fazla ateşlemeyi değiştirdi; başka herhangi bir hook’u henüz test etmedim.
Bu testin göstermediği şeyler
-
Sadece ilk hamleyi isabettim, çünkü skill-creator değerlendirmesi [1] yalnızca ilk hamleyi sayıyor; daha sonra yüklenen bir beceri isabetsiz sayılıyor ve 157 bakınma isabetsizliğinden sonra ne olduğunu bilmiyorum. Koşulları sürdürmek işe yamadı: çoğu koşul izin istemlerinde takıldı (20 tanesinde durup geri aldım) ve salt-okunur araçlara izin verildiğinde bir üçlü duman testi, eksik kodu kendi klasörünün dışında aradı.
-
Bu tek bir harness, tek bir gün: Claude Code 2.1.316, 26 kurulu beceri, 2026-11-01 ve Claude Code’ın varsayılan akıl yürütme düzeyiyle. Model ve CLI güncellemeleri her sayıyı değiştirebilir.
-
Alt hedef beceri ve bizzat yazdığım 104 istem vardı. Sözcük örtüşmesi kuralı ve etiket denetimi sızan anahtar sözcükleri ve belirsiz istemleri yakalıyor; ancak etiketleyici Opus’tu, test altındaki modellerden biri ve her iki denetim de kullanıcıların bu istemleri yazacağını göstermiyor.
-
Beceriyle çıktının becerisiz çıktıdan daha iyi olup olmadığını ölçmedim. claude plugin eval, bir plugin içinde paketlenen beceriler için bu karşılaştırmayı çalıştırır [6]; bir proje becerisi için belgeler, skillOverrides ile kapatıp karşılaştırmayı öneriyor [2].
Kendi becerilerinizi nasıl test edersiniz?
-
Her beceri için üç tür istem yazın: betimlemenin kelimeleriyle yaklaşık dördü, yeniden ifade edilmiş altısı ve yakın yanlışları, ayrıca birkaç alakasız denetim. İçerik kelimesi, becerinin adı veya betimlemesiyle ortak paylaşan herhangi bir yeniden ifade edilmiş istemi reddeden bir denetim ekleyin.
-
Her kurulum için kullanımdan kaldırılabilir bir klasör oluşturun: içinde test edilecek beceri ve usual becerilerinizin .claude/skills/ altında bulunduğu, listelemenizin sizinkinize benzediği boş bir git deposu; ayrıca istemleriniz proje kodundan bahsediyorsa küçük bir örnek proje.
-
Her istemi, ekibinizin kullandığı her model üzerinde üç kez çalıştırın; Haiku ve Opus burada oldukça farklılık gösterdi. Bir beceri için onaltı istem yalnızca büyük farkları tespit eder.
-
İlk araç çağrısını kod ile skorlayın ve girişini saklayın. Her istem için bir oran hesaplayın; aralıklar istemleri yeniden örnekleme yapar, böylece kolay bir istem ortalamayı tek başına taşıyamaz. Kumanda içindeki çalıştırmalar devam etmeye izin verirseniz çalışır. skill-creator tetiklemeyi skorlar; eklentiler için ise claude plugin eval becerinin tetiklenip tetiklenmediğini bildirir [1][6].
-
İsabetsizlikleri oranın yanı sıra okuyun. Doğrudan bir metin cevabı veya yazılan bir dosya, modelin beceri olmadan ilerlediğini gösterir; bir curl çağrısı veya klasör listesi ilk adımdır ve beceri daha sonra gelmeye devam edebilir.
-
Bir beceri her çalıştığında çalışmalıysa, onu /skill-name [2] ile çağırın veya superpowers’ın yaptığı gibi bir oturum başlangıcı kancası ekleyin; takip çalıştırımımda bu, itici cümleyi belirgin biçimde geçti, ancak bir webapp-testing isteğini hata ayıklama becerisine çekti. Model işi zaten yapabiliyorsa, becerinin ne kattığını sorun. Betimleme sorunsaysa, güvenmeden önce yeni ifadeleri aynı istemler üzerinde test edin.
Bir beceri için onaltı istem, üç çalıştırma ve üç model 144 çalıştırma yapar: paralel dördüyle üç-dört dakika ve burada görülen çalıştırma başına 2 sent fiyatla yaklaşık 3 dolar.
Sonuç
Bu altı beceri üzerinde, itici cümle yeniden ifade edilmiş istemlerdeki tetiklemeyi %15’ten %20’ye taşıdı ve oturum başlangıcı kancası onu %62’ye taşıdı; hiçbir kurulum yakın yanlışında bir hedefi tetiklemedi. Altının üçü, kanca olmadan bir ifade edilmiş istem üzerinde hiç tetiklenmedi.
Bu testi her model, açıklama veya eklenti değişikliğinden sonra yeniden çalıştırdım. Tetiklenme, model ve kurulum’a bağlıdır ve çalıştırma arasında değişir; bu nedenle diğer herhangi bir özellikte olduğu gibi aynı eşdeğerlik sınıflarını, sınır durumlarını ve tekrarlanan çalıştırmaları gerektirir.
[1] Anthropic, skill-creator (2026), GitHub anthropics/skills. “Undertrigger” notu ve itici açıklama önerisi; tetikleme değerlendirmesi, becerinin ajanın ilk araç çağrısı olduğu bir çalıştırmaı sayar.
[2] Anthropic, Extend Claude with skills (2026), Claude Code Docs. Beceri listeleme işleyişi, 1.536 karakterlik sınır, listeleme bütçesi, /skill-name ve tetikleme ölçümünün çıktidan ayrı yapılması.
[3] J. Gao, AGENTS.md outperforms skills in our agent evals (2026), Vercel Blog. Bir Next.js belgeleme becerisi değerlendirme durumlarının %56’sında çağrılmadı ve bu beceriyle geçiş oranı, belgesiz taban değerle eşleşti.
[4] K. Faghih, W. Wang, Y. Cheng, S. Bharti, G. Sriramanan, S. Balasubramanian, P. Hosseini ve S. Feizi, Tool Preferences in Agentic LLMs are Unreliable (2025), EMNLP 2025. 17 model üzerinden ortalamaya alındığında, açıklaması yazarların en güçlü kesin cümlesini taşıyan bir araç, aynı aracın bu cümlesiz halinin %11,9’una karşı test durumlarının %79,1’inde doğru kullanıldı.
[5] D. Kundel ve G. Chua, Testing Agent Skills Systematically with Evals (2026), OpenAI Developers Blog. Beceriler için açık, örtük, bağlamsal ve negatif-kontrol test durumları.
[6] Anthropic, Test plugins with evals (2026), Claude Code Docs. claude plugin eval: her durum varsayılan olarak üç kez eklentiyle ve üç kez entsiz çalıştırılır.
[7] J. H. Takeda, How to Build a Production-Ready Claude Code Skill (2026), Towards Data Science. “Itici” açıklamaları önerir ve skill-creator’ın tetikleme döngüsünü betimler.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.