

İğne yapraklı ağaçları çok seviyorum. Ormanlarda gezmeyi ve iğneleri ile kozaları görmeyi seviyorum.
Bel de şu anda yapay zeka ajanları hakkında bir makalede bunu okumanın sebebini merak ediyor olabilirsiniz.
Kısacası, başka bir ülkeye taşındım ve çınar ağaçları arasında gerçekten keyifli gezmeleri için yerler bulmak istedim, ancak bu tür bir gezinin orada pek popüler olmaması nedeniyle bunu yapmanın kolay bir yolu bulamadım. Bu yüzden, benim gibi insanlar için bir yan proje olarak iğne yapraklı ormanların bir haritasını oluşturmaya başladım. Plan, resmi orman envanterini almak, içindeki adlandırılmış yerleri bulmak ve onları bir harita üzerine koymaktı. Adlandırma kısmının bir akşamımı alacağını düşündüm, ancak gerçekte istediğim verileri nasıl bulup birleştireceğimi çözmek birkaç günümü ve çok, çok sayıda token‘ı aldı.

İsimler iki kaynaktan geldi: gönüllüler tarafından çizilen OpenStreetMap ve ulusal haritalama kurumu Ordnance Survey. Bu iki kaynağın birlikte ülkendeki neredeyse tüm adlandırılmış iğne yapraklı ormanları listeleyeceğini varsaydım, bu yüzden onları birleştirdim ve ilerledim.
Toplamda 100 hektar veya daha büyük 1.515 orman buldular. OpenStreetMap bunların 1.052’sine, Ordnance Survey 1.190’ına sahipti ve 727’si her iki haritada da vardı. Merakıma dayanarak bu üç sayıyı, balıkçıların 1890’lardan beri kullandığı bir hesaplamaya koydum ve bunun yaklaşık 1.722 orman olması gerektiğini söyledi, yani her iki harita birlikte yaklaşık 207’sini, yani yaklaşık %12’sini kaçırmıştı.
Şaşırdım ve biraz da kuşkuluydu, çünkü o 207 ormanı kimse görmedi. Bir hesaplama bunların var olduğunu nasıl bilebilir?
Yöntemin kökeni
Bir gölde kaç balık yaşadığını bilmek istediğinizi, ancak onu kurutamadığınızı düşünün 🎣. 100 balık tutar, her birini küçük bir etiketle işaretlersiniz ve salarsınız, bir hafta sonra tekrar 100 balık tutarsınız. Eğer ikinci avın 20’si etiketliyse, ilk avınız gölün yaklaşık beşte biri demektir, dolayısıyla gölde yaklaşık 500 balık vardır.
Buna yakala–tekrar yakala yöntemi denir. Danimarkalı biyolog C. G. J. Petersen bunu 1890’larda genç levrek balıklarına, Frederick Lincoln 1930’da Kuzey Amerika ördeklerine uyguladı ve 1951’de Douglas Chapman, örtüşme küçükken daha iyi davranması için küçük bir düzeltme ekledi.
İki harita, iki yakalamayla aynı şekilde çalışır. Her harita bir ağdır; her iki haritada da görünen ormanlar tekrar yakalanan balıklardır ve örtüşmenin büyüklüğü, her haritanın ne kadar kapsamlı olduğunu ve dolayısıyla ikisinin de yakalayamadığı orman sayısını söyler.
Tüm tahminci beş satırda sığar:
def chapman(n1, n2, m, z=1.96):
“””İki bağımsız yakalamadan toplamı tahmin et.
n1, n2: Her kaynak tarafından bulunan öğeler; m: Her iki kaynak tarafından da bulunan öğeler.”””
N = ((n1 + 1) (n2 + 1)) / (m + 1)
var = ((n1 + 1) (n2 + 1) (n1 – m) (n2 – m)) / ((m + 1) 2 (m + 2))
return N, N – z var 0.5, N + z var ** 0.5
N, lo, hi = chapman(n1=, n2=, m=)
Ormanlar için bu, 1.722’lik bir tahmin ve 1.678 ile 1.765 arasında bir %95’lik aralık verir.
Bunu kırabilecek varsayım
Bunların hepsinin arkasında tek bir büyük varsayım var: iki kaynağın bağımsız olması gerekir. Başka bir deyişle, ilk haritada görünen bir ormanın, ikinci haritada görünme olasılığını ne artırması ne de azaltması gerekir.
Bunun bozulmasının iki açık yolu var.
-
İlk olarak ünlü orman sorunu var. Bazı ormanlar haritaların her birinde yer alır. Belirli ormanlar her iki kaynak için de bulunması daha kolayysa, örtüşme çok büyür ve tahmin aşağıya doğru itilir. Bu durumda %12 yalnızca bir taban değeri; gerçek açık bundan daha büyük olabilir.
-
Diger olasılık, iki haritanın farklı konularda uzmanlaşması olabilir. Gönüllüler parklara ve doğa koruma alanlarına yönelirken, ulusal bir araştırma çalışma orman plantasyonlarını dahil etmeye daha yatkın olabilir. Her kaynak farklı türde bir ormanı bulmada iyiyse, örtüşme küçülür ve tahmin diğer yöne kayar, aşırı yüksek hale gelir.
Bu konuda küçük bir kontrol yaptım. Başka bir test için daha önce seçtiğim 18 ünlü ormandan 10’u her iki haritada da yer alıyordu. Bu, tüm ormanlar için %48’e karşı %56 demek. Ünlü ormanların bulunması daha kolay görünüyor gibi işaret ediyor, ancak 18 orman bunu büyük ölçüde güvenilir biçimde söylemek için çok küçük bir örneklem.
%12 tahminini doğrudan test edemedim, çünkü bununla karşılaştırılabilecek tam bir orman listesi yok. Bunun yerine aklımda kalan hata moduydu. Yöntem, iki kaynak aynı kör noktaları paylaştığında çöker.
Bu beni daha geniş bir endişeye götürüyor. Şu anda birçok ekip AI ajanlarını yayımlıyor ve bunları genellikle ajanın kendisiyle aynı model ailesinden bir LLM jüresiyle değerlendiriyor. Üstelik son araştırmalar, aynı sağlayıcıdan modellerin benzer hatalar yapma eğiliminde olduğunu gösteriyor. Dolayısıyla birçok AI değerlendirme projesinde, modelleri aynı blind spotları paylaşan kaynaklarla ölçüyor olabiliriz ve aralarındaki uyum bize yanlış bir güven verebilir.
AI değerlendirmelerinde aynı blind spot
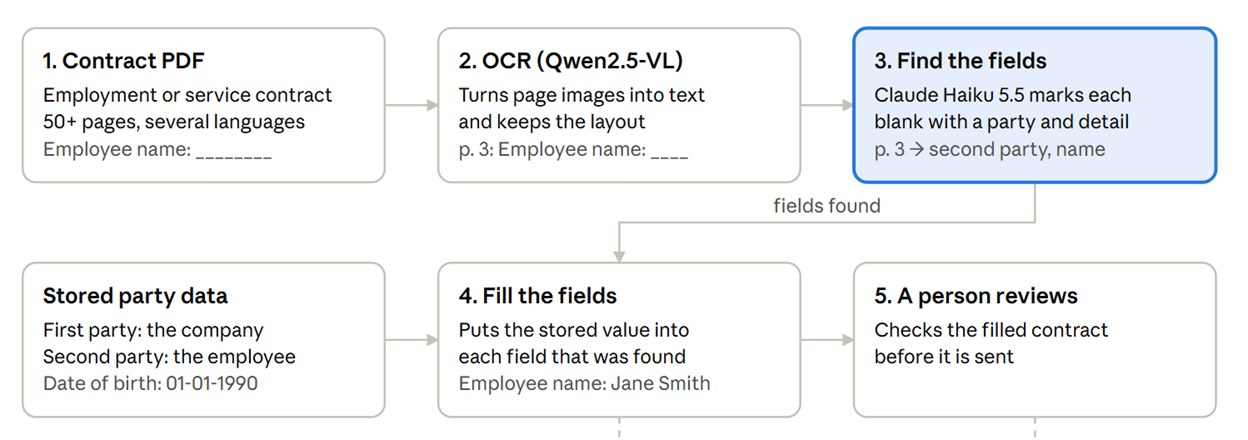
Bir süre önce işte sözleşme dolduran bir yapay zekâ ajanı oluşturmaya yardım ettim. Belgeler çoğunlukla uzun sözleşmelerdi (iş sözleşmeleri ve hizmet sözleşmeleri), her biri en az 50 sayfa uzunluğunda ve birkaç dilde yazılmıştı. İçinde sürekli aynı bilgiler için boşluklar vardı: adlar, adresler, doğum tarihleri, şirket detayları. Amaç, bu bilgilerinin her yeni belgeye tek tek girilmesine gerek kalmamasıydı.
Her iki tarafın da detaylarını, sözleşmedeki rolleriyle eşleştirilmiş şekilde depolamıştık; bu yüzden ilk taraf genellikle şirket, ikinci taraf ise çalışan oluyor. Ajanın görevi, sözleşmedeki her boşluğu bulmak, hangi tarafın ve hangi detayın sorulduğunu belirlemek ve onu doldurmaktydı. Sözleşme “Çalışanın Adı” diyorsa, ajan oraya çalışanın adını koymalı; “Doğum Tarihi” diyorsa 01-01-1990 koymalıydı.
Sözleşme dolduran ajanı, adım adım (yazarın resmi)
Qwen2.5-VL taramalı sayfaları metne çeviriyor, Claude Haiku 5.5 alanları buluyor, depolanmış değerler o alanlara giriyor ve bir kişi göndermeden önce sonucu kontrol ediyor.
Bu ajan için değerlendirmeyi ben kurdum. 100 sözleşme üzerinde manuel QA ile başladı; inceleyiciler doldurulan alanları tek tek elden geçirdi ve ikinci bir LLM yargıç olarak görev yaptı. Her iki kontrol de, ajanın bulduğu her alan için aynı soruyu soruyor:
-
değer doğru mu
-
doğru kutuya konulmuş mu
Ancak bu kontrollerden hiçbiri, hiç bulunmayan alanları ölçmüyor.
Ajan yanlış bir değeri doğru kutuya koyarsa, biri bunu fark eder ve düzeltilir — basit, değil mi? Ama ajan bir alanı hiç tespit etmezse, hiçbir raporde görünmez.
İki ulusal haritanın 727 ormanda hemfikir olduğunu ve yine de %12’sini kaçırdığını gördüğümde, kontrollerimizin de aynı kör noktaya sahip olduğunu anladım: yargıç ve inceleyiciler yalnızca ajanın zaten bulduğu şeye bakıyor, bu yüzden kurulumdaki hiçbir şey ajanın kaçırdığı bir alanı göremez. Bu alanları saymak için belgede kendi başına arayan ikinci bir kaynağa ihtiyacınız var ve yine de bu, iki kaynağın aynı şeyleri kaçırma eğiliminde olmaması durumunda işe yarar.
Sonuç anahtarı tam olan sözleşmeler üzerinde test etmek
Genel olarak, değerlendirme, bir görevde herkesin zaten her şeyi etiketlediği sürece doğrulanabilir. Ancak yeni bir görevde bu tam sonuç anahtarını oluşturmak pahalıdır ve özenle yapılan manuel etiketleme bile bazı noktaları kaçırır.
Aşağıdaki bölüm, yöntemi işte kullanacağın şekilde değil.
Üretimde kimse belgelerini etiketlemez ve tam da bu yüzden tahmine ilk başta ihtiyacın vardır. Burada etiketler farklı bir rol oynar. Tahminleyici onları hiç görmez, yalnızca hangi ajanın hangi alıntıyı bulduğunu gösteren bir tablo alır; ben de etiketleri sonra cevabını değerlendirmek için kullanırım.
Bu yüzden bu bölümü üretim kurulumundan çok, örnek üzerinden anlatılmış bir uygulama olarak düşün. Doğru cevap bilindiği için yöntemin nasıl davrandığını, nerede hata yaptığını ve sonuç anahtarı olmadan kullandığın günde ona ne kadar güvenebileceğini gösterir.
Bunun pratikte ne anlama geldiğini göstermek için tam sonuç anahtarı olan belgelere ihtiyacım vardı, bu yüzden tam olarak bunu sunan CUAD’ı kullandım: avukatların 41 türün her bir maddesini etiketlediği 510 ticari sözleşme.
10.000 token’ın altında kalan 294 sözleşmeyi ve bir sözleşmede birden fazla kez görülebilecek 10 madd türünü aldım; bunlar lisans izinleri, sorumluluk tavanları, devrin önlenmesi ve denetim hakları gibi. Bu da 1413 etiketli madd verdi ve bu, aşağıdaki her tahminin karşılaştırıldığı gerçek sayıdır.
Her ajan bir sözleşmeyi bir kez okur ve 10 türün her maddesini alıntılar, ben de bu alıntıları avukatların etiketleriyle eşlerim. Bir alıntının maddi bulması için iki metnin en az kısa olanın yarısı kadar örtüşmesi gerekir; sözleşmeden tam kopyalanmayan alıntılar ise bulanık eşleştirmeyle konumlandırılır. Ajanları bir merdiven gibi kurdum, birbirinin neredeyse kopyasından çok farklı olanlara kadar:
İki aileyi fiyattan eşledim, çünkü Haiku 5.5 ile GPT-6 luna aynı paraya, Sonnet 5.5 ile de GPT-6.1 sol aynı paraya geliyor. Tüm çalıştırma 294 sözleşme ve 9 ajan için 14,71 dolara mal oldu.\
Ajanların kaçırduğu maddeler
Agent’ların çoğu maddelerin yaklaşık dörtte birini kaçırdı:
1413 maddenin 127’si yedi agent’ın hepsi tarafından kaçırıldı, yani bu oran %9 ve ormanların öngördüğü %12’ye oldukça yakın.
Doğruluk düşük görünüyor, ancak bunun bir kısmı cevap anahtarının kendisinden kaynaklanıyor. El ile birkaç “yanlış pozitif’i incelediğimde, bazıları avukatların etiketlemediği gerçek maddelerdi; dolayısıyla etiketlerin de kendi açıkları var.
Birbirleriyle uzlaşan iki agent
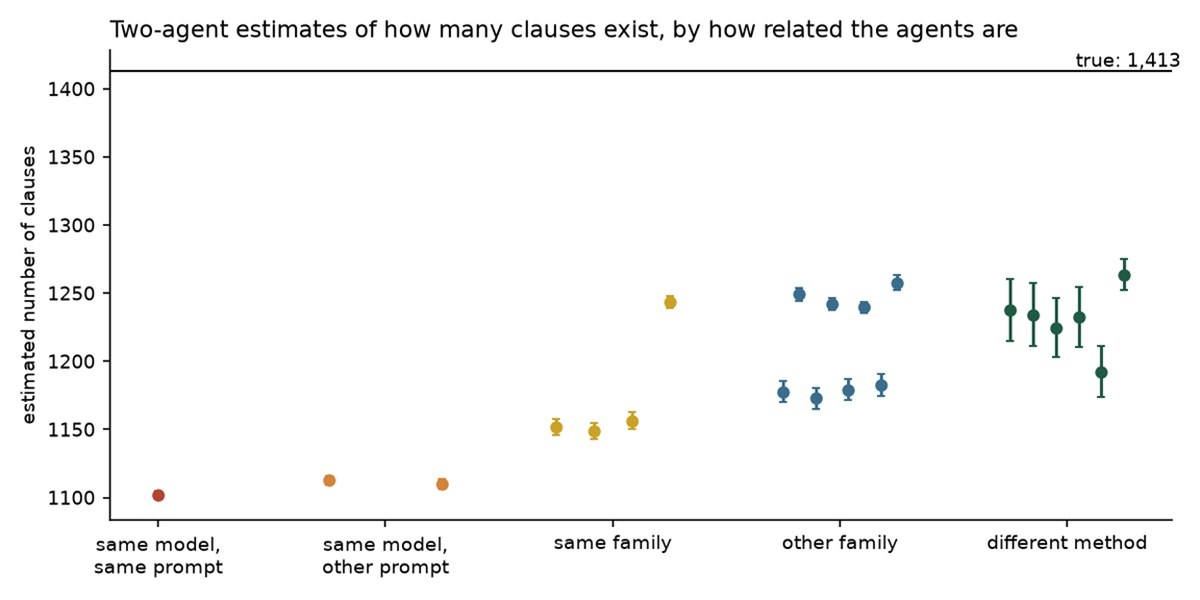
Çalıştırdığım her iki agent çifti için beş satırlık tahminciyi çalıştırdım ve cevabı gerçek 1413 ile karşılaştırdım.
Her nokta bir agent çiftini, kendi %95’lik aralığıyla birlikte temsil eder. Siyah çizgi gerçek sayıdır (görsel yazar aittir)
Çalıştırdığım her iki agent çifti için beş satırlık tahminciyi çalıştırdım ve cevabı gerçek 1413 ile karşılaştırdım:
-
Aynı modelin iki çalıştırması 1.102 madden tahmin etti (gerçeğin yaklaşık %22’si altında).
-
Aynı aileden gelen çiftler 1.149 ile 1.243 arasında bir sonuca ulaştı.
-
Farklı aileden gelen çiftler 1.173 ile 1.258 arasında daha iyi bir sonuca ulaştı.
-
Anhtar kelime kurallarını içeren çiftler ise bunlara yaklaşık olarak eşit bir performans gösterdi.
Her şeyden önce hata çubukları ilgimi çekti. Haiku’nun iki çalıştırması, gerçeği belirgin biçimde aşağı tahmin eden bir sonucun yaklaşık artı eksi 3 madde kadar bir marj bildirmesi, bunun çünkü aralığın yalnızca örneklem gürültüsünü ölçtüğü ve paylaşılan kör noktalar hakkında hiçbir şey bilmediği için ortaya çıkıyor; bu nedenle birbirleriyle çok uzlaşan iki agent, hem çok düşük hem de son derece emin bir tahmin üretiyor. Normal bir değerlendirmede, agent ile jüri arasındaki yüksek uzlaşma genellikle iyi bir işaret olarak okunur; ancak bu ortamda tam tersi söz konusu.
Saçmalı olduğum bir şey, iki OpenAI modelinin sağlayıcılar arasındaki çiftlerden ancak çok az daha benzer olmasıydı; Claude modelleri ise açıkça benziyordu. Dolayısıyla “aynı aile” benzerliğin sabit bir miktarı anlamına gelmiyor ve kullandığınız modeller için bunu ölçmenin değerli olabileceğini düşünüyorum.
Sağlayıcı değiştirmek de baş başına yeterli değildi; çünkü en farklı çiftler bile yaklaşık %10 oranında aşağıda kaldı.
Eşit olmayan zorluğu yöneten tahminciler
Ekoologlar bu sorunu onlarca yıl önce yaşadılar, çünkü bazı hayvanlar diğerlerinden daha kolay yakalanır. Birden fazla yakalamayı kullanan ve bir kez, iki kez, üç kez ve böylece görülen hayvan sayısına bakan tahminciler geliştirdiler. Yazılım mühendisleri daha sonra aynı modelleri kod incelemelerinden sonra kalan hata sayısını tahmin etmek için kullandı ve dört’ten az incelemeciyle hiçbir model yeterince doğru olmadığını ve eksik tahminin büyük thể olabileceğini buldu.
Bunların en basiti, Burnham ve Overton (1978)’ün jackknife tahmincisidir ve yalnızca tam olarak bir kaynak tarafından bulunan ve tam olarak iki kaynak tarafından bulunan öğe sayılarını gerektirir:
def jackknife2(H):
“””Second-order jackknife (Burnham & Overton 1978).
H: 0/1 matrisi, satırlar = en az bir kaynak tarafından bulunan öğeler,
sütunlar = kaynaklar.”””
k = H.sum(axis=1) # her öğeyi kaç kaynak buldu
t = H.shape[1]
f1, f2 = (k 2).sum()
return len(H) + (2 t) / t f1 – (t (t – 1)) / (t (t – 1)) f2
Yedi ajanın tamamıyla MAE bir ajan çifti için yaklaşık %12’den yaklaşık %5’e düştü. Ajanların birbirine hangi derecede bağımlı olduğunu da öğrenen log-lineer model yaklaşık olarak aynı sonucu verdi ve tüm cümleler üzerinde gerçek değer olan 1413’e karşı 1360 tahmininde bulundu.
Ajanların tek tek eklenmesi (yazarın resmi)
Bu, yukarıdaki fikrin en net resmidir. Her yeni ajan birkaç cümle daha bulur ve tahmin, ortada hâlâ ne kadar kaldığını gösterir. Aynı modelin kopyaları çok az katkı sağlarken, farklı modeller ve anahtar kelime kuralları iki çizgiyi de hareketlendirir.
Her ajanın etiketsiz hatırlatma oranını tahmin etmek
Bir değerlendirme paneli genellikle kaç maddenin var olduğunu göstermez, her ajanın ne kadar iyi olduğunu gösterir. Ancak toplam tahminine sahip olduktan sonra, her ajanın geri dönüşü, bulduğu miktarın o toplama oranıyla basitçe hesaplanır.
Sık kullanılan kısa yol, birleştirilmiş geri dönüşümdür: bir ajanın bulduğu her şeyi alırsınız, bunu tam gerçeklik olarak ele alır ve her ajanı bunun üzerinde ölçersiniz. Bildiğim çoğu ekip böyle bir şey yapar ve bence bu da tekrar ormandaki kör nokta, çünkü hiçbir ajanın bulmadığı şeyin var olmadığı varsayımına dayanır.
Sınamayı gerçekçi kılmak için etiketleri tamamen kaldırdım. Ajanların alıntıları ögeler haline getirilir ve sonra bir insan bu ögelerin rastgele %10’unu denetler. Bu denetim, bir ajan tarafından görülen, iki ajan tarafından görülen ve böyle devam eden bir ögenin ne sıklıkla gerçek olduğunu söyler.
Her ajan için gerçek geri dönüşüm (siyah), birleştirilmiş geri dönüşüm (kırmızı artı) ve %10’luk denetimle yakalama-yeniden yakalama (yeşil kare) (yazarın resmi)
Birleştirilmiş geri dönüşüm, her ajanın geri dönüşünü 6 ile 12 puan arasında abarttı ve Haiku, gerçekte 75% iken 86% gibi göründü. Küçük denetimle yapılan yakalama-yeniden yakalama tahmini, ço ajan için gerçek değere 2 puan içinde kaldı. Sözleşmelerin 1.000 bootstrap yeniden örneklemesinde medyan hatası 3.8 puandı, birleştirmenin 9.7’sine karşı.
Bu gerçekten güçlü bir sonuç! Ancak öngördüğüm her şey gerçekleşmedi.
Ne işe yamadı
Farklı mave tiplerinde uzmanlaşmaları için söylenen iki Haiku ajanının abartmasını bekliyordum (uzmanlaşan haritalar gibi), ama yine de %18 düşük çıktılar. Dolayısıyla, aynı modele farklı odak talimatları vermek kör noktalarını her zaman farklı kılmadı.
Ayrıca farklı ailelerden ajanların, gerçekliği içeren aralıklar vermesini bekliyordum, ama öyle yapmadılar, grafik gösteriyordu. Önceden not ettiğim başka bir sınama da anlamsız çıktı: Eğer gerçek sayı biliniyorsa, iki kaynaklı tahmin sadece gerçekliğin anlaşma oranına bölünmesidir, dolayısıyla yapıları gereği mükemmel korelasyonlardır.
Sonuçlarım
Bu çalışma, iş yerinde değerlendirmeleri nasıl yaptığımını değiştirdi. En çok etkileyen üç değişiklik şunlardır:
-
Anlaşmayı iyi bir işaret olarak görmeyi bıraktık. Ajan ile hakem arasındaki yüksek oranda anlaşma bize eskiden güvende hissettirirdi. Artık bunu yalnızca ajanın doldurduğu değerlere yönelik bir kontrol olarak okuyoruz; ajanın atladığı alanlar hakkında hiçbir şey söylemiyor.
-
İkinci bir çıkarıcı ekledik. Haiku ajanının yanına, GPT Luna aynı OCR metnini kendi başına okuyor ve bulduğu her alanı listeliyor.
-
Tahmini geri çağırma değerini doğruluk yanında raporluyoruz. İki çıkarıcı arasındaki örtüşmeden yola çıkarak ilk tahmin, ajanın boş bırakıldığı kimse tarafından fark edilmeden önce yaklaşık %12 oranında boşluğun eksik olduğunu gösterdi.
Genel olarak, bir çıkarıcı ajanı değerlendiren herkese şunları önerebilirim:
-
En az üç denetici kullanın ve bunlardan birini farklı yapın. Üçüyle ne kadar birbirine bağımlı olduklarını ölçebilirsiniz. Denememde en ucuz farklı denetici, yalnızca yarımdan fazlasını bulan bir anahtar kelime kuralları setiydi; ancak kör noktaları LLM’lerininkinden farklıydı.
-
Eğer bazı öğeler herkes için kolaysa, iki kaynaklı bir tahmin çok düşük olur, bu yüzden farklı zorluk dereceleri için tasarlanmış bir tahminci kullanın.
-
İki denetici arasında yoğun bir anlaşma varsa, dar bir aralık bu daha yakından bakmanız için bir nedendir.
-
Küçük rastgele bir örneği elle denetinn. Bende %10, yanlış pozitifleri düzeltmek için yeterliydi.
-
Her ajanın tahmini çağırma değerini raporlayın. Gördüğüm çoğu ajan değerlendirmesi yalnızca doğruyu raporluyor ve birleştirilmiş çağırma değeri burada her ajanı olduğundan daha iyi gösterdi.
Elinizde zaten bir çıkarım ajanı varsa, bu hafta çalıştırabileceğiniz bir kontrol var. Aynı belgeler üzerinde ikinci bir çıkarıcıyı kendi başına, farklı bir model ya da hatta ana çıkarıcının çıktısını puanlayan bir yargıç yerine bir dizi anahtar kural ile çalıştırın. Her ikisinin de bulduğu öğeleri, yalnızca birincinin bulduğu öğeleri ve yalnızca ikincinin bulduğu öğeleri sayın ve bu üç sayıyı beş satırlı işleve yerleştirin. Tahmini toplam, daha önce gördüğünüzden belirgin şekilde yüksekse, değerlendirmeniz asla tam olmayan bir listedeki doğruluğu ölçüyordur.
Kendiniz deneyin
Tüm kod ve eşleşen sonuçlar GitHub üzerinde.
Ve çam ormanımın ilk sürümünü görmek isteyen herkes için bağlantı burada: evergreendaysout.co.uk (tamamen ücretsiz!)
-
Burnham, K. P., & Overton, W. S. (1978). Estimation of the size of a closed population when capture probabilities vary among animals. Biometrika, 65(3), 625–633.
-
Chao, A. (1987). Estimating the population size for capture–recapture data with unequal catchability. Biometrics, 43(4), 783–791.
-
Briand, L. C., El Emam, K., Freimut, B. G., & Laitenberger, O. (2000). A comprehensive evaluation of capture–recapture models for estimating software defect content. IEEE Transactions on Software Engineering, 26(6), 518–540.
-
Hendrycks, D., Burns, C., Chen, A., & Ball, S. (2021). CUAD: An expert-annotated NLP dataset for legal contract review. Data on Zenodo, CC BY 4.0.
-
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of ICML, PMLR 267.
-
Forest counts: National Forest Inventory 2023 (Forestry Commission, OGL v3), OS Open Names (Ordnance Survey, OGL v3; contains OS data © Crown copyright and database right), OpenStreetMap © OpenStreetMap contributors (ODbL).
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.