

2026 yılında bulut tabanlı büyük dil modellerine (LLM) yönelik küresel bağımlılığın son bir yılda hızla ve daha önce görülmemiş bir şekilde artması hiçbir sır değil. Yapay zekâya yapılan kurumsal harcamalara bakmak yeterli: Geçen yıl 33 milyar dolardan, Eylül 2026 itibarıyla 177 milyar dolara yükseldi. VC şirketi Menlo Ventures, 2026 raporunda Claude Code ve OpenAI Codex gibi kodlama araçlarının bunun 24 milyar dolarını tek başına karşıladığını belirtti.
Kendi Claude kullanım faturam da aynı hikâyenin mikroekonomik bir versiyonunu anlatıyor. Beş saatlik sınır iş akışımı oturumun ortasında her bozduğunda, API oranlarından faturalandırılan kullanım kredilerine geçiyorum ve tek bir ayda bu ek yüklemeler, mevcut 20 dolarlık Pro paketimin üzerine 300 doları aştı. Tabii ki bu noktaya, 14.7GB’lık bir model dosyasını sürücümde tutmak yerine kredi kartımı sallayıp sınırların kaybolmasını daha kolay görmek gibi bir hata yaptığım için geldim.
Beş saatlik kullanım sınırı aslında Claude Pro’da bir duvar değildi
Daha çok, her geçtiğimde ödediğim bir gümrük noktasına benziyordu
Claude’yu kullanmış olan herkes, şu anda piyasada bulunan en pahalı AI hizmetlerinden biri olduğunu bilir. Claude’yu çalıştırdığınızda, aynı anda iki kullanım sınırını işletir. Her beş saatte bir sıfırlanan oturum sınırına ve bunun üzerine gelen haftalık sınıra dikkat etmelisiniz. Sohbetleriniz ve Claude Code oturumlarınız aynı kotala sayılır ve sınırlardan birine çarpmak sıfırlanmayı beklemek anlamına gelir.

Sorunu ortadan kaldırmanın bir yolu var ve Anthropic bunu neredeyse pürüzsüz bir şekilde yapmayı sağladı. Kullanım kredileriyle, en az 5 dolarla yükleme yapabilir ve istekleriniz standart API oranlarından ödeme-ya-da-öde faturalandırmasına geçer. Aylık harcama tavanınızı siz belirledikçe (benim ilgilenmediğim gibi) çalışmaya devam edebilir veya otomatik yeniden yükleme seçeneğiyle sınırsız çalışabilirsiniz. Claude, bakiyeniz bir eşiğin altına düştüğünde otomatik olarak daha fazla kredi satın alır ve böylece fatura, izin istemeksizin büyümeye devam eder.
Modeli kullanıma ve gösterdiğiniz çabaya göre fatura daha az ya da daha pahalı olabilir. Örneğin, Fable 5.1 milyon giriş tokeni başına 10 dolar, milyon çıkış tokeni başına 50 dolar tutar; bu da Opus 5.5’in fiyatının 2,5 katıdır. Benim üzerinde olduğum Pro planında ise Fable 5 ve Fable 5.1, planın kotasına hiç dokunmadan, ilk token’dan itibaren doğrudan kredilerden işletilir.
Anthropic’in yeni tanıttığı Fable 5.2, milyon giriş tokeni başına 8 dolar ve milyon çıkış tokeni başına 40 dolarla biraz daha ekonomik, ancak Pro’da aynı şekilde faturalandırılır. Tek istisna, lansman haftasıdır; bu dönemde üç Fable modeli de 16 Kasım’a kadar, haftalık kotanın yarısına kadar, ekstra maliyet olmadan Pro kotasına dahil edilir.
Bulut token’larım için subvansiyon vermek neredeyse hiçbir şeye mal olmuyor
Hibrit bulut ve yerel AI kurulumum maliyetimi neredeyse yarıya indiriyor
Bulut AI kodlama kurulumunu yerel bir modelle desteklemeyen pek çok kullanıcı, iki yanılgıdan birine düşer. Ya donanımlarının yetkin bir yerel modeli çalıştırmaya yeterli olmadığını düşünürler ya da yerel modellerin kodlama için baştan yeterli olmadığını düşünürler. Ben de tam tersine, ikisine birden düşmüştüm.
Qwen3.6-35B-A3B ile kodlama yaparken edindiğim deneyim sayesinde, bunlardan hiçbirinin geçerli olmadığını öğrendim. Model, llama-server üzerinden RTX 4070 Ti Super’ımda çalışıyor ve bir kez çalışmaya başladıktan sonra tek maliyet elektrik oluyor; kendi ölçümümle milyon token başına yaklaşık 15 cent tutuyordu.
Bunu, kısa sürede alışkanlığa dönüşen bir başlangıç deneyiminden öğrendim. Python kodlama iş akışımda, her görevi yerel modelle başlatırım: önce dosya yapısını, ana döngüyü, temel sınıfları ve ilk sürümü çalıştıracak kadar mantığı içeren başlangıç iskeletini o geliştirir. Ardından bu derlemeyi kendim çalıştırır, ince ayar için ise Claude Code’a Opus 5.5 ile teslim ederim; böylece modelin spesifikasyonuma uygunluğunu kontrol eder, hataları düzeltir veya eksik kaldığı yerleri denetir.
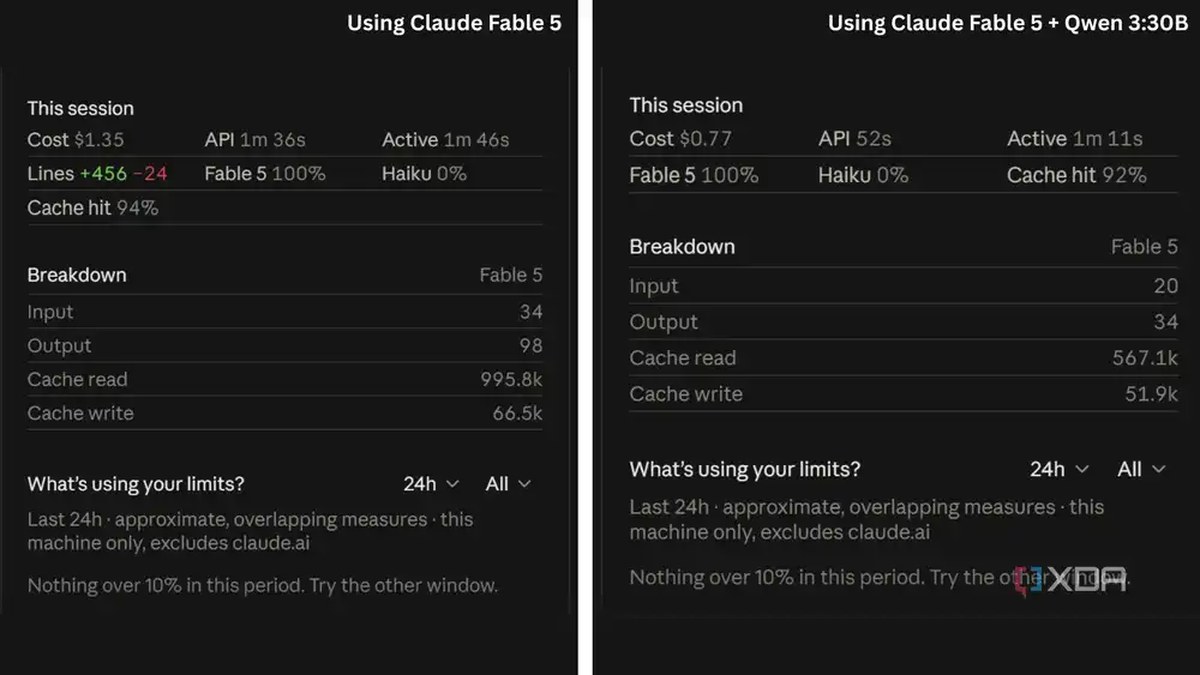
September ayında geliştirdiğim bir Asteroids klonunda ilk derlemeyi daha eski bir Qwen modeli yazdı ve Claude üzerinden iyileştirilmesinin maliyeti, Claude’un sıfırdan kurduğu versiyona göre 1,35 dolar yerine 0,77 dolar oldu; bu da %43’lük bir tasarruf anlamına geliyordu. Her iki oturum da Fable 5 üzerinde çalıştığından, açığın tamamı Claude’un iyileştirme aşamasında daha az iş yapmasından kaynaklanıyordu.
Yetkin bir yerel modeli kurmak hiç olmadığı kadar kolay
Tek gereken model dosyası ve llama.cpp’nin güncel derlemesi
Bunu bir kez söyledim ve muhtemelen defalarca tekrarlayacağım. Yerel yapay zekâ manzarası, çoğunun tahmin ettiğinden daha hızlı ilerliyor ve bulut bazlı yapay zekâ iş akışınızı, yaptığınız işe özel uyarlanmış bir modelle tamamlayabilirsiniz. Yine de yinelemeli kodlama görevleri, kodun ilk yazımını yereli üstlenirken en büyük faydayı sağlıyor; ancak kullanım limitinizi tüketmemek için yerel modele devredebileceğiniz çok çeşitli görev var.
Yerel yapay zekâ yığımda, ComfyUI üzerinden görsel üreten FLUX 3 Image Klein gibi modellerden; hesaplarınızı gözden geçirmek ve finanslarınızı düzenlemek gibi günlük sorgular için Qwen3.6-35B-A3B ve Gemma 4 gibi çok amaçlı modellerden ve yazılımınızı güncel tutmak gibi günlük görevleri Hermes Agent üzerinden devredebileceğiniz, yetkin ajan modellerinden (Nemotron Bolt gibi) yararlanıyorum.
Metin modelleri için kurulum, llama.cpp’nin güncel derlemesini indirmek, CUDA derlemesini seçmek (bende olduğu gibi bir Nvidia GPU’nuz varsa), sıkıştırılmış dosyayı açmak, llama-server’ı çalıştırmak ve onu GGUF model dosyalarınıza yönlendirmek kadar basit. Ancak komut satırları sizi korkutuyorsa, LM Studio ve Ollama gibi ücretsiz uygulamalar, kurulumu baştan sona üstlenen ve yerel yapay zekâ çıkarımına yalnızca birkaç tıklamayla başlamanızı sağlayan yeni başlayanlar için harika bir yol.
Yerel modellerde beş saatlik sınır yok
Ön uç yapay zekâ modelleri güçlü, hızlı ve yetenekli; iş akışınızı desteklemek için geniş bir araç ve MCP yelpazesine erişebilir. Ancak aynı zamanda pahalıdır, verinizi buluta açar ve siz jeton ve dolar harcamaya hazır olmadıkça iş akışınızı felç edecek sınırlarla gelir.
Yerel modeller yetenek bakımından ön uç modellerin yanında hiç yok gibi olsa da, yetenekteki eksiklikleri erişilebilirlik ve maliyet açısından fazlasıyla kapatılıyor. Yine de benim görüşüme göre, ikisinden birini tercih etmek akıllıca değil; bunun yerine hem iş akışınıza hem de cüzdanınıza fayda sağlayabilecek ince bir denge söz konusu.
Llama.cpp, büyük dil modellerini bilgisayarınızda yerel olarak çalıştıran açık kaynaklı bir çerçevedir.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.