

BANKING77 test setinden bir mesaj işte: “Cüzdanımı bugün tüm kredi kartlarımla kaybettim. Kartı bloke edip bir yedek gönderir misiniz?”
Bunu, yedi bankacılık niyetinden seçim yapabilen ve izotonik regresyon ile kalibre edilmiş bir lojistik regresyon sınıflandırıcısına verdim. Yedi niyetin içinde “kaybedilen veya çalınan kart” yoktu; doğru cevap listede değildi. Sınıflandırıcı, 0.984 olasılıkla card_payment_fee_charged’ı seçti. “0.90 üstünde hareket et” yönlendirme kuralı, kaybedilen cüzdanı bir ücret sorunu olarak görüp geçip giderdi. Kalibrasyon öncesi aynı lojistik regresyon, aynı yanlış etiketi 0.51 değerinde verirdi ve bunu üst seviyeye taşırdı. Kalibrasyon modeli ortalama olarak iyileştirdi ama bu hata konusunda daha emin kıldı.
15 Eylül 2026’da TypeSafe AI, bu tür kararlara yönelik inşa edilmiş bir model olan Jev’i yayımladı. Ona bir durum (bir destek bileti, bir işlem kaydı, önerilen bir araç çağrısı) eklersiniz ve tipli sorular bir kümesiyle birlikte gönderirsiniz; o da olasılıklarla yapılandırılmış yanıtlar döndürür: tanımladığınız bir listeden bir seçim, tanımladığınız bir rubrike göre bir puan ya da numara eklenmiş bir evet/hayır. TypeSafe, modelin metin üretmediğini, dolayısıyla ayrıştırılacak bir JSON’un veya bozuk çıktı için yeniden deneme döngüsünün olmadığını söylüyor [1]. (API, çıktı tokenlarını raporluyor; bunlar faturalandırılmıyor.) TypeSafe, bunu Kahneman’ın hızlı-yavaş ayrımından esinlenilen bir System One modeli olarak adlandırıyor [2] ve kalibre edilmiş kararlara yönelik öğrenme anlamına gelen RLCD adlı bir yöntemle eğittiğini belirtiyor. RLHF, insanların tercih ettiği yanıtları ödüllendirir. RLCD ise gerçeği yansıyan olasılıkları ödüllendirmeli; böylece 0.2 olarak atanan sonuçlar zamanın yaklaşık %20’sinde gerçekleşmeli [1].

Bu testleri çalıştırdığımda, TypeSafe henüz hiçbir makale yayınlamamıştı ve hiçbir ağırlık paylaşmamıştı; Jev ise yalnızca API üzerinden erişilebilir durumdaydı ve giriş her milyon token başına 0,042 dolar ücretlendirilirken çıkış ücretsizdi [1]. Üstelik iki soru sordum: Açık araçlarla Jev’in sözleşmesi yeniden üretilebilir mi (tipli sorular, doğrulanabilir olasılıklar ve kodun alabileceği bir dal olarak red)? Ve gerçek API’nin katma değeri ne? Sözleşmeyi scikit-learn üzerinde yeniden kurdum, küçük açık modellerin ne kadar kalibre edildiğini, kalibrasyonun güven-eşiklisini (confidence-gated) daha ucuza getirebileceğini ve tipli arayüzün nerede kırıldığını ölçtüm; ardından aynı deney düzeneğini Jev üzerinde çalıştırdım.
Buradaki tüm sayılar, atıf yapılmadıkça kendi çalıştırmalarımdan alınmıştır. Jev’in kendisiyle ilgili ayrıntılar TypeSafe’in belgelerinden [1] alınmıştır; Deney 2’deki kaskad maliyetleri ise benim yaptığım varsayımlardır.
Kısacası: 7 niyet diliminde, sıcaklık-ölçekli lojistik regresyon ile Jev’in Choice yanıtları yaklaşık aynı derecede kalibre edilmiştir (ECE 0,022’ye karşı 0,014; eşleşmeli bootstrap bunları ayırt edemez). Tam 77 niyet görevinde açık model daha iyi kalibre edilmiştir (0,031’e karşı 0,065). Jev eğitimsiz bu sonuca ulaşır; her niyet için prompt içinde en fazla üç etiketli örnek kullanır; benim modellerim ise 10.003 etiketli sorguyla eğitilmiştir. Jev’in evet/hayır yanıtları doğru durumlarda aşırı güvensizdir. Hiçbiri seçme tuzluğu açık modellerde ve Jev’de yeniden üretilmiştir. Çerçeve tutarsızlığı da öyledir; ve her iki durumda ham boyutunun çoğu, tek bir eşikte farklı derecede kalibre edilmiş iki sayının karşılaştırılmasından gelir.
Jev nasıl çalışır ve ben onu nasıl yeniden kurdum
Jev’in API’sinin üç soru türü vardır [1]. Bir Choice, tanımladığınız 255’e kadar seçenekten birini seçer ve dağılımın tamamını döndürür. Bir Score, sıralı bir seviye kümesi alır ve beklendiği değeri döndürür; bu değer iki seviyenin arasına düşebilir. Bir Noul (TypeSafe’in evet/hayır doğruluk soruları için kullandığı terim) P(true) döndürür. Her yanıta ayrıca bir güven değeri de eşlik eder. Bu sayı dağılımın ne kadar yoğun olduğunu betimler ve üst olasılıktan ayrıdır.
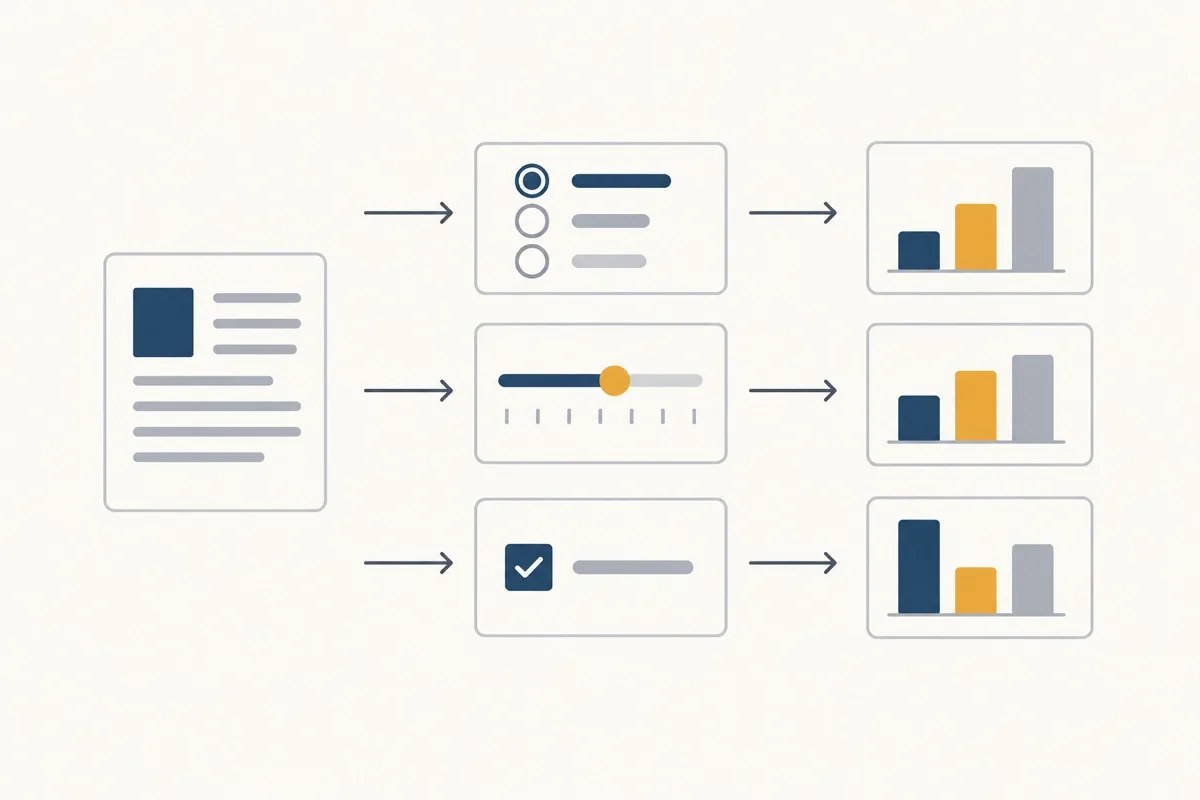
Bir durum girer. Her tipli soru (Choice, Score, Noul) yalnızca başına yanıtlanır ve olasılıklar döndürülür. Resim: yazarın kendi resmi.
Sözleşmeyi düz scikit-learn sınıflandırıcılar üzerinde yeniden uyguladım. Soru ve cevap tipleri veri sınıfları (dataclass) olarak tanımlanmış:
python
from
dataclasses
import
dataclass
@dataclass
class
ChoiceQuestion
name:
str
instructions:
str
criteria:
dict
# option -> description string
@dataclass
class
ChoiceAnswer
choice:
str
probabilities:
dict
confidence:
float
# concentration of the distribution, 0..1
Bir arka uç (backend), (durum, sorular) girdilerini cevaplara eşleyen her şeydir. Açık arka uç, predict_proba metoduna sahip herhangi bir eğitilmiş sınıflandırıcıyı sarar (burada basitleştirilmiş; tam sürüm depo içinde):
python
class
SklearnBackend
(
Backend
):
def
__init__
(self, clf, vectorizer
=
None
):
self
.clf
=
clf
self
.vectorizer
=
vectorizer
def
answer
(self, state, questions):
X
=
self
.vectorizer.transform([state])
proba
=
self
.clf.predict_proba(X)[
]
classes
=
list
(
self
.clf.classes_)
out
=
{}
for
q
in
questions:
options
=
list
(q.criteria.keys())
probs
=
{opt:
float
(proba[classes.index(opt)])
for
opt
in
options
if
opt
in
classes}
total
=
sum
(probs.values())
or
1.0
probs
=
{k: v
/
total
for
k, v
in
probs.items()}
top
=
max
(probs,
key
=
probs.get)
out[q.name]
=
ChoiceAnswer(
choice
=
top,
probabilities
=
probs,
confidence
=
_concentration_confidence(
list
(probs.values())))
return
out
Güvenilirlik için bir eksi normalize edilmiş entropi kullandım: 1.0, tüm kütle tek bir seçeneğe oturduğunda; 0.0, dağılım düz olduğunda. Gerçek Jev, aynı imza altında ikinci bir arka plan olarak devreye girdiğinden, uygulama kodu (eşikler, yükseltme, günlük kaydı) model iç yapısına dokunmaz ve yalnızca geri dönen sayılara göre dallanır.
Deney 1: küçük açık modeller ne kadar iyi kalibre edilmiş?
BANKING77 [3] üzerinde — 77 niyetlik bir banka sorgusu veri seti (10.003 eğitim, 3.080 test) ve eğitim setindeki en sık geçen seven niyetten oluşan 7 niyetlik bir dilim (280 test sorgusu) — Beklenen Kalibre Hatası (ECE) ve Brier skorunu ölçtüm. Dört sınıflandırıcının tamamı aynı özellikleri paylaşıyor: unigram ve bigramlar üzerinden, en fazla 20.000 terimli TF-IDF:
-
çoklu basit Bayes
-
lojistik regresyon (C = 4)
-
aynı lojistik regresyon, sınıf başına izotonik kalibrasyon (scikit-learn’ün CalibratedClassifierCV’si, 3 katman)
-
aynı lojistik regresyon, katman dışı logitler üzerinde tek bir sıcaklık uydurması
ECE [4], tahminleri üst olasılıklarına göre kutulara ayırır ve her kutuda güvenilirlik ile doğruluk arasındaki farkı, kutu boyutuyla ağırlıklandırarak ortalamasını alır:
ECE = Σ_b (|B_b| / n) · |acc(B_b) − conf(B_b)|
Burada B_b, üst olasılığı b kutusuna düşen tahminlerin kümesidir; acc(B_b) bunların ne kadarının doğru olduğu; conf(B_b) ise bu tahminlerin üst olasılıklarının ortalamasıdır. Mükemmel kalibre edilmiş bir model 0 puan alır. Bu makalede açık modeller için de Jev için de 15 eşit genişlikli kutu kullanıyorum. Kodda:
python
def
expected_calibration_error
(y_true, y_prob, n_bins
=
):
“””ECE, eşit genişlikli kutularla: sum_b |acc(b) – conf(b)| |b| / n.”””
bins
=
np.linspace(
0.0
1.0
, n_bins
+
)
ece
=
0.0
for
lo, hi
in
zip
(bins[:
], bins[
:]):
mask
=
(y_prob
>
lo)
&
(y_prob
<=
hi)
if
lo
>
else
(y_prob
>=
lo)
&
(y_prob
<=
hi)
if
mask.sum()
continue
ece
+=
(mask.sum()
/
len
(y_true))
abs
(y_true[mask].mean()
y_prob[mask].mean())
return
float
(ece)
Bu bağlamda Brier skoru, en yüksek olasılığın o en yüksek etiketin doğru olup olmadığı arasındaki kare hatasının sorgular üzerinden ortalamasıdır.
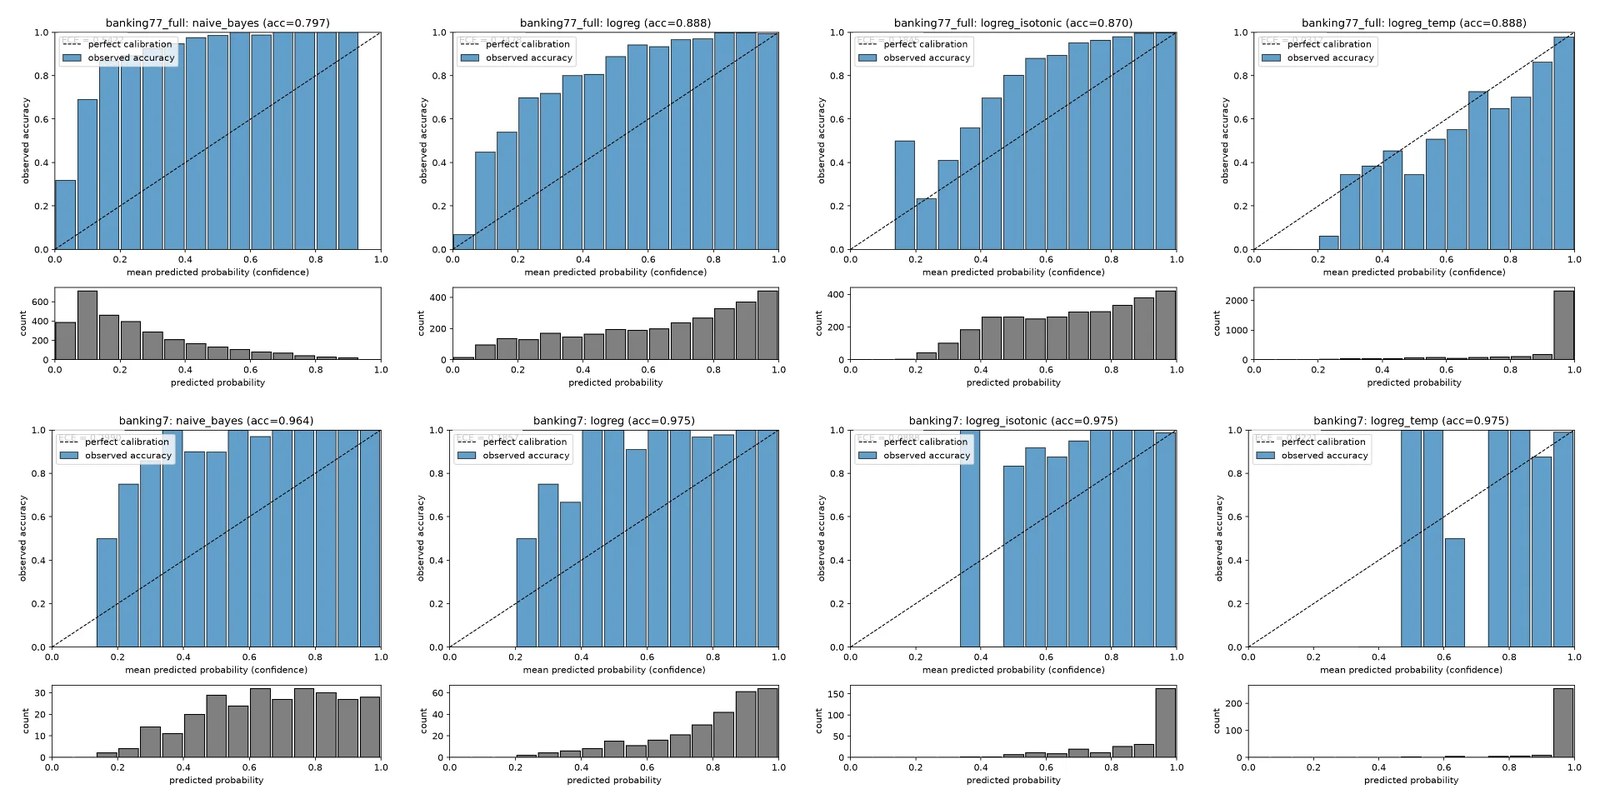
Şekil 1. Yedi niyet dilimi ve tam 77-nyet görevinde tüm dört açık backend için güvenilirlik diyagramları (öngörülen en yüksek olasılık vs. kutu başına ölçülen doğruluk). Görsel yazarın.
Sezgisel Bayes, 77 niyette %80 doğruluğa ulaşırken olasılıkları anlamsıza yakın kalıyor (ECE 0.54). Yön beni şaşırttı. Kitapların Naive Bayes hakkında söylediği gibi aşırı özgüveni bekliyordum [5], ancak tam tersini aldım: ortalaması 0.80 doğruluk karşısında 0.25 olan en yüksek olasılığı ortalaması. Tahminim, 77 sınıf kısa metinle TF-IDF Seviz Bayes’in olasılık kütlesini ince yayması yönünde. Sıradan lojistik regresyon da özgüvensiz, 0.89 doğruluk karşısında 0.64 ortalamalı en yüksek olasılıkla. Özgüvensizlik, Deney 2’nin gösterdiği gibi yanlış eylemlerden çok israf edilen yönlendirme maliyeti doğurur.
İzotonik ve sıcaklık ölçeklendirmesi aynı görevde oldukça farklı sonuçlar verdi. Sınıf başı izotonik kalibrasyon [6], 77 niyet üzerinde 1.7 nokta doğruluk kaybına yol açtı ve yine de ECE’yi 0.185 seviyesinde bıraktı. 77 ayrı kalibrasyon haritası uydurmak ve yeniden normalize etmek sınıfları yeniden sıralayabilir ve tahminleri değiştirebilir; bu da onu burada yanlış bir araç kılığına soktu. Tek bir sıcaklık [7], ECE’yi 0.031’e indirdi ve hiçbir doğruluk maliyeti getirmedi. Sıcaklık ölçeklendirmesi, modelin logits’larını z, softmax’dan önce öğrenilen tek bir T sayısı bölür:
p_k = exp(z_k / T) / Σ_j exp(z_j / T)
T > 1 dağılımı düzleştirir, T < 1 ise keskinleştirir. Her bir logit aynı pozitif sayıya bölündüğünde en büyük olanın hangisi olduğu değişemeyeceğinden, doğruluk yapı gereği 0.888 olarak kalır. 7 niyetlik dilimde izotonik hiçbir şeye mal olmadı ve ECE’i yarıya indirdi, sıcaklık ise bunu 0.022’ye düşürdü.
Sıcaklık, out-of-fold logits üzerinde negatif loğaritmik olasılığı minimize ederek uydurulur: her eğitim sorgusunun logits’ları, o sorguyu görmemiş bir modelden gelir, böylece temel model tüm veri üzerinde eğitebilir.
python
class
TemperatureScaledLR
def
fit
(self, X, y):
self
._lr
=
LogisticRegression(
max_iter
=
C
=
4.0
).fit(X, y)
self
.classes_
=
self
._lr.classes_
# Out-of-fold logits: T, modelin görmediği veri üzerinde uydurulur.
oof
=
np.zeros((
len
(y),
len
(
self
.classes_)))
for
tri, cai
in
StratifiedKFold(
n_splits
=
shuffle
=
True
random_state
=
).split(X, y):
m
=
LogisticRegression(
max_iter
=
C
=
4.0
).fit(X[tri], y[tri])
oof[cai]
=
m.decision_function(X[cai])
cidx
=
np.where(
self
.classes_[
None
, :]
y[:,
None
])[
]
def
nll
(T):
z
=
oof
/
T
z
=
z
z.max(
axis
=
keepdims
=
True
)
p
=
np.exp(z)
/
np.exp(z).sum(
axis
=
keepdims
=
True
)
return
np.log(p[np.arange(
len
(y)), cidx]
+
1e-12
).mean()
self
.temperature_
=
minimize_scalar(nll,
bounds
=
(
0.05
20.0
),
method
=
“bounded
“).x
return
self
def
predict_proba
(self, X):
z
=
self
._lr.decision_function(X)
/
self
.temperature_
z
=
z
z.max(
axis
=
keepdims
=
True
)
return
np.exp(z)
/
np.exp(z).sum(
axis
=
keepdims
=
True
)
Şekil 1’de, kalibrasyon öncesi ortalama güven çoğu kutuda doğruluktan düşük seyrediyor. Politikanız “0.9 üzerinde karar ver” ise, yalnızca 0.9 değerinin üzerindeki tahminler önem taşıyor; bu yüzden ortalamaya güvenmek yerine doğrudan o kutulara bakmalısınız.
Deney 2: kalibrasyon bir zincirleme işlemi ucuzlatabilir mi?
Karar modelleri için ekonomik yaklaşım bir zincirleme süreçtir. Ucuz model, emin olduğunda harekete geçer; geri kalan işleri ya bir sınır modeline ya da bir insana yönlendirir. Yönlendirme kararı, güven skoruna dayanır; bu yüzden politikanı 77 niyetlik görevin tamamı üzerinde üç farklı arka uçla test ettim: Naive Bayes (ECE 0.54), sıradan lojistik regresyon (ECE 0.25) ve sıcaklık ölçeklendirmeli aynı lojistik regresyon (ECE 0.03). Son iki model özdeş tahminler verir, bu yüzden aralarındaki karşılaştırma neredeyse yalnızca kalibrasyonu sıralamadan izole eder. Sıcaklık ölçeklendirmesi, sorgular arasında en üstteki olasılıkları hafifçe yeniden sıralayabilir; bu durum aşağıdaki aralarındaki küçük açığın nedenini açıklar.
Politika tek bir karşılaştırmadır. En üstteki olasılık bir t eşiğini aşarsa otomatik karar verilir. Aksi halde yönlendirilir. Kapsama, trafiğin ucuz modelin kendi başına karara bağladığı oran olarak tanımlanır. Yönlendirme katmanının %97 doğru olduğunu ve ucuz katmandan 100 kat pahalı olduğunu varsaydım. Her iki sayı da benim seçtiğim varsayımlardır. Ölçtüğüm ise her modelin kendi skorları altında doğruluk, kapsama ve maliyetin nasıl ticarete girdiğidir:
python
FRONTIER_ACC
=
0.97
# yönlendirme katmanının varsayımlı doğruluğu
COST_RATIO
=
100.0
# ucuz katmanla karşılaştırıldığında yönlendirmenin varsayımlı maliyeti
def
cascade_point
(top_p, correct, t):
auto
=
top_p
>=
t
cov
=
auto.mean()
prec
=
correct[auto].mean()
esc
=
1.0
cov
return
{
“coverage”
: cov,
“precision_auto”
: prec,
“overall_acc”
: cov
prec
+
esc
FRONTIER_ACC
“rel_cost”
: cov
1.0
+
esc
COST_RATIO
}
Şekil 2. Tüm arka uçlar için yönlendirilen trafik oranına karşı genel doğruluk. Yönlendirme katmanının %97 doğru olduğu ve 100 kat maliyetli olduğu varsayılır. Görsel yazarın.
Tablo, bir doğruluk hedefi mi yoksa bir eşik mi sabitlediğinize göre farklı okunur.
İlk sütun, otomatik karara verilen sorgular için 95% doğruluk hedefi belirler ve bu hedefe ulaşmak için her modelin ne kadar yükselmesi gerektiğini sorar. Bu çoğunlukla bir sıralama sınamasıdır, çünkü her model kendi eşiğini alır ve aşırı temkinlilik ortadan kaybolur. Düz ve sıcaklık ölçekli lojistik regresyon, birbirine neredeyse eşit sıralamalardan bekleneceği gibi sırasıyla 18.1% ve 14.1% yükselir. Naif Bayes, daha kötü sıralaması nedeniyle 51.7% gerekir. Bu çalışma noktalarını, her ayrı skoru bir kesim noktası olarak denerek tam olarak hesapladım, ancak eşikler test kümesinden gelir. Bunlar keşif sayılarıdır. Üretimde bunları bir doğrulama ayrımında seçersiniz.
İkinci sütun, yapılandırma dosyasına yazacağınız sayı olan 0.90 eşiğini sabitler. Naif Bayes, trafiğin 0.2%’sini 100% doğrulukla otomatik karara verir. Asla yanılmaz ve neredeyse hiç işlem yapmaz, taban maliyetin 99.8 katı kadar. Düz lojistik regresyon, trafiğin 21.1%’ini 99.5% doğrulukla otomatik karara verir. Sıcaklık ölçekli model, trafiğin 78.9%’ini 97.2% doğrulukla otomatik karara verir.
Kalibre edilmiş model için, üzerinde işlem yaptığı sorguların ortalama güveni 0.989’dur ve bu 98.9% doğruluk öngörür. Ölçülen doğruluk 97.2%’dir, dolayısıyla 0.90’ın üzerinde model 1.7 puan aşırı güvenlidir. Sıcaklık ölçekleme ortalamayı düzeltti ve en üstteki hatayı temkinliden hafif iyimere çevirdi, çünkü tek bir küresel sıcaklık aynı anda her kutuyu uyduramaz. Düz lojistik regresyon için aynı hesaplama, 99.5% ölçülen değere karşı 94.9% öngörür. Bu hata güvenli yöndedir ve işte kalibre edilmemiş politikanın güvenli ve temkinli olması, trafiğin yaklaşık beşte birinde işlem yapması sebebi budur.
Kalibre etme, size etiketsiz bir eşik seçmenizi sağlamalıdır. Skorlar dürüstse, üzerinde işlem yapılan sorguların ortalama güveninin 0.95’e ulaştığı eşik size yaklaşık 95% doğruluk vermelidir:
python
def
unlabeled_threshold_for_target
(top_p, target):
“””Üzerinde işlem yapılan öğelerin ortalama güveninin hedefe eşit veya büyük olduğu en küçük t.”””
s
=
np.sort(top_p)[::
]
cummean
=
np.cumsum(s)
/
np.arange(
len
(s)
+
)
ok
=
np.where(cummean
>=
target)[
]
return
float
(s[ok[
)
if
len
(ok)
else
None
Kalıplanmış modelde bu, t ≈ 0.54 sonucunu verir ve ölçülen doğruluk oranı burada %92,4’tür. Etiketli cevap 0.78’di. Modelin yalnızca 0.90’ın üzerindeyken 1.7 puan iyimser göründüğünü düşündüğümden, kısayolun 0.78’e yakın bir noktaya ulaşacağını bekliyordum. Tüm aralıkta kısayolun etki ettiği (0.54 ile 1.0) aralıkta, güven ortalaması doğruluğundan 2.6 puan yüksektir. Sadelik logistic regresyon için kısayol, t ≈ 0.90 verir ve ölçülen doğruluk %99,5’tir; güvenli yönde hedefin 4.5 puan üzerindedir. Orada tam olarak %95 doğruluk sağlayan eşik 0.34’tür ve bunu yalnızca etiketlerle bulabilirsiniz.
İzotonik bu deneyden dışarıda bıraktım. 77 niyet görevinde, kalibrasyonsuz modelin %18,1’ine karşılık, %95’lik doğruluk noktasında %23,5’lik artış gösterdi; böylece sıralamayı kötüleştirmenin yanı sıra doğruluk maliyeti de çıkardı.
Kalibrasyon puanlarıyla sabit bir eşik, etiket olmadan hedef doğruluğa yakın bir noktaya ulaştırır: burada 2.6 puan eksiktir. Sıkı bir doğruluk SLA’si yine etiketli bir doğrulama gerektirir. Bir model kuyruk sisteminde kullanmak için satın alırsanız, kalibrasyonu modelin tek başına ne kadar trafiği yönetebileceğini belirler; işte TypeSafe’in RLCD ile kalibrasyon üzerinde eğitim vermesi için ortaya çıkaran da budur.
Deney 3: arayüzın yazılı tipinin kırıldığı yer
Yazılı tip arayüzün başarısız olmasının iki açık yolu var. Biri, “hiçbiri değil” tuzağı: Bir Choice sorusu, hiçbir seçeneğin uymadığı durumlarda bile bir seçeneği seçmek zorundadır. İkincisi ise çerçeve tutarsızlığı: Aynı soru, bir Choice ve bir Noul olarak iki farklı şekilde sorulduğunda, birbirleriyle uyuşmayan olasılıklar dönebilir. Bunların bir üreticiye mi yoksa paradigma mı ait olduğunu görmek için önce açık modeller üzerinde test ettim.
Hiçbiri değil tuzağı
Zorunlu bir seçim, mesajın hiçbir yere uymadığı durumlarda bile onu bir yere kaydeder. Sağdaki açık yuva, şemanın sahip olmadığı “bunların hiçbiri değil” dalıdır. Resim: yazarın.
7 niyetli sınıflandırıcıya, diğer 70 niyetten örneklenen yaklaşık 600 sorgu sordum; böylece doğru cevap asla seçenekler arasında değildi. İzotonik kalibre edilmiş 7 niyetli modelim bu girdilerdeki güvenini düşürdü (şema dışı ortalama üst olasılık 0.70 şema içi 0.89’a karşı), ancak yeterli kadar değil. 0.90 eşiğinde girdilerin %21.2’sine otomatik olarak tepki verdi. Bu tepkilerin her biri yapı gereği yanlıştı.
Ardından tuzakları sıcaklık ölçeklendirilmiş backend ile yeniden çalıştırdım; bu dağılım bakımından daha iyi kalibre edilmiş (bu dilimde ECE 0.022). Aynı 0.90 eşiğinde hatalı otomatik tepkiler %21.2’den %29.2’ye yükseldi. Notlarıma “tuzak kötüleşti” yazdım. İşletim noktası ise kaymıştı. Şema içi otomatik tepkiler aynı adımda %65.7’den %92.1’e çıktı ve hatalı tepkilerin şema içi tepkilere oranı her iki model için de yaklaşık 0.32 oldu.
Adil karşılaştırma, eşit şema içi kapsama düzeyinde yapılır: Her modelin eşiği, şema içi trafiğin aynı oranına tepki verecek şekilde seçilir, ardından şema dışı tepkiler sayılır.
python
out_act_at_coverage
(p_in, p_out, coverage):
=
(np.quantile(p_in,
coverage))
# threshold giving this coverage
t,
((p_out
>=
t).mean())
# false auto-act rate at that t
for
cov
in
(
0.50
,
0.657
,
0.80
,
0.90
,
0.921
):
t_iso, out_iso
=
out_act_at_coverage(pin_iso, pout_iso, cov)
t_tmp, out_tmp
=
out_act_at_coverage(pin_tmp, pout_tmp, cov)
65.7% şema içi kapsama düzeyinde, sıcaklık ölçeklendirilmiş model şema dışı girdilerin %3.5’ine yanlış olarak tepki verirken, izotonik model bu oran %21.2. Modelin bu noktadaki eşiği 0.9989, izotonik modelinkiyse 0.9004. Bu desen, kontrol ettiğim her kapsama düzeyinde geçerliydi ve şema içi ile şema dışı ortalama güven arasındaki fark 0.19’dan 0.26’ya genişledi. Yani daha keskin model bu iki grubu daha iyi ayırıyor, ancak etiketli veri olmadan seçmeyeceğiniz bir eşikte.
Şekil 3. 7 niyetli modelde şema içi ve şema dışı sorgular için en yüksek olasılık histogramları. Kesik çizgi, 0.90 eylem eşiğidir. Görüntü yazar aittir.
Uygulanan 0.90 eşiğinde, sıcaklık ölçeklendirilmiş model yine de şema dışı girdilerin %29’u üzerinde eylemde bulunuyor.
Şemanın bir çıkış yolu gerekiyor. Yollarından biri, sistemin sistemin sorguyu reddetmesi veya “bunlardan hiçbiri” seçeneğine yönlendirmesi için alt eşiktir:
python
act
=
top_p
>=
eşik
if
act:
branch
=
“ACT”
elif
none_branch:
branch
=
“NONE_OF_THESE”
else
branch
=
“ABSTAIN”
Eşik 0.9989 olduğunda, makalenin başındaki cüzban kaybi mesajı (sıcaklık ölçeklendirilmiş modelde en yüksek olasılık 0.981), bir ücret sorunu olarak kaydedilmek yerine NONE_OF_THESE seçeneğine yönlendiriliyor. Bu eşik etiketli verilerden gelmişti. Diğer çıkış yolu ise Choice sorusunun kendisinde açık bir “bunlardan hiçbiri” seçeneği koymaktır. Bunu ne açık modellerde ne de Jev üzerinde test etmedim.
Çerçeve tutarsızlığı
Jev her soruyu yalnız başına yanıtlar [1], bu nedenle aynı sorunun iki farklı çerçevesinin birbirini onaylamasını sağlayan bir şey yoktur. Aynı niyet hakkında bir Choice ve bir Noul, her ikisi de iyi kalibre edilmiş olsa ve yine de bir eylem eşiğinin iki karşıt tarafına düşse bile.
Açık modellerde bunu yeniden üretmek için, daha sonra Jev üzerinde çalıştığım aynı protokoli kullandım. 7 niyetli dilimdeki 280 sorgunun her biri için Choice çerçevesi, çok sınıflı modelin en yüksek olasılığıdır. Noul çerçevesi ise Choice’un seçtiği niyet için ayrı bir bire-bir-karşılaştırmalı lojistik regresyonun P(true) değeridir. Bunlar, birinin 0.90’ı geçtiği diğerinin geçmediği durumda çelişir.
Bir-e-çok sınıflandırıcılar, çok sınıflı modelden daha temkinli davranır: 0.90’da sorguların %27.5’i üzerinde işlem yaparken, düz yaklaşım %35, sıcaklık ölçekli lojistik regresyon ise %92 oranında harekete geçer. Sıcaklık ölçekleme, Choice çerçevesini keskinleştirir; bu nedenle iki çerçeve, çoğu zaman aynı yanıta ulaşsa bile sabit bir eşik değerinde birbirinden uzaklaşır. Hareket oranlarını eşitlemek (Choice çerçevesinin yaptığı kadar sorguda harekete geçen Noul eşik değerini seçmek) açığın büyük kısmını kapatır. Aynı soruya verilen iki farklı yanıt, ayrı ayrı kalibre edildiğinde iki farklı sayıdır. Bu durum açık modellerde de geçerlidir; dolayısıyla tutarsızlık paradigmanın bir parçasıdır ve yalnızca Jev’e ait değildir.
Bu testin ilk sürümü daha gevşekti: 77 sınıfın tamamı üzerinde tek bir niyet hedefi. Orada her iki çerçeve de neredeyse hiç 0.90’ı geçmediği için neredeyse hiç çışışmadılar (%0.03). Bundan bahsetmemin nedeni, hiçbir şeyin harekete geçmediği bir testin çelişki gösterememesidir.
Deney 4: Gerçek Jev API’si üzerinde aynı testler
Yukarıdakilerin tümü açık modeller üzerinde çalışır. TypeSafe’in temel iddiası, eğitim gerektirmeyen kalibre edilmiş olasılıklar Jev’e aittir; bu yüzden aynı çerçeveyi canlı API üzerinde çalıştırdım. 280 sorguluk banking diliminde her çağrı, bir Choice sorusu ve niyet başına biri olmak üzere yedi Noul sorusu içeriyordu:
INTENTS = {
“card_payment_fee_charged”:
“Müşteri kartıyla ödeme yaptığı için ücretlendirildi ve bu ücret hakkında soru soruyor veya itiraz ediyor.”,
“transaction_charged_twice”:
“Aynı işlem hesap ekristinde iki kez görünüyor; müşteri fazla bir tutar ödedi.”,
# … beş niyet daha
}
questions = {
“intent”: {
“type”: “choice”,
“instructions”: “Bu müşteri hizmetleri mesajını listelenen niyetlerden tam olarak birine sınıflandırın.”,
“criteria”: INTENTS,
}
}
for intent, desc in INTENTS.items():
questions[f”noul_{intent}
}
“
]
=
{
“type”
“noul”
“instructions”
“This customer message matches the following situation: “
+
desc,
}
body
=
{
“model”
“jev-latest”
“state”
: text,
“questions”
: questions}
# POST https://api.typesafe.ai/v1/systemone
The API served jev-1.13.0 for every call. Besides the 280 banking calls, 100 calls ran the out-of-schema trap and 6,160 ran the full 77-intent task twice, once with terse criteria and once with few-shot criteria. That is 6,540 calls in total, for $0.80.
Calibration by question type
Jev’s Choice answers are very well calibrated: accuracy 0.975, ECE 0.014 (95% bootstrap interval 0.008 to 0.031), Brier 0.015 on 280 queries. My temperature-scaled model scored 0.022 on the same queries. A paired bootstrap of the difference, resampling the same queries for both models, gives 0.008 with an interval of −0.004 to 0.020, so I can’t call the two different. Jev is also decisive: 85% of its Choice answers put more than 0.99 on one option.
Jev’s Noul answers are underconfident on true cases. Across the 280 query-intent pairs where the answer is yes, mean P(true) is 0.84, and only 56% of those pairs clear 0.9. On the 1,680 pairs where the answer is no, Noul is close to perfect. The pooled ECE over all 1,960 pairs is 0.071 (interval 0.067 to 0.078, resampling by query), but that number mostly reflects the easy negatives. I didn’t compute the same yes/no calibration for my open models, so I make no open-vs-Jev claim for Noul.
Figure 4. Jev’s Choice reliability diagram on 280 banking queries, 15 bins. Image by author.
Figure 5. Jev’s Noul answers across 1,960 query-intent pairs: underconfident on true cases, close to perfect on false ones. Image by author.
Accuracy on all 77 intents
Aynı zamanda 77 seçenekli 3.080 test sorgusunu Jev ile iki kez çalıştırdım: biri niyet adlarından türetilmiş kısa kriterlerle (“card payment fee charged”) ve biri her niyet için kriter metnine gömülmüş üçer örnek sorguyla. Örnekler, her niyetin TF-IDF merkezine en yakın üç eğitim sorgusuydu, dolayısıyla hiçbirinden test kümesinde yer almadı. Kısa kriterler 0.801 doğruluk ve 0.083 ECE verdi. Üç örnekli kriterler ise 0.859 ve 0.065 verdi.
Aynı görevde sıcaklık ölçekli açık model 0.888 ve 0.031 skor alırken, Jev burada bir kalibrasyon üstünlüğü sunmuyor. Üç örnekli Jev, denetimli lojistik regresyondan yaklaşık 3 nokta doğrulukta geride; kısa Jev ise yaklaşık 9 nokta geride (0.797 ile Sağlıksız Bayes’in önünden ancak sıyrılabiliyor). Denetimli modeller ağırlıkları 10.003 etiketli sorguda eşledi. Jev 77 kısa ifadeyi, ardından açıklama metni olarak 231 örnek sorguyu gördü ve hiçbir eğitim adımı işlemedi. Daha zengin açıklamalar 9 noktanın 6’sını kapattı ve ECE’yi 0.083’ten 0.065’e düşürdü. Daha zengin açıklamaların geride kalanları kapatıp kapatmadığını test etmedim. Jev BANKING77’yi eğitim sırasında gördüyse, bu doğruluklar üst sınır.
Gecikme ve maliyet
Gecikmeyi kendi tarafımda, istek başına gerçek zamanlı süre olarak ölçtüm; 7 niyetli çalışmada aynı anda sekiz istek uçtaydı. Medyan gecikme, içinde sekiz soru bulunan her çağrı için 0.37 saniye ve p95 0.61 saniye oldu. İlk sekiz çağrı her biri yaklaşık 16 saniye aldı ki bu da ısınma olarak görünüyor; ardından o çalışmadaki hiçbir çağrı 0.7 saniyeden uzun sürmedi. 77 seçenekli tek soruluk çağrılar neredeyse aynı medyana (0.36 saniye) sahipti, bu da TypeSafe’in bir istekteki soruların paralel olarak değerlendirildiğine dair iddiasıyla tutarlı [1]. Bu iddiayı doğrudan test etmedim.
İşaretlenen giriş token’larından hesaplanan, 7 niyetli çağrılar (her biri için sekiz soru) bin başına yaklaşık 3,4 sent tutuyor. 77 seçenekli çağrılar, dar kriterlerle bin başına 7,1 sent, üç örnekli kriterlerle ise 18,3 sent tutuyor; çünkü her çağrı çok daha fazla giriş token’ı taşıyor. Tüm 6.540 çağrı bin başına yaklaşık 12 sente denk geliyor. Jev’i Deney 2 zincirinden geçirmedim, bu yüzden gecikme ve fiyatı bir zincirle uyumlu görünüyor ancak zincir eğrisinin nasıl göründüğünü söyleyemem.
Jev’deki iki hata modu
Çerçeve tutarsızlığı yeniden ortaya çıkıyor. Yedi niyetin her biri için “bu hangi niyet?” sorusunu Bir Seçim olarak ve “bu niyet X mi?” sorusunu ise Bir Noul olarak sordum. t = 0,90’da iki çerçeve, 280 sorgunun 111’inde (39,6%) eylem ile çekilme arasında uzlaşıyordu. Her çelişki aynı şekilde işliyordu: Bir Seçim eylem, Bir Noul ise çekilme söylüyordu. Noul doğru vakalarda güvensiz olduğu için t = 0,90’da sorguların yalnızca %56’sında eyleme geçerken, Bir Seçim sorguların %96’sında eyleme geçiyor. Eylem oranlarını eşitlemek (0,44’lük bir Noul eşiği) uzlaşmayı %6,4’e, 280 sorgudan 18’ine, her iki yönde de dokuza düşürüyor. Bu, aynı protokoller altındaki açık modellerimin sonuçlarıyla (2,9% ve 5,0%) aynı aralıkta. Bir çerçevenin sayılarını eşitlediğinizde, diğerinin sayılarını içine karıştırmayın.
Sıfırın üstündeki tuzak da yeniden ortaya çıkıyor. Şemaya dahil olmayan 100 sorguda, Jev’in ortalama en yüksek olasılığı 0,71’di; açık modellerimin 0,70 ve 0,72 değerlerine yakın. t = 0,90’da sorguların %26’sında otomatik olarak eyleme geçti (95% aralık 17% ile 35% arasında) ve yapıları gereği hepsi yanlıştı. Jev, o eşikte şemaya dahil sorguların yaklaşık %96’sında eyleme geçiyor; bu da sıcaklık ölçeklendirilen arka uçun %92,1’ine en yakın değer, bu yüzden birebir karşılaştırma Jev’in %26’sı ile %29,2’si arasında yapılıyor. Örnekler farklı (Jev’in 100 sorgusu test ayrımından, açık modellerimin 600 sorgusu ise diğer niyetlerin eğitim ayrımından geldi) ve aralığı göz önüne aldığında ikisi yaklaşık olarak aynı düzeyde.
Sınırlamalar
-
Her şey, TF-IDF özellikleriyle kısa İngilizce bankacılık sorgularından oluşan tek bir veri seti üzerinde işler. Diğer alanlar, daha uzun girdiler ve daha güçlü açık modeller tüm sayıları değiştirebilir.
-
Açık modeller tek bir çalıştırma ile, sabit tohum değerleriyle elde edildi. Tohumlar veya bölümler arasında varyans ölçmedim. Deney 1’i daha yeni bir scikit-learn sürümüyle yeniden çalıştırmak, 77 niyet sayılarını en fazla 0.005 kadar oynattı; 7 niyet sayıları tam olarak tekrarlanıyor.
-
Jev örnekleri küçük: şema içinde 280, şema dışında 100 sorgu.
-
Deney 2’nin çalışma noktaları, test seti üzerinde seçildi.
-
Skor sorularını, açık bir “bunlardan hiçbiri” seçeneğini ya da Jev’i bir ardışık (cascade) sistemin içinde hiç test etmedim.
-
Jev, BANKING77’yi eğitimde gördüyse, doğruluk sayıları iyimserdir.
-
Buradaki her açık model 10.003 etiketli sorgu ile eğitildi. Jev’in avantajı, hiçbiri gerektirmemesi. Çalıştırmadığım ve en faydalı bir sonraki adımın aday olduğu karşılaştırma, Jev’e karşı bir açık sıfır-örnek veya birkaç-örnek model (doğal dil çıkarımı yapan bir sınıflandırıcı ya da küçük bir açık LLM’nin etiket olasılıkları) ile yapılan karşılaştırmadır.
Sonuç: üretim sistemleri için dersler
-
Kendi iş yükünüzde kalibrasyonu, soru türüne göre ve eşiklerinizin kullandığı kutular üzerinde ölçün. Tahminlerinizi hareket ettiremeyen bir yöntemle kalibre edin. Out-of-fold logit’lerine tek bir sıcaklık uydurma, yapı gereği hiçbir doğruluk kaybetmezken, sınıf başına izotonik kalibrasyon 77 niyetli görevde 1.7 puan kaybettirdi ve modeli yine düşük güvende bıraktı. Jev’de Choice yanıtları, true durumlarında Noul yanıtlarına göre çok daha iyi kalibre edilmişti; dolayısıyla bir boyut Choice sorusu olabiliyorsa onu bir Choice sorusu yapın ve herhangi bir Noul’u kendi etiketlerinizle kontrol edin.
-
Eşiği, arkasındaki skorların neye değdiğini bilene kadar bir politika olarak ele almayın. Aynı 0.90 eşiği, backend’e göre trafiğin %0.2’sini, %21.1’ini ya da %78.9’unu otomatik kararlaştırdı; kalibre edilmiş modelde bile etiketsiz seçilen eşik, doğruluk hedefinin 2.6 puan altına düştü. Eşikleri etiketli veri üzerinde belirleyin ve onları her karar için yanlış olma maliyetine göre ayarlayın.
-
Şemaya bir çıkış yolu verin. Bunu yapmadığınızda, şem dışı sorguların %29’u sıcaklık ölçeklendirilmiş modelim tarafından, %26’sı ise Jev tarafından otomatik işleme alındı. Daha iyi kalibrasyon çalışma noktasını değiştirdi ancak tuzağı kapatmadı, çünkü bir eşiği ayarlamak orada olmayan bir dal ekleyemez.
-
Her soruyu tek bir çerçevelemeyle, bir kez sorun. Aynı sorunun iki farklı çerçevelemesi, açık modellerde ve Jev’de ayrı ayrı kalibre edilir ve paylaşımlı bir eşiklerde sorguların en fazla üçte birinde uyuşmazlık gösterir.
Jev’in katkısı sözleşmedir: tipli sorular girer, kontrol edilebilir olasılıklar çıkar ve ret (abstention) kodunuzun alabileceği bir dal olur. Bu ölçüm setinde, sıcaklık ölçeklendirilmiş lojistik regresyon, 7 niyetli dilimde Jev’in Choice kalibrasyonuyla uyumlu çıktı (ECE 0.022’ye karşı 0.014, ayırt edilemez) ve 77 niyetli görevde onu geçti (0.031’e karşı 0.065). API’nin kattığı şey, buna eğitim olmadan ulaşmaktır: her niyet için prompt içinde en fazla üç etiketli örnek ve çağrı başına yaklaşık bir saniyenin üçte biri.
Tüm açık modellerle yapılan deneyler, scikit-learn kullanılarak 2 CPU’lu bir VM üzerinde çalıştırıldı ve toplam hesaplama süresi dakikalarla ölçüldü. Tohumlar: çapraz doğrulama, bootstrap ve Jev tuzağı örneği için 7; açık tuzağı örneği için 0. Kod, figürler ve ham sonuç JSON’ları https://github.com/ankur287/jev-open-calibration adresinde. BANKING77, PolyAI niyet veri setidir (CC-BY 4.0).
[1] TypeSafe AI, Jev dokümantasyonu (2026), https://docs.typesafe.ai
[2] D. Kahneman, Düşünmek: Yavaş ve Çabuk (2011), Farrar, Straus and Giroux
[3] I. Casanueva, T. Temčinas, D. Gerz, M. Henderson ve I. Vulić, Dual Sentence Encoders ile Verimli Niyet Tespiti (2020), NLP for Conversational AI 2. Çalıştay, ACL 2020
[4] M. P. Naeini, G. F. Cooper ve M. Hauskrecht, Bayesian Binning Kullanarak İyi Kalibre Edilmiş Olasılıklar Elde Etme (2015), AAAI 2015
[5] A. Niculescu-Mizil ve R. Caruana, Denetimli Öğrenme ile İyi Olasılıkların Tahmin Edilmesi (2005), ICML 2005
[6] B. Zadrozny ve C. Elkan, Sınıflandırıcı Skorlarını Doğru Çok Sınıflı Olasılık Tahminlerine Dönüştürme (2002), KDD 2002
[7] C. Guo, G. Pleiss, Y. Sun ve K. Q. Weinberger, Modern Sinir Ağlarının Kalibrasyonu (2017), ICML 2017
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.