

Bilgisayar görüşü dünyasının en yaygın kullanılan algoritmalarından biri olan Scale Invariant Feature Transform (SIFT), görüntüler arasında nesne anahtar noktalarını tespit etme, bu noktalara ait betimleyiciler üretme ve aynı nesneleri farklı görüntülerde eşleştirme amacıyla tasarlanmıştır. Ölçekten ve dönüşten bağımsız yapısıyla öne çıkan algoritma, bir çift görüntüde aynı nesnenin farklı boyutlarda görünmesi durumunda dahi anahtar noktaları başarıyla tespit edebilir; ayrıca döndürülmüş nesnelerin de eşleştirilmesini mümkün kılar.
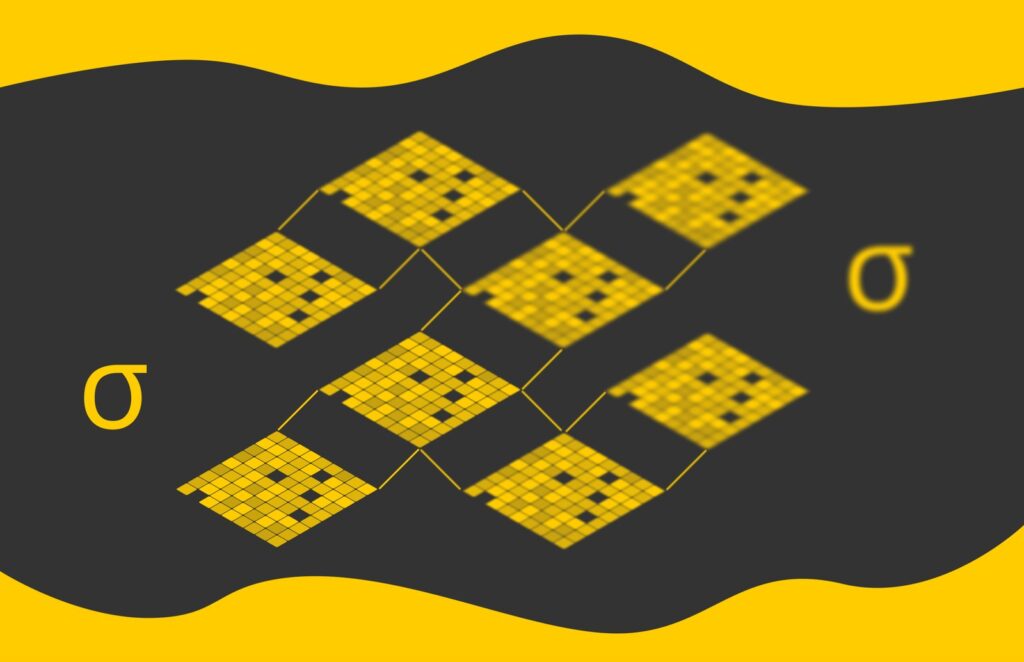
SIFT’in içeride nasıl çalıştığını yakından incelediğimizde, algoritmanın ham görüntüyü birden fazla kopyaya dönüştürerek ilerlediği görülür. Görüntünün ölçek varyasyonlarını yakalamak için uygulanan bu çok katmanlı yaklaşım, hem küçük hem de büyük detayların tespit edilmesini sağlar.
SIFT’in Adım Adım İşleyişi
İşleyişe başlarken, I(x, y) ile gösterilen orijinal görüntü düşünülür. Belirlenen k ve σ1 değerleriyle SIFT, farklı standart sapmalar uygulayarak görüntünün birden fazla sürümünü oluşturur: σ1, k⋅σ1, k2⋅σ1, k3⋅σ1 ve benzeri bir dizi; burada k > 1 koşulundan sağlanır. Bu adımla elde edilen dizide ardışık her görüntü bir öncekinden biraz daha bulanıktır ve bu dizeye oktav (octave) denir.
Ardından SIFT, oluşan görüntüler arasındaki çiftli farkları hesaplar; bunlara Gauss’un Farkı (DoG) adı verilir. Bu farklar yoğunluğu büyük değişim gösteren pikselleri öne çıkarır. Algoritma ardından Di değerlerini üst üste dizer ve içlerinde yerel uç noktaları (local extrema) aramaya başlar.
Bu süreç için her Di(x, y) noktasının 26 komşusu incelenir: Di seviyesinde 8 bitişik nokta, doğrudan üstteki Di+1 seviyesinde 9 nokta ve doğrudan alttaki Di-1 seviyesinde 9 nokta. Bu inceleme sonucunda üç durumdan biri ortaya çıkar: Eğer Di(x, y) tüm 26 komşusundan büyükse SIFT bunu maksimum olarak işaretler; eğer tüm komşularından küçüksen minimum olarak işaretlenir; aksi halde nokta atlanır.
Kavramayı kolaylaştırmak için Di(x, y) ve 26 komşusu, merkezinde Di(x, y) bulunan 3x3x3 boyutlu bir grid olarak hayal edilebilir. Bu yöntem en güçlü özelliklerin belirlenmesini mümkün kılar.
Neden LoG Değil DoG?
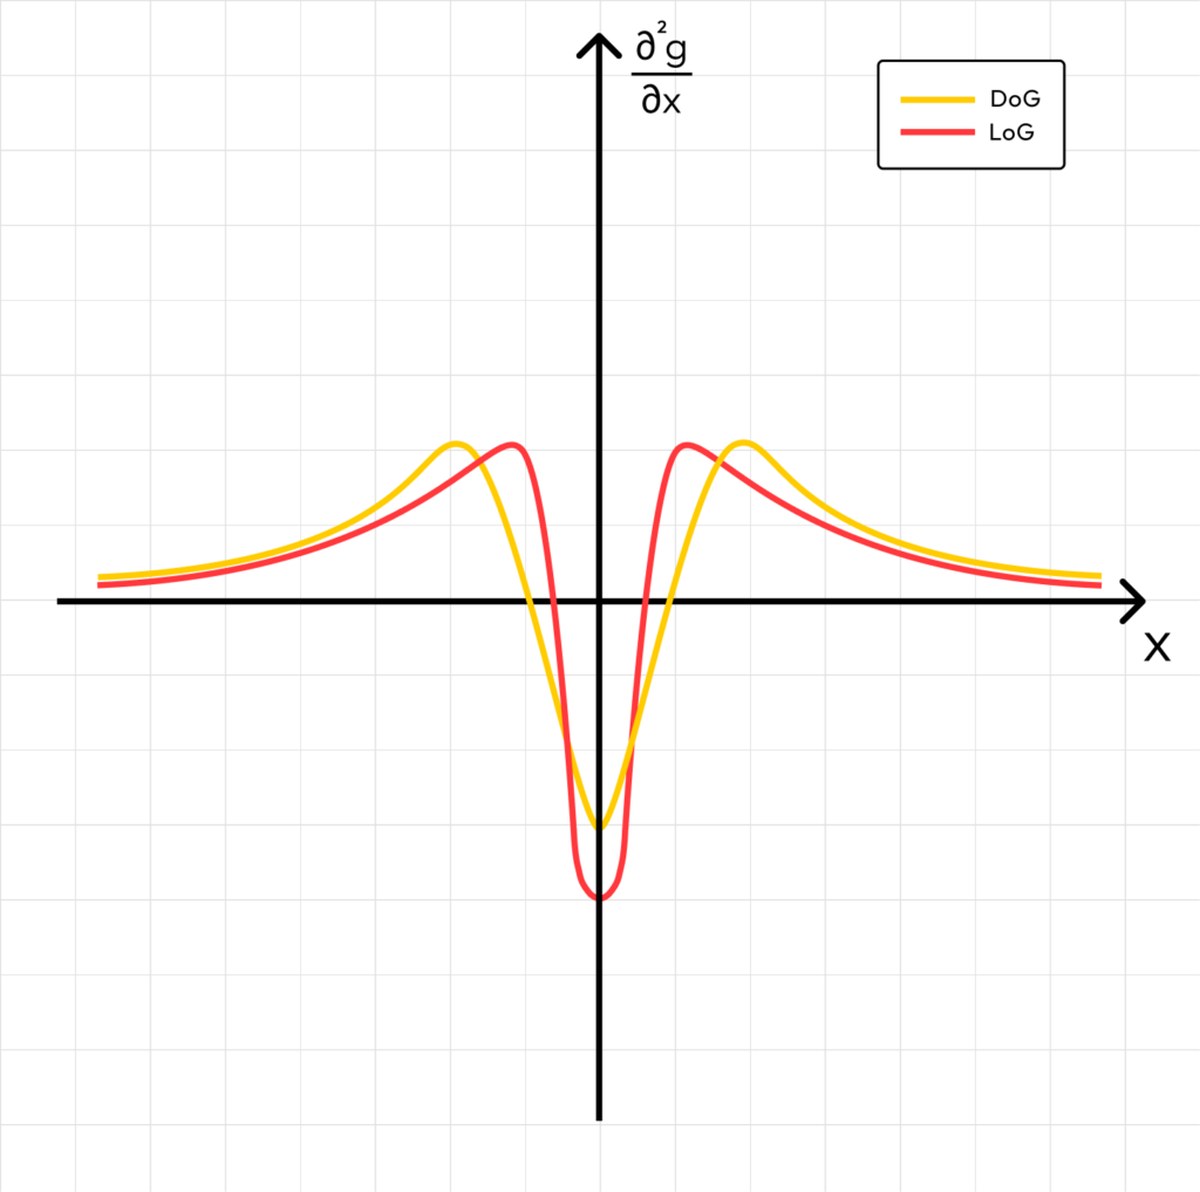
Bu noktada Laplacian of Gaussian (LoG)’nın görüntülerde kenar tespiti için kullanılan bir dönüşüm olduğu hatırlatılır. Aynı anda, aynı görüntüye uygulanan iki ölçekli LoG’nun farkının çok iyi bir yaklaşımla ifade edilebileceği bilinir: DoG = nkσ – nσ ≈ (k – 1)σ2 ⋅ ▽2nσ. Bu formül kullanılarak DoG hesaplamasının, her seferinde orijinal LoG formülünü uygulamaktan çok daha az hesaplama maliyetine sahip olması, algoritmanın verimliliğini artırır.
Neden Tek Oktav Yeterli Değil?
Bir oktav içinde görüntünün bulanıklığı kademeli olarak artar ve ardışık iki DoG arasındaki fark, farklı ölçeklerdeki ilginç noktaları öne çıkarır. Örneğin bir oktavin alt kısmındaki ardışık ağ resimleri arasında oluşturulan DoG, küçük özelliklerin tespitini kolaylaştırırken büyük özellikler için zorlaşır. Bu nedenle algoritma, küçük detayların görünmediği ve daha çok büyük alanlara odaklandığı oktavin üst kısmında bulanık görüntüler için de bir DoG hesaplar.
Birden fazla oktavın kurulum motivasyonu iki unsura dayanır: Bulanıklık arttıkça ince detaylar görünümez, dolayısıyla yüksek bulanıklık seviyelerinde tam çözünürlüğü korumanın verimlilik açısından bir anlamı kalmaz; örnekleme azaltma (downsampling) piksel sayısını dört katına düşürerek işlemi çok daha hızlı kılar. Ayrıca çok büyük Gauss kernellerinin yaklaşımları hataları biriktirebilir, bu yüzden yüksek σ değerlerinden kaçınılmalıdır. Örnekleme azaltmanın ham görüntüye bulanıklık eklemek olarak düşünülebileceği göz önüne alındığında, tam çözünürlüklü görüntüde yüksek bulanıklık seviyesinin, küçük görüntülerde düşük bulanıklık seviyesi kullanmaya yaklaşık eşit olduğu söylenebilir.
Neden Boyutsuz Pencere?
Bir görüntüdeki 3×3 boyutlu pencere yerel uç noktaları tespit edebilir; ancak birden fazla ölçekli sürüm oluşturulduğundan bu çok fazla olabilir. Pencereye üçüncü bir boyut eklemek, tespit edilen ilginç noktaların yalnızca 2D düzlemde değil aynı zamanda farklı ölçeklerde de ayırt edici olmasını sağlar ve böylece görüntünün yakınlaştırılması (zoom) değişimlerine karşı kararlılık kazandırır.
Olası aday noktalar toplandıktan sonra SIFT bunlardan bazılarını eler. Verilen bir noktanın uç nokta olması, yine de gürültü içermiş olabilir; yalnızca en anlamlıları tutmak için SIFT yoğunluk değişimine eşik uygulayarak düşük kontrastlı zayıf adayları temizler.

Betimleyicilerin Üretimi ve Karşılaştırılması
İlgili noktalar seçildikten sonra SIFT, bu özelliklerin farklı görüntülerde eşleştirilmesini sağlayacak betimleyici temsiller üretmeye çalışır. Öncelikle farklı DoG katmanlarında tespit edilen özellikler, varying boyutlu dairelere dönüştürülür; DoG katmanındaki σ değeri ne kadar büyükse daire yarıçapı o kadar büyür. Ardından o dairin içindeki orijinal görüntünün tüm pikselleri için yön gradyanları hesaplanır.
SIFT tespit edilen bölgeyi dört eşit kvadran’a böler ve her kvadran için bir yön gradyanı dağılımı oluşturur. Dört dağılım ardından 128 boyutlu bir vektöre dönüştürülür; bu vektör başlangıçta tespit edilen özellik için betimleyici olarak kullanılır.
SIFT, az sayıda piksele sahip özelliklerle karşılaşma durumlarıyla başa çıkacak sağlam iç mekanizmalar sunar ve komşu piksellerden de bilgi hesaplayarak 128 boyutlu bir vektör betimleyicisi üretmeyi sürdürür. Gerçek dünyada sık karşılaşılan bir durumsa, aynı nesnenin iki görüntüde farklı açılarla döndürülmüş olmasıdır; SIFT dönüşü doğru şekilde hesaba katmak için gradyanın ana yönüne dair ek bilgi kullanır ve bu da rotasyonel bağımsızlığı garanti eder.
Betimleyiciler sayısal olarak karşılaştırılabilen vektörlerdir ve birbirleriyle ne kadar benzer olduklarını belirlemek için kullanılır. En yaygın kullanım durumu, betimleyicisi hesaplanan ilginç noktanın bir çift görüntüde aynı olup olmadığını belirlemektir. Bu karşılaştırmada sıkça L2 mesafesi tercih edilir; L2 mesafesi ne kadar küçükse iki nokta arasındaki eşleşme o kadar iyi olur ve sıfır olması mükemmel bir eşleşmeyi ifade eder.
Kullanım Alanları
SIFT’in en yaygın uygulamalarından biri görüntü eşleştirmesidir. Nesne tespitinde de benzer biçimde, bir nesne şablonu kullanılarak aynı yöntemle görüntü içinde o nesne aranabilir. SIFT’in güçlü yönlerinden biri örtülmelere (occlusions) karşı dayanıklı olmasıdır; bir nesnenin bir parçası başka bir nesneyle kapatılmış olsa dahi görünür özellikleri tespit edip başarıyla eşleştirir.
Nesne eşleşmesi tamamlandıktan sonra, nesnenin konturunu çıkarmak ve görüntüdeki kesin konumunu belirlemek için ek son işleme teknikleri uygulanabilir. Yine de SIFT’in zaman zaman yanlış pozitif eşleşmeler üretebileceği unutulmamalıdır; bu tür durumlar çoğu zaman ciddi bir olumsuz etki yaratmaz ve RANSAC gibi son işleme algoritmaları, sayı fazla değilse yanlış pozitif eşleşmeleri ortadan kaldırabilir.
Görüntü birleştirme (image stitching), tek bir görüş açısından çekilmiş, örtüşen bölgeleri olan fotoğrafları tek yüksek çözünürlüklü bir görüntüye panoramik manzara biçiminde birleştirme görevidir ve özellik eşleştirmesi, perspektif bükülmesi ile geometrik dönüşümlerle zarif çözülebilir. Bu süreçte homografi kavramını anlamak gerekir.
SIFT düz ve 2D nesneler için çok iyi çalışırken, tek başına 3D nesneleri eşlendirmek için uygun değildir; ancak COLMAP gibi diğer 3D yeniden inşaalama algoritmalarının temel adımlarından biri olarak kullanılır. Görüntüler arasında noktaları eşlendirerek tüm 3D sahnenin kurulmasını sağlar.
Bu arada OpenCV, SIFT algoritmasının bir uygulamasını sunar; bir SIFT nesnesi oluşturmak için cv2.create_SIFT() metodu çağrılmalıdır. Belirli parametreler belirtilebilir: nfeatures (tutulacak en iyi özellik sayısı), nOctaveLayers (her oktavdaki katman sayısı, makalede 3 kullanılır), contrastThreshold (düşük kontrastlı bölgelerde zayıf özellikleri elemek için kullanılan kontrast eşiği), edgeThreshold (kenara benzer özellikleri etmek için eşik) ve sigma (ilk oktavda giriş görüntüsüne uygulayan Gauss’un sapması).
SIFT, rotasyonel ve ölçekten bağımsızlığı koruyarak özellik eşleştirme konusunda son derece çok yönlü bir algoritma olarak öne çıkar.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.




Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.