
Google‘ın tensor işleme birimleri (TPU’lar) — kendi özel yapay zekâ çipleri — Google’ın geliştirici blogunda duyurulan yeni PyTorch-native SGLang çıkarım motoru aracılığıyla Meta‘da (yaygın kullanılan PyTorch yapay zekâ çerçevesinin yaratıcısı) üretimde yapay zekâ hizmeti vermeye başladı. Yaygın kullanılan başka bir çıkarım motoru olan vLLM’nin de eşleşen sürümü açık kaynak olarak duyuruldu.
Önceden her iki motor da TPU’larda çalışmak için Google’ın kendi JAX yapay zekâ çerçevesini kullanıyordu. Yeni sürümler, donanımı çoğunlukla yeniden yazım gerektirmeden PyTorch için yerel bir seçenek haline getiriyor.
“SGLang-TorchTPU bugün Meta’da üretimde çalışıyor” dedi Meta’ın PyTorch-TPU sorumlusu Zongwei Zhou ve bunu “Meta, Google ve SGLang ekibi arasındaki yakın üçlü bir işbirliğinin ardından” olarak nitelendirdi. Bu ekip, motoru Google ve Meta ile birlikte kuran SGLang’in yaratıcıları tarafından kurulan RadixArk adlı girişimde çalışıyor. Sözkonusu motor Meta’ya “olağanüstü olgun, PyTorch-native bir hizmet yığını” sağlıyor, dedi.

Meta’da PyTorch mühendisliğinden sorumlu direktör Jana van Greunen, Google’ın TorchTPU gönderisinde Meta’ın “tek bir mimari donanım tarafından kısırlamaması gerektiğini” ve TorchTPU’nun “bize PyTorch yüklerimizi Google TPU’larına dağıtmayı sağladığını” ekledi. Google, TorchTPU’yu Meta’ın PyTorch ekibiyle ortak geliştirdiğini belirtti.
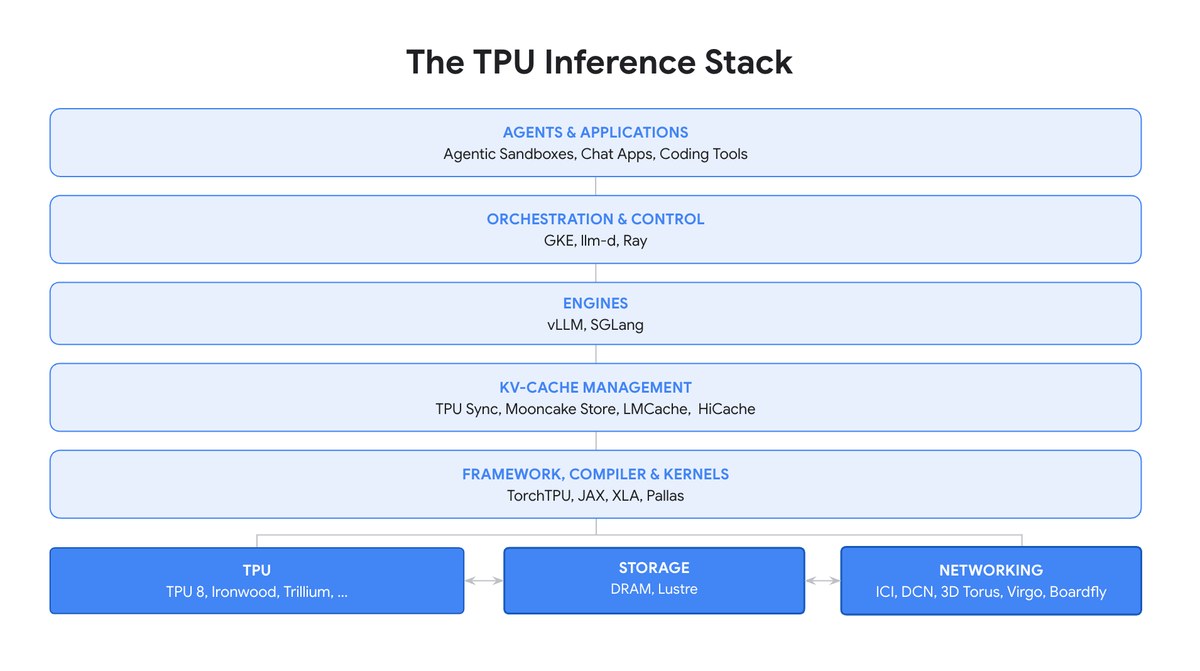
(Görsel kaynağı: Google)
Bu, Meta’nın TPU kullanmaya yönelik ilk girişi değil. Google, PyTorch’dan TPU’lara giden eski köprü olan PyTorch/XLA’yı yeni TorchTPU’nun “öncüsü” olarak adlandırıyor ve SemiAnalysis geçen yıl Meta araştırma ekiplerinin 2020’den 2023’e kadar bu köprü aracılığıyla TPU kullandığını, ardından Meta’nın bu sözleşmeleri feshettiğini bildirmişti. Google’ın PyTorch-on-TPU girişimi çoğunlukla JAX’e geçmek istemeyen Meta’ya yönelikti.
Meta’nın üretim TPU’larının nerede bulunduğu belirsiz olsa da, geçen yılki görüşmelerin 2026 için Google Cloud TPU kiralama ve 2027 için satın alımları içerdiği, ardından Meta’ın çok yıllık bir kiralama sözleşmesi imzaladığı bildirilmişti.
KESİN HABER🚨🚨: BUGÜN META, TPU ÇIKARIMINI ÜRETİMDE ÇALIŞTIRDIĞINI DOĞRULADI. Bu, CUDA hendeksi için ne anlama geliyor?
Kamusal bültenimizi okuyanlar için bu bir sürpriz değil, çünkü 28 Kasım 2025’te Meta’ın bir TPU müşterisi olduğunu ve TPU’larda çalışan çok sayıda mühendis olduğunu kamusal olarak yazmıştık. Hızlandırıcı tedarik zinciri modelimiz Meta’ın TPU satın alımları hakkında ayrıntılar içeriyor!21 Ekim 2026
Duyuru, Amazon’un bir gün ardından, aynı PyTorch Konferansı’nda kendi yerel PyTorch arka uçunu Trainium2 ve Trainium3 çipleri için açık kaynak olarak duyurduğu TorchNeuron’u açıkladı. Her iki hamle de Nvidia’nın yazılım kilidini gevşetmeye yönelik görünüyor.
Performans konusunda, Moonshot AI’nin açık ağırlıklı, 2,8 trilyon parametreli Kimi K3 modelini hizmet veren ayarlanmış bir vLLM kurulumunun, yedinci nesil Ironwood TPU üzerinde tek bir kullanıcı için saniyede 700’den fazla token’a ulaştığı bildirildi. Bu hız rakamı, vLLM’nin yaratıcıları tarafından kurulan ve Google’ın vLLM-TorchTPU yapmasına yardımcı olan Inferact’tan geldi. Testi, vLLM’nin 16 Nvidia GB200 üzerinde yayımlanmış kurulumuyla karşılaştıran, 16 Ironwood çipini küçük bir taslak modelle büyük dil modellerinin çıkarımını hızlandıran bir yöntem olan tahmini kodlama ile çalıştırdı. Kimi K3 ve Qwen 3.8 27B için çekirdekleri, tahkodlama olmadan küçük parti boyutlarında GB200 tabanının veriminin yaklaşık 1,4 ile 2 katına ulaşıyor.
SGLang-TorchTPU, DeepSeek V4.1 Flash ve Reflection Beam ile başlayarak modellere eklemeye devam edecek. Ayrıca RadixArk’a göre, 2027’nin ilk çeyreğine kadar yeni açık modeller için Gün 0 TPU desteği — yani yayın günü desteği — hedefleniyor. Google, Meta ve RadixArk, 12–13 Kasım’da San Francisco’da düzenlenecek SGLang Summit 2026’da daha fazla bilgi paylaşmayı planlıyor.
Son haber, analiz ve incelemeler için , ya da takip edin.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.