
2026’nın neredeyse tamamı boyunca, ardışık haftalar boyunca birkaç düzine yerel LLM ile sayısız deney denedim ve yine de yerel AI’nın bu kadar kısa sürede ne kadar yetkinleştiğinin ancak yüzeyine değinmiş gibi geliyor.
Add
XDA

on Google
Add as Preferred Source
Follow on Google Discover
AI çıkarımı söz konusu olduğunda hem veri gizliliği hem de mali açıdan temkinli olmak nedeniyle yerel-öncelikli yaklaşımın kararlı bir savunucusuyum, ancak bu yaklaşımın temel sınırlamalarından birinin, tek bir modelin derin araştırma, kodlama ve görüntü üretimi konularında en iyisi olmadığı ve bunun yerel modellerin bulut rakipleriyle rekabet etmesini zorlaştırdığı gerçeğini kabul etmeliyim.
Ancak fark ettiğim şey, aslında tek bir model olmak zorunda olmaması. 16GB RTX 4070 Ti Super ve Ryzen 5 7600X ile donatılmış PC’mde, bir görev için en uygun oldukları üç “uzman” modeli döndürerek kullanıyorum. İşte kod yazmak, derin araştırma yapmak ve görüntü üretmek ve düzenlemek için kullandığım modeller ve bulut abonelikleri için 0$ ödeyorum.
BigBang-v1 bir arama motorunu araştırma asistanına dönüştürür
Beş aramadan sonra, aradığım her şeyi buldu
BigBang-v1, her zaman güvenilir olan Qwen3.6-35B-A3B’nin ince ayarlı bir varyantıdır ve Apache 2.0 lisansı altında yayınlanmıştır. Yüzey olarak Qwen3.6 gibi genel amaçlı bir modeldir, ancak hakkındaki en ilginç yönlerden biri, model kartının BrowseComp’de 76.5 değerini bildirmesidir; bu da bir modelin web’de zor bulunan bilgileri ne kadar iyi kazabildiğini test eden bir ölçümdür. Sadece 35 milyar parametresinin 3 milyarını her token için aktive eden Qwen3.6-35B-A3B’ye dayandığı için, RTX 4070 Ti Super’daki okuma hızından daha hızlıdır.
bartowski’nin IQ4_XS nicelleştirmesi ağırlıklarda 19.3GB’dır ki bu, açıkça VRAM kapasitemden fazladır. Sığdırabilmek için modelin uzmanlarını barındıran ve her token için yalnızca birkaçını kullanan sistem RAM’ine modelin yaklaşık 7GB’ını taşımak için –n-cpu-moe bayrağını kullanırım. 128K bağlam penceresi olsa bile, saniyede 68 ile 78 token arasında yazabilir.
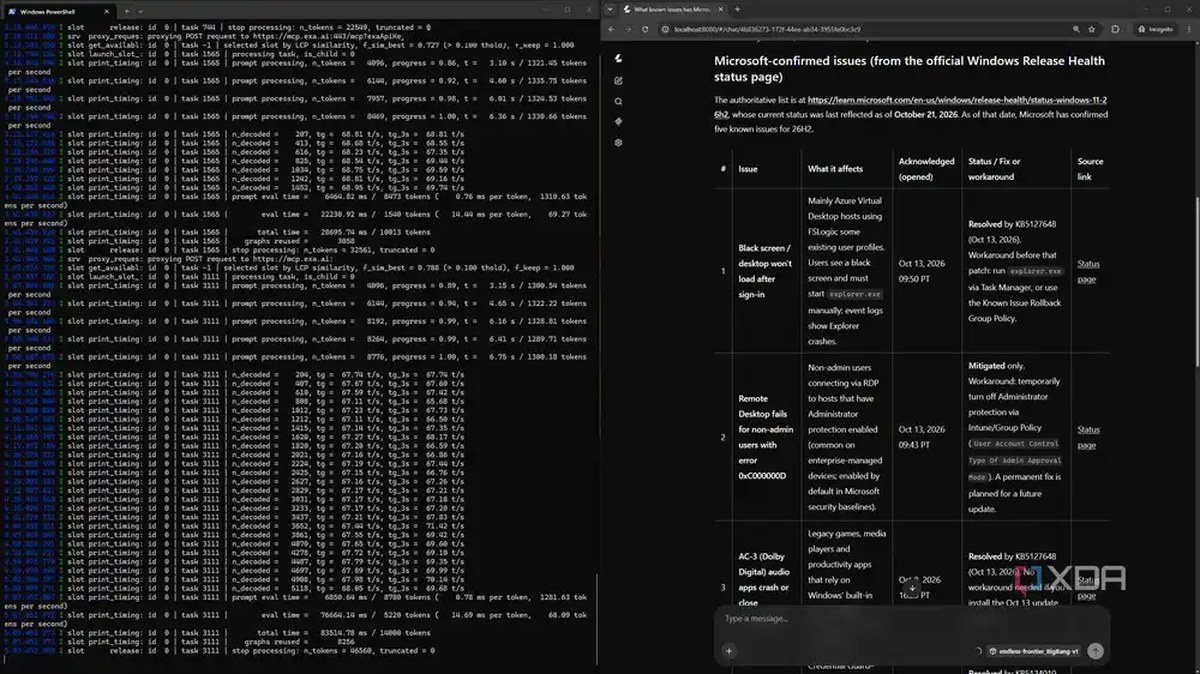
Arama yeteneklerini test etmek için llama.cpp’nin web arayüzünü Exa’nın arama motoruna, ücretsiz bir API anahtarı kullanarak MCP üzerinden bağladım. Ardından, eğitim kesme tarihinden oldukça uzakta olacak kadar güncel olan, Windows 11 26H2’deki en son bilinen sorunlara ilişkin standart bir soru sordum.
Saygı uyandıracak kadar etkileyici bir şekilde, yalnızca beş aramayla, yazdığım anda Microsoft’un onayladığı her sorunu, doğru tarihler ve KB numaralarıyla yakaladı. Microsoft’a geri izleyemediğim bir sorun için bir KB numarası ve bir düzeltme ekledi, bu yüzden hala kaynaklarını kontrol ediyorum; ancak bu, herhangi bir LLM kullanırken standart bir uygulama olmalıdır.
FLUX 3 Image Klein bir promptu bitmiş bir görüntüye dönüştürür
Neyse ki Nano Banana’ın kullanım sınırlarıyla uğraşmak isteyen kim var ki?
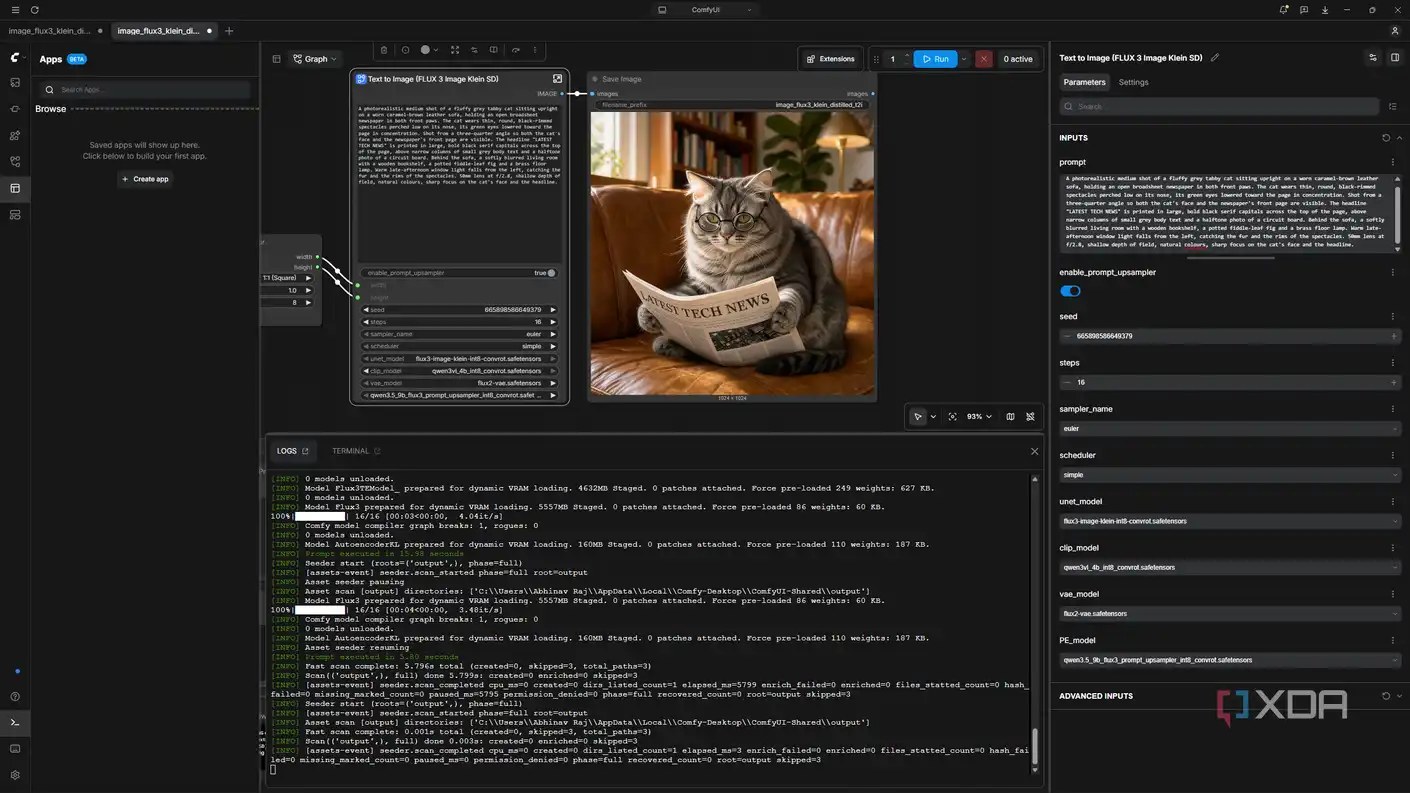
5.6 milyar parametreyle FLUX 3 Image Klein, yerel AI yığınımın en küçük modelidir, ancak her şeyi aynı ağırlıklardan görüntü üretip düzenleterek kullanır. ComfyUI’da görüntü başına yalnızca 16 adım gerektiren sıkıştırılmış sürümü çalıştırırım. Ayrıca Apache 2.0 olmayan üç modelden yalnızca biri. Güzel olan, FLUX Kommunity Lisansının ticari olmayan kullanıma izin vermesi ve bazı koşullarla birlikte yıllık 5 milyon doların altında gelir elde eden herkes için ticari kullanım izni sağlamasıdır.
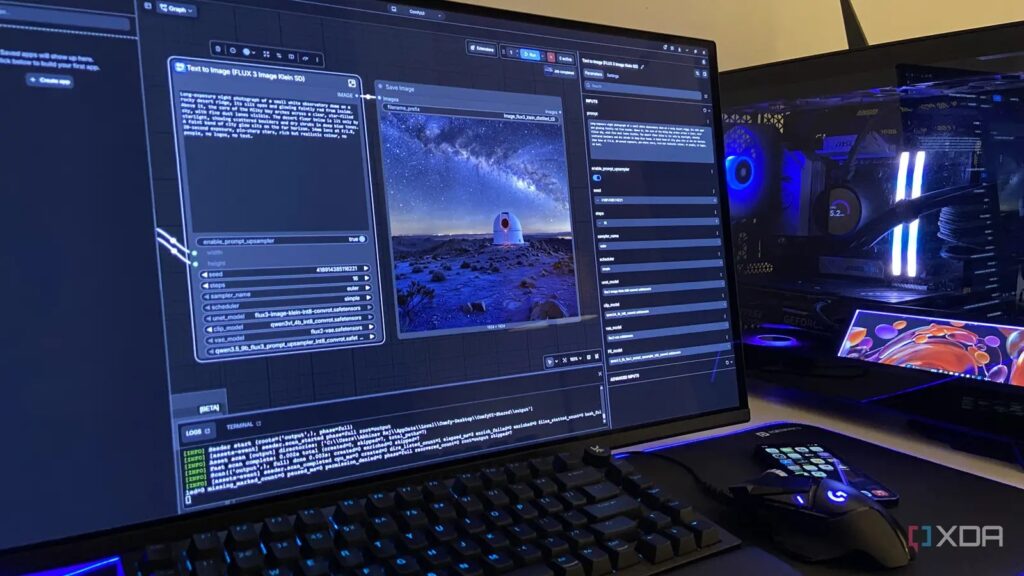
Ancak model tek başına çalışmaz. Sağlanan promptu daha iyi ayrıntılarla yeniden yazmak için bir prompt upsampler olarak görev yapan 9B’lik bir Qwen3.5 modeline ve bu promptu Klein’ın çalışabileceği gömme değerlerine dönüştürmek için bir metin kodlayıcısı olarak görev yapan 4B’lik bir Qwen3-VL modeline ihtiyaç vardır. Üçünün de INT8 yapılarını kullanırım ve ComfyUI, her aşama çalıştığında bunları sırasıyla VRAM’e yükler.
Hız açısından, donanımım üzerinde 1024×1024 boyutunda bir görüntü oluşturmak için neredeyse sıfıra yakın bir bekleme süresi var. Testlerim sırasında beş denemede ortalama yaklaşık 16 saniye aldı. Örnekleme işlemi kendisi yaklaşık 4 saniye sürüyor ve geri kalanın çoğu, kendi genişletilmiş istemini oluşturmak için upsampler’a gidiyor. Tüm bunlar donanımım üzerinde yerel olarak çalıştığı için kullanım sınırları veya filigranlar konusunda endişelenmeye gerek yok ve oluşturmayı kendi kontrolüm altında tutma hissi, kurulumu değer kılıyor. Yine de itaf etmem gerekirse, ComfyUI’nin mevcut hali ilk kez kullananlar için biraz zahmetli bir deneyim sunuyor.
Kodlama için seçimim olan model Qwen3.8-27B
Hızı, daha iyi kod ile değiştiriyor; bu güzel bir takas
Bu noktada, aynı disk üzerinde zaten yer kaplayan fine-tuned bir Qwen3.6-35B-A3B varken, ayrı bir yoğun kodlama modeline sahip olmanın avantajlarını tartışıyor olabilirsiniz. Mantıklı bir soru bu. BigBang-v1’in de kod yazabildiği doğru, ancak Qwen SWE-bench Pro’da BigBang-v1 model kartındaki 54.2’ye karşı 61.7 puan bildiriyor. Her iki puanın da self-reported (kendi kendine bildirilen) olduğunu belirtmek gerekir, ancak ben genellikle Qwen3.8-27B ile daha iyi bir kodlama deneyimi yaşıyorum.
Konuya dair kesin olarak raporlayabileceğim tek takas, hız. Qwen3.8-27B yoğun bir model, yani her token için o 27 milyar parametresinin tamamı çalışırken, BigBang-v1 için yalnızca 3 milyar çalışıyor. Öndeki bir MoE modeli olmadığı için uzmanları devre dışı bırakmak adına kullandığım –n-cpu-moe bayrağı taktiği geçerli değil.
Sınırlı VRAM’imle yapabileceğim tek mantıklı çözüm, dolayısıyla, 14.3GB olan Unsloth’un UD-IQ4_XS quant’ını seçmek; böylece BigBang-v1’in aksine ağırlıklar tam olarak VRAM içinde ikamet edebiliyor. Ancak 32K bağlam penceresi başka bir mesele. Öncesi 14.3GB ağırlığa ek olarak yaklaşık 2GB önbellek gerektirdiği için llama.cpp çalışma zamanı, modelin 64 katmanından 6’sını sistem RAM’ine geri alıyor ve üretim hızı genellikle saniyede yaklaşık 15 ile 17 token arasına düşüyor. Yine de eğlence için yazmasını sağladığım çoğu Pygame projesinde bu neredeyse bir sorun bile olmuyor ve kodun kalitesi, yavaş üretim hızını gerekçelendiriyor.
Tüm modeller ücretsiz ve zamanla daha da iyi hale geliyor
Günlük iş akışımın bir bölümünde bana yardımcı olan her bir model, birlikte RTX 4070 Ti Super’ımı, 1440p için oyun oynamak amacıyla özel olarak satın aldığım bir bileşenin olabileceğini asla hayal etmeyeceğim kadar faydalı kıldı. Yerel AI sahasının aydan aya ne kadar hızlı ilerlediğini düşününce, bir iki hafta içinde bu modelleri daha iyi olanlarla değiştiririm ve aynı GPU, karşılığında herhangi bir abonelik ücreti talep etmeden iş akışım için daha fazlasını yapar; buna şaşmamış olurum.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.