

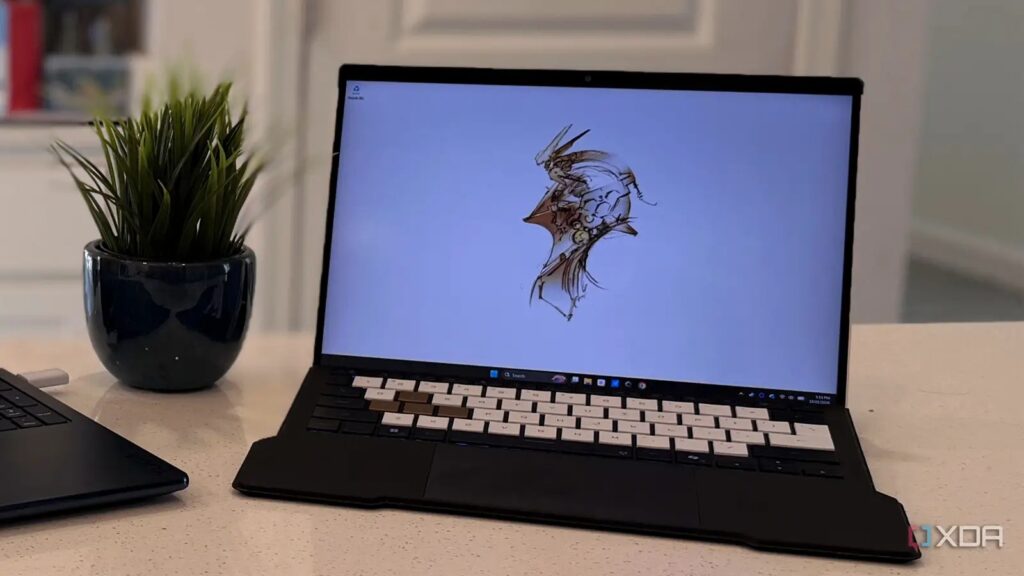
Asus ROG Flow Z13’ümdeki NPU’yu kutudan çıkarıldığı günden beri görmezden geliyorum ve yalnız olmadığımı sanmıyorum. Görev Yöneticisi, yanındaki Radeon 8060S’in benim PC’mdeki aynı LLM‘leri çalıştırması ve en son Copilot+ özelliklerinin bana önemsemem için bir sebep vermemi nedeniyle NPU’nun yüzde 0’da düzleştiğini gösteriyor.
Ekleyin
XDA

Google‘da
Tercihli Kaynak Olarak Ekle
Google Discover’da Takip Et
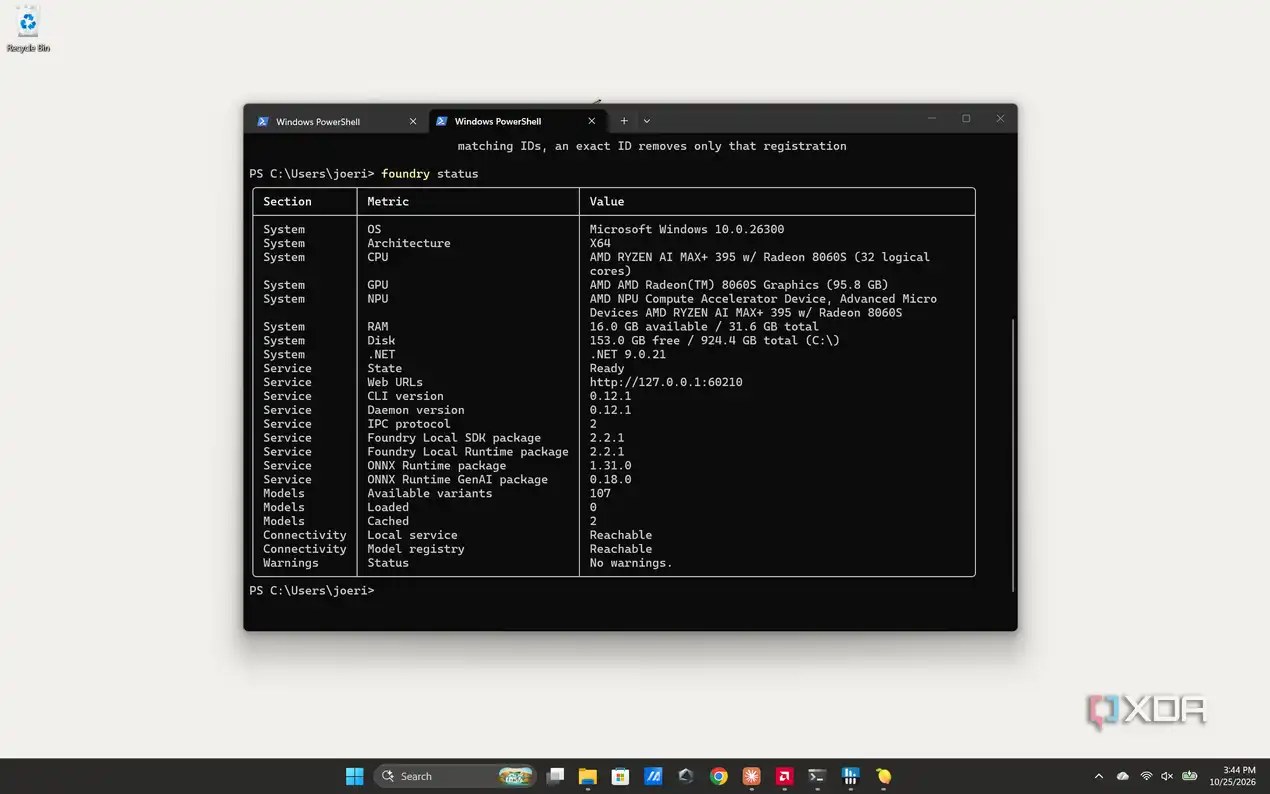
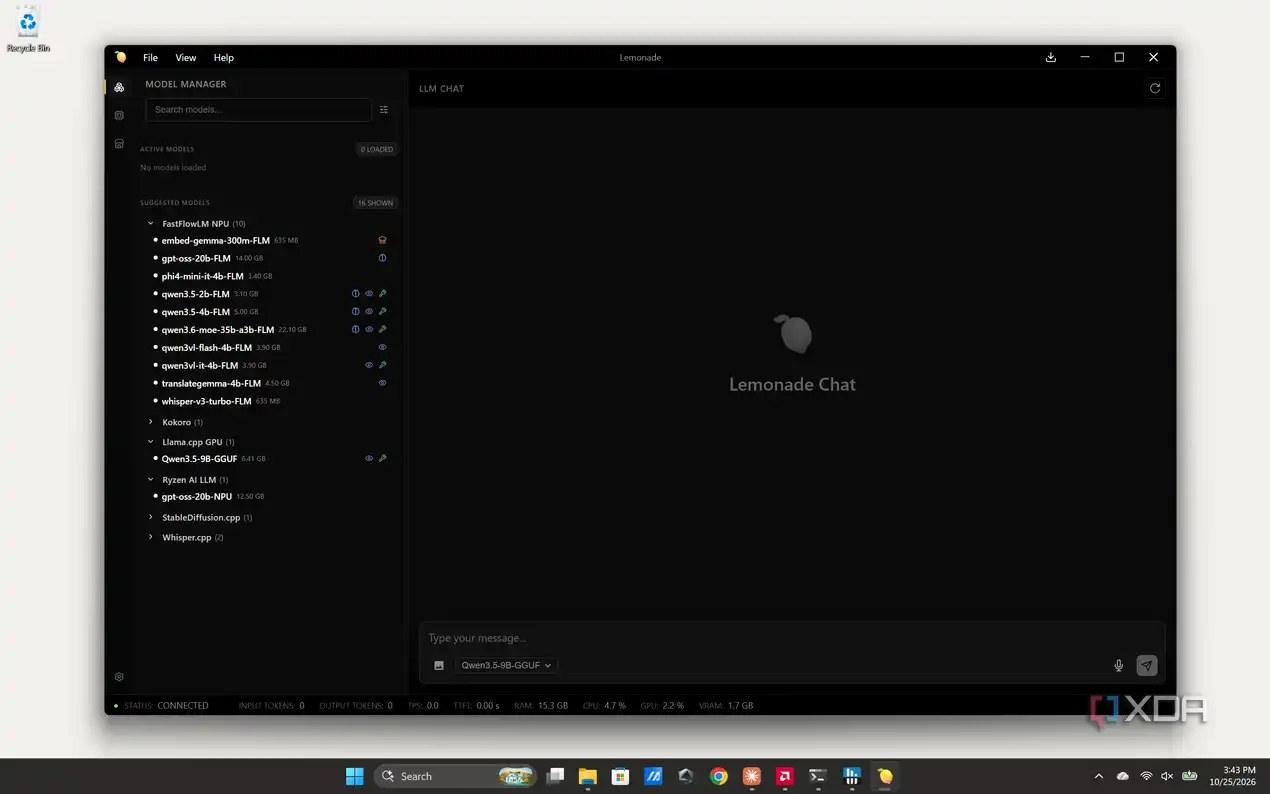
AMD’nin Lemonade’i—artık FastFlowLM’i çalıştırıyor—ve Microsoft’un Foundry Local’ı—bazı modeller için NPU’yu varsayılan olarak seçiyor—sonunda denediğimde bu değişti. Bu yüzden birkaç gün boyunca üzerinde sohbet, transkripsiyon, belge arama ve kod otomatik tamamlama çalıştırdım ve çipin güç ölçerleri yol boyunca kaydı. Çalışıyor. Sadece umduğum gibi değil.
Kendi AI modellerinizi NPU’da artık birkaç dakikada çalıştırabilirsiniz
FastFlowLM, Lemonade ve Foundry Local, Copilot+ olmadan buna ulaşıyor
Ömrünün çoğunda laptopumdaki NPU, Microsoft’un kendi Copilot+ özellikleri dışında pek bir şey yapmıyordu ve AMD yalnız değil, çünkü Nvidia’nın RTX Spark’ının da neredeyse hiç bahsetmediği bir NPU’su var. FastFlowLM bunu değiştiriyor: dil, konuşma ve gömme modelleri için NPU-öncelikli bir çalışma zamanı ve artık AMD’nin kendi ROCm projesinin altında yer alıyor. Lemonade içinde, llama.cpp’nin yanı sıra bir backend daha olarak görünüyor, AMD’nin ryzenai-llm çalışma zamanı ve whisper.cpp’nin NPU sürümüyle birlikte.
Microsoft’un Foundry Local’ı aynı alanı diğer taraftan kapsıyor. Z13’ümde, üç kod-ayarlı Qwen modeli dahil olmak üzere modellerinin 11’inin NPU’da çalışmasını varsayılan olarak ayarladı. Yalnızca Lemonade, 40’dan fazla FastFlowLM modelini listeliyor ve bu araçlardan birini çalıştırmak birkaç komut aldı.
Kurulum, tek bir test bile çalıştırmadan önce hala benimle uğraştı
Elbette “birkaç komut” gerçeklikle karşılaştığında ayakta kalamadı. Lemonade’in gpt-oss-20b’nin MXFP4 sürümü için katalog girişi, 12,1 GB’lık modelden 1,6 GB’ı iki kez indirdi ve ardından her iki llama.cpp arka ucunda da yüklenmeyi reddetti. Q4_K_M sürümü 11 GB’ın tamamını indirmeyi tamamladı, ancak başka bir sürecin dosyayı hâlâ açık tutması nedeniyle dosyayı yeniden adlandıramadı ve ikinci bir çekme işlemi bunu düzeltti.
Sonra Lemonade’in ROCm arka ucu, o modeli hiçbir şey söylemeden CPU üzerinde çalıştırdı. GPU’nun güç çekimi düz kaldığı için modeli yalnızca günlüklerde yakaladım. llama.cpp’yi Vulkan’a geçirmek işi Radeon 8060S üzerine aldı; bu, kurulumu kendiniz yapıyorsanız bilmek değer.
Yerel bir modelle sohbet için NPU son sırayı aldı
iGPU, beşten fazla kez daha hızlıydı ve yarıdan iyi altında enerji kullandı
gpt-oss-20b’yi Lemonade’in kendi dahili ölçümünü kullanarak, pil üzerinde çalıştırdım ve Windows’un Enerji Ölçer sayaçlarından güç kaydettim; bunlar CPU, GPU ve NPU’yu ayrı ayrı raporlar. Ardından boşta çalışma sırasında yapılan çekimi çıkardım ve her kurulumun 1.000 oluşturulan token başına kaç joule yaktığını hesapladım.
Vulkan üzerinden llama.cpp çalışan Radeon 8060S, second başına 53,8 token üretti ve 1.000 token başında yaklaşık 460 joule kullandı. NPU üzerinde FastFlowLM 9,5 token/second ortalamasına ulaştı ve en iyi koşusu yaklaşık 1.200 joule kullanırken, daha yavaş koşuları güç günlüğündeki bir boşluğa denk geldi. AMD’nin kendi ryzenai-llm çalışma zamanı 8,8 token/second’ı 1.700 joule’da yönetti.
CPU bile onu geride bıraktı; o ROCm yedeklemesi 990 joule’da 23,6 token/second’a ulaştı. iGPU da yanıtlamaya 0,44 saniyede başladı, FastFlowLM’in 4,1 saniyesine karşılık; ve sohbet penceresinde gerçekten hissettiğiniz boşluk işte budur.
NPU’nun küçük güç çekiminin onu verimli kılmamasının nedeni
Güç okumaları enerjinin nereye gittiğini gösteriyor. FastFlowLM altında 1W’ın, ryzenai-llm altında ise 2.4W’ın altına düşen NPU’nun kendisi, ancak tüm üretim süresince 14W ile 15W arasında bir artış sağladı. Garip olan, bu ekstra gücün çoğunun CPU, GPU veya NPU hatlarında hiç görünmemesi. iGPU’nun çekimi boşta çalışmaya göre yaklaşık 25W daha fazlaydı, ancak beş kez daha erken bitirdiği için token başına enerji tüketimi çok daha düşük çıktı.
Bu yüzden, tüm çalışma süresince chip’in geri kalanı beslemeye devam ederken, NPU’nun kendi güç hattındaki küçük sayı pek bir şey söylemez. Görev Yöneticisi’nin de bunları size anlatmasını beklemeyin. NPU’yu açıkça meşgul olsa bile %0 olarak, saniyede 54 token üretirken GPU’yu ise %19 olarak gösterdi.
Bu iki NPU çalışma zamanı arasında net bir kazanan yok. FastFlowLM’nin hızı 8.1 ile 11.8 token/saniye arasında salındı, ryzenai-llm ise 8.8’de sabit kaldı ve FastFlowLM’nin en iyi koşusu %30’a kadar daha az enerji harcadı.
Transkripsiyon, NPU’nun yerini hak ettiği tek iş
FastFlowLM Whisper’i NPU üzerinde tuttu ve CPU ile GPU’yu boş bıraktı
Sohbet, bir NPU için doğru test değil; kodlama da öyle. Tablet’i bu iş için kullandığım usual iş akışı bu olsa da, NPU beş dakikalık bir sesli mesajı transkribe etme görevini üstlenebilir. Aynı klibi FastFlowLM’nin Whisper modeliyle ve whisper.cpp’nin NPU sürümüyle çalıştırdım ve her ikisi için de gücü kaydettim.
Whisper.cpp kağıt üzerinde kazandı: 33.6 saniyede (gerçek zamanın 8.9 katı daha hızlı) yaklaşık 450 joule için tamamladı. Ancak güç izi bunu ortaya çıkarıyor. NPU ve CPU sırayla devraldı, CPU’nun 5W ile 8W arasında çalıştığı sürelerin arasında kısa NPU patlamaları oluştu.
FastFlowLM 78 saniye aldı, gerçek zamanın 3.8 katı daha hızlıydı ve tüm çalışma süresince NPU üzerinde kaldı. Tüm chip yalnızca 8.7W ekledi, CPU neredeyse hareket etmedi ve GPU boşta kaldı. Toplamda yaklaşık %50 daha fazla enerji kullanıyor, ancak daha düşük bir çekimle; ve işte NPU’nun varoluş amacı da bu: GPU’nuza oyun oynarken, render alırken veya daha büyük bir model çalıştırırken zamanı olabilecek bir şey.
Arama ve otomatik tamamlama, son derece tuhaf biçimlerde yanılttı
NPU gömme modeli, LED arızasını rosta sebze tarifinden ayıramadı
Belge aramasının kolay bir başarı olacağı düşünülüyordu; bu yüzden FastFlowLM’nin gömme modelini AMD Ryzen AI Halo’nun 40 sayfalık kullanım kılavuzuna yönlendirdim ve yavaş yavaş yanıp sönen mavi LED’in ne anlama geldiğini sordum. Model, şikayet etmeden NPU üzerinde çalıştı ve SSH ayarları hakkında sayfaları özgüvenle getirdi. En iyi dört eşleşme 0.93 ile 0.94 arasında puan aldı ve hiçbirinde LED’den bahsedilmedi.
Yanıp sönen LED hakkında sorulduğunda, model Windows aktivasyon anahtarıyla ilgili bir cümleyi en iyi eşleşme olarak derecelendirdi; rosta sebze tarifi ise yalnızca 0.06 geride kaldı. Küçük bir llama.cpp gömme modeli aynı cümleleri doğru sırayla derecelendirdi. Testlerimde, FastFlowLM’nin sürümü bir örnekteki ilk cümle için aynı cümle tek başına gönderildiğinde döndürülen farklı sonucu da döndürdü.
Düzeltme, aramaya eski usul anahtar kelime derecelendirmesi eklemek oldu. Bu bulgun ardından, NPU üzerinde çalışan qwen3.5-4b, her iki test sorusunu da altı saniyeden kısa sürede, alıntılarla doğru yanıtladı.
NPU’m sonunda bir iş buldu, ama bu küçük bir iş
Z13’ümde NPU, sohbet testinde iGPU’ya kaybetti. CPU’ya da kaybetti. İyi yaptığı şey, CPU ve GPU’nun daha önemli bir şey yaparken, siz daha kirli bir metne katlanabildiğiniz sürece, bir toplantının metnine dönüştürme gibi şu an ihtiyaç duymadığınız bir işi düşük güç tüketimiyle çalıştırmak.
Pürüzlü yanları düzeltilebilir görünüyor ve FastFlowLM’nin gömme modelleri ile Foundry Local’ın tamamlamaları yetişene kadar yeniden test edeceğim. Bir Ryzen AI dizüstü bilgisayarınız varsa ve çok fazla toplantı kaydediyorsanız, FastFlowLM’nin Whisper’i bugün denemeye değer.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.