

Zaten bu sorunun cevabını biliyorsunuz.
Bir yarışma programındasınız. Üç kapı var. Birinin arkasında bir araba, diğer iki kapının arkasında ise keçi var. 1 numaralı kapıyı seçiyorsunuz. Arabanın nerede olduğunu bilen sunucu 3 numaralı kapıyı açıp size bir keçi gösteriyor. Sonra şunu soruyor: 2 numaralı kapıya geçmek ister misiniz?
Evet. Geçmek üçte iki kez kazandırır. Marilyn vos Savant bu cevabı 1990’da Parade dergisinde yayımladığında, binlerce okuyucu ona yanlış olduğunu söylemek için yazdı ve bunların çoğu matematikçi idi [1][2]. Yanlış olan o değildi.

Bugün kimse tartışmıyor, yapay zeka modelleri de yapmıyor. Birine sorun, “geç” diyorlar.
Ben de bir kuralı değiştirdim. Ya sunucu arabanın nerede olduğunu bilmiyorsa ve sadece tesadüfen bir keçi kapısını açıyorsa? Ya hep zaten araba seçtiğinizde bir değişim öneriyorsa? Aynı kapılar, aynı keçiler, aynı soru. İkinci versiyonda, her seferinde geçmek kaybediyor.
Beş yapay zeka modeline bulmacanın altı farklı versiyonunda ne yapılması gerektiğini sordum. Neredeyse hepsinde “geç” dediler. Arayarak kazanmanın imkânsız olduğu versiyon dahil.
Beni rahatsız eden yanlış olmaları değildi. Ne kadar emin konuştukları ve kendi mantık yürütmelerini okuduğumda nasıl göründüğüydü. Bir durumda bir model sunucunun kuralını bana doğru şekilde tekrarladı ve ardından onu görmezden geldi.
Bunu nasıl test ettiğim ve bulmacanın her versiyonunu açıklayan tek matematik parçası işte burada.
Mesele sunucunun o kapıyı neden açmasında
Sıradan açıklama şöyle. İlk seçiminizin doğru olma olasılığı her zaman 1/3’tür. Sunucunun bir kapı açması bunu değiştirmez. Dolayısıyla diğer kapının doğru olma olasılığı 2/3 olmak zorundadır. Güzel bir argüman ve çalışıyor, ama biraz da tesadüfen çalışıyor. Bu konuda yazı yazmış istatistikçi Jeffrey Rosenthal buna “sarsık” çözüm diyor, çünkü bulmacanın küçük varyasyonlarında çöküyor [1].
Asıl soru şu: Bu ne kadar dayanıklı? Sunucunun az önce ne yaptığı verildiğinde, araba kapı 1’in ardındaysa sunucunun bunu yapma olasılığı ne kadarardı? Kapı 2’nin ardındaysa? Kapı 3’ün ardındaysa? Rosenthal buna Orantılılık İlkesi [1] diyor. Bir şeyin gerçekleştiğini gördükten sonra, her olası sonucun yeni olasılığı, o sonucun kendi altında gerçekleşme olasılığıyla doğru orantılıdır. Dağınıklıktan arındırılmış Bayes kuralıdır.
P
(
araba kapı
c
‘nın ardındaysa ∣
sunucunun yaptığı
)
∝
P
(
sunucunun yaptığı
∣
araba kapı
c
‘nın ardındaysa
)
P(\text{car behind } c \mid \text{what the host did}) \;\propto\; P(\text{what the host did} \mid \text{car behind } c)
P
(
araba kapı
c
‘nın ardındaysa ∣
sunucunun yaptığı
)
∝
P
(
sunucunun yaptığı
∣
araba kapı
c
‘nın ardındaysa
)
Klasik sürümü yapalım. Kapı 1’i seçtiniz ve sunucu kapı 3’ü açıyor. Araba kapı 1’in ardındaysa, sunucunun seçebileceği iki keçi kapısı vardı, dolayısıyla kapı 3’ü zamanın yarısında açardı. Kapı 2’nin ardındaysa, seçeneği yoktu, dolayısıyla her kapı 3’ü açardı. Kapı 3’ün ardındaysa, onu hiç açamazdı, dolay sıfır. Bu da 1/2, 1 ve 0 ağırlıklarını verir. Bunları topladıklarında 1 olacak şekilde ölçeklendirirseniz 1/3, 2/3 ve 0 alırsınız. Ünlü cevap budur ve tamamen sunucunun davranışından gelir, kapıların hiçbir özelliğinden değil.
Bu da cevabın sunucuyu değiştirerek değiştirilebileceği anlamına gelir. Aynı iki adım, farklı bir olasılık sütunu:
Fall ve Crawl Rosenthal’in [1] önerileridir. “Cehennemden Monty”, yalnızca araba zaten sizin seçtiğinizde değişimi teklif eden bir sunucudur. Sessiz sunucu benim kendi eklemem: hiçbir şey açmayan ve sadece değişimi isteyip istemediğinizi soran bir sunucudur. Son iki sütuna bakın. Değiştirmek her zaman kazanmaktan asla kazanmamaya dönüyor ve tek bir kapı bile hareket etmedi. Yalnızca sunucunun kuralı değişti.
Tüm hesaplama, buraya yapıştırılmaya yetecek kadar küçüktür. Aşağıdaki her şey için bunu temel gerçek (ground truth) olarak kullandım ve ayrıca her cevabı varyant başına 300.000 oyun simüle ederek kontrol ettim. Eşleşiyorlar.
python
from fractions import Fraction as F
from itertools import combinations
def knowing_host(N, k):
“””Host knows where the car is and opens k goat doors (never door 1).”””
def policy(c): # c = door hiding the car
goats = [d for d in range(2, N + 1) if d != c]
combos = list(combinations(goats, k))
return {frozenset(s): F(1, len(combos)) for s in combos}
return policy
def posterior(policy, N, seen):
“””P(car behind each door | we saw the host do seen).”””
w = {c: F(1, N) * policy(c).get(seen, F(0)) for c in range(1, N + 1)}
total = sum(w.values())
return {c: w[c] / total for c in w}
print(posterior(knowing_host(3, 1), 3, frozenset({3})))
# {1: Fraction(1, 3), 2: Fraction(2, 3), 3: Fraction(0, 1)}
Modelleri nasıl sordum
Qwen2.5’in talimatla ince ayara alınmış (instruction-tuned) sürümlerini dört farklı boyutta kullandım: 0,5B, 1,5B, 3B ve 7B (7B sürümü 4-bit olarak yüklenmiş) [3]; ayrıca farklı bir aileden gelen 3,8B’lik Phi-3.5-mini’yi de dahil ettim, böylece sonucun bir Qwen yanlılığına indirgenmesinin önüne geçilirdi [4]. Altı hikâyenin her birinde oyunu anlattım ve sunucunun kuralını düz sözlerle açıkladım; ardından seçilecek üç ifade sundum: değiştirmek daha iyi, aynı kalmak daha iyi ya da fark etmiyor.
Modellerin bir cevap yazmasına izin vermedim. Doğrudan cevap harflerine (A, B veya C) atadıkları olasılıklara baktım. Modellerin sevdiği harfler olma eğilimi taşıdığı için her soruyu altı olası sıralamanın hepsinde sordum ve sonuçları her ifadenin anlamına göre ortalamaya döndürdüm. Bu sayede “her zaman A’yı seçme” etkisi ortadan kalkıyor.
Unutmayın diye bir sayı: Bu altı hikâyede, her seferinde “değiştir” diyen bir model iki doğru dört yanlış yapıyor. Bu da %33.
Ne dediler
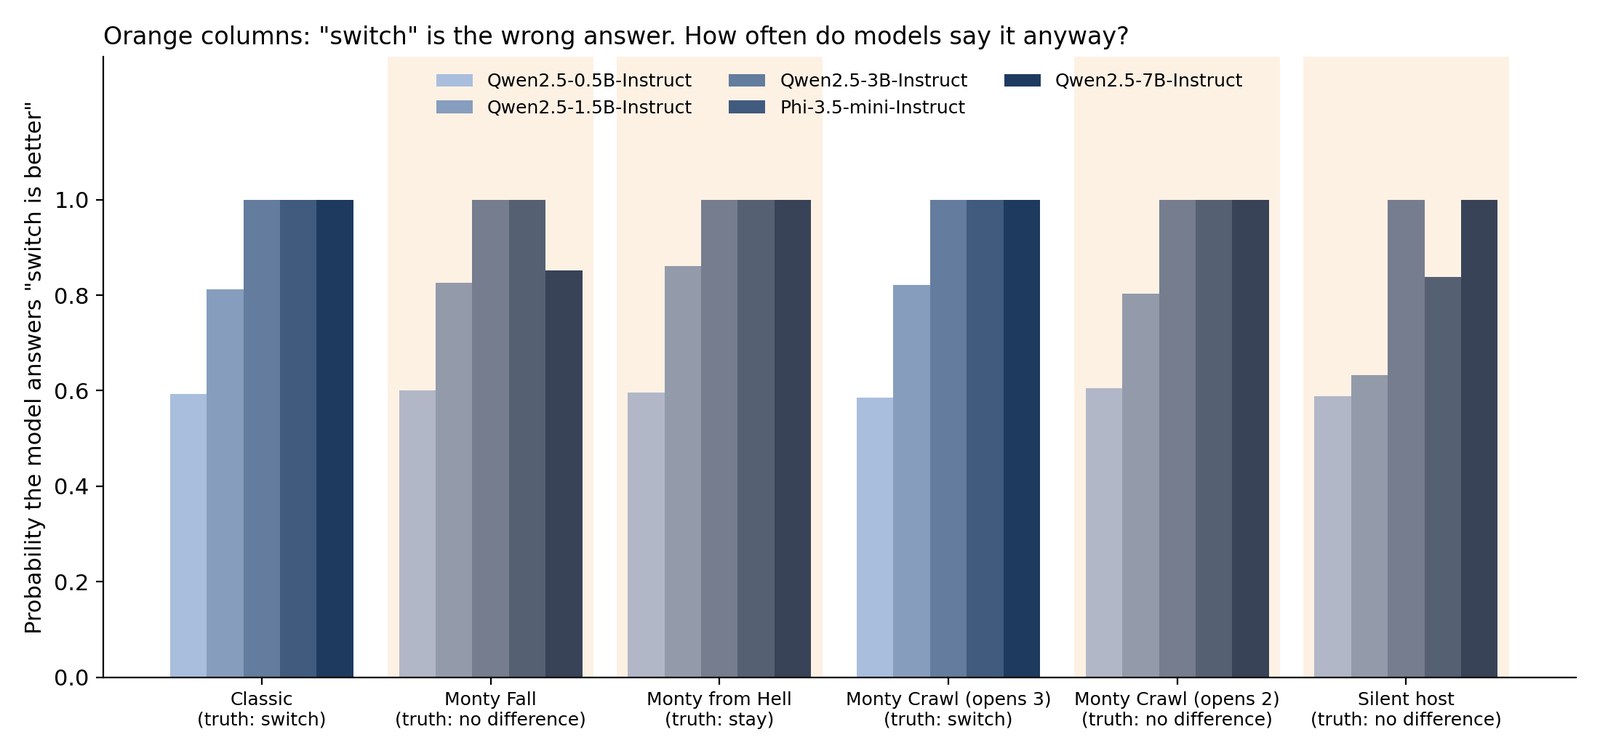
Her modelin her varyant için “değiştirmek daha iyi” cevabını verme olasılığı. Turuncu sütunlar, değiştirmenin doğru cevap olmadığı varyantlardır. Resim yazar aittir
Klasik bulmacada “değiştirmek daha iyi” olasılığı 0.5B için %59, 1.5B için %81 ve diğer üçü için temelde %100’dü. Tamam, bu doğru cevap. Aynı zamanda bir modelin bunu ezberlemişten çıkaracağınız cevabın aynısı bu.
Durum zorlaşan yer diğer varyantlarda. “Değiştirmek”in yanlış olduğu dört varyantta (Monty Fall, Monty from Hell, Crawl opening door 2 ve sessiz sunucu) modelllerin doğru ifadeye verdiği ortalık olasılık 0.5B için %13, 1.5B için %4.5, 3B için %0.0, Phi için %0.4 ve 7B için %3.7’di. Rastgele tahmin %33 alır. Yani daha büyük olmak, farkına varmada daha iyi olmak anlamına gelmiyordu. Daha büyük olmak, hiçbir şeyin değişmediğine dair daha emin olmak anlamına geliyordu.
İlk tepkim kendi koduma güvensizlikti
Gözümün önündeki neredeyse %100’lük duvar bana yanlış geldi. Modeller genellikle herhangi bir konuda bu kadar tutarlı değildir, bu yüzden biraz kendi sonucumu bozmaya çalıştım.
Düzenek bozulmuş muydu? Aynı A/B/C formatında altı önemsiz soru ekledim (hangi numara daha büyük, anahtarlar nereye gitti, işte böyle şeyler). 7B ve Phi hepsini doğru bildi, 3B %91, 1.5B ise %85 aldı. 0.5B ancak %52’ye ulaştı, bu da rastgele tahminden pek fazla iyi değil, bu yüzden onun sayılarına fazla anlam yüklemem. 3B’yi ayrıca tam 32-bit hassasiyetinde yeniden çalıştırdım, 16-bit yuvarlamanın tuhaf bir şey yapıyor olabileceği şüphesiyle. Aynı cevaplar.
Sonra cümle kurma. “Değiştirmek daha mı iyi?” yerine “hangi kapı arabayı gizleme olasılığı daha yüksek?” diye sorduğumda, 1.5B’nin klasik bulmacadaki “değiştirmek” cevabı %81’den %38’e düştü. Yani küçük modellerin yaptığı şeylerin bir kısmı sadece sözcüklere tepki vermek. 3B ise umursamadı ve yaklaşık %100’de kaldı.
Aynı zamanda bir gerçeği kendilerine verildiğinde onu kullanıp kullanamadıklarını da öğrenmek istedim. Bir kontrolde, dürüst bir sunucu size arabanın 1 numaralı kapının arkasında, kendi kapınızın arkasında olduğunu fısıldar ve ardından bir takası sunar. Cevap açıkça kalmaktır. 3B yine de %100 civarında “değiştirmek” dedi. Phi bunu zamanın %67’sinde söyledi. 7B ise “değiştirmek”i ancak %3.5 verdi, gerisini “kalmak” (%48) ile “fark yok” (%49) arasında böldü. Yani 7B, ona bir gerçek verildiğinde onu kullanabilir; bu da diğer hatalarını daha ilginç kılıyor.
İkinci bir kez yeniden ifade edilen sorulara dönelim. “Hangi kapının daha olası olduğu” biçimindeki ifadyle 7B, Monty Fall için “eşit olası”ya %74, sessiz sunucu için %66 verdi. İkisi de doğru. Ancak yine de cehennem sunucusu için %99,8 ve Crawl için kapı 2’yi açarken %100 oranında kendisine sunulyan kapıyı seçti. Kanıtın sunucunun kuralı olduğu durumlar bunlar. “Sunucu bana faydalı bir şey söylemedi” onu bir şekilde halledebilir. “Sunucunun davranışı ipucu” ise hayır.
Oyun şousu kurulumunun sorun olduğunu düşünüyordum
Girerken yaptığım tahmin, tam Monty Hall kurulumunun, kapılar ve keçiler ve bir sunucu ile ezberlenen cevabı tetiklediği yönündeydi. Bu yüzden kontrollerin düz ikizlerini yazdım: üç kutunun birinde bir ödül ve ya nerede olduğu hakkında size gerçeği söyleyen ya da hiçbir fikri olmayan bir arkadaş. Aynı bilgiler, oyun şousu yok.
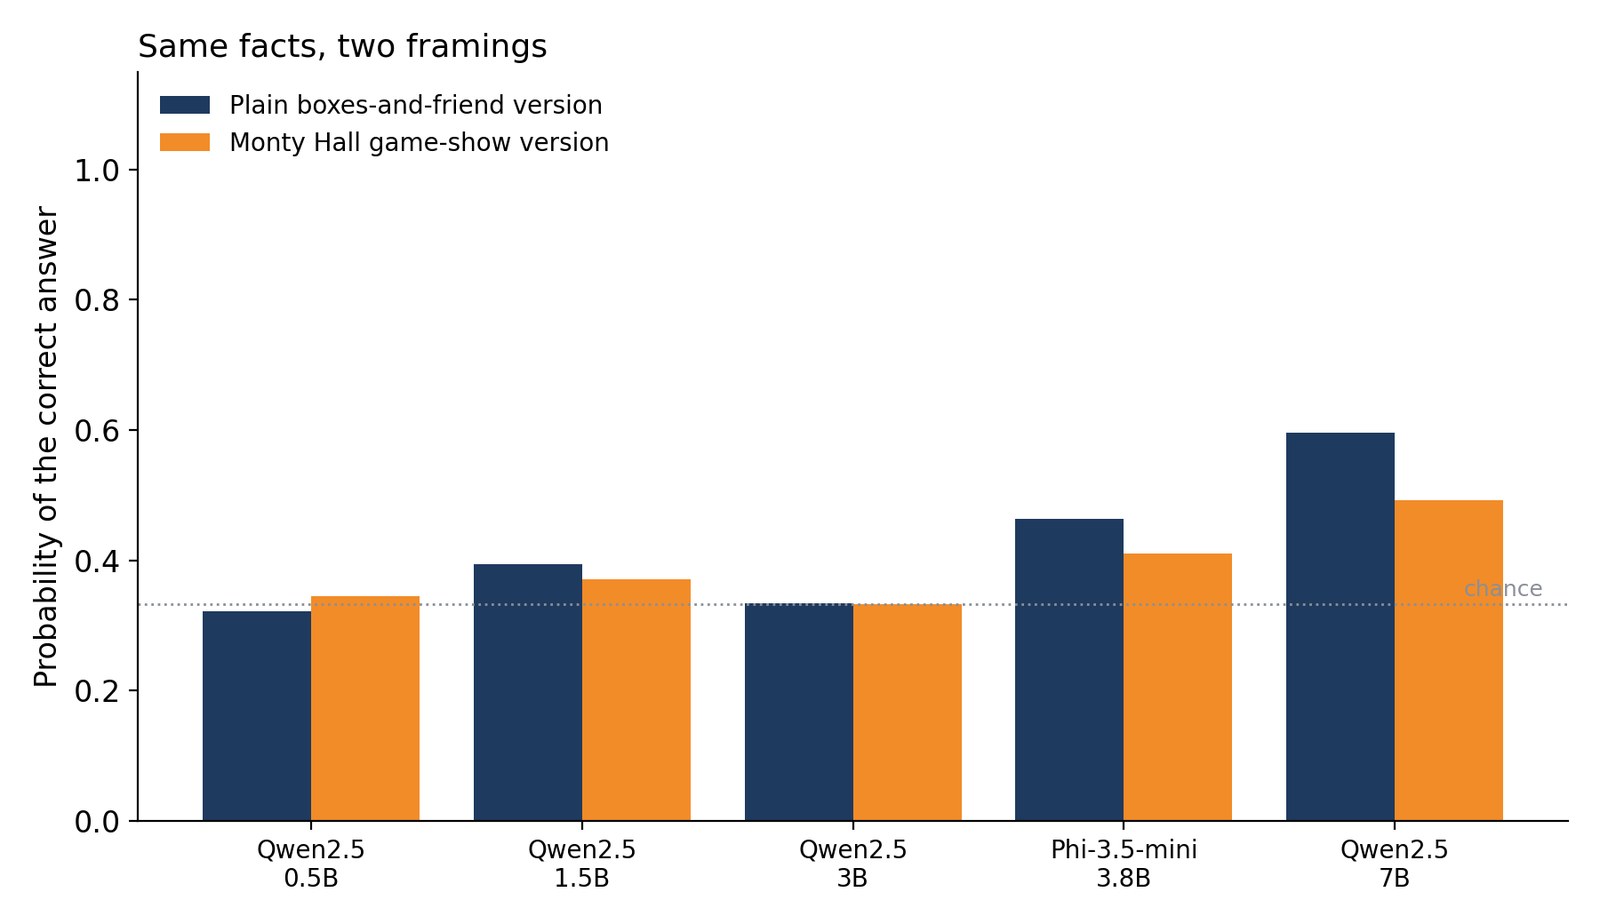
Monty Hall kurulumu ile ve olmadan, üç eşleşen çiftte doğru cevabın olasılığı. Görüntü yazarın.
Neredeyse hiçbir fark etmedi. 3B her iki sürümde de %33 puan aldı. Phi %41’den %46’ya çıktı. 7B %49’dan %60’a çıktı ki bu bir şey ama pek çok şey değil. Arkadaş ödülün 1. kutuda olduğunu söylese bile, 3B’nin %99,9 oranında “2. kutuya geç” deme oranıydı.
Yani sorun kapılar ve keçiler değil. Durumun biçimi: üç seçenek, birini seçersin, biri sana bir değişim sunar. Düz sürümümün de bu biçimi var, o yüzden çekimin nerede durduğunu söyleyemem. Sadece kostümü çıkarmanın yeterli olmadığını söyleyebilirim.
Düşünmelerine izin vermek
Adil itiraz: Hiç kimse bir olasılık bulmacasını tek anda çözmez. Bu yüzden sohbet modellerinin önce muhakemelerini yazmalarına izin verdim (her hikaye için beş örnekleme zinciri, tanesi 600 anahtar sözcüğe kadar, model başına 55 zincir) ve son cevabı sondan okudum.
Yarar sağlamadı. Altı temel varyant üzerindeki 30 zincir boyunca modeller, 0.5B için %80, 1.5B için %97, 3B için %100, Phi için %100 ve 7B için %97 oranında “geç” ile sonuçlandı. Doğruluk %33, %30, %33, %33 ve %37 olarak ortaya çıktı. Yani bu, her zaman “geç” demenin size kazandırdığı şeydir.
Bu zincirlerin çoğunu okuyorum ve deneyin tamamındaki en iyi kısım onlar. “Cehennem’den Monty” hikâyesinde sunucu yalnızca arabayı seçtiğinizde değişimi teklif ediyor. Bir 7B zinciri bu kuralı doğru biçimde ifade ediyor (keçi seçtiyseniz “sunucu değişimi teklif etmeyecek”) ve birkaç satır sonra, “başlangıçta bir keçi seçtiyseniz, ki bu daha olasıdır,” diye düşünerek değişimin daha iyi olduğuna karar veriyor. Öncül de kanıt da vardı ve öncüye yön verdi. Hiçbir yerde sunucunun bu teklifi her durumda yapma olasılığını sormuyor; oysa yukarıdaki tablonun asıl konusu tam da bu.
“Monty Düşmesi” hikâyesinde sunucu arabanın nerede olduğunu açıkça bilmiyor. Bir 3B zinciri “Sunucu arabanın nerede olduğunu bildiğinden” diye başlıyor ki bu klasik bulmaca, size verilen değil. Soruyu sessizce hatırladığı versiyona dönüştürmüş. Düz kutu sürümünde ise bir 7B zinciri 2. kutunun, dostunuzun işaret ettiği gibi ödül gerçekten 1. kutudaysa “0 olasılığını koruduğunu” söylüyor ve ardından 2. kutuya “değiştir” cevabını veriyor.
Açıklayamadığım bir şey de bu. Dostunun ödülün 1. kutuda olduğunu söylediği kutu hikâyesinde, 7B’nin anlık cevabı %69 oranında “kaldır” yönündeydi. Muhasebesini yazdıktan sonra beş zincirin de “değiştir” dediği görülüyor. İstemler biraz farklı cümlelerle yazılmış ve zincirler örneklenmiş, bu yüzden düşüncenin onu daha da kötüleştirdiğine kanıt demek doğru olmaz. Yine de umduğum şeyin tam tersi.
Döndürme kolu değil, değiştirme
Son bir test daha, çünkü buradaki matematik oldukça güzel. 10 kapı ve k keçi kapısını bilerek açan bir sunucu ile, belirli bir kalan kapıya değiştirme olasılığı (N−1)/(N(N−1−k)) olurken, değiştirmeden kalma olasılığı 1/N’dir.
P
(
değiştirerek kazanma
)
=
N
−
1
N
(
N
−
1
−
k
)
P
(
değiştirmeden kazanma
)
=
1
N
P(\text{win by switching}) = \frac{N-1}{N\,(N-1-k)}, \qquad P(\text{win by staying}) = \frac{1}{N}
P
(
değiştirerek kazanma
)
=
N
(
N
−
−
k
)
N
−
P
(
kayda kalma ile kazanma
)
=
N
k = 0’da sunucu hiçbir şeyi açmaz ve iki seçenek berabere biter. k = 8’e gelindiğinde ise değiştirme, dokuz kat daha avantajlıdır.
Sunucu daha çok kapı açtıkça “değiştir”in modeldeki güveni; değiştirme gerçekte ne kadar avantajlıysa onunla karşılaştırılmış. Görsel: yazarın kendi çalışması
7B modeli k = 0’ı doğru buldu: %51 değiştirme, temelde bir omuz silkme. Sonra k = 1’de %99’a fırladı ve bundan sonra her daha büyük k için %84 ile %96 arasında kaldı; değiştirme ne kadar açıkça doğru olsa da asla yükselmedi. 3B ve Phi ise sunucu hiçbir şeyi açmadığında bile “değiştir”i %99,9 veya daha fazla güvenle söyledi. Matematiği takip eden bir model, her kapı açıldıkça daha da emin olurdu. Bunlar bir düğme gibi davrandı, bir kolum değil.
Sunacağım ve sunmayacağım iddialar
Küçük bir çalışma bu. Modeller 0,5B ile 7B arasında çalışıyor, biri nicetlenmiş, dördü aynı aileden ve ben yalnızca kısa yanıtlara ve kısa örnek zincirlerine baktım. Altı hikâye, birkaç kontrol, hikâye başına beş zincir. Bulmacayı yeniden düzenleyen zincir sayıları, metni okumadan ve basit bir desen aramadan geliyor; bunları oran değil örnek olarak değerlendirin. Hiçbir öndeki (frontier) modeli test etmedim.
Büyüklerini inelen bir benchmark var. Yirmi beş klasik bulmacayı aldı, 149 değiştirilmiş sürüm hazırladı ve on öndeki modeli test etti, kapalı olanlar dahil. Aynı türden bir hatayı raporluyor: artık ona uymayan bir bulmaca için ezberlenen çözümü güvenle verme [5]. Benim gördüğüme uyuyor ama bunu büyük modellerde tekrar üretmediğim için bunu iddia etmeyeceğim.
Sunacağım şey daha dar. Bu modeller için ünlü bir bulmacayı doğru çözmek muhakemeye zayı kanıttır, çünkü aynı cevap bulmaca değişse de değişmese de ortaya çıkar. Bildiğim en ucuz test, doğru cevabın tersine döneceği bir kuralı değiştirmek ve cevabın onunla birlikte dönüp dönmediğini görmektir.
Sonraki sefer bir model ünlü bir bulmacayı doğru çözdüğünde, etkilenmeden önce ben bir kuralı değiştireceğim.
[1] Jeffrey S. Rosenthal, Monty Hall, Monty Fall, Monty Crawl (2008), Math Horizons, Eylül 2008, ss. 5-7
[2] Marilyn vos Savant, Ask Marilyn (1990), Parade Dergisi, 9 Eylül 1990, s. 22
[3] Qwen Ekibi (An Yang ve ark.), Qwen2.5 Teknik Raporu (2024), arXiv:2412.15115
[4] Marah Abdin ve ark., Phi-3 Teknik Raporu: Telefonunuzda Yerel Olarak Çalışan Yüksek Yetenekli Bir Dil Modeli (2024), arXiv:2404.14219
[5] Souradeep Mukhopadhyay, Rishabh Baral, Nimeesh Mahajan, Samhitha Harish, Aswin RRV, Mihir Parmar, Mutsumi Nakamura, Chitta Baral, Phantom Recall: Tanıdık Bulmacalar Akıllı Modelleri Nasıl Aldatır (2025), arXiv:2510.11812
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.