

Kuantum Bilişim
Coherent Quantum Long Short-Term Memory Mimarisi CoQS-LSTM’i Tanıtıyoruz
Lorenz çekicisi, doğrusal olmayan dinamik bir sistemin kaotik evrimini gösteriyor. Yazar tarafından Python ve Matplotlib kullanılarak oluşturuldu.

Lorenz çekicisinin renkli bir görselleştirmesi, kaotik dinamikleri ve doğrusal olmayan zaman dizisi davranışlarını gösteriyor. Python ve Matplotlib kullanılarak oluşturulan bu görselleştirme, kuantum makine öğrenmesi ve zaman dizisi tahmini için CoQS-LSTM mimarisi üzerine bir incelemeyi eşlik ediyor.
Geleceği tahmin etmek her zaman bizleri büyülemiştir. Yarının hava durumunu öngörmekten mahsul verimini ya da elektrik tüketimini tahmin etmeye kadar, pek çok tahminimiz geçmiş gözlemlerde örüntüleri belirlemeye dayanır. Farklılıklarına rağmen, bu sorunlar tek bir önemli özelliği paylaşır: zaman. Sonraki adım çoğu zaman önce ne olduğuna bağlıdır.
Makine öğrenmesinde, böyle sorunlar genellikle zaman dizisi tahmini üzerinden incelenir; modeller geçmiş gözlemlerden oluşan dizilerden öğrenerek gelecekteki sonuçları tahmin eder.
Bu makalede, makine öğrenmesi modellerinin zamansal örüntülerden nasıl öğrendiğini, zaman dizisi tahmini için öne çıkan mimarilerden biri olan Kısa Süreli Uzun Süreli Bellek (LSTM) ağlarından başlayarak inceleyeceğiz. Oradan kuantum makine öğrenmesinin yapı taşlarına geçecek, bunların klasik yinelenen mimarilere nasıl entegre edilebileceğini inceleyecek ve nihayetinde zaman dizisi tahmini için tutarlı bir kuantum yaklaşımına ulaşacağız; bu yaklaşım benim süregelen araştırmamın bir parçasını oluşturuyor. Son olarak yeteneklerini, sınırlarını ve geleceğe yönelik olası araştırma yönlerini inceleyeceğiz.
Zaman Dizisi Tahmini ve LSTM’ler
Makine öğrenmesi ve veri biliminde, zaman içinde kaydedilen veya zamanla dizilen gözlemlerden oluşan veriye yaygın olarak zaman serisi verisi denir. Basit bir ifadeyle bir zaman serisi, bir veya birden fazla değişkenin zaman içinde nasıl değiştiğini betimler. Birçok gerçek dünya sisteminde bu gözlemler zamansal bağımlılıklar gösterir; geçmiş kalıplar, günümüz ve gelecekteki davranışlar hakkında faydalı bilgiler sağlayabilir.
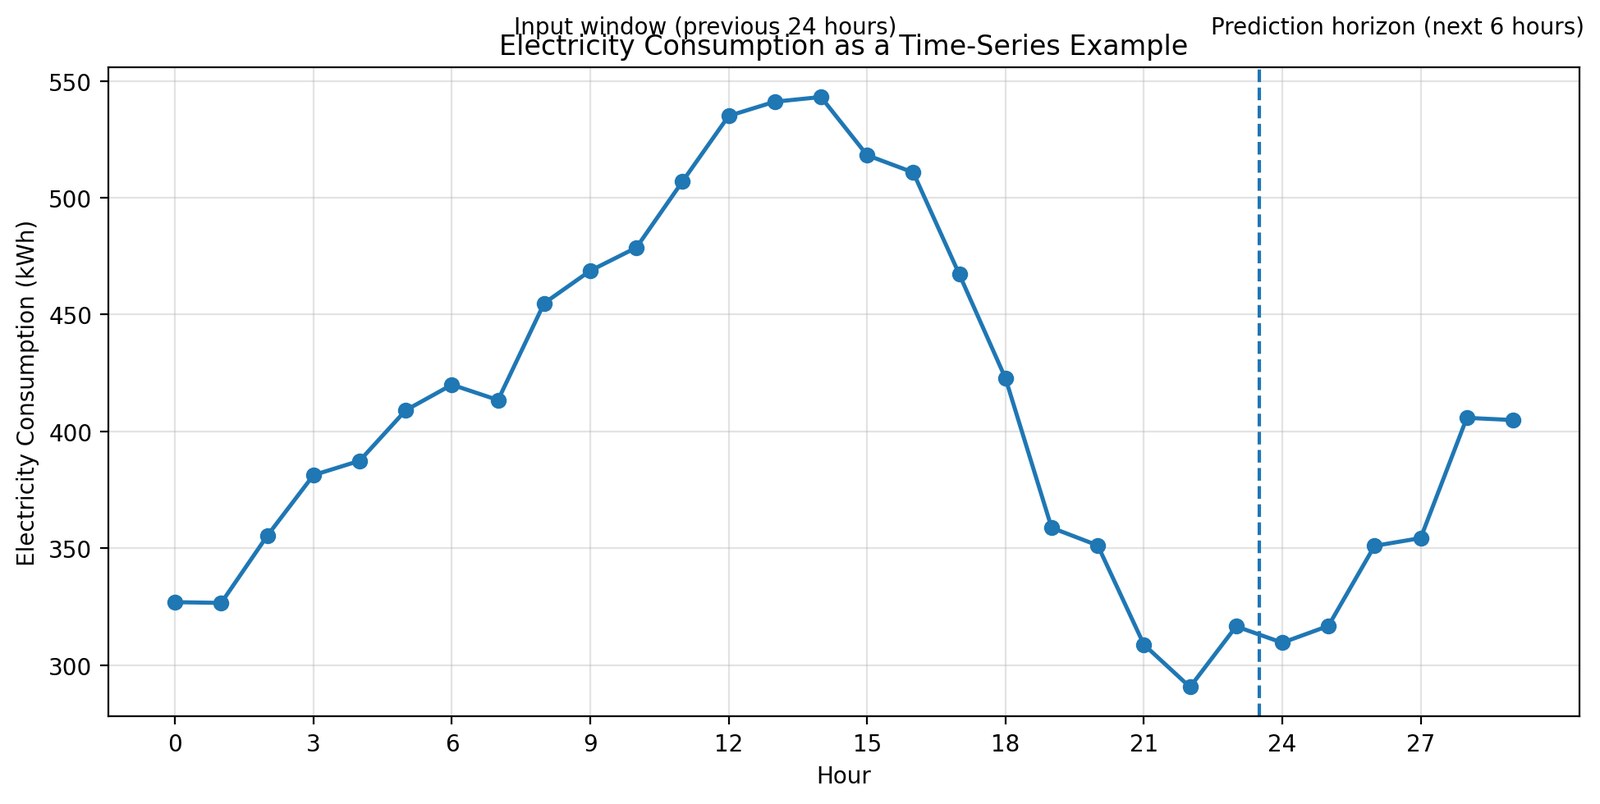
Aşağıdaki şekilde gösterildiği gibi, birkaç saatlik elektrik tüketimi örneğini göz önüne alalım.
30 saatlik bir dönemde saatlik elektrik tüketimini gösteren örnek bir grafik; 24 saatlik bir giriş penceresinden sonra 6 saatlik bir tahmin ufkunun izlendiği bir görünüm. Yazarın Python ve Matplotlib kullanarak ürettiği sentetik veri.
Bu grafikte Y ekseni elektrik tüketimini (kWh cinsinden), X ekseni ise saate göre zamanı temsil eder. Grafik yaklaşık 30 saatlik bir dönemi kapsar ve elektrik tüketimi saatlik aralıklarla kaydedilir. İlk 24 saat bizim giriş penceresimizi, ardından gelen 6 saat ise tahmin ufkumuzu temsil eder.
Şimdi ilgimizi çeken soru şu şekildedir:
Önceki 24 saatin gözlemlerini kullanarak bir sonraki 6 saatlik elektrik tüketimini tahmin edebilir miyiz?
Resmi olarak, yukarıdaki soruyu şöyle ifade edebiliriz:
X={x1,x2,…,xT} dizisini, burada xt’nin t zaman adımında bir gözlem, T’nin ise gözlemlerin toplam sayısını temsil ettiği bir gözlem dizisi olarak tanımlayalım.
Elektrik tüketimi örneğimiz için xt, t. saat içinde tüketilen elektrik miktarını temsil edebilir. Alternatif olarak her bir gözlem, o saat sırasında kaydedilen elektrik tüketimi, sıcaklık, nem ve çevresel koşulları içeren birden fazla özelliğe sahip bir vektör de olabilir.
xt = [t. tüketim, t. sıcaklık, t. nem, t. rüzgâr hızı, t. güneş radyasyonu] ∈ R⁵
\mathbf{x}_t = \begin{bmatrix} \text{tüketim}_t\\ \text{sıcaklık}_t\\ \text{nem}_t\\ \text$rüzgâr hızı}_t\\ \text{güneş radyasyonu}_t \end{bmatrix} \in \mathbb{R}^{5}
x
t
=
tüketim
t
sıcaklık
t
nem
t
rüzgâr hızı
t
güneş radyasyonu
t
∈
R
Pencere ve Ufuk
Zaman serisi tahmini için bir derin öğrenme modeli tanımlamadan önce, iki basit ama önemli kavramı anlamamız gerekiyor: Pencere ve Ufuk.
Pencere boyutu, modele tahmin yapması için bağlam olarak sunulan geçmiş gözlem sayısını ifade eder. Tahmin ufuku ise modelin kaç gelecek zaman adımını tahmin etmesinin beklendiğini ifade eder.
Örneğin, 2 günlük bir pencere boyutu ve 3 günlük bir tahmin ufuku, modelin geçmiş 2 güne ait gözlemleri kullanarak bir sonraki 3 gün için değerleri tahmin ettiği anlamına gelir.
python
import
numpy
as
np
def
create_sequences
(data, window, horizon):
X, y
=
[], []
for
i
in
range
(
len
(data)
window
horizon
+
):
X.append(data[i:i
+
window])
y.append(data[i
+
window:i
+
window
+
horizon])
return
np.array(X), np.array(y)
data
=
np.arange(
)
X, y
=
create_sequences(data,
window
=
horizon
=
)
for
x, target
in
zip
(X, y):
(
f
“
{
x
}
→
{
target
}
“
)
Çıktı:
yaml
[
1 2
]
→ [3 4 5]
[
2 3
]
→ [4 5 6]
[
3 4
]
→ [5 6 7]
[
4 5
]
→ [6 7 8]
Kayıtlı bir okuyucu, pencerenin her ardıl örnekte bir zaman adımı kadar ileri kaydığını fark eder. Model, iki geçmiş gözlemi girdi olarak alır ve sonraki üç gözlemi tahmin etmesi beklenir. Bu süreç, bir zaman dizisini denetimli öğrenme için uygun bir girdi-hedef çifti koleksiyonuna dönüştürür.
Tekrarlayan Sinir Ağları ve LSTM’ler
Zaman dizisinin ne olduğunu ve öğrenmeye uygun bir veri setine nasıl dönüştürülebileceğini anladığımıza göre, sıralı bilgiyi işlemek üzere tasarlanmış bir model sınıfını keşfedelim: Tekrarlayan Sinir Ağları (RNN’ler).
Her girdiyi bağımsız olarak işleyen modellerin aksine, RNN’ler ardıl gözlemler işlendikçe güncellenen dahili bir gizli durum korur. Bu durum, önceki zaman adımlarından bilgi taşır ve modelin tahmin üretirken güncel girdiyle birlikte geçmiş bağlamı da dikkate almasını sağlar.
Üç zaman adımında açılmış bir tekrarlayan sinir ağı. Her zaman adımında ağ, güncel girdiyi önceki zaman adımındaki gizli durumla birleştirerek bilginin sıra boyunca yayılmasını sağlar. (Örnek, yazar tarafından Gemini kullanılarak oluşturuldu.)
Derin öğrenmenin erken dönemlerinde oldukça popüler olsa da, geleneksel RNN’ler gradyanın kaybolması olarak bilinen önemli bir sınırlamadan muzdaripti. Girdi dizisinin uzunluğu arttıkça, zaman içinde geriye doğru yayılan gradyan sinyali giderek küçülebilir ve bu da ağı, önceki zaman adımlarından gelen bilgiye dayanarak parametrelerini güncellemeyi zorlaştırır. Sonuç olarak, geleneksel RNN’ler uzun vadeli bağımlılıkları öğrenmede genellikle zorlanır.
Bu sınırlamayı azaltmak amacıyla, Uzun Süreli Kısa Süreli Bellek (LSTM) adlı daha gelişmiş bir tekrarlayan sinir ağı formu tanıtıldı [1].
LSTM’ler, kapılı tekrarlı ağlar olarak bilinen tekrarlı sinir ağları sınıfına aitdir. Bir LSTM, bilgi akışını düzenleyen kapılarla donatılmış tekrarlı hücrelerden oluşur. Bu kapılar, ağı bir sonraki zaman adımından bir sonrakine ilerlerken bilgiyi seçici olarak korumasını, güncellemesini veya atmasını sağlayarak, daha uzun diziler üzerindeki bağımlılıkları öğrenmeye daha uygun hale getirir.
Uzun Kısa Süreli Bellek (LSTM) hücresinin iç mimarisi; unutma, giriş ve çıkış kapılarının gizli hücre ve hücre durumu üzerinden bilgi akışını nasıl düzenlediğini göstermektedir. (Örnek, yazar tarafından Gemini kullanılarak oluşturulmuştur.)
Yukarıdaki şekilde de görüldüğü gibi, bir LSTM hücresi üç temel kapıdan—unutma kapısı, giris kapısı ve cikis kapısı—ve hücre durumu olarak adlandırılan dahili bir bellekten oluşur.
Unutma kapısı, önceki hücre durumundan ne kadarının korunması gerektiğini belirlerken, giriş kapısı ne kadar yeni bilginin buna dahil edileceğini kontrol eder. Güncellenmiş hücre durumu ardından çıkış mekanizmasına geçer; burada çıkış kapısı, bir sonraki zaman adımına aktarilan gizli creye katkıda bulunan bilginin ne olduğunu belirler.
Bu mekanizmalar birlikte, bir LSTM’in bilgiyi bir dizide nasıl sakladığını ve yaydığını düzenlemesini sağlayarak, geleneksel RNN’lerin yakalamakta zorlandığı bağımlılıkları öğrenmesine yardımcı olur.
LSTM’ler kaybolan gradyan sorununu önemli ölçüde azaltsa da, özellikle eğitilebilir parametre sayısı bakımından kendi karmaşıklıklarını getirirler. Geleneksel bir RNN hücresinin aksine, LSTM kapı mekanizmalarıyla ilişkili birden fazla eğitilebilir bileşen içerir ve bu da gereken parametre sayısını artırır. Ek LSTM katmanları üst üste yerleştirdikçe, toplam parametre sayısı ve hesaplama gereksinimleri daha da artar.
Modern hesaplama sistemleri muazzah bir hesaplama gücü sağlasa da, bu, veriden öğrenmenin daha verimli yollarını sunabilecek alternatif yaklaşımları keşfetmeyi bırakmamız gerektiği anlamına gelmez.
Kuantum Makine Öğrenmesi (QML), kuantum hesaplamanın makine öğrenmesi modellerine nasıl dahil edilebileceğini araştıran ve bilgiyi temsil etme ile işleme için yeni yollar sunma potansiyeli taşıyan araştırma yönlerinden biridir. Kuantum yinelenen mimarilere geçmeden önce, önce QML’nin birkaç temel yapı taşına göz atalım.
Parametreli Kuantum Devreleri
Kuantum Makine Öğrenmesi (QML) terminolojisine giriş yapmadan önce, bir sinir ağını bir siyah kutu olarak düşünelim. Zaten bildiklerimiz ışığında bu siyah kutunun hangi özellikleri vardır?
Öncelikle, siyah kutumuz giriş verilerini tüketebilmelidir. Bunun için veriyi kabul eden ve daha fazla işlem için kullanılabilir hale getiren bir tür giriş arayüzüne ihtiyacı vardır. Benzetimimiz adına, buna gömme aşaması diyelim.
Ardından, siyah kutumuzun eğitilebilir çekirdeği gelir. Asıl öğrenme burada gerçekleşir. Bu, ayarlanabilir parametrelerle girişi dönüştüren, sinir ağının gizli katmanları gibi eğitilebilir bileşenlerden oluşur.
Son olarak, eğitilebilir çekirdeğin ürettiği her şeyi alır ve bunu tahmin görevimiz için uygun bir biçime dönüştüren çıkış aşaması vardır.
Aynı zamanda bu siyah kutunun nasıl öğrendiğini de biliyoruz. İleri yayılım sırasında bilgi, bir çıktı üretmek için bu aşamalar üzerinden geçer. Eğitim sırasında ise tahmin edilen ve beklenen çıktılar arasındaki hata, geri yayılım yoluyla eğitilebilir parametrelerin güncellenmesine yardımcı olan gradyanları hesaplamak için kullanılır.
Şimdi ilginç kısım burada:
aynı genel fikri, ancak tamamen farklı bir hesaplama alanında uygulamaya çalışsaydık ne olurdu?
Bu, Parametreli Kuantum Devresi (PQC) kullanılarak inşa edilmiş bir Kuantum Sinir Ağı (QNN) hakkında düşünmenin bir yolu [2>.
Tıpkı klasik siyah kutumuz gibi, tipik bir PQC tabanlı model üç fonksiyonel aşama üzerinden anlaşılabilir:
-
Kuantum gömülmesi: Klasik giriş verileri, kuantum işlemleri kullanılarak bir kuantum durumuna kodlanır.
-
Eğitilebilir kuantum işlemleri: Parametreli kuantum kapıları, kodlanmış durumu dönüştürür ve bu parametreler eğitim sırasında ayarlanır.
-
Kuantum ölçümü: Elde edilen kuantum durumu, öngörüler üretmek için kullanılabilen klasik bilgileri çıkarmak üzere ölçülür.
Kısacası, genel fikir aynı şekilde korunuyor: bir giriş alınır, eğitilebilir işlemlerden geçirilir ve bir çıktı üretilir. Değişen şey, altta yatan hesaplama makinesidir.
Bu dönüştürmeleri artık klasik sayısal temsiller üzerinde yerine getirmek yerine, hesaplamanın bir bölümünü gerçekleştirmek için kuantum durumları ve kuantum kapıları kullanıyoruz.
Aşağıdaki şekil, tipik bir Parametreli Kuantum Devresi’ni gösteriyor: klasik özelliklerin nasıl gömüldüğü, eğitilebilir ve dolanık kuantum kapıları üzerinden nasıl işlendiği ve son olarak klasik çıktılar elde etmek için nasıl ölçüldüğü.
Parametreli Kuantum Devresi (PQC) illüstrasyonu; klasik veri gömülmesini, eğitilebilir kuantum dönüşlerini, dolanık işlemleri ve ölçüme dayalı okumayı gösteriyor. θ parametreleri eğitim sırasında optimize edilirken, x giriş özelliklerini temsil ediyor. (İllüstrasyon, yazar tarafından Gemini kullanılarak oluşturuldu.)
Dolanıklık ve eğitim aşamaları benzetmemizde doğrudan görünürken, keskin bir okur şeklin içinde iki bileşen daha fark edebilir: Dolanıklık ve Ölçüm. Bunları açıklamayı mı unuttum? Hayır, tam da değil!
Ölçümle başlayalım. Daha önce de belirtildiği gibi, kara kutumuzun çıkış aşaması, kendi iç hesaplamalarının sonucunu tahmin görevimiz için uygun bir biçime dönüştürür. Bir kuantum devresinde ölçüm benzeri bir işlev görür: devre işlemlerini tamamladıktan sonra katum durumundan klasik bilgi çıkarabilmemizi sağlar. Ölçüm yöntemine bağlı olarak bu bilgi, bireysel ölçüm sonuçları ya da beklenti değerleri gibi istatistiksel nicelikler biçiminde olabilir.
Şimdi, dolanıklığa gelelim.
Dolanıklık, birden fazla katum sisteminin ortak durumunun, bireysel durumlarının çarpımı olarak tanımlanamadığı özgün bir kuantum olgusudur. PQCs bağlamında, şekil üzerinde gösterilen Kontrol Edilmiş-DEĞİL (CNOT) kapısı gibi dolanık kapalar, farklı qubit’lerin birbir etkileşmesine olanak tanır ve bağımsız tek-qubit durumlarıyla temsil edilemeyen korelasyonlar oluşturabilir.
Bu işlemler, bir PQC’nin, yalnızca bağımsız tek-qubit dönüşümleriyle ulaşılamayacak olan kodlanmış özellikler arasındaki ilişkileri temsil etmesine yardımcı olabilir.
Birlikte, parametreli katum kapaları ve dolanık işlemler, pek çok PQC tabanlı modelin eğitilebilir hesaplama çekirdeğini oluştururken, ölçüm tahminleri değerlendirmek ve eğitimi yönlendirmek için gereken klasik bilgiyi sağlar.
Klasik ve katum hesaplama arasında önemli bir ayrım daha vardır. Katum devreleri, katum mekaniğinin ilkelerine göre evrilir; burada katum durumlarının evolutionu doğrusal işlemlerle yönetilir. Ancak makine öğrenmesi modelleri, veri içindeki karmaşık örüntüleri öğrenmek için çoğu zaman doğrusal olmayan ilişkilere dayanır. PQCs tabanlı modellerde, doğrusal olmayan giriş-çıkış ilişkileri, klasik verinin katum durumlarına kodlanması ve bilginin ölçümler aracılığıyla çıkarılması biçiminden doğabilir.
Şimdi, bir sonraki bölüme geçmeden önce, bulmacanın son parçası kalmıştır: Bir QNN’yi ya da PQC’yi nasıl eğitiriz?
Bir PQC’yi eğitmek, tanıdık bir optimizasyon döngüsünü izler:
x
⟶
P
Q
C
(
θ
)
⟶
y
^
⟶
L
(
y
^
y
)
⟶
Optimizer
⟶
θ
′
x \longrightarrow \mathrm{PQC}(\theta)
\longrightarrow \hat y
\longrightarrow \mathcal L(\hat y,y)
\longrightarrow \text{Optimizer}
\longrightarrow \theta’
x
⟶
PQC
(
θ
)
⟶
y
^
⟶
L
(
y
^
y
)
⟶
Optimizer
⟶
θ
′
Bu noktada xxx giriş verilerini, θ\theta
θ eğitilebilir devre parametrelerini ve y^ \hat yy^ kuantum ölçümlerinden elde edilen tahmini ifade eder. Kayıp fonksiyonu L(y^,y)\mathcal L(\hat y,y)L(y^,y) bu tahmini beklenen yyy çıktısıyla karşılaştırırken, klasik bir optimize edici parametreleri θ\thetaθ’den θ′\theta’θ’ye günceller.
Güncellenmiş parametreler bir sonraki yinelemede kullanılır ve uygun bir durdurma kriterine ulaşılana kadar süreç devam eder.
Bu eğitilebilir devreler, özellikle parametreleri klasik bir optimizasyon döngüsüyle optimize edildiğinde, aynı zamanda yaygın olarak Değişken Kuantum Devreleri (VQCs) olarak da adlandırılır. Bu makale boyunca PQC ve VQC terimlerini yer değiştirerek kullanacağım.
Klasikten Hibrit Kuantum Modellerine
Genel olarak, Kuantum Makine Öğrenmesi (QML) modelleri kurmanın iki yaklaşımı vardır. İlki, klasik makine öğrenmesi mimarisinin belirli bileşenlerinin eğitilebilir kuantum devreleriyle, örneğin PQC’lerle değiştirilmesi veya desteklenmesiyle hibrit kuantum-klasik modeller oluşturmaktır. İkincisi ise hesabın büyük ölçüde bir kuantum sistemi içinde gerçekleştirildiği modeller tasarlamaktır.
Hibrit modeller, mimarinin seçili bölümlerine kuantum devreleri sokarken, matris çarpımı, doğrusal olmayan aktivasyon fonksiyonları ve diğer matematiksel dönüşümler gibi tanıdık işlemleri de içeren klasik hesaplamanın esnekliğini koradığı için genellikle doğal bir başlangıç noktasıdır.
Tamamen kuantum tabanlı bir model tasarlamak ise ek zorluklar sunar. Kuantum devreleri, klasik sinir ağlarında bulunan tüm hesaplama işlemlerini doğrudan sağlamaz; bu nedenle tanıdık bileşenler sık sık kuantum işlemleriyle yeniden kurgulanmak zorunda kalır. Ayrıca, kübit sayısı ve devre işlemleri arttıkça klasik simülasyonlar hesaplama açısından maliyetli hale gelebilir ve deney ile eğitimi giderek daha zor hale getirir.
Bu nedenlerle hibrit mimariler, kuantum makine öğrenimini tüm modeli baştan sona yeniden tasarlamadan keşfetmek için pratik bir yol sunar. Yalnızca seçili hesaplama işlemleri kuantum devrelerine devredildiğinden, kuantum bileşenleri genellikle nispeten küçük tutulabilir ve simülasyon ile deney daha yönetilebilir hale gelir.
Peki bu fikir bir LSTM’ye uygulandığında ne olur?
Hibrit Kuantum Uzun Kısa Süreli Bellek (HQLSTM) hücresi mimarisi; burada değişken kuantum devreleri (VQC’ler) klasik kapı hesaplama işlemlerinin yerini alır. Her VQC’nin çıktısı ölçülür ve klasik aktivasyon fonksiyonlarından geçirilir; gizli ve hücre durumları ise klasik olarak kalır. (İllüstrasyon, yazar tarafından Gemini kullanılarak oluşturuldu.)
Klasik LSTM mimarisinin üç kapıdan—unutma, giriş ve çıkış—ve zaman adımları boyunca uzun süreli belleği taşıyan bir hücre durumundan oluştuğunu hatırlayın. Gizli durum ise ardışık zaman adımları arasında ve uygun olduğu kadarı bir sonraki katmana aktarılan kısa süreli bilgiyi temsil eder.
Şimdi, yukarıda görselleştirilen Hibrit Kuantum LSTM (HQLSTM) [3] mimarisine bakın. Hâlâ tanıdık hücre durumunu, (C) olarak işaretlenen ve onu güncellemek için kullanılan eleman bazlı çarpım (Hadamard çarpımı) gibi klasik işlemleri ayırt edebilirsiniz.
Başlıca fark, kapı hesaplama işlemlerinin nasıl gerçekleştirildiğinde yatmaktadır. Hibrit mimari, tamamen klasik eğitilebilir dönüşümlere dayanmak yerine, LSTM kapılarının ve aday hücre durum güncellemesinin ihtiyaç duyduğu bilgiyi hesaplamak için Değişken Kuantum Devreleri (VQC’ler) kullanır.
Her VQC çalıştırıldıktan sonra, kuantum durumu klasik değerleri çıkarmak için ölçülür. Bu değerler ardından uygun klasik aktivasyon fonksiyonlarından geçirilir ve hücre durumunu güncellemek ile gizli durum çıktısını üretmek için kullanılır.
Kısacası, tanıdık LSTM bellek mekanizması klasik olmaya devam ederken, seçilebilir eğitilebilir hesaplamalar kuantum devrelerine devredilir.
Neyi Kaçırıyoruz?
Hibrit Kuantum LSTM’ler çeşitli problemlerde başarıyla uygulansa da, hâlâ keşfetmeye değer birkaç ince mimari sınırlama—ya da belki daha doğru bir ifadeyle, iyileştirme fırsatı—mevcuttur.
-
Ara ölçümler: Muhtemelen fark ettiniz ki, her VQC’den sonra klasik değerleri elde etmek için kuantum devresini ölçüyoruz. Ancak ölçüm, kuantum durumundan yalnızca belirli bilgileri çıkarır ve ölçülen çıktılar sonrasında sınırsal olarak işlenir. Bu nedenle bu mimari, ardışık zaman adımları boyunca tutarlı kuantum bilgisini korumaz.
-
Klasik bellek: Başka bir önemli gözlem ise gizli ve hücre durumlarının klasik kalmaya devam etmesidir; yani yinelenmeli bellek mekanizması bilgiyi saklamak ve işlemek için kuantum durumlarını doğrudan kullanmaz.
-
Kuantum-klasik etkileşimi: Ayrıca, tekrarlanan kuantum devresi değerlendirmeleri ve ölçümleri, özellikle model kuantum donanımında çalıştırılırken ek hesaplama yükü getirebilir.
Bu gözlemlere bakıldığında, ilginç bir soru sorulabilir (ben bunu yüksek lisansım sırasında sordum): Ya belleği yinemenmeli hesaplama boyunca kuantum olarak kalan bir LSTM inşa edebilirsek?
Tutarlı Kuantum LSTM’leri
Böyle bir modeli inşa etmeden önce ele alınması gereken birkaç temel zorluk var. En önemlisi, kuantum mekaniğinin iki temel ilkesidir: ölçüm sırasında durum çökmesi ve Klonlanamazlık Teoremi.
Ölçümle başlayalım. Kuantum sistemi, farklı olası durumların süperpozisyonunda var olabilir ve her biri farklı ölçüm sonuçlarının olasılıklarına katkıda bulunur. Ancak sistemi ölçtüğümüzde belirli bir sonuç elde ederiz ve kuantum durumu genellikle bu sonucun bir sonucu olarak değişir.
Bunun bir sorun olması neye dayanıyor, diye sorabilirsiniz.
Kuantum hesaplamanın ilginç özelliklerinden biri, kuantum durumlarının süperpozisyonlarını manipüle etme yeteneğidir. Özenle tasarlanmış kuantum işlemleri uygulayarak farklı olasılık amplitüdlerinin girişim yapmasını sağlayabilir ve böylece istenen cevabı elde etme olasılığını artırabiliriz. Ancak sistemi ölçtüğümüzde yalnızca sınırlı klasik bilgi çıkarız ve orijilin bilinmeyen kuantum durumu genellikle yalnızca bu ölçümden geri getirilemez.
Şimdi ikinci zorluk geliyor: oldukça şaşırtıcı görünebilecek Kopyalanamazlık Teoremi.
Klasik hesaplamada bilgi kopyalamak, hepimizin varsayıp gittiği bir işlemdir. Ancak kuantum mekaniği bu işleme temel bir kısıtlama getirir: herhangi bir bilinmeyen kuantum durumunun mükemmel bir kopyasını oluşturamayız.
Bunun nedeni yalnızca durumu ölçmenin onu bozması değildir. Aksine, kuantum işlemlerinin doğrusal yapısı, böyle evrensel bir kopyalama prosedürünü imkânsız kılar.
Bu kısıtlamalar birlikte, tekrarlı kuantum modelleri için ilginç bir zorluk yaratır: Hatıra durumunu tekrar tekrar ölçüp kopyalamadan, kuantum bilgisini ardışık zaman adımları boyunca nasıl korur ve güncelleriz?
LSTM’ler farklı yapılandırmalarda çalışabilir; bunlar arasında birden çoğa, çoktan bire ve çoktan çoğa yapılandırmalar yer alır. Örneğin, çoktan çoğa yapılandırmada, ardışık girdileri işlemek için gerekli hatırı aynı zamanda korurken her zaman adımında bir çıktı üretmemiz gerekebilir.
Kuantum geri beslemeli bir model için bu, ilginç bir meyok okuyuştı. Çıktı gerektiğinde hafıza durumunu ölçebiliriz, çünkü bunu yapmak ileri taşımak istediğimiz kuantum bilgisini bozar. Aynı zamanda No-Cloning (Kopyalama) Teoremi sayesinde, keyfi bilinmeyen bir kuantum durumunun mükemmel bir kopyasını oluşturup kopyayı ölçemeyiz.
Bu nedenle, kuantum hafızadan faydalı bilgi elde ederken onun gelişmeye devam etmesine izin vererek bunu nasıl yaparız?
Sadece terimlerle, QLSTM’den her zaman adımında bilgi çıkarmak istiyoruz, ancak aynı zamanda sonraki adımlar için gerekli kuantum bilgisini korumamız gerekiyor. Bilginin özgürce kopyalanıp yeniden kullanılabildiği klasik LSTM’lerin aksine, kuantum mekaniği kuantum durumlarına erişim ve kopyalama konusunda temel kısıtlamalar getiriyor. Bu da tanıdık LSTM davranışını tamamen kuantum ortamında yeniden üretmeyi oldukça zorlaştırıyor.
Bu sorunun çözümü, iki kubit arasında dolanıklık oluşturma yöntemlerini keşfederken güzel bir günde geldi. Bu keşif sırasında, √SWAP (SWAP’ın Karekökü) adlı ilginç bir kuantum kapısına rastladım.
Bu kapının ilginç olmasını sağlayan şey, kelime kelime tanıdık SWAP işleminin karkökü olmasıdır.
Klasik bilgisayarda iki değeri yer değiştirmek genellikle geçici bir değişken veya bit bit işlemler dizisi gerektirir. Ancak kuantum bilgisayarda SWAP, bir üniter matris ile temsil edilir. Ve bir matris olduğu için, onun karkökünü oluşturabiliriz; bu da kendisi geçerli bir kuantum işlemidir.
Ama SWAP işleminin karkökünü almak gerçekten ne anlama gelir?
Sadece terimlerle, sıradan bir SWAP kapısı iki kubitin durumlarını yer değiştirir. Örneğin, ilk kubit ∣0⟩ durumunda ve ikinci kubit ∣1⟩ durumunda ise, SWAP uyguladığımızda durumları yer değiştirir ve sırasıyla ∣1⟩ ve ∣0⟩ durumlarını üretir.
∧SWAP kapısı, buna karşılık oldukça ilginç bir şey gerçekleştirir. İki durumu tamamen değiştirme yerine, değiştirilen ve değiştirilmeyen yapıların tutarlı süperpozisyonunu oluşturur. Örneğimizde bu, iki kubitin ölçülmesinin ya ∣01⟩ ya da ∣10⟩ sonucunu verir ve her ikisinin de olasilığı %50’dir.
Daha da ilginç olanı, ∧SWAP’ın iki kez uygulanmasının, sıradan bir SWAP kapısının kez uygulanmasıyla aynı sonuca yol açmasıdır.
Bu gözlem, bizi ∧SWAP’ın kuantum kayıtları arasında bilgi alışverişi için bir mekanizma olarak kullanılabileceğini araştırmaya yönlendirdi. Bu fikre dayanarak, aşağıda gösterilen mimariyi geliştirdik; bu mimari, yayımlanan makalemizde CoQS-LSTM (Tutarlı Katum Kuantum LSTM) olarak tanıtılmıştır [4]. Sadelik ve okunabilirlik adına, makalenin geri kalanında buna CoQLSTM diyeceğim.
Tutarlı Kuantum Kısa-Uzun-Eklenmiş Bellek (CoQLSTM) mimarisinin ardışık zaman adımları üzerinden katum kuantum devre temsili. Veri kodlama devreleri, parametreli katum devreler (PQC’ler) ve ancilla destekli ∧SWAP işlemleri, ara ölçümler olmadan yinelenen kuantum bilgi işlemeyi sağlar. Klasik çıktılar elde etmek için ölçüm dizinin sonunda gerçekleştirilir. (Singh ve ark. [4]’dan uyarlanmıştır.)
Yukarıdaki şekil, önerilen Tutarlı Katum Kısa-Uzun-Eklenmiş Bellek (CoQLSTM) mimarisini ardışık zaman adımları üzerinden göstermektedir.
İlk bakışta, klasik LSTM’den tanıdık bazı bileşenleri fark edebilirsiniz: bir girdi xx x, bir gizli durum hhh ve bir hücre durumu hhh. Ancak gizli ve hücre durumlarının klasik değerlerle temsil edildiği klasik veya hibrid LSTMs’in aksine, CoQLSTM bunları katum kayıtları kullanarak temsil eder.
Bilginin mimari içindeki akışını takip edelim.
Her zaman adımında, gelen klasik veri bir veri kodlama devresi D-PQCD kullanarak kuantum durumlarına kodlanır. Burada, klasik özellikleri kuantum döndürme kapıları aracılığıyla kuantum devresine tekrar tekrar sokan veri yeniden yükleme [5] adlı bir teknik kullanıyoruz. Bu sayede, her özellik için ayrı bir qubit atamak zorunda kalmadan birden fazla giriş özelliğini kodlayabiliyoruz.
Kodlanan giriş ardından, giriş, gizli ve hücre kayıtları arasında etkileşimlere olanak tanıyan bir dizi Parametreli Kuantum Devresi (PQC) üzerinden geçer. Bu işlemler, yeni bilgiler geldikçe kuantum hafızasını günceller.
Şimdi, gizli kaydı yardımcı qubitlere ya da ancillara bağlayan √SWAP kapılarını fark edin; bunlar a0, a1 olarak gösterilir. Bu kapılar kuantum durumlarını tamamen değiştirmek yerine, gizli kaydı ile ancillar arasında kısmi bilgi alışverişi yapmaya olanak tanır ve arasında kuantum korelasyonları oluşmasına yol açabilir.
Ama belki de en önemli özellik, bundan sonra olanlardır.
Gizli ve hücre kayıtlarının, ölçülmeden bir sonraki zaman adımına doğrudan aktığını fark edin. Daha önce tartışılan hibrit QLSTM’nin aksine, CoQLSTM tekrarlayan hafızasını sürekli olarak klasik değerlere dönüştürmez. Bunun yerine kuantum durumları ardışık zaman adımları boyunca evrimini sürdürür ve tutarlı bir tekrarlayan hesaplamayı korur.
Son olarak, kuantum sisteminden klasik bilgi çıkarmak için ölçümler gerçekleştirilir. Ölçümler tekrarlayan hesaplamanın sonuna ertelendiğinden, gizli ve hücre kayıtları ara okumalar olmadan evrimini sürdürebilir. Simülasyonlarda ayrıca kuantum durumlarını bireysel zaman adımlarında inceleyerek bilginin tüm dizı boyunca nasıl evrildiğini çalışabiliriz.
Özetle, CoQLSTM klasik tekrarlayan hafıza mekanizmasını bir kuantum olanakla değiştirir; bilgiyi işlemek için parametreli devreleri ve tutarlı bilgi alışverişini kolaylaştırmak için √SWAP işlemlerini kullanır.
Ama siz de sorabilirsiniz: CoQLSTM her zaman adımında nasıl bir çıktı üretiyor?
Bu amaçla CoQLSTM, ancilla (a₀, a₁) adı verilen yardımcı kuantum kayıtları kullanır. √SWAP işlemleri aracılığıyla katumum bilgisi, o belirli zaman adımına ait bilgiyi koruyan gizli kayıt ile ilgili ancilla arasında kısmen değiş tokuş edilir.
Bu ancillaları hemen ölçmek yerine, ölçümlerini tüm yinelenen dizinin işlenmesini erteleriz. Bu sayede, yinelenen belleğin koherent evrimini kesintiye uğratmadan zaman adımına dayalı tahminler elde edebiliriz.
Aslında İşe Yarıyor mu? — Değerlendirmeler
Şu ana kadar CoQLSTM’nin ardındaki motivasyonu ve katumum bilgisini ardışık zaman adımları boyunca korumaya nasıl çalıştığını inceledik. Ancak ilginç bir mimari hikâyenin yalnızca bir bölümüdür. Sonraki soru, gerçekten anlamlı zamansal örüntüleri öğrenip öğrenemediğidir.
Orijinal makalemizde [4], CoQLSTM’yi Kalite İndeksi (AQI) tahmin görevinde klasik ve hibrit katumum LSTMLeriyle karşılaştırarak değerlendirdik. Ancak bu makalede farklı bir sorunu ele alacağız: Lorenz sistemi adı verilen, doğrusal olmayan ve kaotik dinamiğin bilinen örneklerinden birinin evrimini tahmin etmek.
Gerçek dünya gözlem veri setlerinin aksine, Lorenz zaman dizisi bir dizi diferansiyel denklemden sayısal olarak üretilebilir. Bu deneyi tekrarlanabilir kılar ve CoQLSTM’nin doğrusal olmayan bir dinamik sistinin davranışını öğrenme yeteneğini araştırmak için ilginç bir ortam sağlar.
Tahmin performansını değerlendirmek için, CoQLSTM’yi ortalamarekare hatası (MSE) ve karekök ortalamarekare hatası (RMSE) gibi ölçütler kullanarak, basit bir süreklilik tabanı ve klasik makine öğrenmesi modelleri de dahil olmak üzere daha basit tahmin yaklaşımlarıyla karşılaştırıyoruz.
Deney Kurulumu
Bu deney için, açık kaynaklı Python kütüphanesi ReservoirPy kullanarak Lorenz sisteminden 5.000 gözlem ürettik. Standard Lorenz parametrelerini ve 0.03 entegrasyon aralığını kullandık.
Üretilen veri seti, sistemin evrimini betimleyen xxx, yyy ve zzz değişkenini içeriyor. Amacımız, üç değişkenin de önceki iki gözlemin kullanarak xx’nin sonraki değerini tahmin etmekti.
Veri setini kronolojik olarak %70 eğitim, %20 doğrulama ve %10 test olarak böldük. Eğitimden önce, veri sıfır ortalamalı ve birim varyanslı olacak şekilde standartlaştırıldı; ölçeklendirme parametreleri bilgi sızıntısını önlemek için yalnızca eğitim bölümünden hesaplandı.
Bu deney için, eğitilebilir √SWAP etkileşimi içeren, 271 eğitilebilir parametre barındıran modifiye edilmiş bir CoQLSTM mimarisi kullandık. Model 10 dönem boyunca eğitildi ve tahmin performansı Ortalama Kare Hatası (MSE), Kare Hatasının Karekökü (RMSE) ve belirleme katsayısı R2 üzerinden değerlendirildi.
Sonuçları bağlama oturtmak için iki basit tahmin temeli de değerlendirdik:
-
Sürdürme: Sonraki değeri, en son gözlemlenen değer kullanarak tahmin eder.
-
Hareketli Ortalama: Sonraki değeri, en son iki gözlemin ortalamasını kullanarak tahmin eder.
Bu iki basit temel herhangi bir model eğitim gerektirmez.
Sonuçlar ve Tartışma
İlk gözlem, CoQLSTM’nin veriden öğrenebilmesidir. Eğitim sonrasında test MSE’si yaklaşık 1.145’ten 0.089’a düşmüş, bu da %92’yi aşan bir azalmaya karşılık geliyor. R2 değeri de negatif bir değerden yaklaşık 0.91’e yükselmiştir.
CoQLSTM’nin Lorenz tahmin görevindeki performansı. (a) 10 dönem boyunca eğitim ve doğrulama ortalama kata hatası (MSE). (b) Standartlaştırılmış test setindeki gerçek değerlerle karşılaştırılan Lorenz sisteminin xxx-bileşenine yönelik tek-adımlık tahminler.
Eğitim eğrileri bu gözlemi güçlendiriyor. Hem eğitim hem de doğrulama hataları on dönem boyunca azalıyor; bu da modelin geçmiş Lorenz gözlemlerinden bir tahmin ilişkisi öğrendiğine işaret ediyor.
Prognoz grafiğine bakıldığında, CoQLSTM’nin genel olarak gerçek Lorenz izini takip ettiği, birkaç tepe, çukur ve kısa vadeli değişkenliği yakaladığı görülebilir. Ancak, özellikle sinyaldeki keskin değişimler etrafında belirgin sapmalar kalmaktadır.
Ancak bu performans, daha basit öngörü yöntemleriyle nasıl karşılaştırılır?
İlginçtir ki, hem süreklilik hem de hareketli ortalama temel modelleri, CoQLSTM’den daha yüksek öngörü hataları elde etti. Model öngörülebilir ilişkileri öğrenme yeteneğini göstermekle birlikte, bu nispeten basit öngörü görevindeki performansı, özellikle daha karmaşık gerçek dünya senaryolarında klasik yöntemlere karşı herhangi bir üstünlük tesis etmemektedir.
Buna rağmen deney, tutarlı bir kuantum yinelenen mimarinin zamansal örüntüleri yaklaşarak modelleyecek şekilde eğitilebileceğine dair ilk bir gösterimi sağlamaktadır. Kuantum belleğin kendinin bu öğrenmeye anlamlı bir katkı sağlayıp sağlamadığı ise hâlâ cevaplanmamış bir sorudur.
Sonra Nereye?
Başlangıç sonuçları umut verici olsa da, CoQLSTM’nin kapasiteleri ve sınırlamaları hakkında tam bir anlayışa varmadan önce hala yapılması gereken oldukça fazla iş bulunmaktadır.
İlk olarak, mimariyi AQI öngörü ve Lorenz sistemi gibi problemlerde inceledik; ancak bu deneyler, pratikte karşılaşılan zaman serisi problemlerinin yalnızca küçük bir bölümünü temsil etmektedir. Mimarinin ne kadar iyi genelleştiğini daha iyi anlamak için, her biri kendi altında yatan örüntüleri ve özellikleri taşıyan daha çeşitli veri setleri ve gerçek dünya uygulamaları üzerinde değerlendirmesi gerekmektedir.
İkinci olarak, mimarinin birkaç bileşeni optimize etmeye açıktır. Veri kodlama stratejisi, kübit sayısı ve Parametreli Kuantum Devrelerinin (PQC’ler) derinliği hepsi ayarlanabilir hiperparametre olarak ele alınabilir. Zaman ve hesaplama sınırlamaları nedeniyle bu olanakları kapsamlı şekilde inceleme fırsatı bulamadık. Alternatif yapılandırmaların öngörü performansını önemli ölçüde iyileştirebileceği hâlâ ilginç bir soru olarak kalmaktadır.
Son olarak ve belki de en önemlisi, CoQLSTM tutarlı bir kuantum yinelenir hesaplama sağlasa da, nasıl öğrendiği ve zamansal bilgiyi nasıl koruduğu konusunda hâlâ kapsamlı bir teorisel anlayışa sahip değiliz. Deneyimsel sonuçlarımız modelin geçmiş verilerden örüntüler öğrenebildiğini gösteriyor, ancak önceki zaman adımlarından gelen bilginin nasıl korunduğu, dönüştürüldüğü ve sonraki tahminlere nasıl dahil edildiği konusunda tam olarak açıklama yapmıyor.
Bu altta yatan mekanizmaları anlamak, gelecek araştırmaları için önemli bir yön ve benim de aktif olarak üzerinde çalıştığım bir konu.
Şimdilik CoQLSTM, yinelenir hafızanın kuantum mekaniği kullanılarak nasıl uygulanabileceğine dair başlangıç seviyesinde bir keşif niteliği taşıyor. Böyle mimarilerin nihayetinde klasik karşılıklarına göre anlamlı avantajlar sunabilmesi açık bir soru olarak kalyor.
Okuduğunuz için teşekkürler!
Sorumluluk Reddi
Bu makale, Dil Modellerinin (LLM’ler) yardımıyla dilbilgisi açısından düzenlenmiştir. Makaledeki tüm görseller yazar tarafından GPT ve Gemini görsel üretimi araçları kullanılarak oluşturulmuş, kuantum devre diyagramları ise PennyLane kullanılarak üretilmiştir.
-
S. Hochreiter ve J. Schmidhuber, “Long Short-Term Memory,” Neural Computation, c. 9, no. 8, ss. 1735–1780, 1997. DOI: 10.1162/neco.1997.9.8.1735.
-
K. Mitarai, M. Negoro, M. Kitagawa ve K. Fujii, “Quantum Circuit Learning,” Physical Review A, c. 98, no. 3, 032309, 2018. DOI: 10.1103/PhysRevA.98.032309.
-
S. Y.-C. Chen, S. Yoo ve Y.-L. L. Fang, “Quantum Long Short-Term Memory,” Proceedings of the IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP) içinde, ss. 8622–8626, 2022. DOI: 10.1109/ICASSP43922.2022.9747369.
-
D. Singh, U. Nath, A. Gupta ve D. Bera, “CoQS-LSTM: A Coherent Quantum LSTM,” Proceedings of the 5th International Conference on AI/ML Systems (AIMLSystems) içinde, ss. 400–405, 2025. DOI: 10.1109/AIMLSystems67835.2025.11330282.
-
A. Pérez-Salinas, A. Cervera-Lierta, E. Gil-Fuster ve J. I. Latorre, “Data re-uploading for a universal quantum classifier,” Quantum, c. 4, s. 226, 2020. DOI: 10.22331/q-2020-02-06-226
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.