

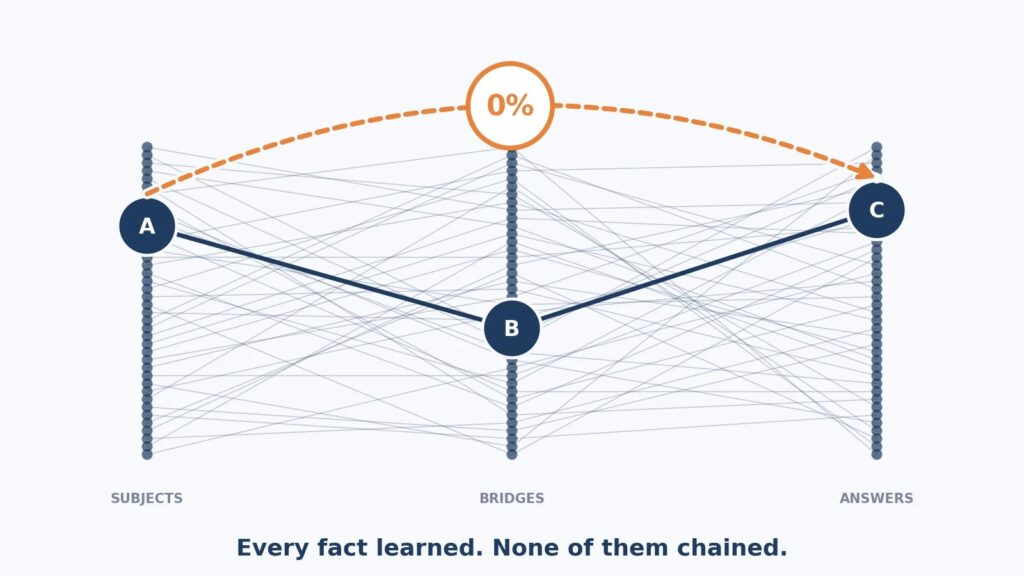
Dil modeline “Imagine’ı seslendiren sanatçının eşi kimdir?” sorusunu sorduğunuzda, iyi bir model bunu doğru cevaplayabilir; yeter ki önce sesli düşünerek ilerlesin: şarkıyı kim seslendirdi, sonra o kişiyle kim evlendi. Tek adımda, görünür bir muhakeme olmadan cevap vermesi istendiğinde ise işler sarsılmaya başlar.
Balesni, Korbak ve Evans [1], bu zayıflığın ne kadar derine indiğini merak etti. Yöntemleri, modelleri uydurma gerçeklerle ince ayar (fine-tune) yapmak oldu; böylece cevap, eğitim verisinde yarı yarıya hatırlanan bir kısayoldan gelemez. İki gerçek aynı eğitim metninde yan yana geldiğinde modeller onları birbirine bağlayabiliyordu. Aynı iki gerçek ayrı metinlerden öğrenildiğinde ise doğruluk rastlantı seviyesine düşüyordu. Bu olguya İki-Adım Laneti adını verdiler.
Önceden Tersine Lanet hakkında yazmıştım; burada bir model “A, B’dir” bilgisini öğrendiğinde “B, A’dır” sorusunu cevaplayamıyor [3]. İki-adım sürümü yakın bir akraba gibi görünüyordu ve bu makaleleri eğlenceli kılan aynı özelliği taşıyordu: Tüm sayıların üzerine çıkabileceğiniz bir ölekte bütün sistemi yeniden kurabilirsiniz. Ben de öyle yaptım.

Kurulum: İki gerçek, kimse sormadığı bir soru
200 konu, 200 köprü varlığı ve 200 cevap uydurdum. Her konu tam olarak bir köprüye, her köprü de tam olarak bir cevaba rastgele eşleştirmelerle bağlanır. Kişi, sonra şehir, sonra ülke düşünebilirsiniz; ancak verimdeki hiçbir şey bir anlam taşımıyor, böylece model dünyaya dair bir bilgiye dayanamıyor.
Eğitim, modele iki bağı ayrı örnekler olarak gösterir: (konu, ilişki 1) köprüyü verir ve (köprü, ilişki 2) cevabı verir. İlgilendiğim soru ise (konu, ilişki 1, ilişki 2) üzerinden cevabı bulmaktır. Bu soru eğitim setinde hiç yer almaz. O, sınavdır.
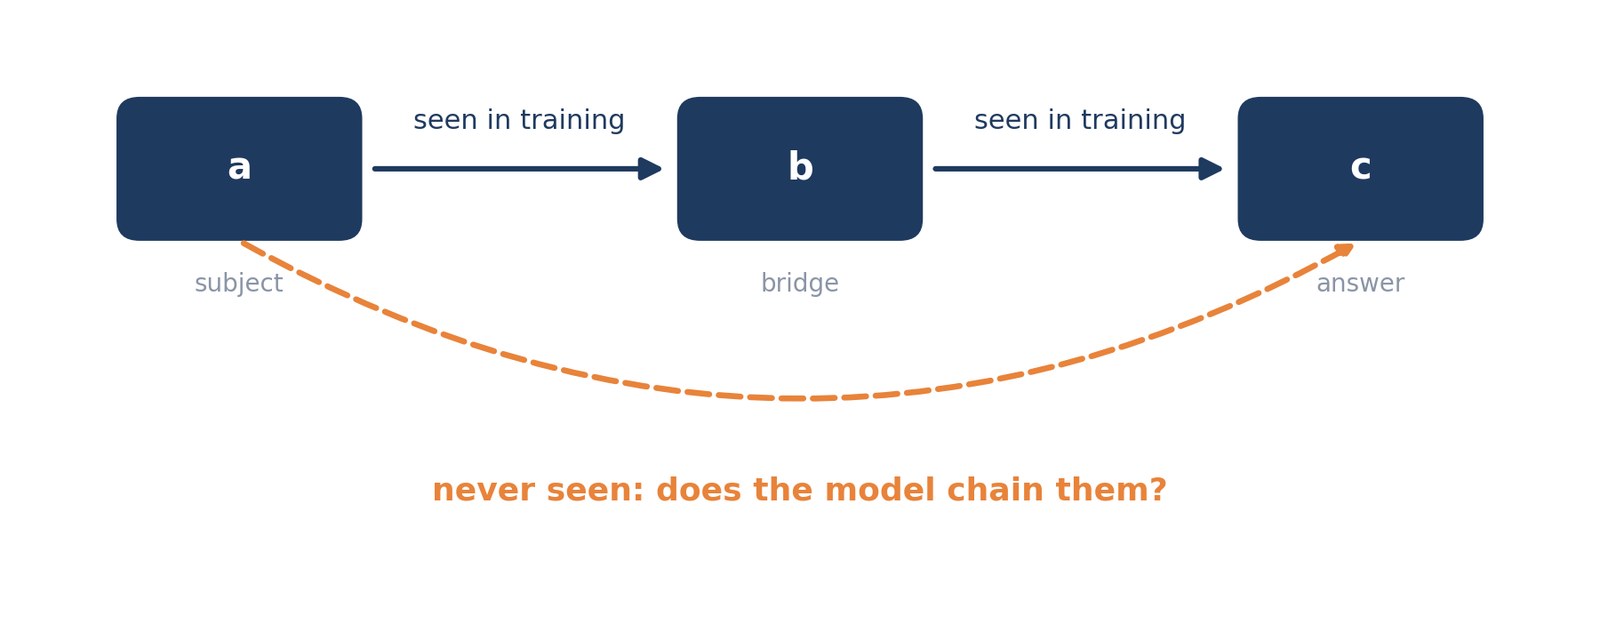
İki gerçek eğitim verisinde vardır. Birleşik soru ise yoktur. Resim yazar aittir.
Model, 4 katmanlı, 128 genişliğinde ve 4 dikkat başına sahip, her adımda tam eğitim seti üzerinde AdamW ile (öğrenme oranı 0.001, ağırlık azaltma 0.1) sıfırdan eğitilen bir GPT’dir. Aşağıdaki her ayar üç rastgele tohum ile çalıştırıldı. Doğruluk katıdır: modelin tüm sözlükteki en üst tahmini, doğru cevap belirteci olmak zorundadır.
Veri kurulumu birkaç satırda özetlenebilir. SUBJ, BRIDGE ve ANSWER yalnızca token kimlik numaraları listesi; R1 ve R2 ise iki ilişki tokenidir.
python
import
numpy
as
np
N
=
rng
=
np.random.default_rng(
)
p
=
rng.permutation(N)
# subject i -> bridge p[i]
q
=
rng.permutation(N)
# bridge j -> answer q[j]
train
=
[]
# (giriş tokenları, hedef token)
for
i
in
range
(N):
train.append(([
SUBJ
[i], R1],
BRIDGE
[p[i))
# ilk adım
for
j
in
range
(N):
train.append(([
BRIDGE
[j], R2],
ANSWER
[q[j))
# ikinci adım
# kimlik köprüsü: seçilen bir oran için köprülere “b -> b” ekle
frac
=
0.0
chosen
=
rng.permutation(N)[:
int
(
round
(frac
*
N))]
for
j
in
chosen:
train.append(([
BRIDGE
[j,
BRIDGE
[j]))
# test: eğitimde hiçbir zaman görünmez
test
=
[([
SUBJ
[i], R1, R2],
ANSWER
[q[p[i])
for
i
in
range
(N)]
Meydan okumanın görüntüsü
Eitim kümesinde yalnızca iki tek adımlık tablo bulunduğundan, model her şeyi neredeyse anında ezberledi. Eğitim doğruluğu, kaydettiğim ilk kontrol noktasında (adım 100) %100’e ulaştı ve orada kaldı. İki adımlık testte ise üç denemede de 200 sorudan 0’ını, yani 600 sorudan 0’ını doğru bildi.
Bunu bağlama oturtmak gerekirse, 200 olası cevap arasında tahmin yürüten bir model bu 600 cevabın yaklaşık 3’ünü doğru bilirdi. Hiçbire doğru demek, ağın görünmez bir iki adımlık soruda yaptığı şeyin cevaplar arasında tahmin yürütmek olmadığını gösteriyor. Bunun yerine ne çıkardığını kaydetmediğim için bunun üzerine spekülasyon yapmayacağım.
Bu, İki-Adım Laneti’nin en saf halidir. Model, ihtiyaç duyduğu her bilgiyi bilir ve tek-adımlık soruların her birini mükemmel şekilde yanıtlayabilir. Yine de ikisini bir araya getiremez; bunun için nasıl yapılacağı ona gösterilmeden.
Tek satırlık çözüm
Lin, Chen ve Xu’nun [2] yeni bir makalesi, böyle kurulumlarda eğitim verisinin bir şeyi eksik ettiğini savunuyor. İlk adımdan çıkan köprü varlığının, ikinci adıma giren köprü varlığıyla aynı şey olduğu modele anlatılmıyor. Bu olmadan, ağın tek-adımlık görevleri içsel özellikler kullanarak ayrı ayrı uydurabileğini ve iki yapının asla bağlanamayacağını iddia ediyorlar.
Son çözümleri kimlik köprüsü olarak adlandırılıyor: Her b köprü varlığı için, b’yi kendisine eşleyen bir eğitim örneği ekleniyor. Tek bir token giriyor, aynı token çıkıyor. Konu yok, yanıt yok, bileşik soruya dair bir ipucu yok.
Bunun, sentetik ortamlarında bileşimi açmaya yeterli olduğunu ve olmadan bileşimin başarısız olduğunu bildiriyorlar [2]. Küçük bir değişikliğe göre bu güçlü bir iddia; ben de test ettim. 200 köprünün kaçına kimlik örneği verildiğini değiştirdim: hiçbiri, %25’i, %50’si ya da hepsi. Örnek alan köprüler ile almayanlar aynı test kümesinde olduğu için, iki grubu ayrı ayrı puanlayabildim.
Aslında olan oldu
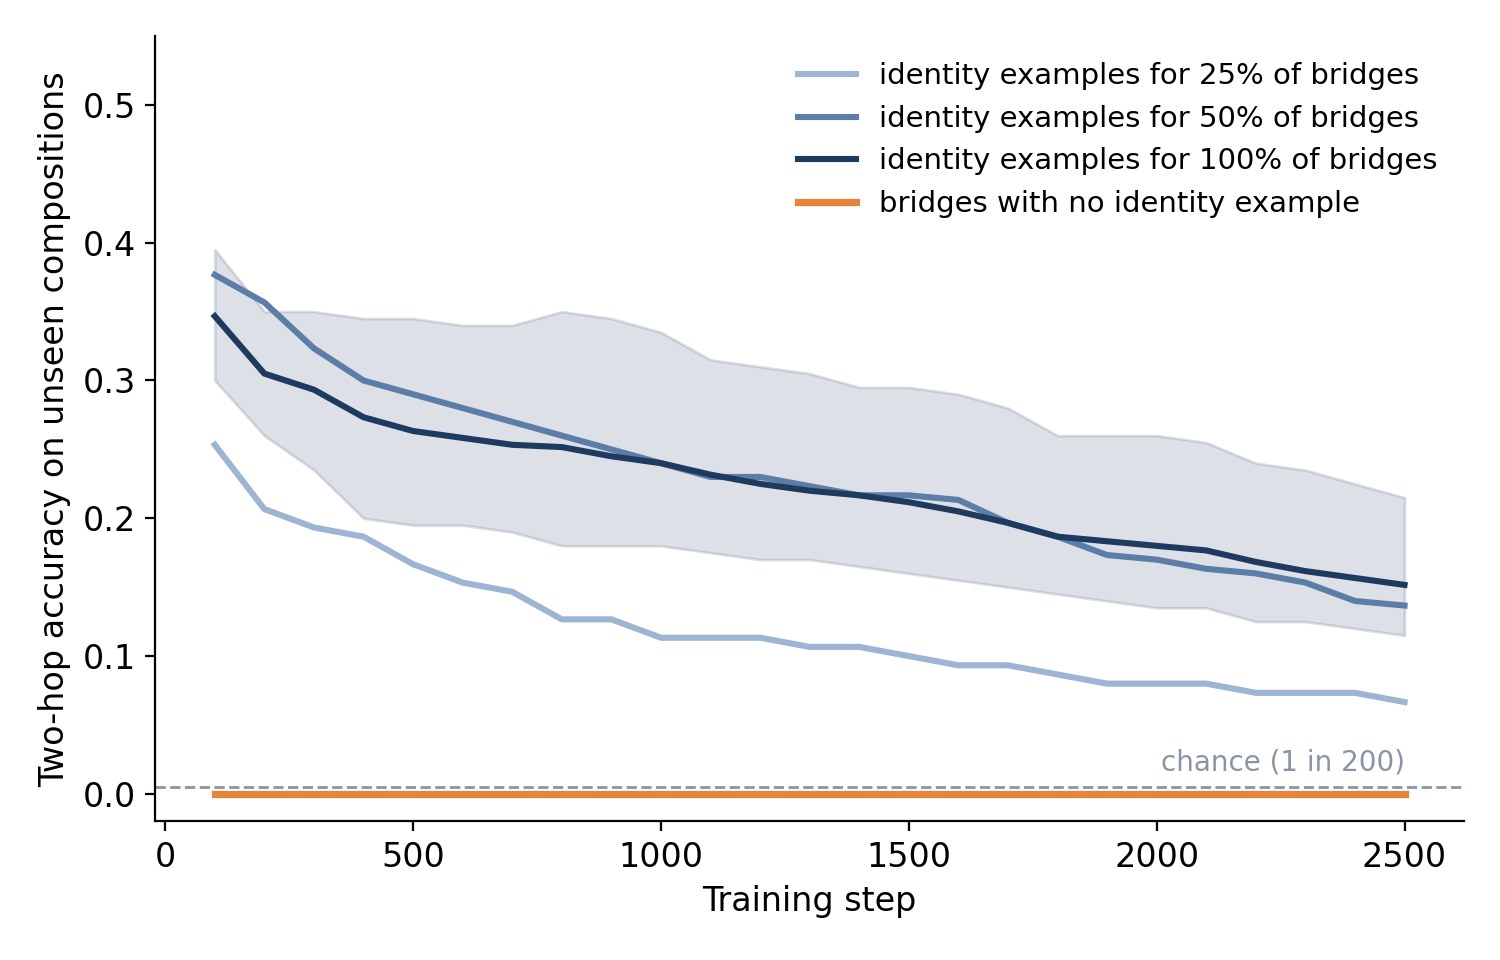
Hiç kimlik örneği almayan köprülerle başlayalım. 12 deneme ve 25 denetim noktası boyunca model, o test sorularının tam olarak sıfırını doğru cevapladı. %0, %25 ve %50 kapsama oranlarında bu, son adımda sırasıyla 600, 450 ve 300 böyle test durumu anlamına geliyor ve hiçbirinde hiçbir zaman doğru yanıt verilmedi.
Şimdi bir tane alan köprüler.
Eğitim sırasında görülmeyen bileşimlerde iki-adımlık doğruluk. Kimlik örneği alan köprüler (mavi) bir süre bileşim yapıyor, sonra kayboluyor. Bir tane almayanlar (turuncu) ise hiç yapmıyor. 3 tohum ortalaması; gölgeli bant, %100 ayarı için min’ten max’a aralığıdır. Resim yazarındandır.
Bileşim kısmen işe yarar. İlk kontrol noktamda (100. adım), örnek içeren köprülerin oranı %25 iken o köprülerdeki doğruluk ortalaması %25, %50 oranında %38, %100 oranında ise %35’ti. Bu, rastlantıyla elde edilecek %0,5’in ve lanetten gelen düz sıfırın çok üzerinde. Model hiç olsun olsun bileşik bir örnek görmedi ve bunların üçte birden fazlasını doğru yanıtlıyor.
Ama bu sürüp gitmiyor. İçinde herhangi bir kimlik örneği olan tüm dokuz denemede, o köprülerdeki doğruluk ilk ya da ikinci kontrol noktasında en yüksek seviyeye ulaşıyor, ardından eğitimin geri kalanında düşürlüyor. 2.500. adımda üç ayar için bu değer %7, %14 ve %15’e düşüyordu. %100’lük ayarda üç tohum sırasıyla %12,5, %21,5 ve %11,5’te kapanıyordu.
Kimlik örneği içeren köprülerdeki doğruluk: ilk kontrol noktası ile son kontrol noktasında. Hata çubukları 3 tohum üzerinde bir standart sapmayı gösteriyor. Görüntü yazarın.
Sayabileceğim şey ve söyleyemeyeceğim şey
Bu kurulum içinde sağlam: lanet tamamdır (600’ün 0’ı) ve bir köprünün bileşim üretmesiyle hiç üretmemesi arasındaki farkı kimlik örneği belirliyor. İçinde böyle bir örnek olmayan her köprü, her demenin her kontrol noktasında başarısız oldu.
Aynı şekilde sağlam: benim kurulumumda bu fayda geçicidir. Etki gerçektir ancak eğitimin sürmesiyle aşınır.
Nedenini bilmiyorum. Denemedğim tahminim, daha uzun eğitimin ağırlığın iki tek-atımlık tablo için ayrı iç özelliklere oturmasına yol açması; ki bu, kimlik örneklerinin önlemesi gereken tam olarak durum bu. Ağırlık azaltma ve öğrenme hızı da rol oynayabilir; ayrıca deneyde tek tek, bir seferde yalnızca bir şeyi değiştirdim, o da kimlik örneği içeren köprülerin oranıydı.
Okuyan herkesin önüne koyacağım iki sınır daha var. Her 100 adımda bir değerlendirdiğim için ilk 100 adımı hiç görmedim. Tepe noktası %38’den yüksek olabilir ve daha erken gelebilir. Ayrıca kurulumum makaleninkinden oldukça farklı. Lin ve arkadaşları, çok daha büyük modeller (12 katman, 768 genişlik) kullanarak, daha düşük öğrenme hızıyla 20 dönem eğitilmiş en basit ayarlarında neredeyse mükemel doğruluk bildiriyor [2]. Benimkisi ise daha yüksek bir öğrenme hızıyla 2.500 tam toplu adım boyunca çalıştırılan 4 katmanlı bir model. Yani sonuçlarım onlarınkini çürütmüyor. Yapılacak düzeltmenin ne kadar ve ne kadar yoğun eğittiğinize hassas olduğunu öne sürüyorlar ve bunun üzerine daha fazla konuşmadan önce doğrudan test etmek istediğim bir konu bu.
Neden oyuncak bir model zahmete değer
Gerçek modellerde hikâye daha bulanık. Balesni ve arkadaşları da dokuz önde gelen modeli gerçek dünyaya ait bilgiler üzerinde test etti ve zincirli düşünme olmadan, yazılı muhakeme yapmalarına izin verildiğinde kısmen başarılı olmalarına rağmen, denedikleri soru kategorilerinin yarısından fazlasında tamamen başarısız olduklarını buldu [1]. Başka bir çalışma ise, bir bilginin iki atlama soruları için yeterince iyi öğrenilmesinin modelin onu iki kez depolamasını gerektirebileceğini öne sürüyor [4]; bu da bunun neden zor olduğunun bir kısmını açıklayabilir.
200 varlıklı bir oyuncaktan, büyük bir modelin içinde aslında ne olduğunu söyleyemem. Oyuncak bana makalelerden nadiren ulaşabileceğim bir şey veriyor: kendi kendime kontrol edebileceğim kadar küçük bir deney, bir bilgi başına açıp kapatabileceğim bir anahtar. Anahtar kapalıyken model her zaman başarısız oluyor. Açıkken birleştirebiliyor ve eğitim bunu yine de aşındırabiliyor.
Bu, açık sonraki soruyu somutlaştırıyor. Bu solma, ağırlık çürümesi mi, öğrenme hızı mı, yoksa sadece çok uzun eğitim mi yapıyor? İlk birkaç yüz adımda her 10 adımda bir değerlendirme yapmayla başlarım, sonra bu iki ayarı tarardım. Sen önce sen deneyorsun, ne gördüğünü duymak isterim.
[1] Mikita Balesni, Tomek Korbak, Owain Evans, İki Atlama Laneti: A->B, B->C üzerinde eğitilen LLM’ler A->C’yi öğrenmekte başarısız oluyor (2024), arXiv:2411.16353
[2] Pengxiao Lin, Zheng-An Chen, Zhi-Qin John Xu, Transformers’da Çok Atlamalı Muhakemenin Mekanizmalarının Kimlik Köprüsü Üzerinden Ortaya Çıkarılması (2025), arXiv:2509.24653
[3] Lukas Berglund ve diğerleri, Tersine Lanet: “A, B’dir” biçiminde eğitilen LLM’ler “B, A’dır” bilgisini öğrenemiyor (2024), ICLR 2024
[4] David Johnston, Nora Belrose, Bilgi İçeriği Ölçeklendirmesi Üzerinden İki Adımlı Çıkarımın İncelenmesi (2025), arXiv:2502.03490
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.
Bu gelişme hakkında düşüncelerinizi, donanım deneyimlerinizi veya sorularınızı Topluluk Forumumuzda paylaşın.
Foruma Katıl & Yanıtla ➔























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.