

TypeSafe.AI adlı yapay zeka şirketi, yeni nesil bir karar verme modeli olan Jev’i piyasaya sürdüğünü ve bu modelin yıllardır kullandığımız ve övdüğümüz büyük dil modellerinden (LLM) temelden ayrıldığını iddia ediyor. Şirket, “System One” olarak adlandırdığı bu yaklaşımı; sınıflandırma, NPS yorumları için konu analizi veya LLM tabanlı değerlendirme görevleri gibi günlük kullanım alanlarına uygun görüyor ve Jev’in kendisinden beklenen çıktıyı yapılandırılmış biçimde üretmesini hedefliyor.
Bu gelişmeyi pratikte test etmek isteyen bir araştırmacı, modelin LLM’lerden farklarını ve TypeSafe.AI’nin iddialarının gerçekte ne kadar tuttuğunu, müşteri destek talepleri için niyet sınıflandırması örneği üzerinden incelemeye karar verdi. Böylece hem yeni model mimarisinin teknik yönleri hem de gerçek bir görevdeki performansı karşılaştırmalı biçimde değerlendiriliyor.
Jev’in LLM’lerden farkı: Karar ve olasılık
Büzel dil modelleri, sıradaki token’i tahmin edip uzun metinler ve konuşmalar üretmek üzere eğitilirken, System One modelleri bir durumu değerlendirmek ve yapılandırılmış yanıtlar vermek için tasarlanmış. LLM’lerdeki gibi doğal dili girdi olarak alabilmeleri nedeniyle bu açıdan belirgin bir fark yok; ancak temel amaç farklı: karar üretmek.
Jev’i ilginç kılan şey, eğitim sonrası (post-training) yaklaşımı. LLM’ler çoğunlukla RLHF (İnsan Geri Bildirimiyle Güçlendirilmiş Öğrenme) ile insan tercihleriyle uyumlu olacak biçimde eğitilir; ancak bu yöntem pratikte görülen uysallığı (sycophancy) ve özgüvenli görünen uydurma yanıtları da beraberinde getirebilir. Sohbet asistanları için işe yarayan bu yaklaşım, karar verme içeren görevlerde TypeSafe’e göre farklı bir yöntemi zorunlu kılıyor.
Jev için şirket, modele hem kararı hem de olasılıkları döndürecek biçimde eğiten RLCD (Kalibre Edilmiş Kararlar için Güçlendir Öğrenme) yöntemini kullanıyor. Modelin nasıl çalıştığı ve girdi-çıktının neye benzediği ise aşağıda açıklanıyor.
Girdi “durum”, çıktı ise olasılıklı yapılandırılmış cevap
Modele yapılan girdi “durum” (state) olarak adlandırılıyor. Durum, modele sağlamak istediğiniz bağlamı ve yanıtlamasını istediğiniz soruları içeriyor; tek bir mesajdan, örneğin “PIN numaramı değiştirmem mümkün mü?” müşteri talebinden ya da bir JSON nesnesinden oluşabilir.
Durum çeşitli alanları içeren bir harita biçiminde olabilir: {“message”: “PIN numaramı değiştirmem mümkün mü?”, “user_id”: 123}. Ya da mesajların veya kayıtların bir dizisini temsil eden bir dizi biçimde olabilir: [“Merhaba! Size nasıl yardımcı olabilirim?”, “PIN numaramı değiştirmem mümkün mü?”]. En iyi uygulama, bağlam hakkında akıl yürütmeyi kolaylaştıracak şekilde açık alan adları içeren bir nesne kullanmak.
Bağlamla birlikte modele birden fazla soru da geçirmek mümkün. System One modelleri serbest biçimde yanıt üretmediği için, beklenen cevap türünü mevcut temel (primitive) tiplerden biriyle belirtmek gerekiyor.
Choice (Seçim), cevabın önceden tanımlanmış birkaç seçeneğinden birinin olması gerektiği durumlarda çalışır; örneğin bu müşteri talebi teslimat, fatura veya hesaba erişim açısından neyi içeriyor. Score (Puanlama), cevap sıralı bir değer kümesinden geliyorsa kullanılır; örneğin bu müşteri mesajının duygu durumunun olumsuz, nötral mı yoksa olumlu mu olduğu. Noul ise evet/hayır soruları için uygundur; örneğin müşterinin sorunbu sohbet içinde çözülüp çözümmediği.
Bu tür tüm durumlarda yalnızca cevabı değil, aynı zamanda tüm mümkün değerler için olasılıkları da elde ediyoruz. Confidence (Güven), Jev’in önemli bir parçası; çünkü modele kararında emin olup olmadığını söylüyor: Olasılıkların büyük kısmı tek bir değere yoğunlaşıyorsa güven yüksek, birkaç seçenek yaklaşık olarak benzer olasılıklara sahipse belirsizlik söz konusu.
Bu güven seviyeleri, model çıktısına dayanarak karar vermemiz gereken durumlarda özellikle faydalı olabilir. Müşteri sorularına otomatik yanıtları örnek verebiliriz: Model bir müşteri talebini yüksek güvenle bilinen kategorilerden birine sınıflandırabiliyorsa otomatik yanıt gönderilebilir; aksi halde mesaj bir insan destek temsilcisine yönlendirilebilir.
Pratik deney: Jev ile OpenAI karşılaştırması
TypeSafe, Jev’in 193,6 kat daha hızlı, 444,6 kat daha ucuz ve uydurma yanıtlara daha az eğilimli olduğunu iddia ediyor. Bu iddiaların pratikte ne kadar tuttuğunu görmek için araştırmacı, bu deneyde OpenAI’yi seçti; çünkü TypeSafe’in referans testi Jev’in OpenAI’nin Terra modeliyle paralel performans gösterdiğini ortaya koyuyor.
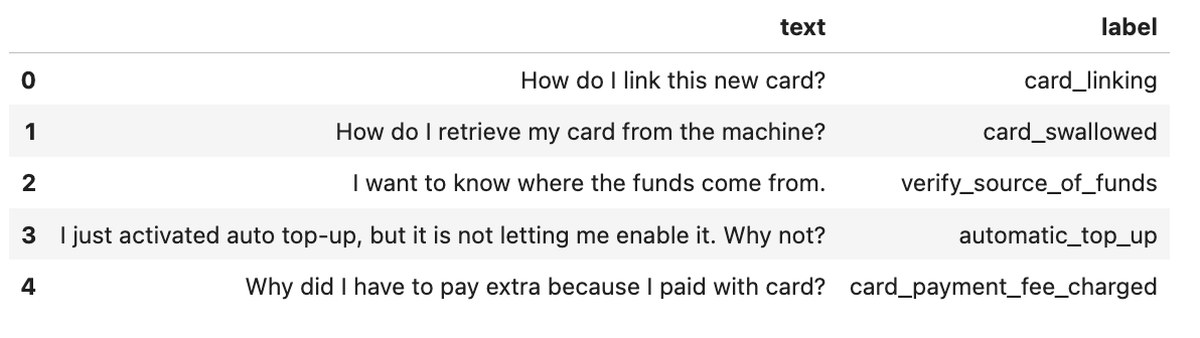
Araştırmacı ayrıca PolyAI tarafından CC BY 4.0 lisansı altında yayınlanan, bankacılık niyetlerini içeren halka açık bir veri seti kullandı. 77 farklı niyet sınıfı içerdiği için oldukça ilginç bir sınıflandırma problemi sunuyor; bu da ciddi sayıda sınıf anlamına geliyor.

Jev’i kullanmaya başlamak için önce modele çağrı yapmak gerekiyor. Erişim için kayıt olmak (günümüzde bekleme listesi bulunuyor) ve bir API anahtarı almak şart. Araştırmacının deneyimine göre daveti almak yaklaşık yarım gün sürdü.
Sınıflandırma görevi için soruda Choice temelini kullanmak gerekiyor. Kategoriler için ek açıklama olmadığından bu alanlar null olarak bırakılıyor. Ardından yalnızca bir HTTP isteği yapmak ve gerekli tüm bilgileri (durum ve soru temeli) geçirmek yeterli.
Sonuçta, cevapı ve tüm mümkün seçenekler için olasılıkları içeren bir JSON nesnesi elde ediliyor. Bu durumda modelin doğru cevabın card_linking olduğundan kesin emin olduğu görülüyor.
Karşılaştırma sonuçları: Doğruluk daha düşük, hız üstün
Karşılaştırma için OpenAI’nin Luna ve Terra modelleri kullanılıyor. Kurulumu karşılaştırılabilir kılmak için bu modellere de bir çıktı şeması belirtiliyor; böylece yanıtları aynı yapılandırılmış biçime kısılanıyor. Ne var ki OpenAI modelleri şu anda log olasılıkları döndürmediği için modele doğrudan bir güven skoru elde etmek ve onu Jev ile karşılaştırmak kolay bir yol yok.
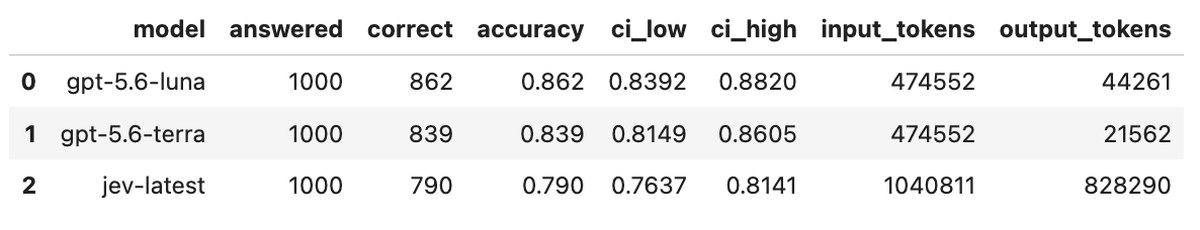
TypeSafe, Jev’i Terra ile kabaca paralel, Luna’dan ise biraz önde konumlandırırken; özellikle birden fazla karar veya çağrı içeren iş akışlarında önemli ölçüde daha hızlı ve ucuz olduğunu vurguluyor. Bu iddianın basit tek bir çağrı gerektiren bu görevdeki karşılığına bakıldığında, doğruluk açısından Jev’in her iki OpenAI modelinden belirgin biçimde düşük çıktığı görülüyor: 79,0% ile Terra’nın 83,9%’u ve Luna’nın 86,2%’sının altında. Fark istatistiksel açıdan anlamlı.
Araştırmacı ayrıca Jev’in önemli ölçüde daha çok token kullandığını fark etti: giriş tokenlarının yaklaşık 2 katı ve çıkış tokenlarının 40 katı; bunun temel nedeni tüm 77 niyet için olasılıkları döndürmesi. Bu nedenle, satır başına daha düşük fiyatlandırma olsa bile, bu özel görevde Jev’in Luna’dan dramatik biçimde daha ucuz olduğu söylenemez.
Bununla birlikte hız iyileşmesi gerçekten önemli: Jev neredeyse 2 kat daha hızlı. Gerçekten dikkat çeken yön ise güven skorlarının ne kadar iyi kalibre edildiği: Doğruluk, düzenli olarak daha yüksek güvenli gruplarda artıyor.
Neden bu görevde beklendiği gibi çalışmadı?
Araştırmacı, Jev’in bu göreve bu kadar iyi performans göstermemesinin nedenini anlamak için biraz deneme yaptı. En güçlü tahmini, büyük sınıf sayısının ana sorun olduğunu yönündeydi. Görevi 77 etiketten yalnızca 7’ye indirdiğinde sonuçlar belirgin biçimde iyileşti ve OpenAI modelleriyle kabaca paralel hale geldi.
Tüm kod GitHub üzerinden erişilebilir durumda.
Sonuç: Yönü beğenilen bir yaklaşım, ancak iddialar abartılı olabilir
Araştırmacı, System One modellerinin gittiği yönü seviyor; çünkü LLM tabanlı değerlendirme değerlendirmeleri veya niyet sınıflandırması gibi işinde sık karşılaştığı birçok görevde faydalı olabileceğini görüyor. Gördüğümüz gibi kalite her zaman LLM’lerle paralel olmayabiliyor, ancak iyi kalibre edilmiş güven skorları büyük bir avantaj sunuyor. Bu skorlar, daha kolay durumlar için hızlı ve ucuz bir modeli kullanırken, daha belirsiz olanları ileri düzey modellere yönlendirmeye olanak tanıyabilir; araştırmacı bu tür bir kurulumu gerçek bir üretim iş akışında denemek oldukça istekli.
Bir yandan da TypeSafe’in başlıktan gelen iddiaları (100 katdan fazla ucuz ve hızlı) bu modelleri neredeyse mucizevi gösteriyor. Bazı iş akışları için bunun ulaşılabilir olabileceğine inanılıyor; özellikle çok sayıda küçük karar ve tekrarlayan çağrı içerenler. Ancak gerçek dünyadaki kazanımların kullanım alanına göre oldukça değişeceğini beklemek gerekiyor. Bu nedenle, referans numaralarının doğrudan çevrileceğini varsaymaktansa, kendi görevinizde test etmek yerinde olur.
Araştırmacı, okuyucuya Einstein’ın şu sözünü hatırlatarak makaleyi kapatıyor: “Önemli olan sorgulamayı bırakmamaktır. Merakın var olmasının kendi nedeni vardır.” ve merakın okuyucuyu bir sonraki büyük içgörüye yönlendirmesini diliyor.
Bu Gelişmeyi Toplulukta Değerlendirin
Haber hakkındaki düşüncelerinizi, donanım deneyimlerinizi ve teknik sorularınızı topluluk üyeleriyle anlık olarak tartışın.























Söz sizde.
Deneyiminizi, sorularınızı ve katkılarınızı paylaşın. E-posta adresiniz yayımlanmaz.